起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Gemini 4 终于给我用了,能不能脚踢 Claude Opus 5.5?


Gemini 4(代号 Argon)今日向 Pro 用户开放,Antigravity CLI 里可直接切换、思考强度可调 High。实测复杂动画半小时才交卷,一周额度被吃掉三成多;海外盲测 3.95 分垫底,92 项断言里 47 项被指捏造。

老章一直对 Gemini 3.8 Flash 的评价很高,不仅推理速度快如闪电,还附赠了 Colab Pro 和丰富的算力比如 A100 的使用权限
- 我的 Gemini 终于要回本了,开发了一个 macOS 原生菜单栏工具
- Gemini Pro 大礼包,英伟达 A100 我用上了,成功部署 Qwen
其实网上很多吐槽 Gemini 难用的负面声音,很大程度是被 Gemini 的网页版和桌面客户端劝退了,感受 Gemini 的模型能力,必须使用 Antigravity CLI,在纯粹的 Agent 环境里跑起来才叫顺手
Gemini 4(内部代号 Argon)磨磨叽叽半个多月了,前些天只对 Google AI Ultra 顶配用户开放,今天终于全面轮到我们 Pro 用户了
打开 Antigravity CLI,在模型切换菜单里已经能直接选到 Gemini 4 Argon,思考强度(Thinking Effort)也可以自由调节到 High,让它在后台进行最深度的复杂推理
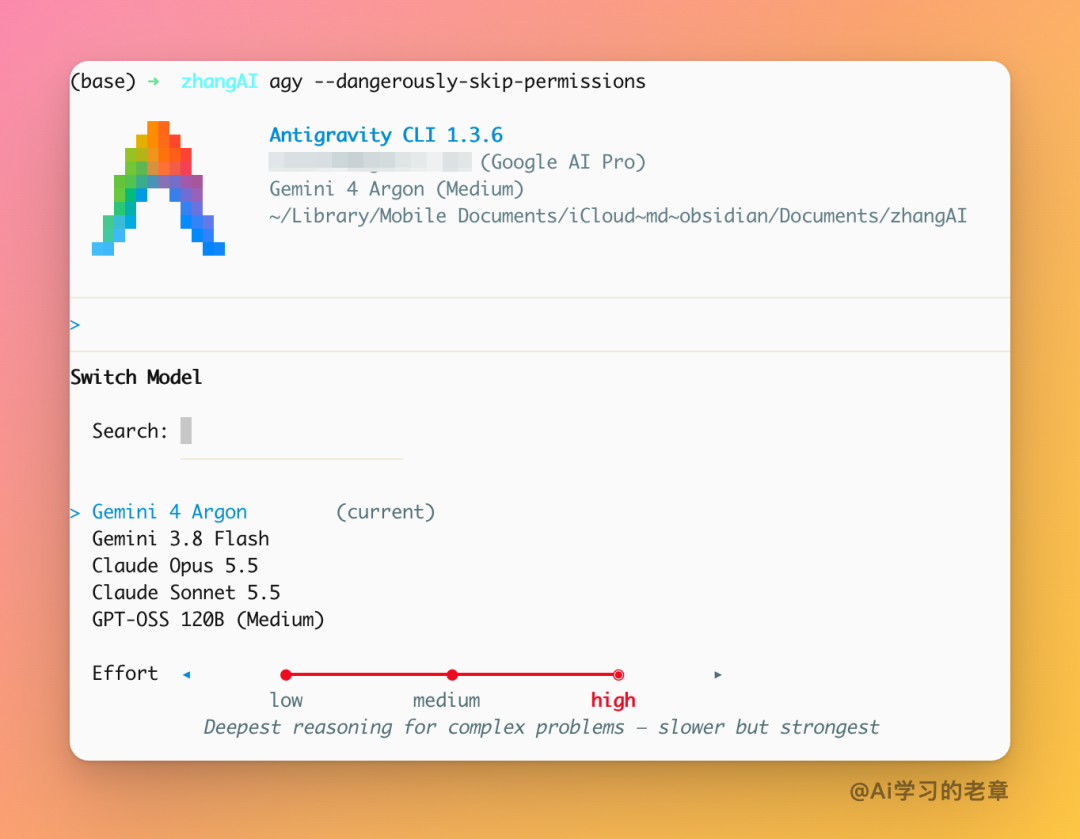
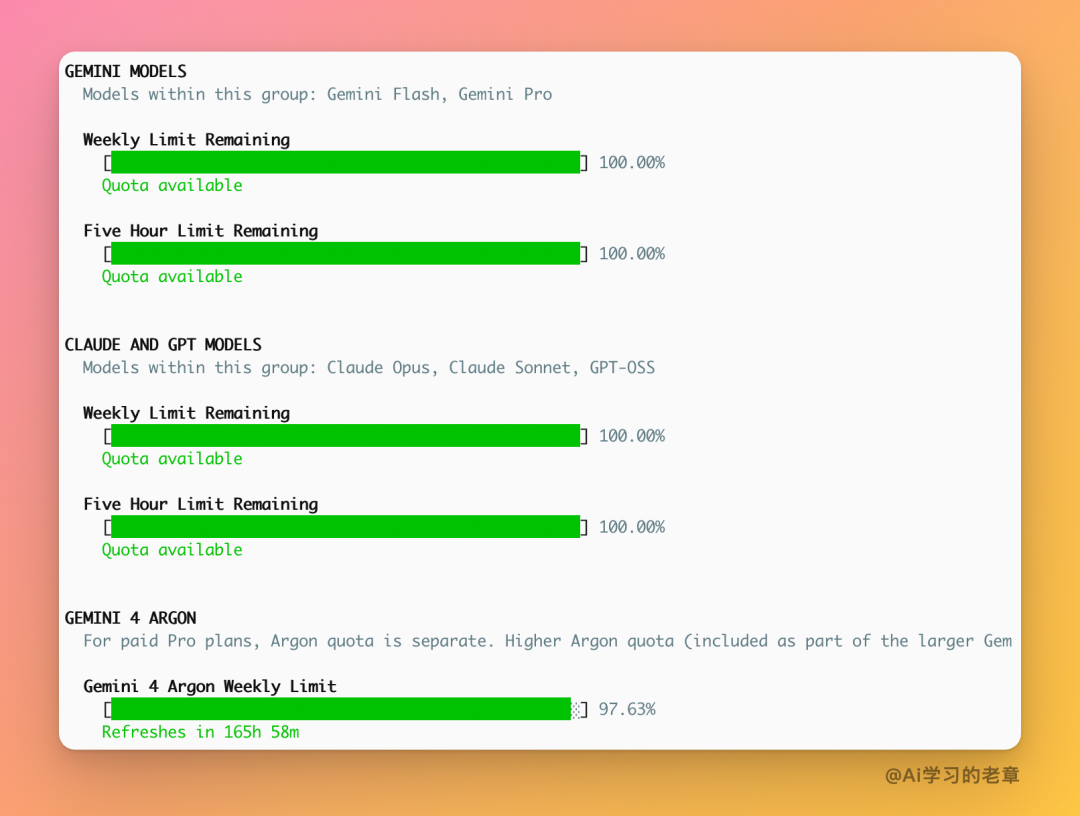
更让人舒心的是它的配额机制:Google 这次挺厚道,Gemini 4 Argon 与 Gemini 3.8 Flash 的额度是彻底分开的两个池子,互不占用,就像列表里的 Claude Opus 5.5 和 Sonnet 5.5 一样独立计算,顺嘴说一句 Claude Opus 5.5 形同虚设,一个问题干掉 5 小时额度
实测:复杂动画与代码视频生成
拿到新模型,老章第一时间拿它和当前的编程王者 Claude Opus 5.5 掰掰手腕
最近 Claude Opus 5.5 被社区深度发掘出惊人的代码动画与视频生成能力,比如下面这段纯代码构建的手绘沸腾线风格火柴盒点火动画:
老章拿了完全相同的提示词和参数要求,让刚上线的 Gemini 4 Argon 也来挑战一次
实测下来的第一体感:思考过程极其漫长,开启高强度思考后在后台反复推演,这类复杂动画任务半小时起步才开始交卷
结果也有点粗糙,差点意思,好在完成了任务
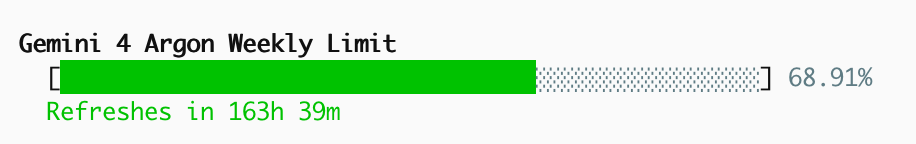
随之而来的就是心疼,一周宝贵的 Argon 额度肉眼可见地直接被消耗 30% 多,容错率极低,根本经不起反复调试折腾
除了老章自己的手感,大家最关心的还是它在复杂工程里的真实实力
在海外众多评测中,前端顶流博主 Theo 的测试最具说服力,直接拿自己生产级的 T3 代码库做了严格的盲测架构审计
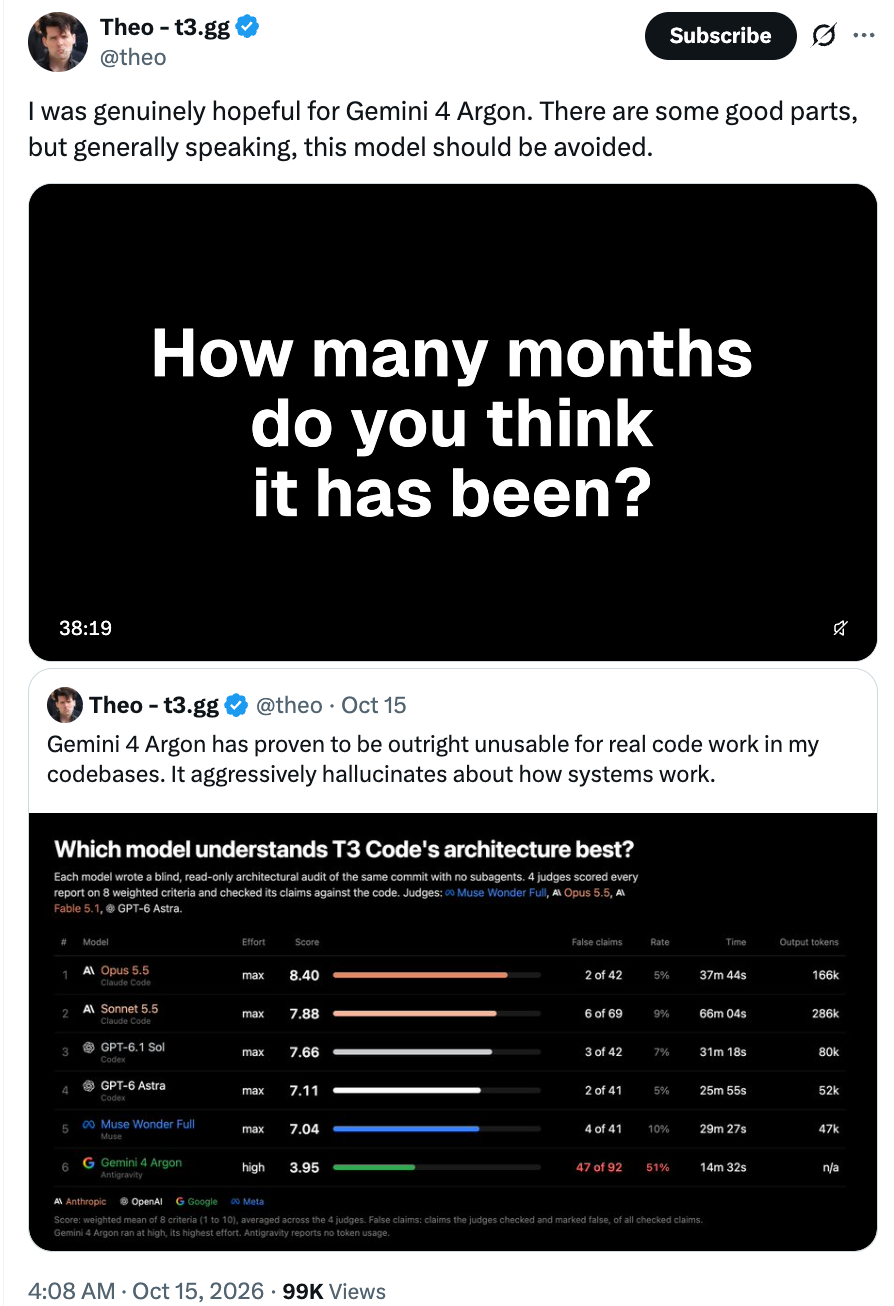
结果出来,可以说把 Gemini 4 Argon 的底裤给彻底扒光了:
- Claude Opus 5.5 凭借 8.40 的高分稳坐榜首,42 项声明里只有 2 项错误,虚假声明率低至 5%
- Claude Sonnet 5.5 拿下 7.88 分,虚假声明率 9%
- GPT-6.1 Sol 和 GPT-6 Astra 也稳稳拿下 7.66 和 7.11 分
- 满怀期待登场的 Gemini 4 Argon 却直接暴跌到 3.95 分,在一众旗舰模型中垫底
- 最离谱的是虚假声明率:92 项系统断言里有 47 项纯属捏造,错误率高达 51%
Gemini 4 Argon 不懂真实项目架构、乱提重构建议,甚至一本正经地编造完全不存在的系统行为
Theo 测完后直接给出极其严肃的忠告: “I was genuinely hopeful for Gemini 4 Argon. There are some good parts, but generally speaking, this model should be avoided.”(原本对它满怀期待,虽然某些局部有些亮点,但大体而言,开发者在实际项目中最好避开这个模型)
Three. s 3D 渲染实测
除了架构层面的代码审计,海外开发者 Bhavani 也做了一组直观的 3D 渲染代码对比
他给出的 Prompt 是:在 Three js 中完全用纯代码构建巴黎埃菲尔铁塔
同台竞技的选手涵盖:Gemini 4 Argon、Claude Opus 5.5、GPT-6 Astra 以及国产的 Kimi K3
以及四款模型的对比:
- Argon 构建的埃菲尔铁塔底层结构明显畸变,骨架比例完全走样,缺乏真实的力学与空间对称感
- 表现最让人惊艳的反倒是 GPT-6 Astra 和国产的 Kimi K3,塔身细节精致,层级分明,高度贴近真实的埃菲尔铁塔
- Claude Opus 5.5 依然保持着一贯的沉稳水准
- 在需要精细几何推演和 3D 代码构建的场景下,Argon 再次显露出空间想象力与代码精确度上的脱节
看 Google 官方博客最新的技术报告,战报可谓豪华至极:
- Alphabet 内部每月有超过 10 万名工程师重度依赖 Argon
- 内部 Agent 代码产出 4 周内激增 35%,提交后回滚率下降 30%
- 帮 YouTube 优化前端评论区性能,CPU 开销直接腰斩,端到端延迟降低 20ms
- 帮 Wing 无人机物理模拟器推导空气动力学,提出了 18 项高难度建模改进
- 自动把运行了几十年的 Fortran 科学计算遗留系统完整重写为现代 Rust,不仅性能提升 1.8 倍还解决了内存安全
- 在安全审计中挖出了 4 个隐蔽权限漏洞,而之前两款顶尖大模型审查同一批代码都给出了「零风险」的误判
- 3 小时内自动清理掉了跨多系统的 72.4% 陈年积压 Bug
Google 内部跑这套流水线,依赖的是全球最顶级的标准化工程体系,包括统一的代码单体仓库(Monorepo)、完备的运行时遥测监控(Telemetry)、成千上万的前置测试用例,以及针对内部流程深度定制的 Custom Skills
而在外部开发者的现实世界里,面对的是充满个性化配置的技术栈、版本错综复杂的三方依赖以及大量没有类型标注的历史包袱
一旦缺少了官方实验室的严密护栏,Argon 在真实上下文感知上的短板就彻底暴露了:极度容易过度脑补、凭空编造接口,给出看似言之凿凿实则报错连篇的方案
平心而论,Gemini 4 Argon 绝非毫无亮点,在超大上下文信息提取、长篇技术文档梳理以及多模态综合分析等领域,它依然具备 Google 家的深厚底蕴
作者:Ai学习的老章 公众号:Ai学习的老章
本文由 @Ai学习的老章 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议


- 目前还没评论,等你发挥!