起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
一个住着 25 个 AI 角色的小镇,变成了估值 20 亿美元的公司


Simile 用住着 25 个 AI 角色的小镇做合成用户,五个月里估值从 10 亿涨到 20 亿美元;创始人 Joon Sung Park 认为,模拟真人这件事不能只靠更强的模型,得回到真人数据。
你有没有试过这样问大模型:你是一个 34 岁的女性,住在大城市,现在给你看一款新产品,你会买吗?它的回答通常很合理,条理也清楚,可你多半不敢拿这个答案去做真正的决定。
Sequoia(红杉资本)的 Sonya Huang 也问过 Joon Sung Park 差不多的问题:大模型不是已经读遍了整个世界吗,为什么还要专门去找真人收集数据?Joon 是 Simile 的创始人和 CEO,Simile 做的事,是用 AI 模拟真人会怎么选、怎么做。公司今年 2 月拿了 1 亿美元的 A 轮融资,Index Ventures 领投,李飞飞和 Andrej Karpathy 也投了个人的钱。7 月底又拿了 2 亿美元的 B 轮,Greenoaks 领投,估值 20 亿美元。他们说,A 轮之后的五个月里,收入涨到了原来的五倍。这篇文章我只讲一条线:为什么模拟真人这件事,不能只靠更强的模型,一定要回到真人身上去。我先讲他怎么说,再写我自己的想法。
Simile 的官网形象:一座座像素风格的小镇。图片来自 Simile
01 现在的大模型很聪明,但真人不是这样想问题的
Joon 先讲了一个他很看重的判断。今天的大模型公司,不管是 OpenAI、Anthropic,还是新冒出来的实验室,目标差不多:做一个超级聪明的机器,遇到有标准答案的难题,能算得比人还好。这样的模型是讲道理的,也是理性的。
Joon Sung Park 在 Sequoia 的播客节目《Training Data》里。图片来自 Sequoia
可真人不是这样。他说,人有很多主观的想法,有自己的偏好和口味,常常不讲道理。所以模型做得越大,解数学题、写代码的本事越强,但预测和模拟真人会怎么做,进步并没有跟上,甚至两者越拉越开。他的看法是,在现有的做法下,模拟人的能力已经基本到顶了,想再往前走,得有专门为“人的差别”做的新模型。
他打了个比方。今天的大模型,像电脑里的 CPU(中央处理器),是一个特别强、特别理性的大脑,专门啃复杂的难题。Simile 想做的,更像 GPU(图形处理器)。GPU 是由很多小单元一起干活的,每个小单元负责一小块。Simile 的模型也一样,它不需要比人聪明,反而要尽量像人,而且里面的每一小块,都要能代表不同人群的真实想法。
我觉得这个比方讲清楚了他们和大模型公司的区别。大模型公司要的是一个答案对的脑子,他们要的是很多个各不相同的脑子。
02 一个住着 25 个角色的小镇,后来变成了一家公司
要看 Simile 怎么来的,得从 2023 年春天说起。Joon 当时在斯坦福读博士,做了一个叫 Smallville 的实验:一个游戏里的小镇,住着 25 个由大模型驱动的角色。每个角色有自己的身份介绍,还有记忆、计划和反思的能力。他们早上起床,过自己的日子,去上班,也会发展出各种关系。
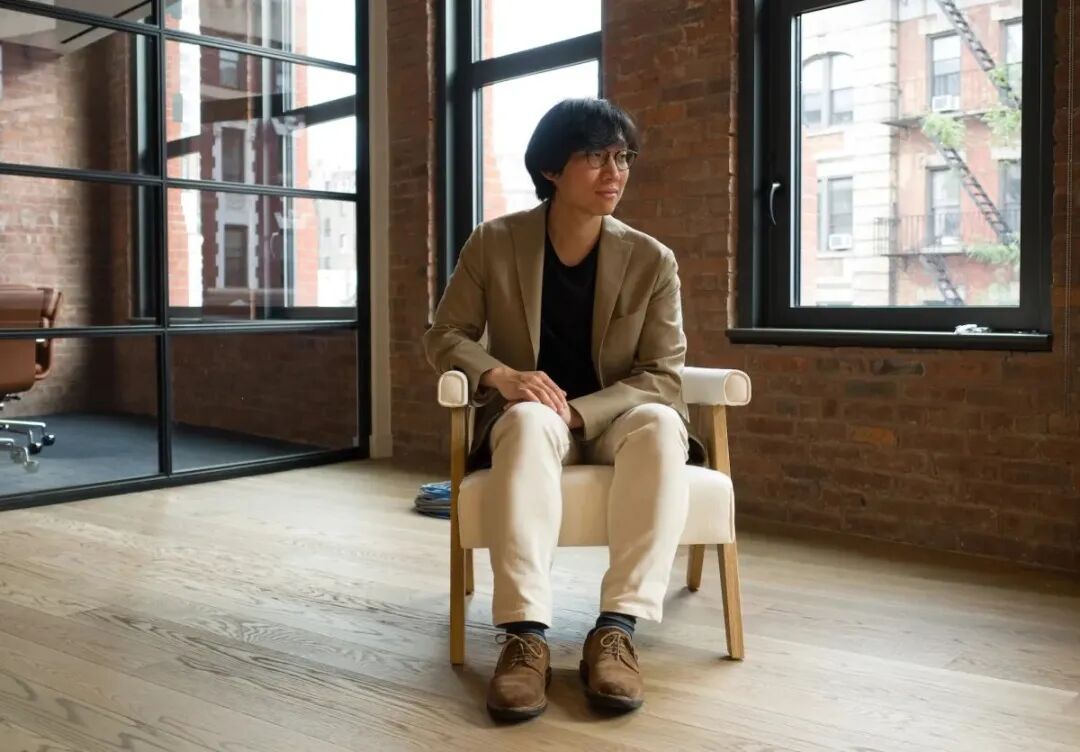
Simile 的创始人兼 CEO Joon Sung Park。图片来自 Simile,来自 TechCrunch 的报道
最让他意外的是情人节前一天发生的事。一个叫 Isabella 的咖啡馆老板,自己想到要办一场情人节派对,就去张罗东西,一个个告诉来店里的客人。到了那天,真有一群角色赶来参加。有的人收到了邀请却忘了去,有一个叫 Klaus 的角色,收到邀请后,约了自己暗恋的人一起来。这些事没有人提前写好,都是角色们自己做出来的。
后来 Joon 慢慢想明白,做研究和做公司是两回事。他说,做研究像是广撒网,每个人拿一小块想法去试,有些会长成了不起的成果,但研究者往往不负责把成果送到真实世界里去。公司则不一样,是一台适合钻到底的机器:认准一个方向,把人和钱都集中过来,一路做下去。
让他下决心的,是 Smallville 论文发表后半年左右的事。先是社会科学家找上门,想在他们的平台上做自己的实验。很快,美国财富 500 强里的一些大公司也来了,有的公司董事会成员或 CEO 来斯坦福时看到了演示,回头就问:我们每天要做那么多调查和实验,还有一大堆市场问题回答不了,能不能放到模拟里去做?
他说,这让他看到了研究能直接用到真实世界的一条路。不过在把它当成产品之前,他们先要证明模拟是准的。于是他们找了 1000 多个美国人做实验。他们的做法是,让一个 AI 面试官,先和每个人聊他们的人生经历、对社会问题的看法,再根据聊天的内容,生成一个“数字分身”。然后过两周,请这些人回来填问卷,做性格测试、经济学小游戏和行为实验,看分身能不能预测出来。
结果是,分身答对的程度,达到了真人自己前后一致程度的 85%。这里的意思是,同一个人隔两周再答同一份问卷,答案本来也不会完全一样,分身答得有多接近真人的答案,是拿这个来做比的。Joon 说,2024 年底,他们第一次在这个领域里证明,能用这种办法预测人的行为,准确率有 85% 以上。这就是公司最初的底气。
他的两位导师 Percy Liang 和 Michael Bernstein 也一起加入,成了联合创始人,Percy 是斯坦福基础模型研究中心的负责人,现在是 Simile 的首席科学家,Michael 做首席产品官。后来 Lainie Yallen 加入,负责客户和落地。
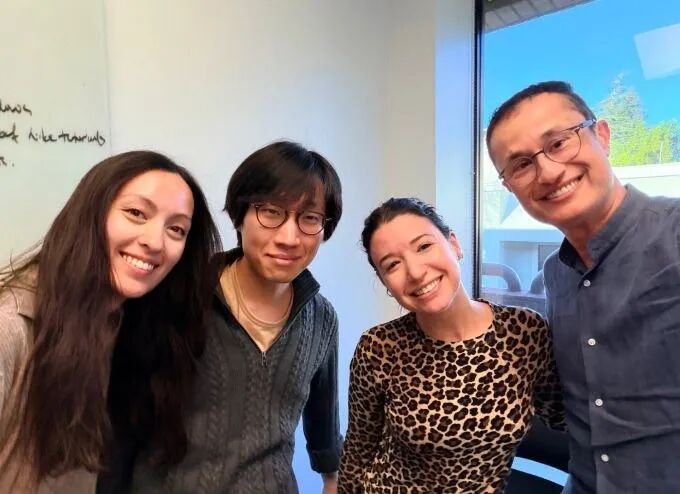
Joon Sung Park(左二)、Lainie Yallen(左三)和投资方 Bain Capital Ventures 的合伙人合影。图片来自 Bain Capital Ventures
03 光让模型扮演真人不行,因为人说的和做的不一样
回到 Sonya 的那个问题:为什么不能直接告诉大模型“你是一个 34 岁的女性”,就让它代表这一类人?
Joon 的回答是,因为人说的和做的有一个差距,这个差距是真的。大模型学到的东西,很大一部分是人们在网上说过的话,也就是人们的态度。可是人们嘴上说的,和实际做的,常常对不上。
他举了一个健身的例子。问卷里问大家这周打算去几次健身房,答案分布得比较平均。可实际去了几次,是另一种样子:有的人一次都没去,去的次数越多,人数掉得越快。为什么会这样?因为真到了要做的时候,人手里有很多选择。他说,我可以去健身,但不去的话,我能多睡一个小时,也能多开一个会。每个选择都有代价,人是在这些代价之间做决定的。问卷把选择说得很抽象,真实的生活里,选项是摆在眼前的,竞争也在眼前。
所以 Simile 会去收集真人的数据,来补上这个差距。他们先在邮件、问卷、一对一聊天里收集信息,再训练自己的面试模型。这个模型的目标是,用尽量少的时间,了解到一个人尽量多的东西。它问的不是“你对这款产品怎么看”,而是“讲讲你的人生故事”。他说,一个人在哪里长大,做过哪些艰难的决定,这样的信息是“长尾”的,也就是不常见、不一样的地方,恰好能把人说的话和人做的事连起来。
光有一对一聊天还不够。问卷效率高,适合问具体的选择题,了解大家对某些政策、某些话题的看法。他们还有大量的实验数据,包括社会科学研究里做过的随机对照实验(把人分成几组,只改变一个条件,看结果有什么不同),也包括价格研究。他们要训练的,是一个能预测各种随机对照实验结果的模型。
这些真人从哪里来?Joon 说,他们和一家调查公司 Gallup(盖洛普)合作,在全球的合作渠道里,一共能联系到 4000 多万人,每个星期都会和几万甚至几十万真人说话。他们为了不让数据变差,会控制问卷发出的间隔,免得人答烦了,也会做检查,比如问简单的算术题,看对方有没有认真答。未成年人不会参加,每个人都可以随时撤回同意。
投资他们的 Bain Capital Ventures 把这个区别说得很清楚:很多做“合成用户”的产品,是先写一个人口画像,再让通用大模型去扮演。Simile 的每一个“分身”,都对应一个真实的人,背后是一对一的聊天、过去的选择和行为数据。
04 客户拿它做什么,结果又怎么判断能不能信
先看客户。CVS(美国一家大型连锁药房和医疗公司)合作了差不多半年。起因是他们负责消费者洞察的一位高级副总裁,看了 Joon 的论文,觉得公司被两件事卡住了:能拿到现场去试的问题太少,而想看清整个市场里一个决定会连带出什么后果,也没有办法。后来这个副总裁的表亲碰巧认识 Joon,双方就这样联系上了。
做法其实跟客户以前和调查公司合作很像:先告诉 Simile,想了解哪一类人。Simile 和合作方去联系真人,只拿一次十五分钟左右的时间,问最有用的问题,再用这些数据生成分身,放到平台上。之后客户可以随时问关于这群人的任何问题,没有数量上限。Simile 披露,CVS 的分身用了超过 40 万个参与者的 290 万份同意使用的回答,覆盖 200 多种行为场景。CVS 用来检查调研的问题,看顾客的购物流程,也测试怎么让人更好地按时吃药,然后才去做真实的调研和试点。
最常见的起点是概念测试,也就是拿一个新产品、新的宣传语,看用户怎么想。Joon 说,客户很快会发现,以前一次最多试五到十个想法,现在可以同时拿 1000 个想法,去问 1000 种不同的人。接下来的需求会越来越多:让分身去“体验”一个产品十分钟,再讲讲看到了什么;或者让很多分身一起跑,比如模拟一次财报电话会。他说这一条他起初很意外,没想到会这么多人问,因为 CEO 和董事会确实要想,电话会怎么安排,听的人会怎么反应。
Simile 还披露,Deloitte(德勤)拿它来代替一部分焦点小组,Wealthfront 把做定性研究的范围扩大到了原来的 15 倍。
这就带来一个问题:怎么判断结果能不能信?Joon 说,他们有两类办法。第一类是对比分布。比如拿真实人群的回答分布,和模拟出来的分布比,用一个叫总变差距离的指标(衡量两组结果差多远),低于 0.15,他们认为证据就足够强,可以拿来做决定。第二类是给每一次模拟打一个信心分,0 到 100,是跟基础模型一起训练出来的。他说,信心高于 90%,或者通常 85%,客户发现这样的结果可以用来做风险很高的决定。他把这个比作统计学里的 p 值,低于 0.05 就算有证据,是整个领域花了很多年才定下来的标准,Simile 想为模拟做同样的事。
多个分身互相影响的时候,误差会不会越滚越大?他说得很细。有一类模拟,结果会往同一个方向收拢。比如模拟一群人组成的网络,总会冒出几个中心人物,这是网络科学里很早就知道的规律,Google 早期的网页排名也是靠这个。这种情况下,小误差不要紧,最后会落到差不多的地方。另一类模拟则会越走越散,比如选举,跑一百次,结果可能不一样。这时候要看的不是哪一次对,而是一百次里有多少次出现某个结果,让人看清楚有哪些可能,各自是怎么走到的,早点做准备。
我觉得他把这两类分开讲,很实在。很多人以为模拟就是要给出一个唯一的答案,他的意思是,有些问题本来就没有唯一的答案,模拟的用处是把各种可能摆出来。
05 他想模拟的,不只是消费者
Sonya 问他,有没有可能解决一些比商业更大的问题,比如经济学、央行的决定。他说,当初他打动自己的导师,就是一句话:这件事做对了,是有机会拿诺贝尔奖的。
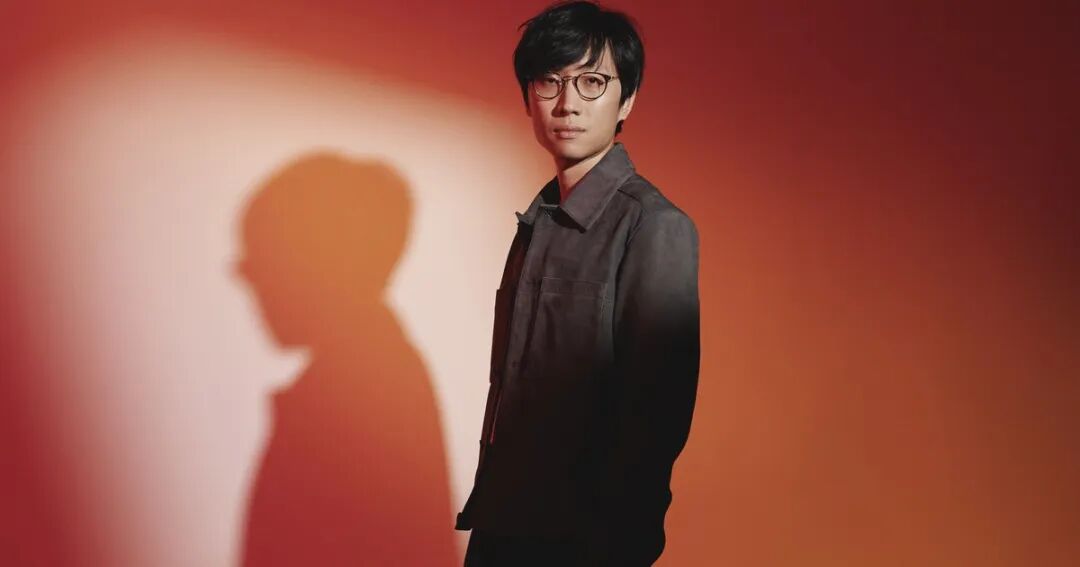
Joon Sung Park。图片来自 Index Ventures
他举的是经济学家 Thomas Schelling 的例子。几十年前,Schelling 用一个极简单的模型研究种族隔离是怎么形成的:每个人就是一个红点或蓝点,看看周围邻居有多少和自己同色,如果比例低于某个数,就搬走。就是这么简单的规则,却说明了社会层面的一个深刻道理,他后来拿了诺贝尔奖。Joon 说,现在的差别是,点不再是红蓝两种,而是能把一个人丰富的样子还原出来的分身,可以跑同样的实验。
经济学家问过他的问题,包括银行挤兑什么时候发生,气候变化里各国怎样才能合作。他说,这些问题要的是很大规模的模拟,今天的模拟又快又便宜,可以想象的是,将来有的模拟跑一次要花一亿美元,跑好几个月,但一旦跑完,就能回答社会里最根本的问题之一。他还引了联合创始人 Percy 的一句话:伟大的科学进步,往往从一次了不起的测量开始,比如哈勃望远镜改变了人们对宇宙的认识,模拟可能会成为人类社会的这样一种工具。他把这个想法叫作“人类社会的欧洲核子研究中心”。
他也说了现在的位置。他认为模拟现在好比大模型的 GPT-4 时期,技术已经能做出实际的成果,但每个月都在变化,大概一年半到两年,会像今天的编程智能体这么成熟。
06 也有人觉得这件事走得太远了
当然,不是所有人都买账。有人觉得,Simile 说要模拟地球上所有 80 亿人,这个说法太夸张,因为大家做市场调研,本来就是因为人难以预测。也有人提醒,公司自己报的 85% 到 99% 的准确率,是他们自己算的数字,AI 替身能不能真代表人,本来就是批评者最怀疑的地方。
一位叫 Carlo Torniai 的人,意见更细。他认可那项研究是真的,但提出一个问题:那项研究里,就算把聊天记录删掉 80%,或者换成 AI 写的摘要,预测准确率也差不多(0.79 到 0.83)。他的理解是,模型有用,是因为它把人压缩成了几条规律,而被删掉的那 80%,恰恰是一个人的质感:说话的停顿,前后的矛盾,第 87 分钟说的一句话,把第 12 分钟说的全推翻了。预测买什么、答什么问题,压缩是行得通的;但要说“模拟一个人”,就不是一回事了。他说,得到的是一个人的统计影子,而不是这个人。
他还指出,两个人在走廊里碰面,一个很累,一个刚升职却有点愧疚,四十秒的对话,可能引出一个影响半年项目的误会。这样的事,从聊天记录和交易记录里是读不出来的。Smallville 里办派对,只是协调安排,还说不上真正的社会互动。
我自己的一点思考
回头看,Joon 讲的是一件挺朴素的事:要预测人,就得先去问人。模型再聪明,也只是读过人们说过的话,人们没说出口的,要靠真人一个个讲给它听。Simile 做的事,是把这件很贵、很慢的事,变成每个月都能重复做的事。
我自己的想法有两点。第一,这家公司真正的本钱,是那 4000 多万人的合作渠道,和一套知道该怎么问的办法。模型会越来越容易拿到,能稳定地找到真人、问对问题,才是难的。第二,Carlo 的提醒我觉得要认真对待。预测一个人买不买、答什么,和“模拟一个人”,是两个大小不同的说法。Simile 自己给客户的信心分和阈值,我觉得就是在划这条线:能用的地方放心用,没把握的地方,把各种可能摆出来。如果我是客户,做大决定之前,我会先用一小批真实的试验去核对一下,再放手。
要模拟人,先得老老实实去问人。
资料来源:
Sequoia Capital,Simulating Humans at Scale: Simile’s Joon Sung Park(Training Data 播客)原文 https://sequoiacap.com/podcast/simulating-humans-at-scale-similes-joon-sung-park
Sourcery(Molly O’Shea),Inside Simile, $2B Company Simulating Human Behavior,2026-10-26原文 https://www.sourcery.vc/p/breaking-stanford-phd-built-2b-simulation
Index Ventures,Simulating Society at Scale: Our Investment in Simile’s $200M Series B,2026-07-30原文 https://www.indexventures.com/perspectives/simulating-society-at-scale-our-investment-in-similes-200m-series-b/
Bain Capital Ventures,The Human Layer of AI: Why We’re Continuing to Invest in Simile,2026-07-30原文 https://baincapitalventures.com/insight/the-human-layer-of-ai-why-we-re-continuing-to-invest-in-simile/
The Next Web,To find out what customers think, this $2bn startup asks their AI twins,2026-07原文 https://thenextweb.com/news/simile-200-million-agentic-twins-ai-market-research
TechCrunch,Synthetic-user startup Simile raises $200M at $2B valuation 5 months after $100M Series A,2026-07-30原文 https://techcrunch.com/2026/07/30/synthetic-user-startup-simile-raises-200m-at-2b-valuation-5-months-after-100m-series-a/
Carlo Torniai,Simile Wants to Simulate You. Can It?原文 https://carlotorniai.substack.com/p/simile-wants-to-simulate-you-can
本文由人人都是产品经理作者【深思SenseAI】,微信公众号:【深思SenseAI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于CC0协议


- 目前还没评论,等你发挥!