
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Claude要会“读心”了?Anthropic神秘新模型曝光


爆料称 Anthropic 一款未发布模型特别擅长理解没被明说的意图。把「读心」翻译成工程能力,就是先定位显性问题、再判断扩展范围、然后请求确认;难点不在敢不敢多想一步,而在分清证据、推断和该由人决定的事。
让 AI 修一个报错,模型却顺着调用链找出同类缺陷,列出影响范围,再问你要不要一并解决。这种体验听起来像“读心”,但它真正考验的不是模型是否会猜,而是能否从有限指令中推断任务目标、发现关联问题,并在越界前请求确认。
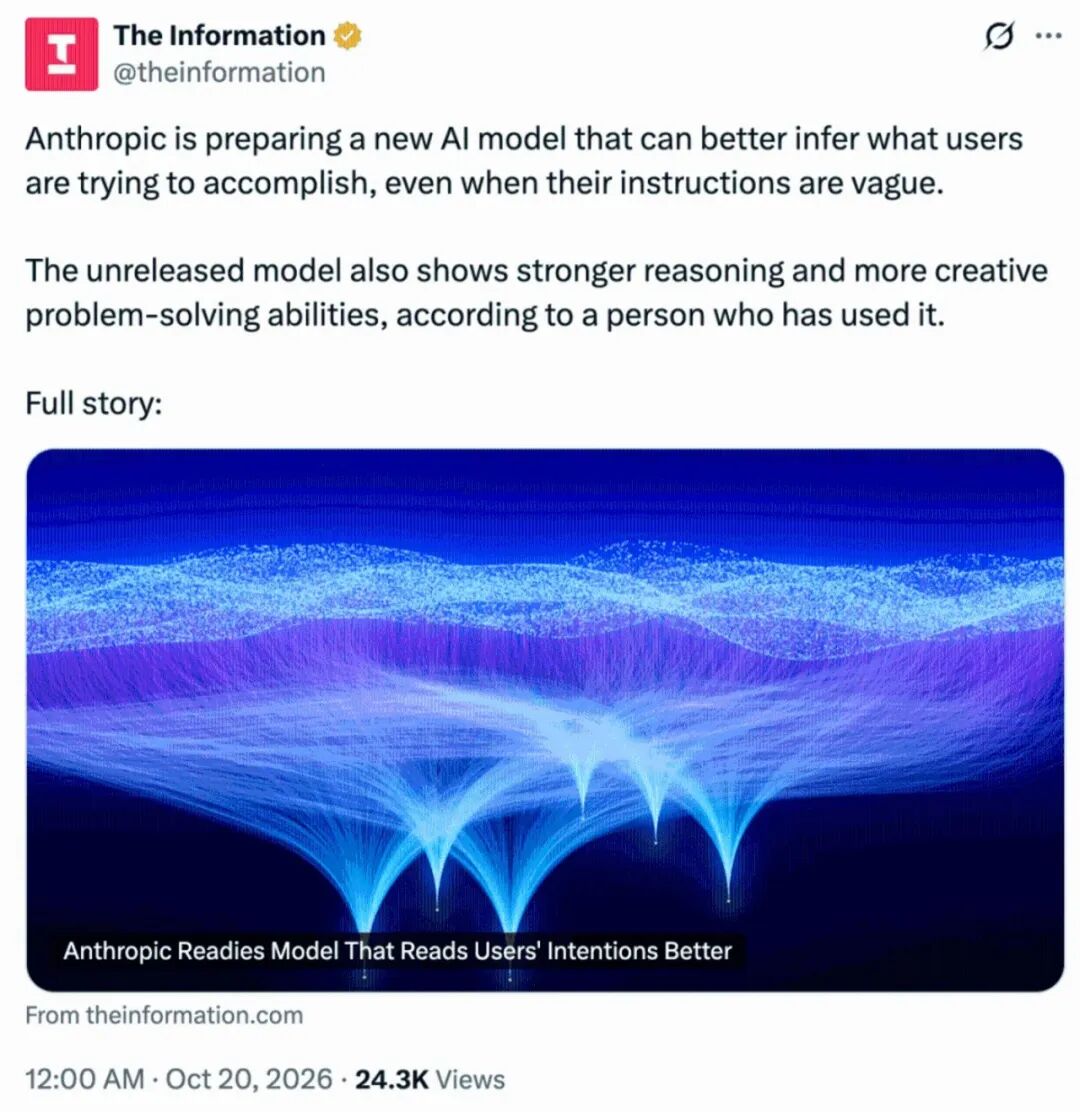
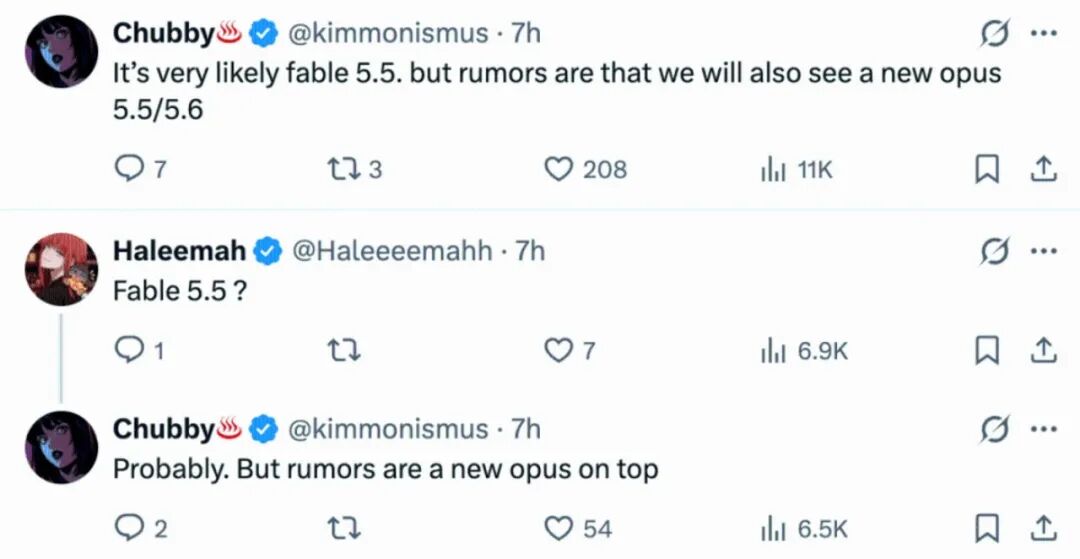
一则关于 Anthropic 新模型的爆料把这个方向推到台前。试用者称,这个尚未正式发布的模型在推理和直觉判断上超过 Anthropic 当前商用产品,并且特别擅长理解用户没有明确表达的深层意图。目前,模型名称、发布日期、评测数据和具体能力都没有得到 Anthropic 的正式确认,因此更适合把它当成一个值得观察的 Agent 产品方向,而不是已经可验证的性能结论。
先把“读心”翻译成工程能力
模型不会读取人的真实想法。所谓理解隐藏意图,本质上是基于当前指令、代码上下文、任务历史、工具结果和常见工作模式,生成一个关于“用户可能真正想达成什么”的假设。
在普通对话中,这种假设可能只是补充说明;在 AI 编程和 Agent 执行中,它会变成一条更长的决策链:
用户指令 -> 定位显性问题 -> 分析根因与关联范围 -> 形成候选目标 -> 判断是否需要扩展操作 -> 请求确认或执行受限修复
决定这项能力是否可靠的,不是模型敢不敢多想一步,而是它能否把“已观察到的证据”“合理推断”和“需要用户决定的事项”清楚分开。
修一个 Bug,为什么可能牵出一类问题
爆料中给出的编程场景是:用户要求修复一个 Bug,模型在检查代码时发现这不是孤立问题,而是某种底层模式在多个模块中重复出现。模型不会直接改完所有代码,而是先询问是否要把同类问题一起处理。
这个场景的价值很具体。大型代码库里,一个空值判断缺失、序列化约定不一致、缓存失效顺序错误或权限校验遗漏,都可能在多个服务中重复出现。只补当前报错能快速止血,却可能留下下一次故障的入口。
一个更成熟的 AI 编程流程应当输出四类信息:
- 显性修复:当前缺陷的位置、原因与最小补丁。
- 关联证据:相同模式出现在哪些文件,为什么判定它们可能相关。
- 风险分级:哪些位置可以自动修复,哪些会影响接口、数据迁移、权限或账单。
- 执行边界:模型准备改哪些文件、跑哪些测试、是否需要人工批准。
只有当这些信息可见,模型的“主动性”才会变成开发效率,而不是一套不可控的批量重构工具。
主动发现不等于自动扩大修改范围
模型从一个问题推断出更大的任务,首先会遇到一个边界问题:用户可能只想修复线上故障,并不希望在当前发布窗口触碰整个项目。即便模型的关联分析完全正确,额外修改也会带来测试时间、回归风险和评审成本。
因此,优秀的 Agent 不应把推断出的目标当成命令。一个合理的确认交互应包含:
已修复:payments/validator.ts 的空值处理错误。
发现:同样的校验模式还出现在 6 个调用点,2 个位于高风险支付路径。
建议:先生成只读分析报告,或分批提交 4 个低风险修复。
需要确认:是否扩大处理范围?
这比“我顺手修了所有类似问题”更可靠。对模型来说,推断意图只是提出下一步方案;对用户来说,确认范围才是最终授权。
股票例子提示了另一个风险:创造性不等于正确性
试用者还用股票投资举例,认为新模型可能在常规指标之外提出更有创造性的算法来预测表现。这可以说明模型有机会给出不同分析路径,却不能说明算法已经具备可交易价值。
金融、医疗、法律和安全场景尤其需要警惕这种能力幻觉:模型提出的“新思路”可能很有说服力,但没有可靠数据、回测、因果验证和风险控制,就不应直接进入决策链路。
对于任何高风险任务,Agent 都应把输出拆成三层:已知事实、分析假设、待验证实验。把假设写成结论,或者把创意方案写成行动建议,都会放大错误决策的成本。
Google 与 OpenAI 的下一轮产品信号
除了 Anthropic 的传闻,新一轮模型竞争也在积累信息。Google 已扩大 Gemini 4 Argon 的可用范围,覆盖编程、金融、法律、网络安全和科学研究等复杂任务。关于 Gemini 4 Carbon 的消息目前仍停留在内部代号与可能的后续产品层面,没有公开性能数据。
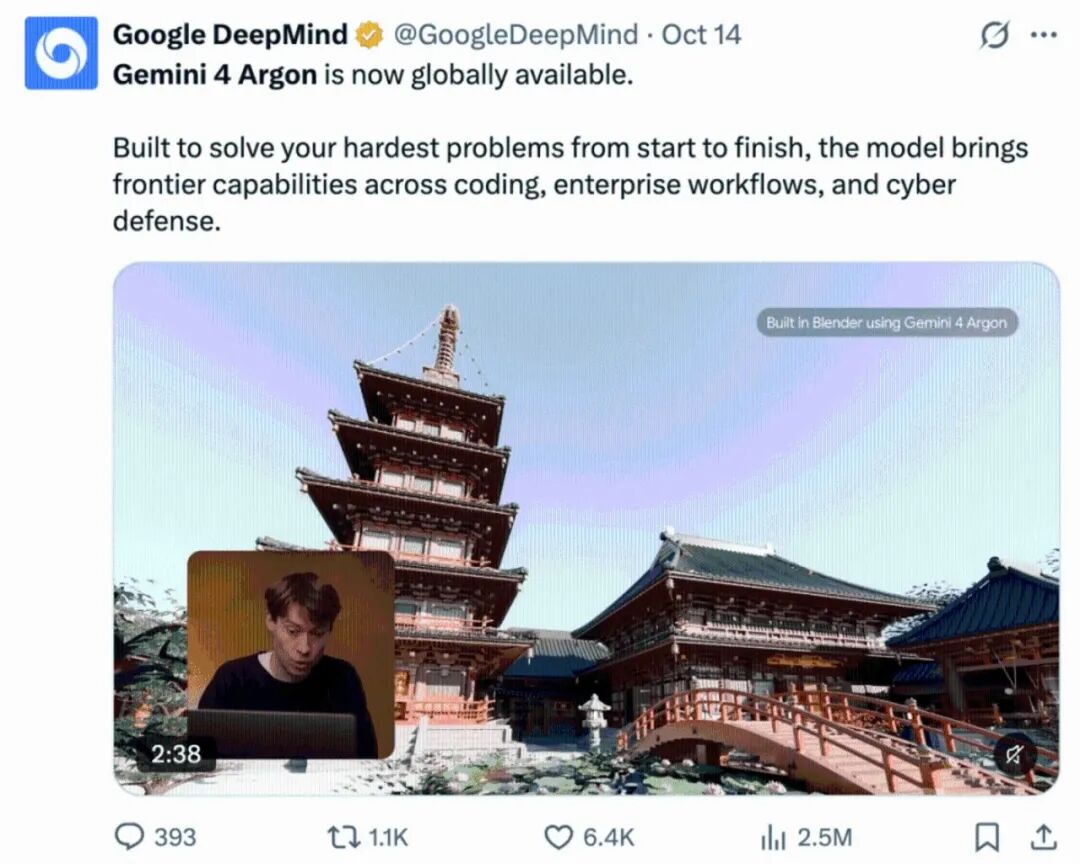
部分开发者认为 Gemini 在视觉理解类任务中表现突出,例如分析视频内容或检查网站是否正常运行。将其直接归因于 YouTube 数据规模并不严谨,训练数据、模型结构、后训练方法和评测任务都会影响最终能力。对应用团队而言,更实用的做法是拿自己的截图测试、浏览器流程和视频样本做评估,而不是根据模型传闻设定架构。
另一条消息指向 OpenAI 的 Terra 系列,定位可能位于 Sol 与 Luna 之间,目标是以更低价格覆盖中等难度的调用需求。价格与能力尚未公开,不能提前假定其替代关系;但这个方向说明一个事实:模型产品不再只分“旗舰”和“低价”,而是越来越强调面向不同任务密度的性能成本分层。
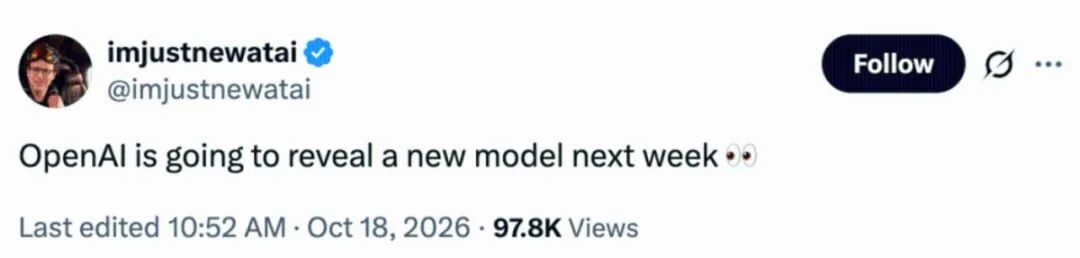
真正有价值的,是减少提示词往返
复杂 Agent 任务的低效之处,常常不在单次推理速度,而在用户必须反复补齐遗漏的上下文。用户先要求排查指标下降,模型检查一项数据后停住;用户再要求看另一个维度,模型才继续;发现异常关联后,用户又得补一轮问题。
如果模型能在执行中发现潜在线索,并把它们以候选步骤的形式呈现,就可以减少这种来回。但主动能力必须由几个机制约束:
- 证据门槛:没有观察到的事实不能作为扩展操作的理由。
- 确认门槛:涉及更多文件、更多数据或外部副作用时,必须请求授权。
- 预算门槛:搜索、工具调用、子 Agent 和推理时长都要有上限。
- 回滚门槛:自动生成的修改必须保留 Diff、测试结果和可恢复版本。
这会让 Agent 从“猜测用户需要什么”变成“根据证据提出下一步建议”。二者看起来只差一步,实际决定了系统能否进入生产环境。
面向代码库的意图推断,应该怎样评测
新模型若真的擅长挖掘问题背后的目标,公开榜单之外还应通过下面几类测试:
| 维度 | 要验证的问题 |
|---|---|
| 根因定位 | 能否找到当前 Bug 之外的共同原因,而不是只给相似文本匹配结果 |
| 影响范围 | 能否区分真正受影响模块与表面相似但语义不同的代码 |
| 用户对齐 | 是否会在范围扩大、风险提高前清楚说明并请求确认 |
| 误报控制 | 不存在关联问题时,是否能停止扩展而不是制造无用改动 |
| 验证闭环 | 修改后是否执行对应测试、构建、静态检查和回归验证 |
开发团队可以为此建立一批带已知根因的历史缺陷:先只给模型表面错误,再评估它是否找到关联位置;同时记录其误报、改动范围、测试覆盖和人工接受率。没有这类评测,“直觉更强”只能停留在产品叙事。
传闻模型上线前,团队现在能做什么
不需要等到任何新模型发布,现有工作流也可以先为更主动的 Agent 做准备:
- 将代码检查、测试、构建和部署权限拆分,避免一个 Agent 拥有无限执行范围。
- 为任务定义显性目标、不可触碰区域和扩展修改时的确认规则。
- 用结构化任务结果保存证据、发现、建议、Diff 与验证状态。
- 记录模型主动建议被接受、拒绝和回滚的原因,逐步建立本团队的 Eval 集。
如果需要以兼容 API 的方式把 Claude Code 接入现有开发环境,可通过 Code80 配置 endpoint。无论底层使用哪种模型,代码权限、密钥隔离、人工审批和发布回滚都应在项目侧完成。
常见问题
Anthropic 的这款新模型已经发布了吗?
没有。现有信息来自媒体和试用者描述,名称、发布日期、性能数据以及最终产品定位都尚未得到官方正式公布。
“读心”能力是否表示模型可以准确理解用户真实意图?
不表示。它更可能是基于上下文做目标推断。推断会出错,因此涉及范围扩大、代码批量修改或外部操作时,必须通过明确确认来约束。
模型主动修复同类问题是否一定更好?
不一定。它能减少重复排查,但也可能扩大改动范围、引入误报和增加回归风险。最佳实践是先展示证据和影响范围,再由用户决定是否执行。
传闻中的 Gemini 4 Carbon 和 OpenAI Terra 能力已经确定了吗?
没有。它们目前缺少公开可验证的性能数据和完整产品信息,不能据此做生产选型或成本预测。
如何判断 Agent 的主动建议是否值得采纳?
看它是否提供可复核的证据、清晰的影响范围、可控的修改计划和完整的验证结果。建议越主动,越需要更严格的权限、测试和人工审查机制。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!