
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
AI产品学AI:那就从y=ax+b开始讲起


AI听起来玄乎,其实底层逻辑简单到初中数学就能讲清。本文用一元一次方程 y=ax+b 拆解机器学习全流程,把特征、标签、参数、训练、模型等术语一一对应,让产品经理秒懂AI本质,不再被技术黑话唬住。

传统软件中,你想让计算机识别一只猫,需要写一堆规则:“耳朵是三角形的”、“有胡须”、“会喵喵叫”。规则越写越多,边界永远覆盖不完,而且遇到英短、折耳、无毛猫就全乱套了。
机器学习换了一个思路:不写规则,给模型看十万张图片,告诉它“这是猫”“这不是猫”,让它自己去学猫长什么样。学完之后,给一张新图片,它能判断。这就是机器学习。
我会将这一部分内容写的尽量直白,以最方便产品经理理解和学习的方式呈现。
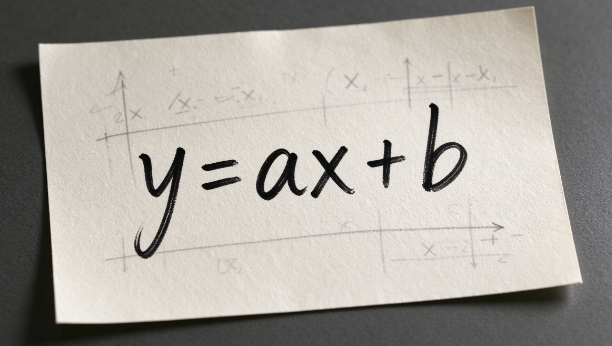
我们从y=ax+b揭开AI的神秘面纱
这里,我们不是要给大家讲数学,而是通过这个最基础的数学函数,给大家讲清楚机器学习运行的本质,帮助大家破除AI的神圣光环,掌握AI的原理。
1、为什么AI听起来那么玄?
在正式开始之前,我们先花两分钟,聊聊一个现象。
很多人一听到“AI”、“机器学习”、“深度学习”、“神经网络”这些词,第一反应是:好高级、好复杂、看不懂。于是,心里产生了畏惧和抗拒心里。这种感觉很正常。我总结了一下,原因主要有三个:
第一,AI是技术概念。 技术在很多人的认知里,天然就带着“复杂”“难学”的标签。尤其是当技术涉及算法、数据、模型这些抽象词汇时,大脑自动开启防御模式。
第二,概念太多,听着听着就乱了。 机器学习、深度学习、监督学习、强化学习、神经网络、大模型……这些词像连珠炮一样砸过来,每个词都似懂非懂,放在一起就彻底糊涂了。
第三,概念太抽象,抓不住。 “模型”是什么?看不见摸不着。“训练”是什么?到底在练什么?“参数”又是什么?这些词没有具体的画面感,很难真正理解。缺少具象案例做铺垫,单纯背诵定义很难真正理解内在逻辑。
于是很多人得出一个结论:AI太深奥了,那不是我能懂的。但事实真的如此吗?
不。AI的底层逻辑,其实非常简单。简单到你初中学过的一元一次方程,就能把它的本质讲清楚。
这所以作为AI基础介绍的开篇,我们不讲复杂的概念,我们就从y=ax+b开始,把AI的神秘光环拆掉。
2、一个初中的数学题
让我们回到初中数学课堂。有一个函数,长这样:
y=ax+b
这是我们再熟悉不过的一元一次方程。它描述了x和y之间的关系。知道x,就能算出y。在这个函数里,有三种类型的数值:
自变量:x。可以主动给定的输入数值
因变量:y。跟随x变化、被动计算得出的输出结果
常量:a、b。固定不变的系数与偏移量,决定整条直线的走势
在数学的语境中,只要我们知道了常量a和b,就可以已知自变量求出因变量。那么怎么样获取常量的值呢。这就需要给你我们一些已知的x、y值。
已知我们有下面的数据:
x y
1 3
2 5
3 7
要求求出x=5时,Y的值是多少?
于是我们将已知的x、y代入函数。
当x=1,y=3:3 = a×1 + b 得到3 = a + b
当x=2,y=5:5 = a×2 + b 得到5 = 2a + b
联合求解可以求出a=2、b=1.所以我们求解出的完整方式就是y=2x+1。有了这个方程之后,我们就可以直接额根据X求出Y值。即y=2*5+1=11.
于是乎,以后我们遇到同样的问题,如x=10、x=100等等,我们都可以套用这个公式快速得到答案。
3、把数学函数翻译成AI语言
看似一道简单的数学计算题,恰好完整复刻了机器学习从头到尾的全部流程。接下来,我们做一件很重要的事:把上面那道初中数学题里的词汇,全部替换成AI领域的专业术语,就能瞬间理解机器学习本质,对应关系如下:
特征数据:对应公式里的自变量 x,是输入给模型的原始信息、条件、素材,是模型用来做判断、做预测的依据;
标签数据:对应公式里的因变量 y,是我们想要模型最终预测、输出的目标结果;
模型参数:对应公式里的常量a 、b,是模型内部需要通过数据不断调整、求解的核心数值;
模型架构和算法:对应y=ax+b整体:代表预设好的模型架构与基础算法,我们也可以统一称之为算法模型对象,相当于一个待填充的空框架。(这里对算法模型对象做一个解释:算法模型对象是一种特殊的对象,特殊之处在于,该对象内部集成/封装了某种形式的算法/方程。该算法/方程用于找寻数据间的规律。假设某一个模型内部封装的算法/方程如下:y=ax+b,它是一个还没有求出解的方程式。)
模型训练:利用已有数据得出最优参数a、b、的过程。在数学题里,我们依靠多组(x,y)已知数据,算出固定的a和b。放到机器学习里,模型训练就是投喂大量特征 + 标签样本,不断迭代求解、调整内部参数(a、b),找到一组最贴合数据规律的参数组合。一开始(a、b)是随机乱设的,计算出来的预测值和真实y偏差很大;随着不断比对样本、修正参数,误差持续缩小,最终收敛出最合适的(a=2、b=1)。这个不断试错、修正参数、拟合数据规律的全过程,就是大家常说的模型训练。训练完成后得到确定式子 y=2x+1,这个定型、可用的式子,就是训练完成后的AI 模型。
模型:指训练好的模型,简单理解就是已经求出参数的算法模型对象。这对AI产品经理非常重要,因为他属于一个AI产品,AI产品经理很多时候就是对AI模型的应用。
模型应用:用训练好的模型对新数据做预测
4、所以,AI到底是什么
在我们用AI的视角,重新描述刚才那道题:
我们有历史数据:x和y的对应关系(1、3,2、5,3、7)。
我们有一个算法模型对象:y=ax+b。
我们用这些数据去“训练”模型,就是找到最合适的a和b,让模型能够尽可能准确地拟合这些数据。
训练完成后,我们得到了一个“模型”——y=2x+1。
当有一个新的x(比如x=5)时,我们用模型去“推理”。y=2×5+1=11。
这就是AI的全部。整个AI的核心逻辑,不外乎如此。
你可能会说:“这也太简单了吧?真正的AI肯定比这个复杂得多。”
你说得对。真实的AI模型确实复杂得多。它们可能有上万亿个参数,比如大模型。他们的模型架构不是y=ax+b而是一层层神经网络,训练数据不是几行而是几十亿条。
但本质是一样的。复杂的模型复杂的点体现在数据工程、训练参数等方面。但是复杂模型做的事情,和y=ax+b做的事情,没有区别。都是“用数据找规律,然后用规律做预测”。唯一的区别是:y=ax+b找的是直线规律,而深度神经网络找的是极其复杂、人类无法直接理解的高维规律。
一旦你理解了这一层,很多AI概念就不再神秘了。“训练模型” 不是什么玄学操作,就是用数据去算参数。“参数” 也不是什么神秘数字,就是决定输入输出关系的系数。“模型推理” 不是什么高级智能,就是把输入代进公式算出结果。“模型效果不好” 不是什么系统崩溃,就是参数没算好,或者数据不够。原来,AI没有那么神。
它不是机器产生了意识,而是我们帮机器找到了数学规律。但当拨开这些华丽的外衣,你会发现底层逻辑——就是我们刚刚用y=ax+b讲清楚的那些东西。
这不只是AI算法工程师的活,作为AI产品经理,我们为什么要掌握这些东西,因为我们要做判断、做方案、为结果负责。当算法工程师说“模型正在训练”,你知道他们是在用数据调参数,而不是在创造智能。当他们说“模型效果不太好”,你知道问题可能出在数据、参数或模型架构上。你要知道,在一个具体的业务场景里,什么是特征x?什么是标签y?我用什么样的模型架构?需要多少数据才能算出可靠的参数?当你开始这样思考时,你已经不再是一个“听技术的产品经理”,而是一个合格的AI产品经理。
本文由 @老赵的产品论 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自作者提供


- 目前还没评论,等你发挥!