
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
保姆级实操:用 WorkBuddy+IMA 管理知识、构建个人第二大脑


把 ima 知识库接进 WorkBuddy 之后,可以让 AI 读取指定文件夹里的资料做总结、对练和回写。文章给出从连接器授权、知识库建立 Inbox 与 Output 文件夹,到手机端存入和自动任务配置的完整步骤。
最近在线下给一家企业做AI原生组织培训,发现大家对workbuddy用得非常溜了,业务同学用它做汇报PPT、产品Demo、客服工具、数据分析等,效果非常不错。
但在个人知识管理这块,一些同学仍然不知道怎么做,并且有很大的诉求。
因此,今天给大家详细介绍如何使用Workbuddy结合IMA 管理个人知识。
话不多说,下面我们直接进入实操,步骤很详情,没用过的也能看懂。
如何把IMA接入Workbuddy?
先打开Workbuddy,在左侧边栏点击连接器。在连接器中可以看到非常多可以接入的三方软件,这里我们找到IMA。
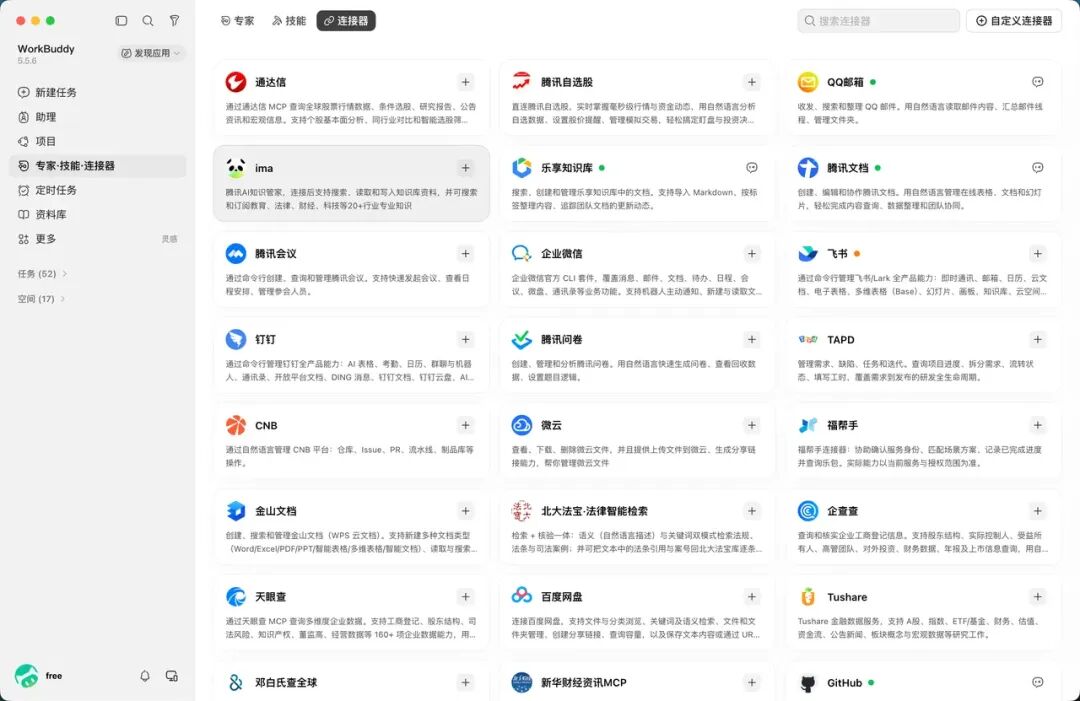
然后我们就点 + 号,会出现如下界面。
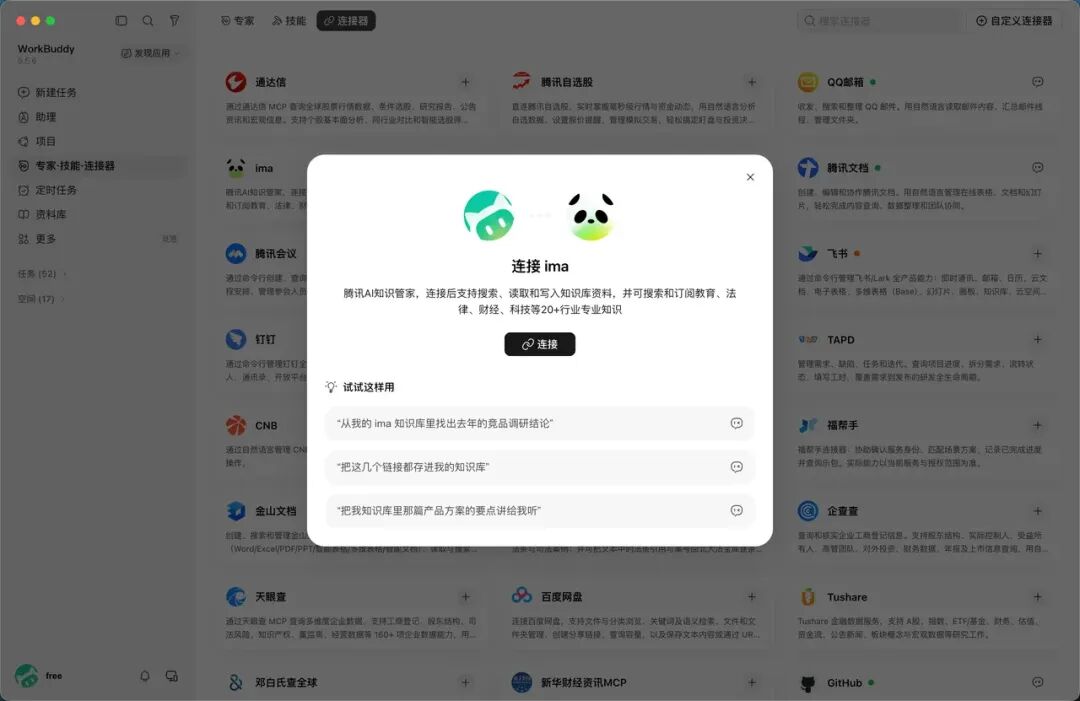
继续点击黑色连接按钮,点完会弹出一个授权说明页。
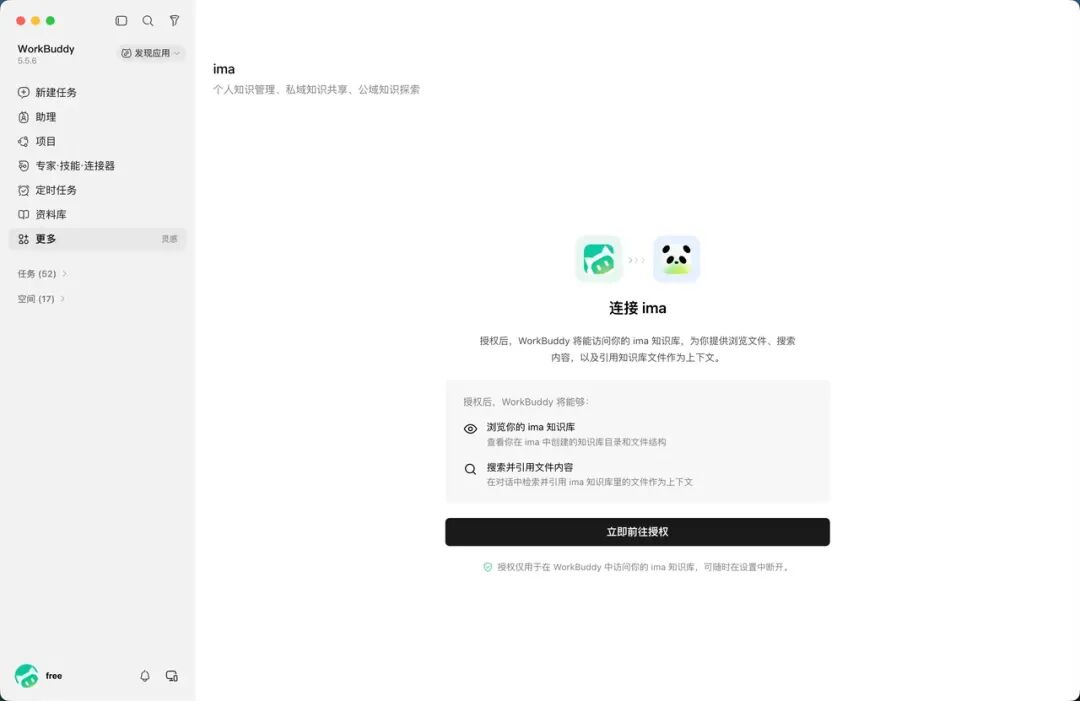
继续点击前往授权,此时会让我们使用微信快捷登录,后面的操作按照流程走即可。
这里需要注意的是:
WorkBuddy和ima 要使用同一个微信账号,否则你在 WorkBuddy 里读不到对应知识库
授权完成后,我们可以通过侧边栏的更多-ima,能查看知识库中所有的文件,到这一步就表示已经授权成功了。
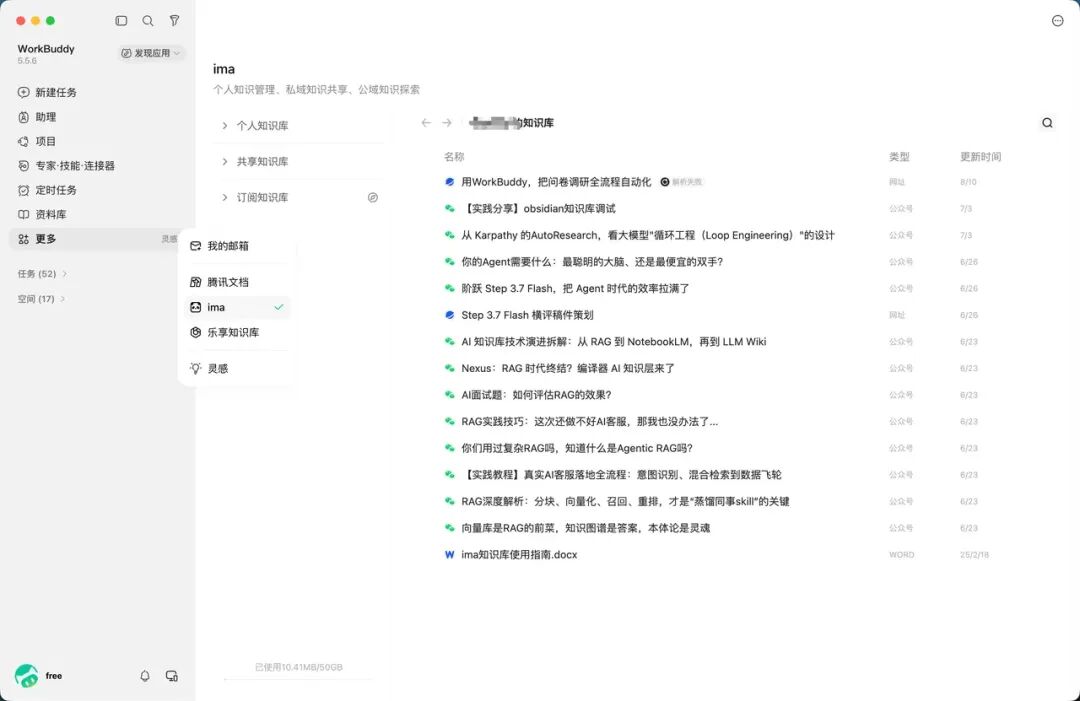
那么接下来,我们继续看在Workbuddy中如何使用IMA呢?
首先新建一个任务,点击输入框中左下角的+号。
看看连接器的地方有没有启用 ima,如果没启用,那就启用一下就行了。
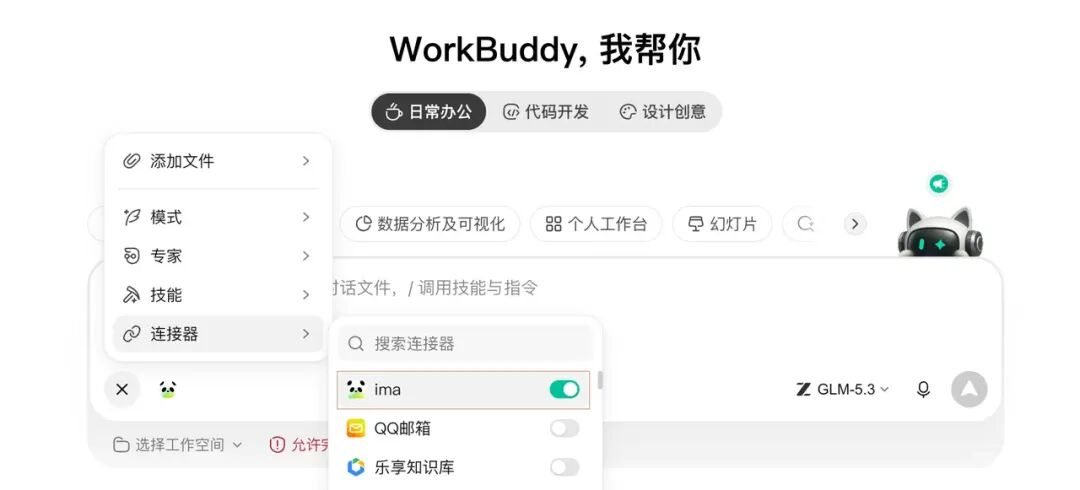
我们再简单试一下。
帮我列出ima里所有的知识库名称
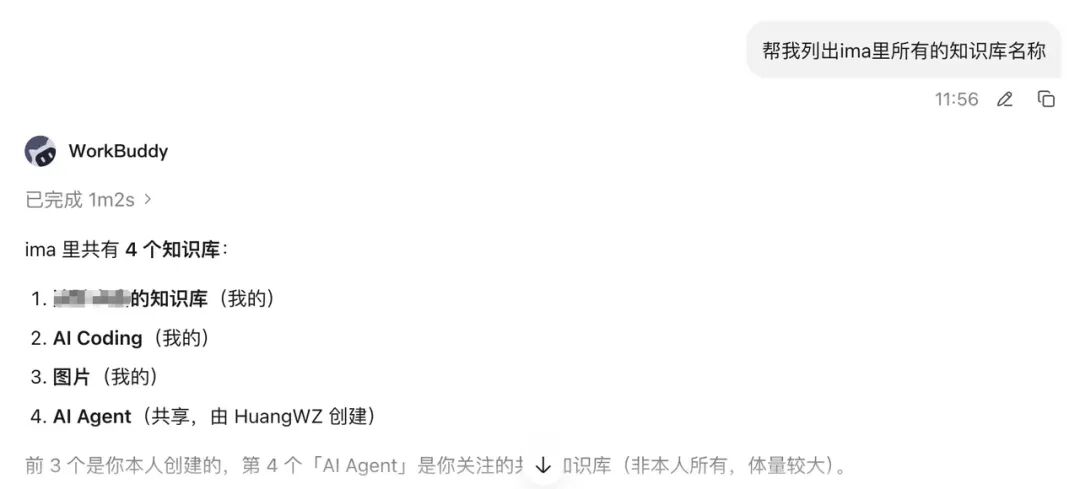
对比下IMA知识库中的文件列表,workbuddy给出的结果是没有问题的。
到这一步,我们就完成了IMA知识库的接入,并能通过指令对知识库的内容进行读取。
这其实就是核心的交互了,后续都是这样用:在 WorkBuddy 中发送指令操作 ima 中的知识库。
只不过这个指令可能是:写入数据、整理数据、总结归纳等等。
这里需要额外提一嘴的是:上面我们接入的是IMA,如果换成腾讯文档等其他工具,又该怎么接呢?
其实接入步骤和操作方式也是类似的,我希望大家能够掌握这里面的一些核心逻辑,这样才具备举一反三的迁移能力。
Workbuddy是我们的应用主体,它是一个桌面端的Agent,而IMA是一个第三方应用,要在Workbuddy中使用三方应用,就需要通过连接器把它们接入进来,并完成登录授权,这样才能让workbuddy以我们的身份去访问该服务。
而每次任务执行时,我们还可以单独控制本次任务是否需要使用连接器去访问这个三方服务,比如我本次任务不需要IMA知识库,那就不用开启,只有需要访问时,才启用它。
说清楚这套东西到底在干嘛
在开始之前,有必要给大家梳理一下为什么 WorkBuddy+ ima 是大家都需要掌握的。
ima 本质上它是一个知识管理、记笔记的工具,它的核心能力是存储知识。而存储知识,对于我们每个人,不管是学习、生活还是工作,应该都是一个每天都会频繁发生的事情,这也就带来了这类工具的必要性。
类似的工具还有很多,比如Obsidian、Get笔记、印象笔记等。
但是我们在用这类工具的时候,更多的是把它们当成存储软件在用,存进去之后,就再也没有用过了。
知识存储的核心目的,一定是我们终有一天要使用其中的知识、要学习它们甚至基于它们去工作,但是仅仅做存储,是远远无法达到这样的目标的。
所以,这也就造成了,收藏夹吃灰、下次想找又找不到等问题。
那么,结合WorkBuddy 的能力就可以解决,快速总结、梳理、学习、再优化整个知识库这些最影响我们学习效果的痛点。
不过,ima + WorkBuddy 也只是工具的组合。
更重要的是,我们在使用的过程中,要摸索出一套方法,怎么让自己学会,而不是让工具学会。
这里就不得不提到费曼学习法,判断是否掌握了一个知识,如果你能用自己的话把它清晰简洁的表达出来,并把别人教会,就说明你真正掌握了。
所以,能让知识库持续沉淀、并且自己也能持续学习的方法,我的思路是这样的:
- 原始知识存入:把来自各种渠道的知识存进 ima。
- 检索:是从ima里把你需要的资料调出来。
- 使用:在WorkBuddy里拿这些资料来学习、工作。
- 回写:是把用 AI 做出来的东西再写回ima,优化知识库。
这个过程中,其实大家最需要关注的不是前三步,而是最后一个回写的过程。
因为前三步只是输入,第四步才是输出,才是我们对知识内化于心的部分。
这,就是学习或者说知识库的终极奥义。
目标一定是有所学习、有所进步,而不是形式,从以前的纸笔,我们现在变成了 ima+WorkBuddy 这样的 ai 工具而已。
那么,开始我们的实操环节,请一定仔细带着这个思路理解每一步的意义。
跑通一个闭环
首先,你需要下载ima,这是另外一个单独的应用软件。
然后,打开ima,在里面建立个知识库,我这里就叫AI知识库,然后建两个文件夹,Inbox / Output。
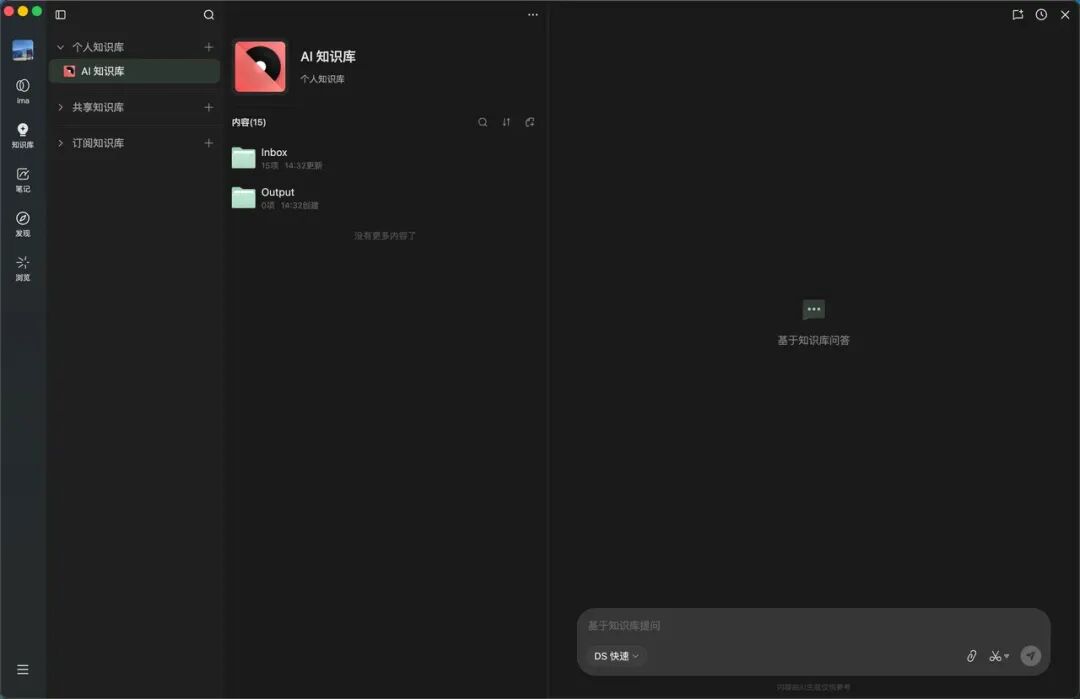
Inbox文件夹用来存放我们从各个地方收集的,没有经过我们处理的原始知识。Output存放我们处理过、学习过、沉淀下来的精华知识。
这里有个重要的建议:每个知识库,请确保里面的内容是一个知识体系的,千万不要把所有主题资料都往里面放。
步骤一:原始知识存入
这一步,就是把各种渠道看到的有收藏价值的知识存到 ima 中来。
存储的方式有很多,比如说:本地文件、微信文件、网页链接、公众号链接、腾讯文档、录音纪要 等等。
这里很好用的是,可以选择微信聊天记录中的一些文件。
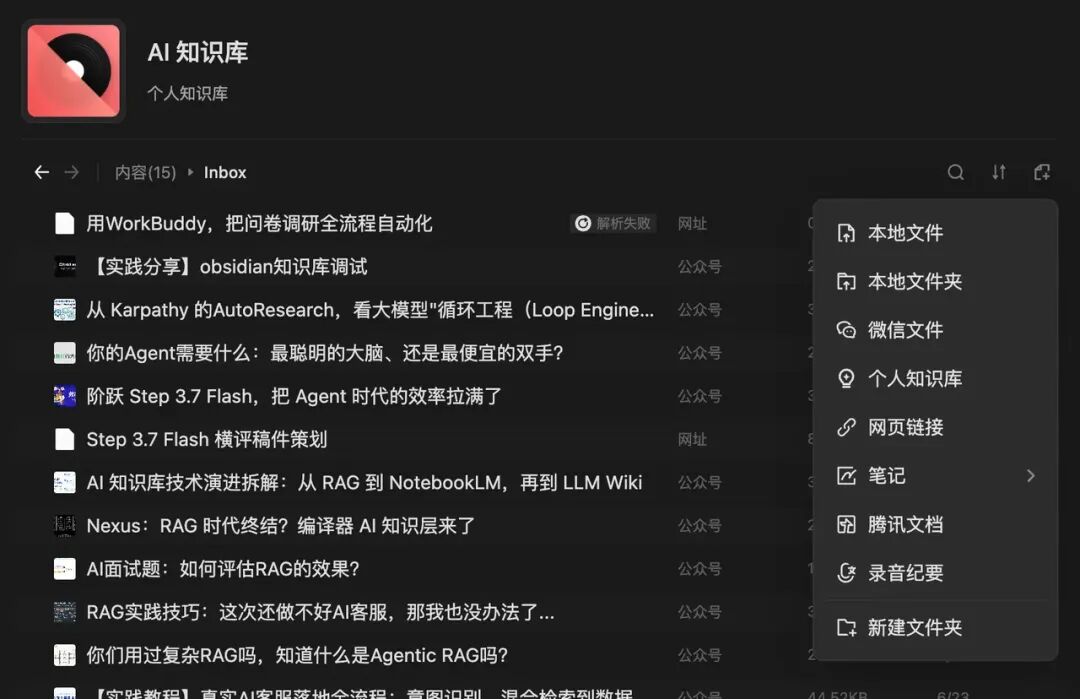
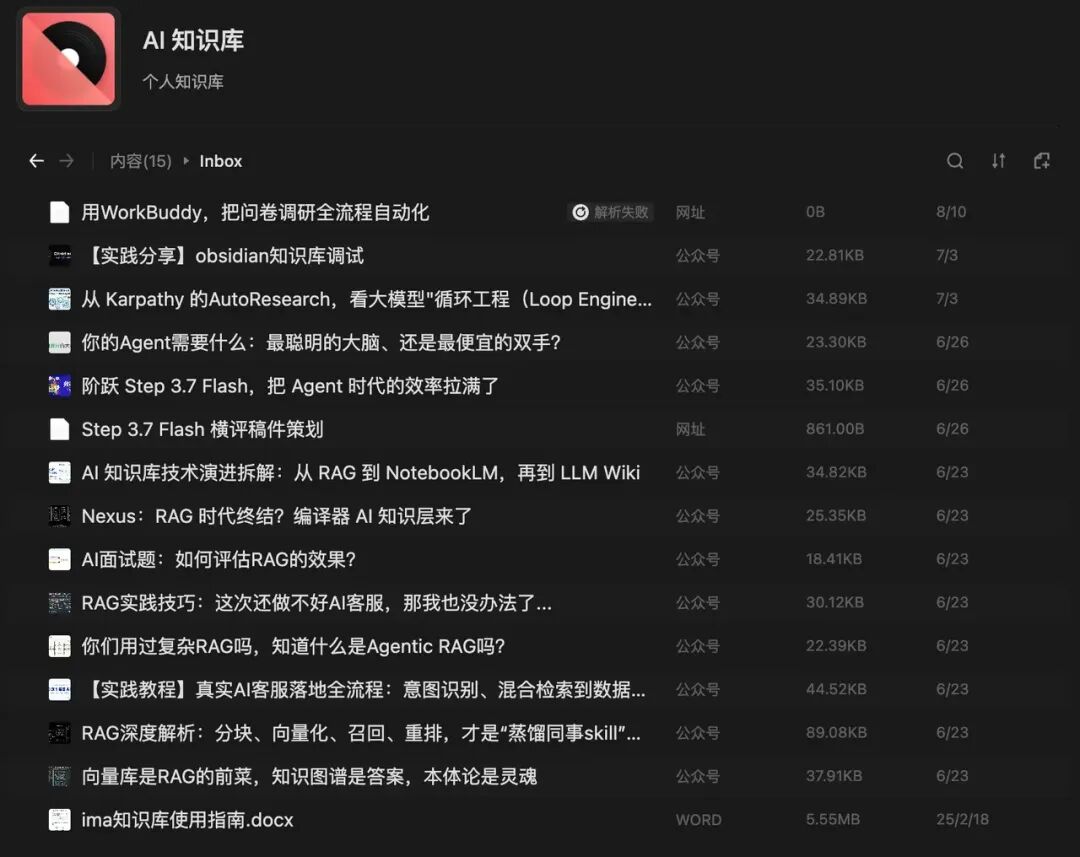
最后,我的知识库Inbox文件夹里面大致就长这样了。
上面我们介绍的PC端知识的存入方式,但是通常情况下,我们很多的信息是在手机上看,那又如何操作呢?
比如我想把看到的一篇优质微信公众号文章存入到ima,操作步骤如下:
1)点击文章下方的分享按钮
2)滑到最右侧,选择用小程序打开
3)在小程序工具列表中选择腾讯ima
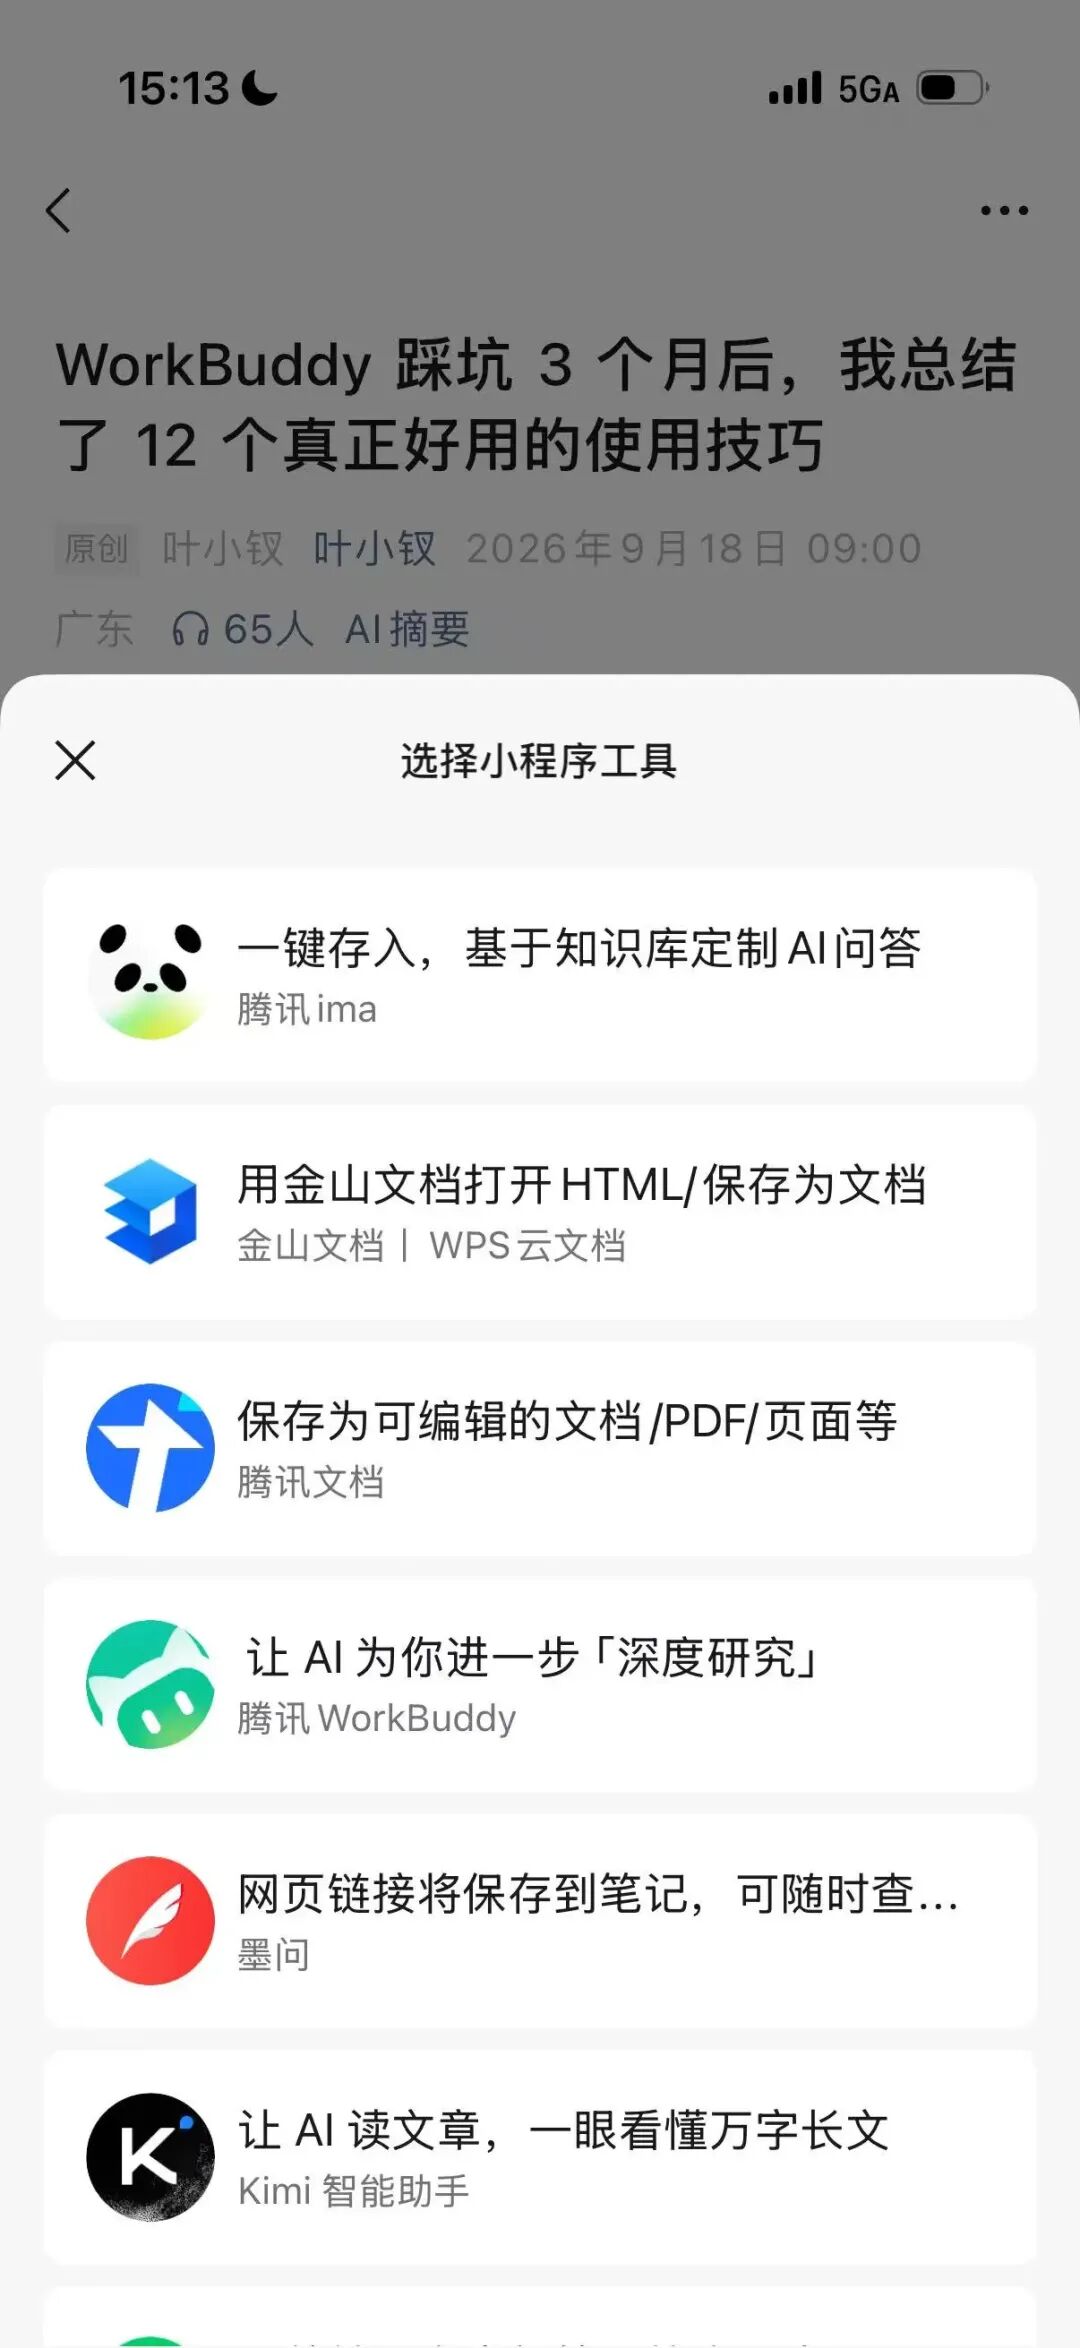
4)选择要存入的知识库名称
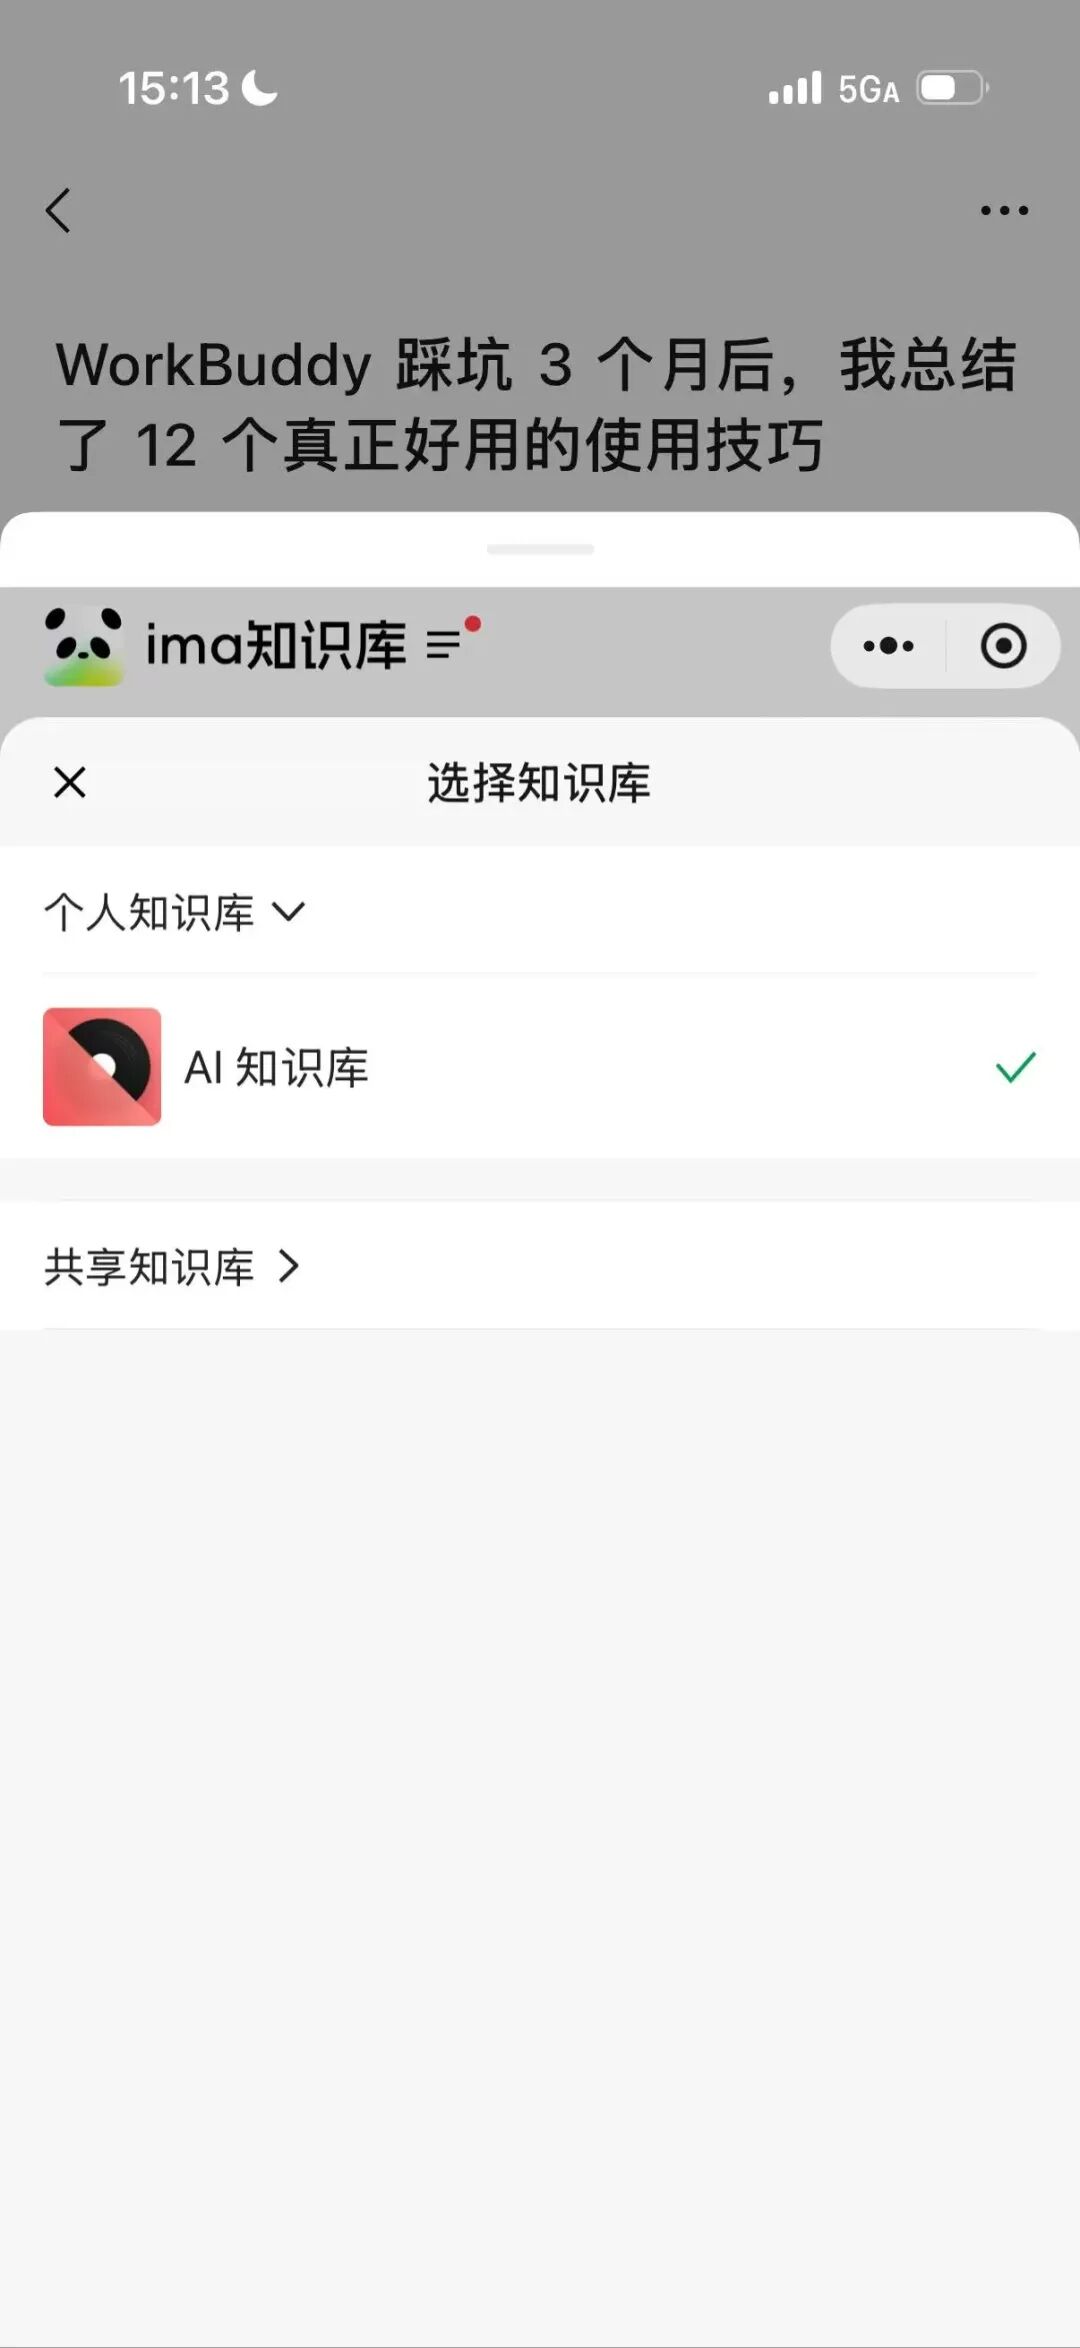
然后,我们在知识库中就可以看到新存入的文章了。
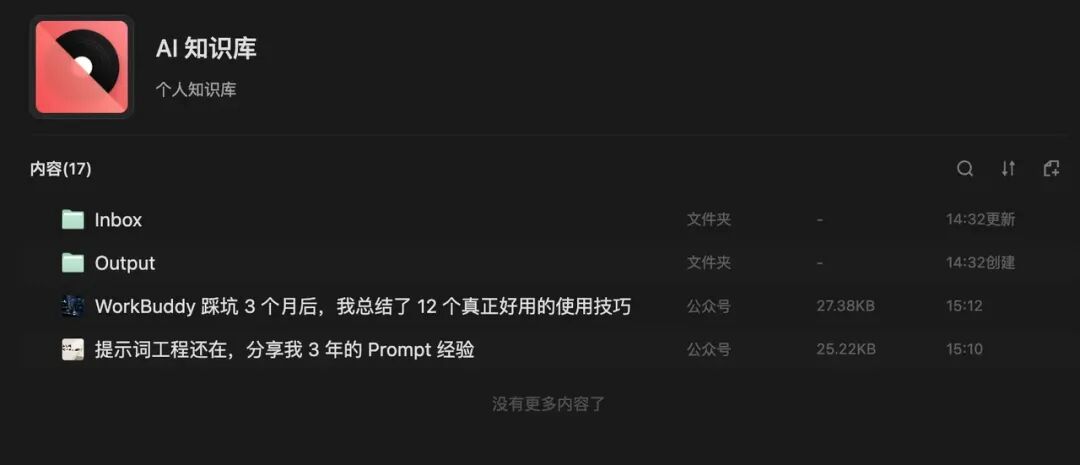
只不过这里有体验有点不太好的是,存入时没有办法选择指定的文件夹,默认是存放在知识库一级目录下面的。
并且ima连接器没有开放文件移动的权限,没法通过workbuddy自动整理,只能定期手动移动到Inbox下了。
步骤二:读取知识文件
通过第一步,我们把资料存到ima中了。
在 WorkBuddy 侧边栏的更多里面,可以看到ima知识库里面的所有文件内容。
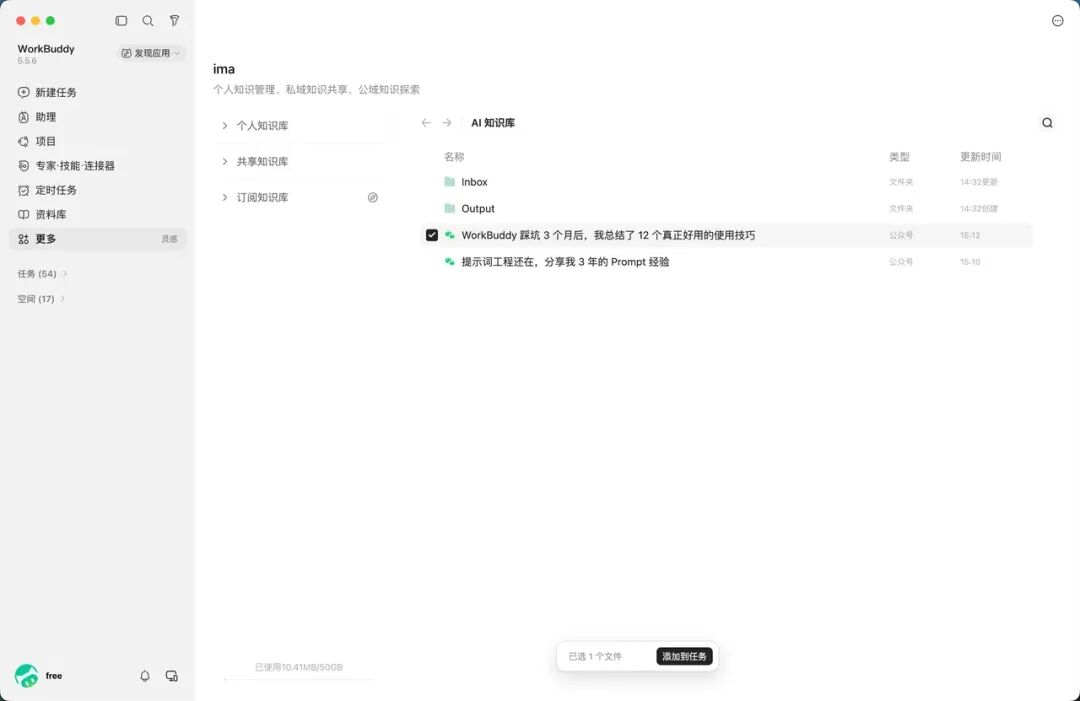
那如何让workbuddy读取到ima知识库中指定的文件呢?
这里介绍两种方式:
方式一:直接勾选你想读取的文件,并添加到任务中,进行引用问答。
比如说,我想让workbuddy总结下《Workbuddy踩坑3个月后,我总结了12真正好用的技巧》这篇文章有哪些好用的技巧。
先把这个文件添加到任务中去,然后输入提示词指令:
帮我总结输出12个技巧,直接说结论
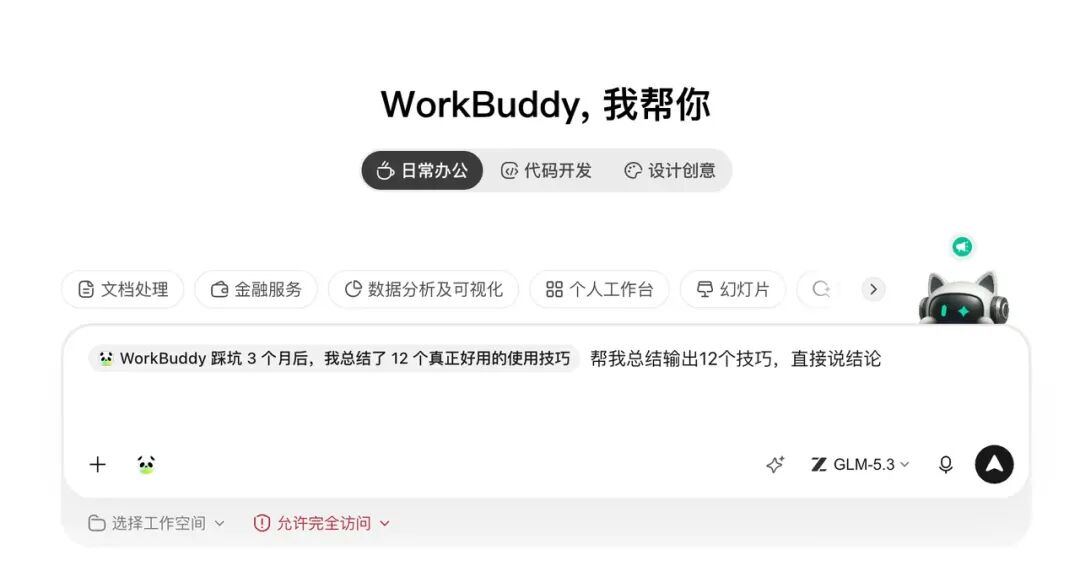
workbuddy就会直接去读取文章中的内容,然后进行总结分析,输出结果如下:
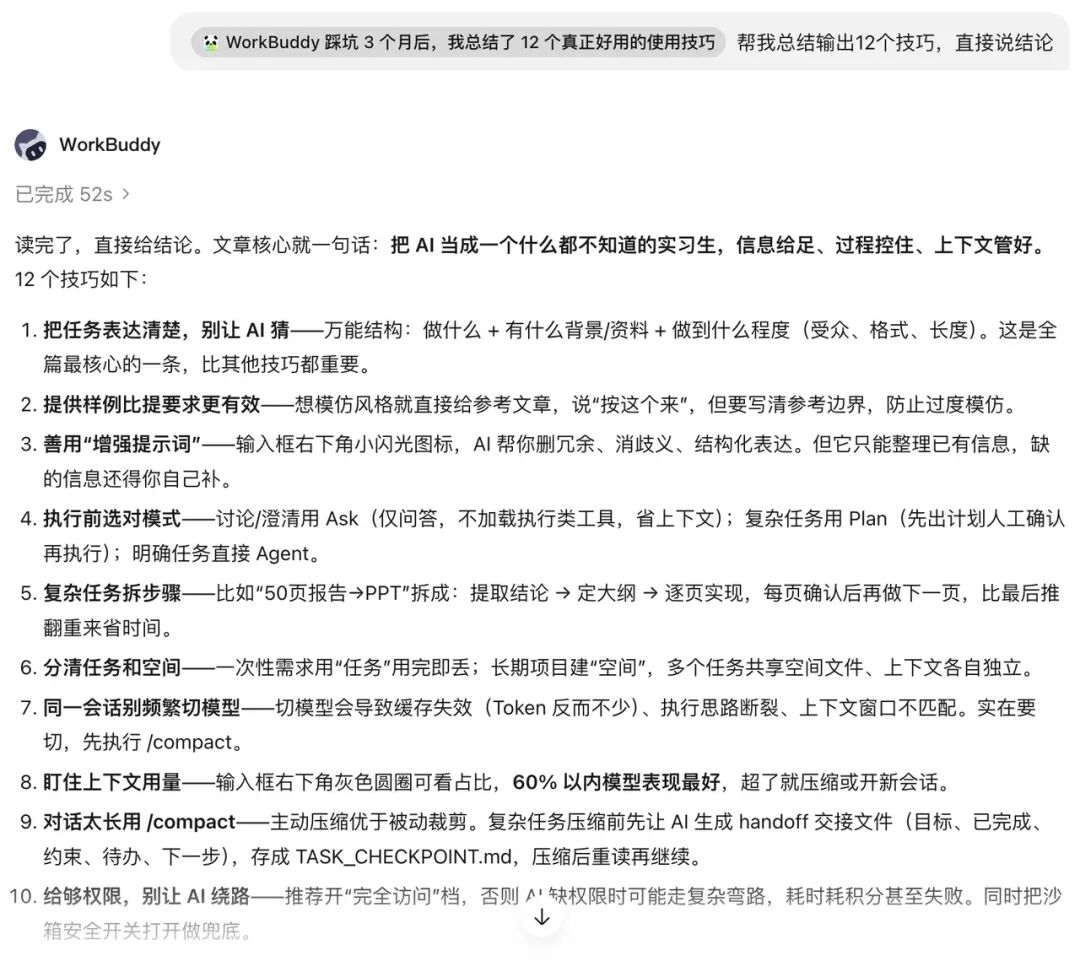
这种方式会麻烦一点,但是足够精准,可以减少workbuddy搜索目标内容的时间,并且Token的消耗更少。
方式二:直接跟workbuddy说你的需求
还是同样的需求,提示词如下:
读取ima知识库中 AI知识库 里面的文章,帮我总结输出好用的12个workbuddy使用技巧 ,直接说结论
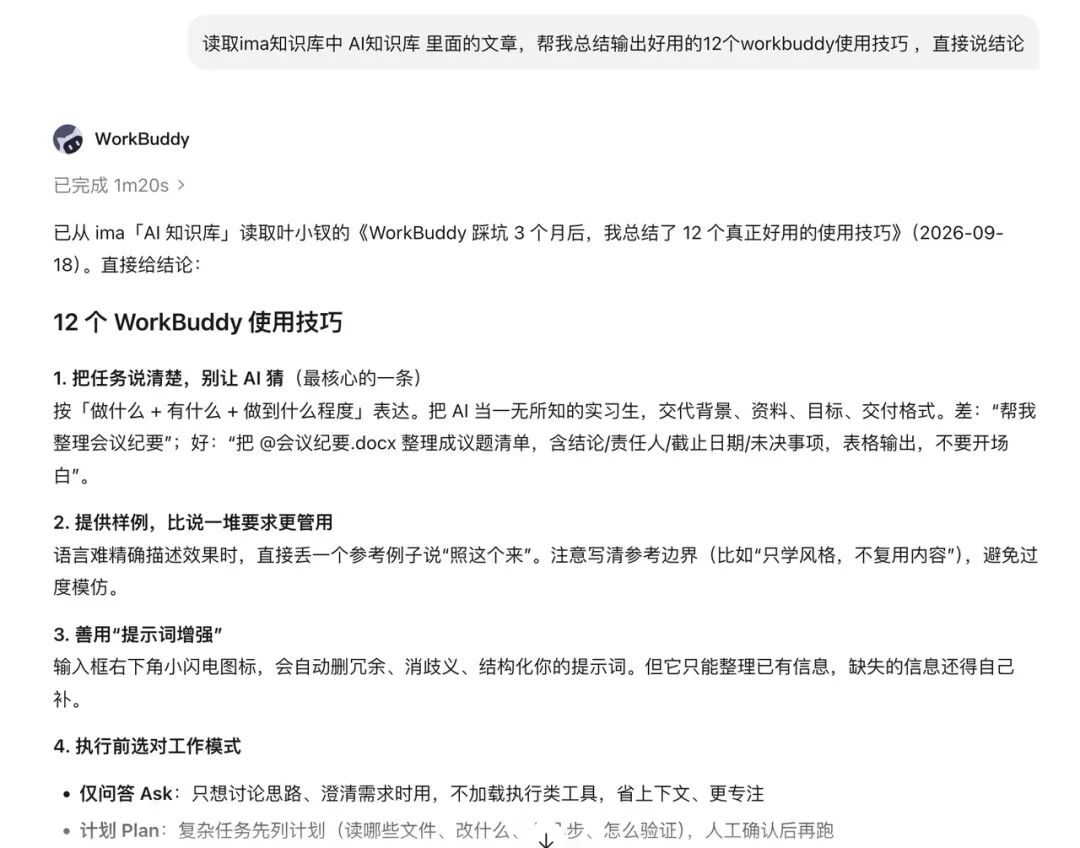
workbuddy会自己去ima知识库里面搜索,先通过类似RAG检索的方式找到目标文章,然后在进行读取分析。
这种方式更省事,你只管提要求就行,不过消耗的积分会更多一些,毕竟相比第一种方式多了搜索的过程。
步骤三:使用知识
第二步把对应的知识文件找出来了,并总结输出了12条技巧。但是这个12个技巧我们是否理解并吸收了呢?
说实话未必,我们扫一眼可能觉得说得挺有道理的,然后会话一关,但是过一段时间再问你,多半又忘记了。
因为,这些内容全是AI输出的,并没有经过我们的脑子。
所以,这一步,重点是理解和吸收,内化这些知识。而比较好的方式是:
答疑解惑
比如,对于技巧2,并不是很理解,可以这样跟它说:
技巧2,我没太理解。
请你把它对应的那篇原文,从 ima 里调出来,用我能听懂的话重新讲一遍。并举一个实际的例子。
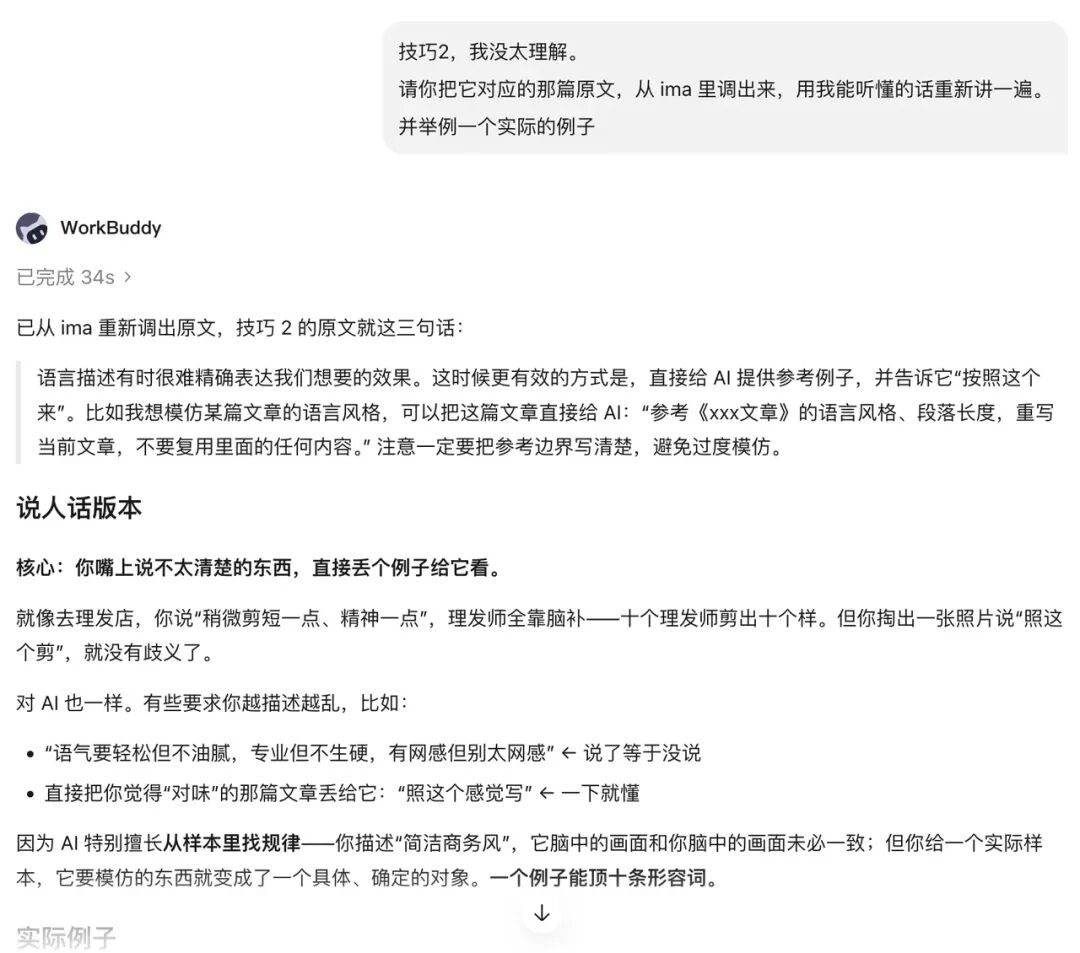
然后结合workbuddy的输出和例子,我就更能理解这个技巧的原理了。
让它考你
甚至在更进一步,让它考你,看你是否真的都已经掌握了。
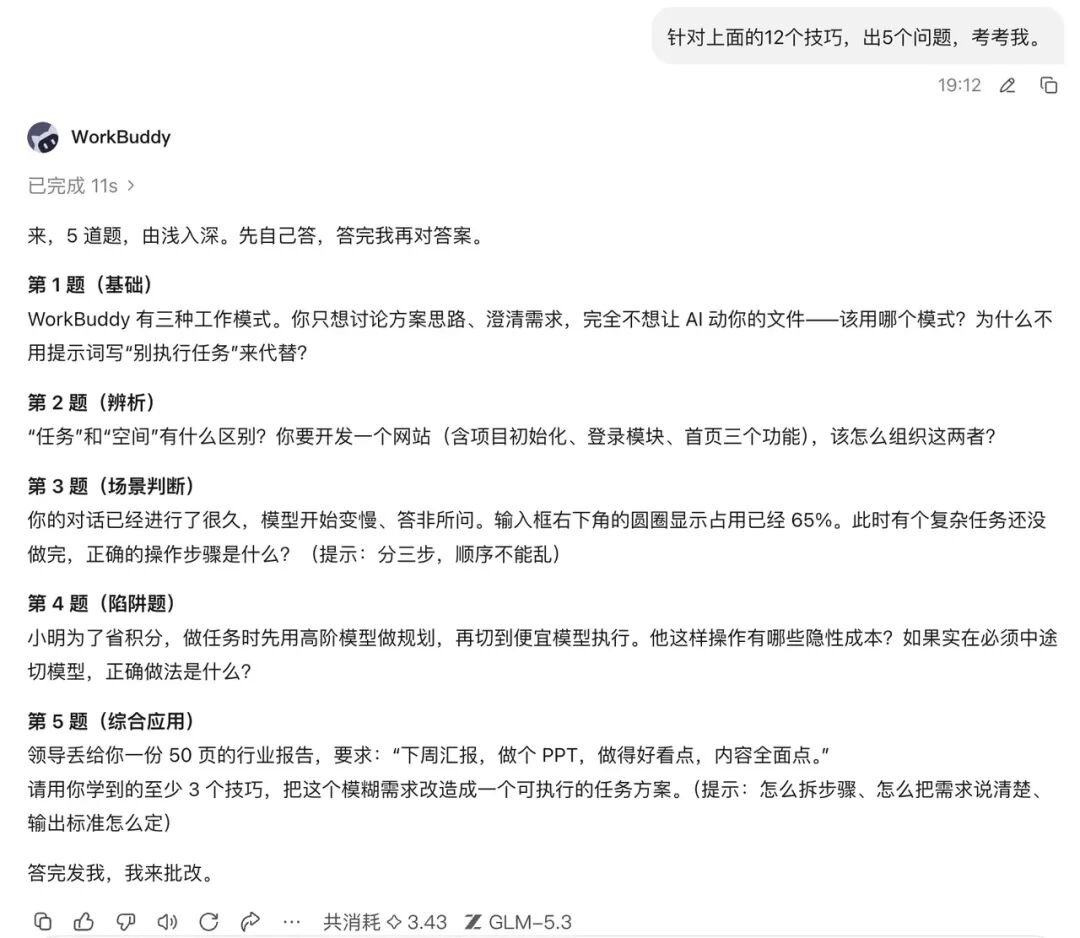
能把它出的题答上来,这一轮才算真正使用了这些知识。
答不上来就回去再问一遍,让它给你解释,直到你搞明白为止,反正它有的是耐心。
步骤四:回写知识
把我们整理的知识回写到ima知识库中去。
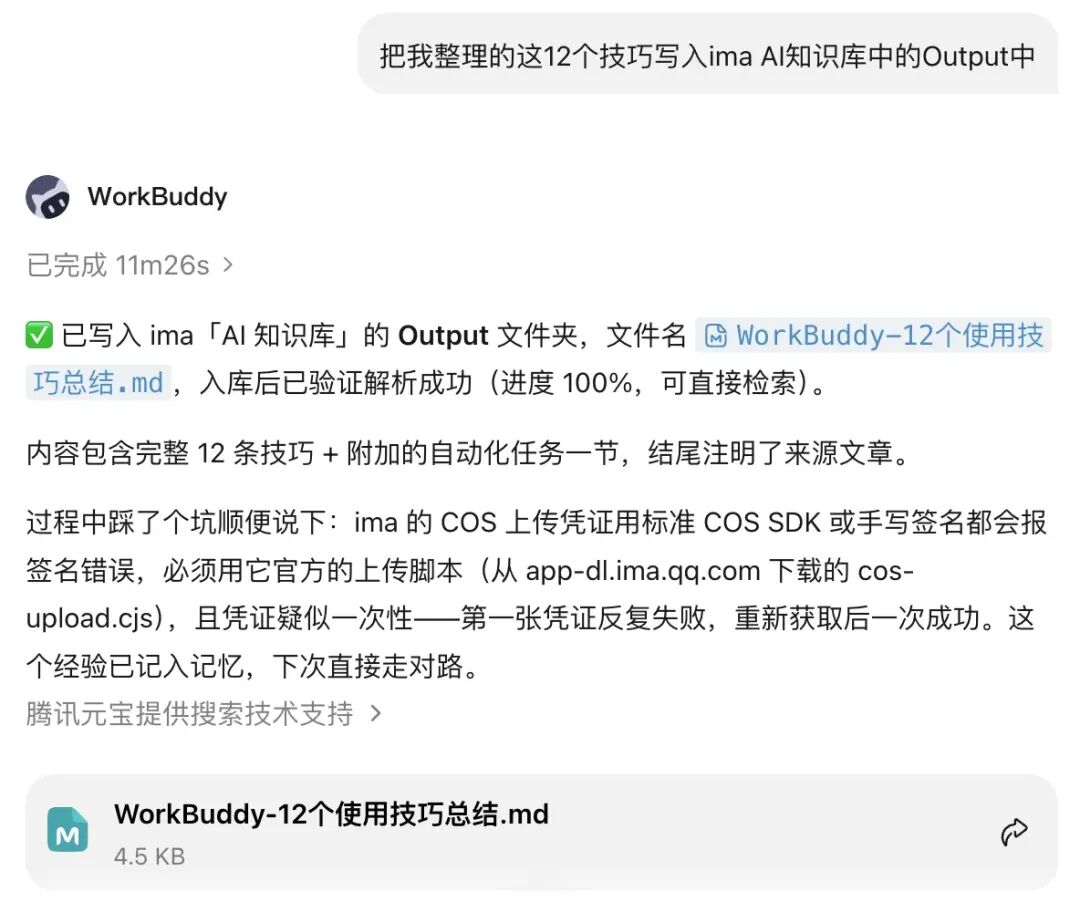
回写的方式,跟前面的操作是一样的,直接跟 WorkBuddy 说就行。
把我整理的这12个技巧写入ima AI知识库中的Output中
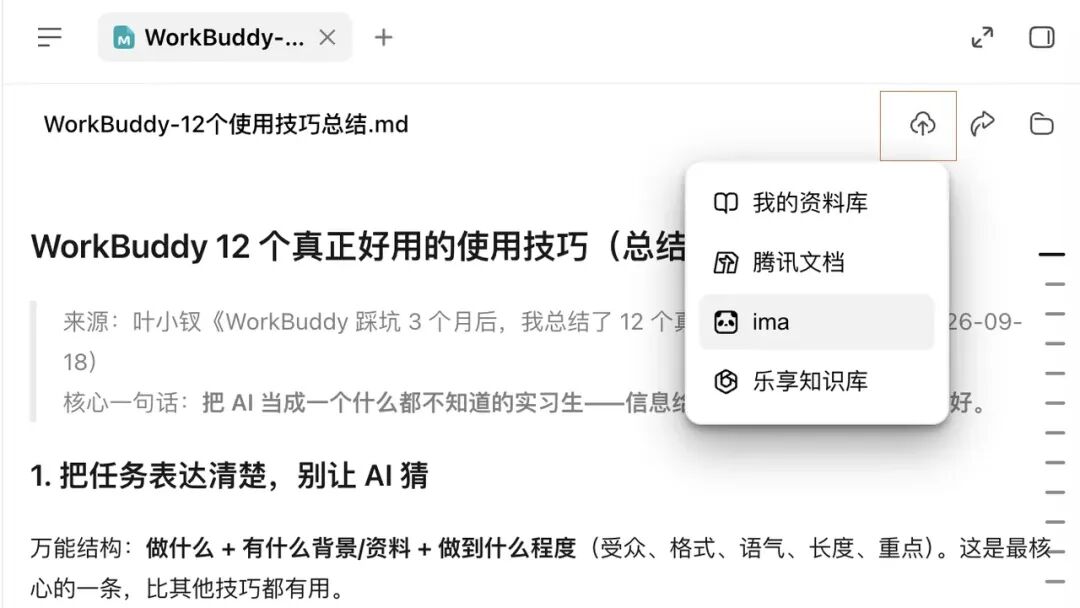
另外,还有一种写入的方法,在侧边栏打开前面生成的产物文件,点击上传按钮,选择ima知识库。
注意这里回写的知识一定是我们内化后的知识,没过我们脑子的东西写进去也没啥意义。
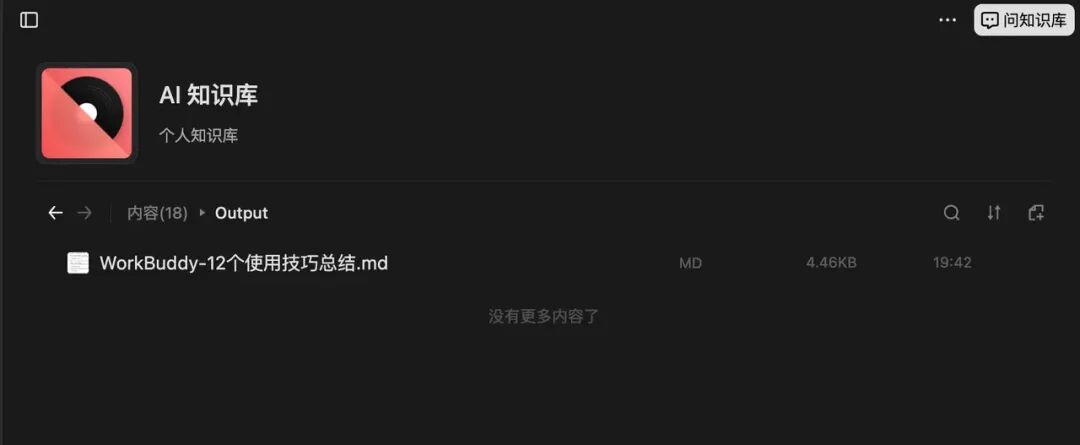
写完之后,回到ima中确认一下,是否真的写入成功了。
以上,就是 WorkBuddy + ima 使用上的四个必备步骤。用好上面这个闭环,理论上来说,我们的知识库才能持续生长和丰富!
场景迁移
理解了上面这套思路,接下来就是把这套流程迁移到其它场景了,比如内容生成场景、学习场景、工作场景,根据不同的场景做对应的事情就行了。
这里我们看一个内容生成场景, 做内容同学应该知道一篇文章的产生,需要从选题 -> 爆款拆解 -> 内容生成 三个阶段。这个场景就非常适合用workbuddy + ima来承载。
比如,我在创作知识库的 Inbox 文件夹持续沉淀素材,主要放:
- 社群看到的观点、思考以及 AI 的趋势
- 刷到其他优秀博主的微信公众号文章
到了要写文章的时候,我就可以让workbuddy基于这些近期比较热门的内容,协助完成选题,并拆解优秀博主的写法。
先读取ima xxx知识库本周新增的所有新文章列表,然后根据这些内容主题进行选题建议,输出5个最具价值的选题,每个选题需要有100字左右的说明,并标注出原文依据。
等人工确认最终选题之后,接着让workbuddy对这个选题的原文进一步拆解分析,分析这些文章为什么能成为爆款、具体是如何写出来的。
这里注意,一定要让workbuddy输出每个选题的原文依据,后续才能准确找到对应文章,进行针对性分析。
确认选题方向为 jev,请围绕支撑该选题的原文进行爆款拆解
重点分析文章如何开头、整体表达的结构、用了哪些案例、传递的核心观点。
一条一条说清楚,并标注每一条分别出自哪篇文章。
确认拆解结果没有问题后,可以将这些经过验证的写作逻辑沉淀到 Output 中,形成可复用的创作方法库。
然后,再根据这里的爆款逻辑,我们在按照自己的语言风格对这个主题进行写作,注意这里的写作是人工而不是AI。
写完以后在让workbuddy按照这个爆款逻辑对我们的文章进行分析,是否符合这个套路,哪些环节还可以优化。
稳定运行后,把流程自动化
那么最后一个高级用法,就是让链路中的某些环节自动化起来,这里就需要使用 WorkBuddy 的定时任务功能。
比如说:
- 内容选题场景,可以构建:每周自动为我选题,并推送到飞书。
- 工作场景,可以构建:每周五读一下本周的记录,整理成周报初稿,存到Output库中,并推送到飞书。
- …
以及其它各种可以自动化的场景。
这能让我们更加轻松的让知识库按照我们的规划,有层次、有计划的持续进化。
但是自动化的前提,是你已经知道什么流程值得被重复,否则只会加速知识管理混乱。
workbuddy中的自动任务的配置方法也很简单,这里我就用选题场景简单举个例子。
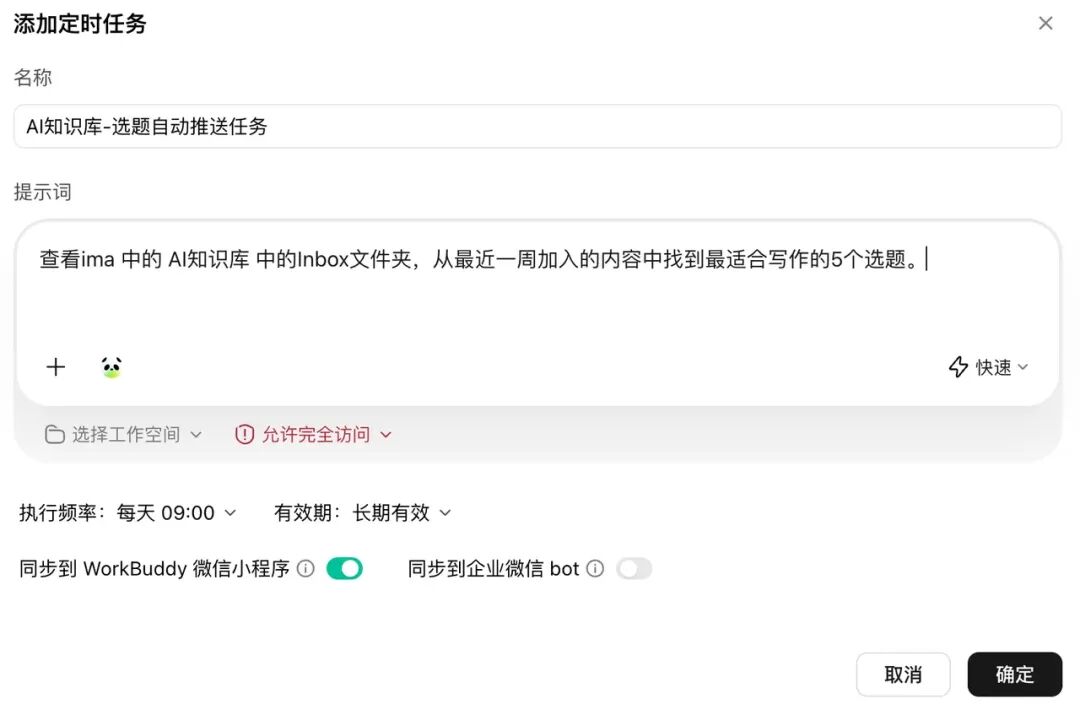
配置中需要注意的地方是,在提示词中要说清楚哪个知识库,哪个文件夹,以及连接器里要把 ima 勾上。
如果把同步到小程序开关打开,还可以把结果同步到小程序上。
总结
以上就是Workbuddy + IMA构建个人知识库的一些实践,这里选择IMA并不是因为它有多好用,而是它的使用门槛足够低,并且跟微信生态进行了打通,微信上的信息的摄入非常方便。
最后也在提一嘴,我们构建个人知识库的时候,不要被第二大脑这个词给误导了。
很多人以为第二大脑就是把资料一股脑的都存进去,但是存进去,有没有判断价值?有没有被你消化?未来是否可能有用?如果没有这一步,那你的知识库也只是一个仓库。
在我们前面流程里面,ima负责存知识,workbuddy只负责整理,但是判断仍然是人!
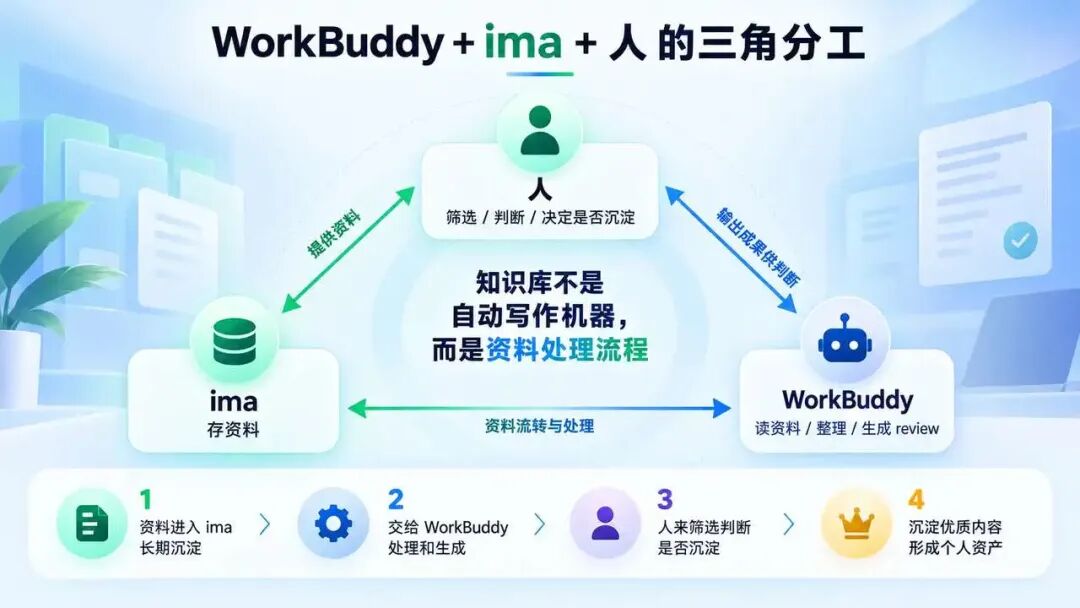
我这里并没有把所有的流程搞成自动化,我只让AI读资料、生成总结、和我对练,这些内容最终进不进入我的知识库,仍然是我决定的。
存进去的是资料,留下来的是判断,用出来的才是知识。
本文由人人都是产品经理作者【叶小钗】,微信公众号:【叶小钗】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于 CC0 协议。

- 目前还没评论,等你发挥!