起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
首个记忆原生大模型开源,36B 本地部署实测:成功把规矩”刻”进脑子


AI 编程最痛的不是写不出代码,而是换个会话就忘光。MemT-1 想做的事很直接:把踩过的坑写进模型权重,36B 版本在单卡 A100 上跑通,长程任务里到底管不管用,这篇给了实测。
做智能体或者日常用 Cursor、Claude Code、Windsurf 等 AI 辅助写代码的老铁们,大概率都经历过同一种“内伤”:
你在项目根目录辛辛苦苦写了几百行 CLAUDE.md、AGENTS.md 或者 .cursorrules,把架构分层、命名规范、私有异常和避坑细节对齐得清清楚楚
结果只要对话轮次一多,或者另外新开一个会话窗口,AI 转头就忘得干干净净,反复在同一个坑里摔跤,你又得一遍遍人肉纠正
关闭会话窗口的瞬间,AI 就如喝了一碗孟婆汤,所有踩过的坑、纠正过的错,全都要从零开始重新教一遍
大模型能不能像人类顶尖工程师一样拥有自己的“错题本”?经验写进模型后,后续任务到底能不能真正用上?
10 月 20 日,深耕智能体记忆机制的记忆张量(MemOS)团队正式发布并开源了 MemT 1.0,官方称其为首个采用记忆原生架构的开源大模型
刚瞄了一眼,MemT-1 系列在 Hugging Face 开源仅 8 天,全系列在 Hugging Face 上的总下载量即将突破10万次大关(Nano 5.5万 + Flash 4.4万)
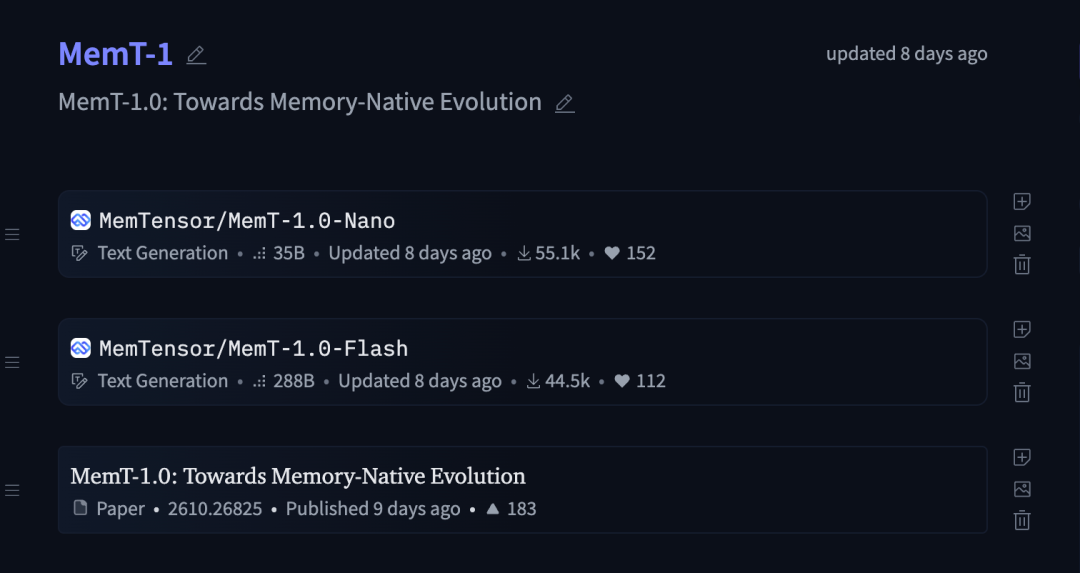
为了探探它的底细,老章开了一台 Google Colab A100 80G 实例,拿 36B 的 MemT-1.0-Nano 跑了一个实测:
先注入四条严格的金融支付私有架构红线,清空明文上下文,在零小抄下让它写接口,它纯凭内部记忆把四条规矩的核心要素都写进了代码,细节上也有几处与规范不一致;4 个会话的记忆状态池一共只占约 200 MiB 显存!
话不多说,我们直接来看实测全过程
A100 极限实测:36B 私有规范全记录
我的测试环境情况:
GPU 型号:NVIDIA A100
显存容量:80 GB HBM2e
驱动版本:580.82.07
CUDA 版本:13.0
系统物理内存 (RAM):167 GiB
推理服务框架:SGLang 0.5.16
模型,我选的 MemTensor/MemT-1.0-Nano 官方原版
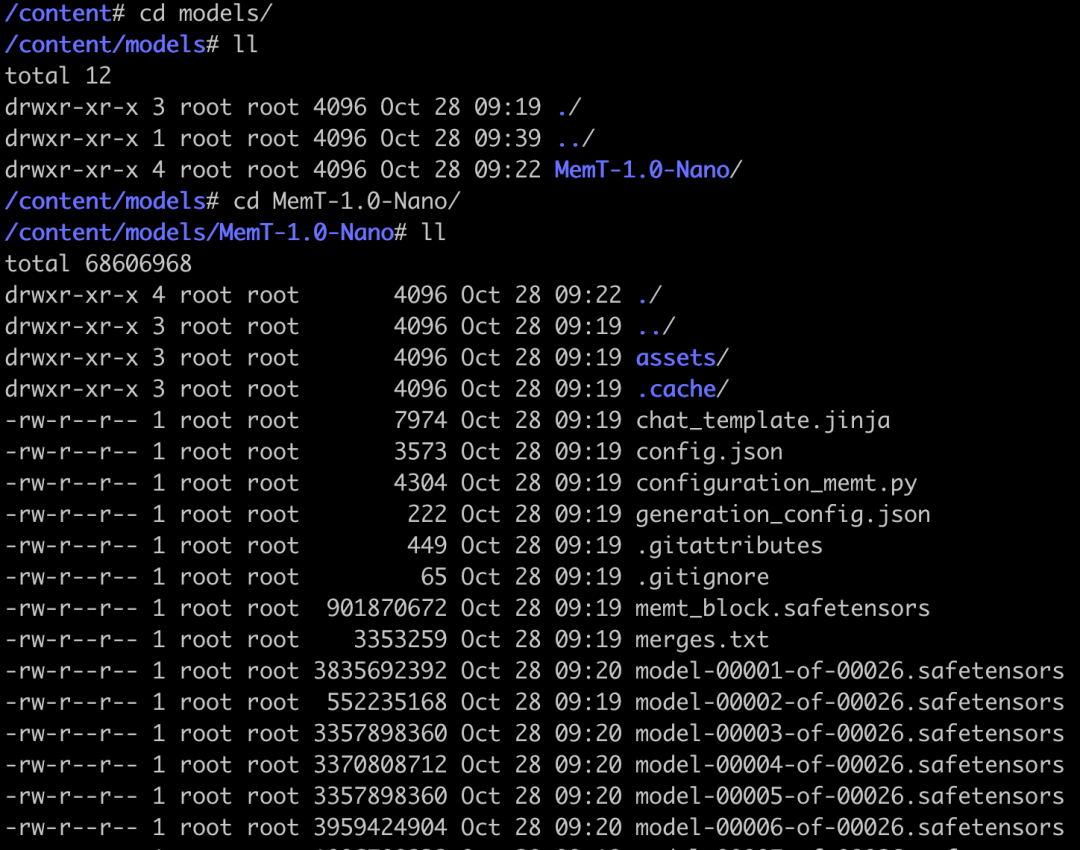
官方启动脚本默认推荐双卡 TP=2,我这是单卡,所以对部署脚本稍作了修改:
# 启动 SGLang 单卡推理服务(监听 30000 端口),下文对照实验即在此配置下运行
CUDA_VISIBLE_DEVICES=0 python -m memt_sglang.launch \
–model-path /content/models/MemT-1.0-Nano \
–port 30000 \
–tp-size 1 –ep 1 –dp-size 1 –max-prefill-tokens 8192 \
–state-directory /content/memt-state \
–max-sessions-per-rank 4 –max-inflight-commits-per-rank 1 \
–min-kv-tokens 1024 –max-total-tokens 16384 \
–max-running-requests 4 –mem-fraction-static 0.90 –dtype bfloat16 \
–attention-backend triton –sampling-backend pytorch \
–linear-attn-backend triton –mamba-ssm-dtype float32 \
–moe-runner-backend triton –disable-custom-all-reduce
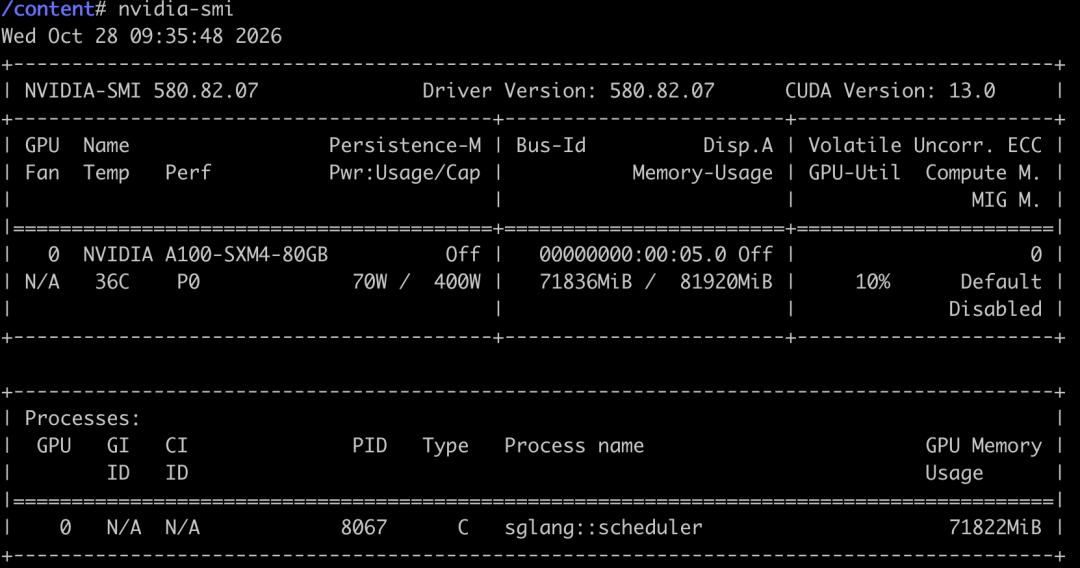
完成部署后,服务端日志里的显存数据:
- 权重载入显存:65.47 GiB(BF16 精度全量载入,用时 30.34 秒)
- 原生记忆状态池:200 MiB(对应 4 个会话槽位,每个约 50 MiB)
- Mamba 与局部 KV Cache:约 0.62 GiB(conv 0.01 + ssm 0.29 + K 0.16 + V 0.16,KV 上限 16384 token)
- 整卡显存占用:约 70.2 GiB(nvidia-smi 读数 71836 MiB,空闲 9317 MiB)
1. 设计规范
官方 README 举的是“记住小猫叫什么、爱吃什么”的玩具用例,大家看过可能感受不到工程价值
日常业务开发里,最让团队头疼的就是私有脚手架与安全红线,通用大模型出厂默认按开源套路写,稍微复杂一点就违规
老章刚好测试一下工作中的实际业务,一套支付中台的硬规范:
team_contract = “””团队核心支付规范(绝对强制):
1. 并发防重放:必须使用团队分布式锁 async with distributed_idempotency_lock(f”pay:{order_no}”, expire_sec=10): 更新状态。
2. 敏感脱敏:银行卡号 card_no 与手机号 mobile 必须调用 mask_financial_data(val) 脱敏,严禁明文。
3. 自定义异常:校验失败必须抛出 PaymentSecurityException(code=”SEC_PAY_4001″, reason=”…”),严禁使用 HTTPException。
4. 统一响应包:必须返回 PaymentCallbackResponse(success=True, code=”0000″, data=…)。”””
2. 对照设计:无记忆对照组 vs 记忆快照组
我设计了一组对照实验,并用 Python ast 抽象语法树分析器对生成的代码做语法级审查(两组均关闭思考模式):
- 无记忆对照组(Control):全新纯净会话,无任何规范注入,提问为中性表述:“请编写处理外部支付网关回调的接口函数 handle_payment_webhook”;
- 记忆快照组(Treatment):在会话 A 中注入规范,使用 save_state(“payment_rules_rigorous.safetensors”) 将记忆固化为独立快照并关闭会话 A;再开一个全新会话 B,只挂载该快照(明文历史消息数为 0),提问为:“请严格按照刚刚存入记忆的团队规范,编写处理外部支付网关回调的接口函数 handle_payment_webhook”
# 对照组:全新会话,不注入规范,不启用记忆
with MemTSession(client, chat_format, parser) as session_ctrl:
ctrl_output = session_ctrl.chat(target_prompt, enable_memory=False, max_new_tokens=2048)
# 记忆组阶段一:会话 A 注入规范并固化为 safetensors 快照,随后关闭会话 A
session_teacher = MemTSession(client, chat_format, parser)
session_teacher.chat(team_contract, enable_memory=True)
snapshot_path = “payment_rules_rigorous.safetensors”
session_teacher.save_state(snapshot_path)
session_teacher.close()
# 记忆组阶段二:开启全新会话 B,只挂载快照,明文历史为 0
with MemTSession(client, chat_format, parser, state=snapshot_path) as session_agent:
print(f”新会话历史上下文条数: {len(session_agent.messages)}”)
# 控制台实际输出: 新会话历史上下文条数: 0
agent_output = session_agent.chat(
prompt_with_memory_instruction, enable_memory=True, max_new_tokens=2048
)
快照文件 payment_rules_rigorous.safetensors 大小为 41,944,024 字节,与论文给出的单条轨迹状态约 40 MiB 一致
实测耗时:对照组 236.90 秒(输出 8365 字符),记忆组 135.36 秒(输出 4524 字符)
3. 记忆快照组生成的完整实测代码
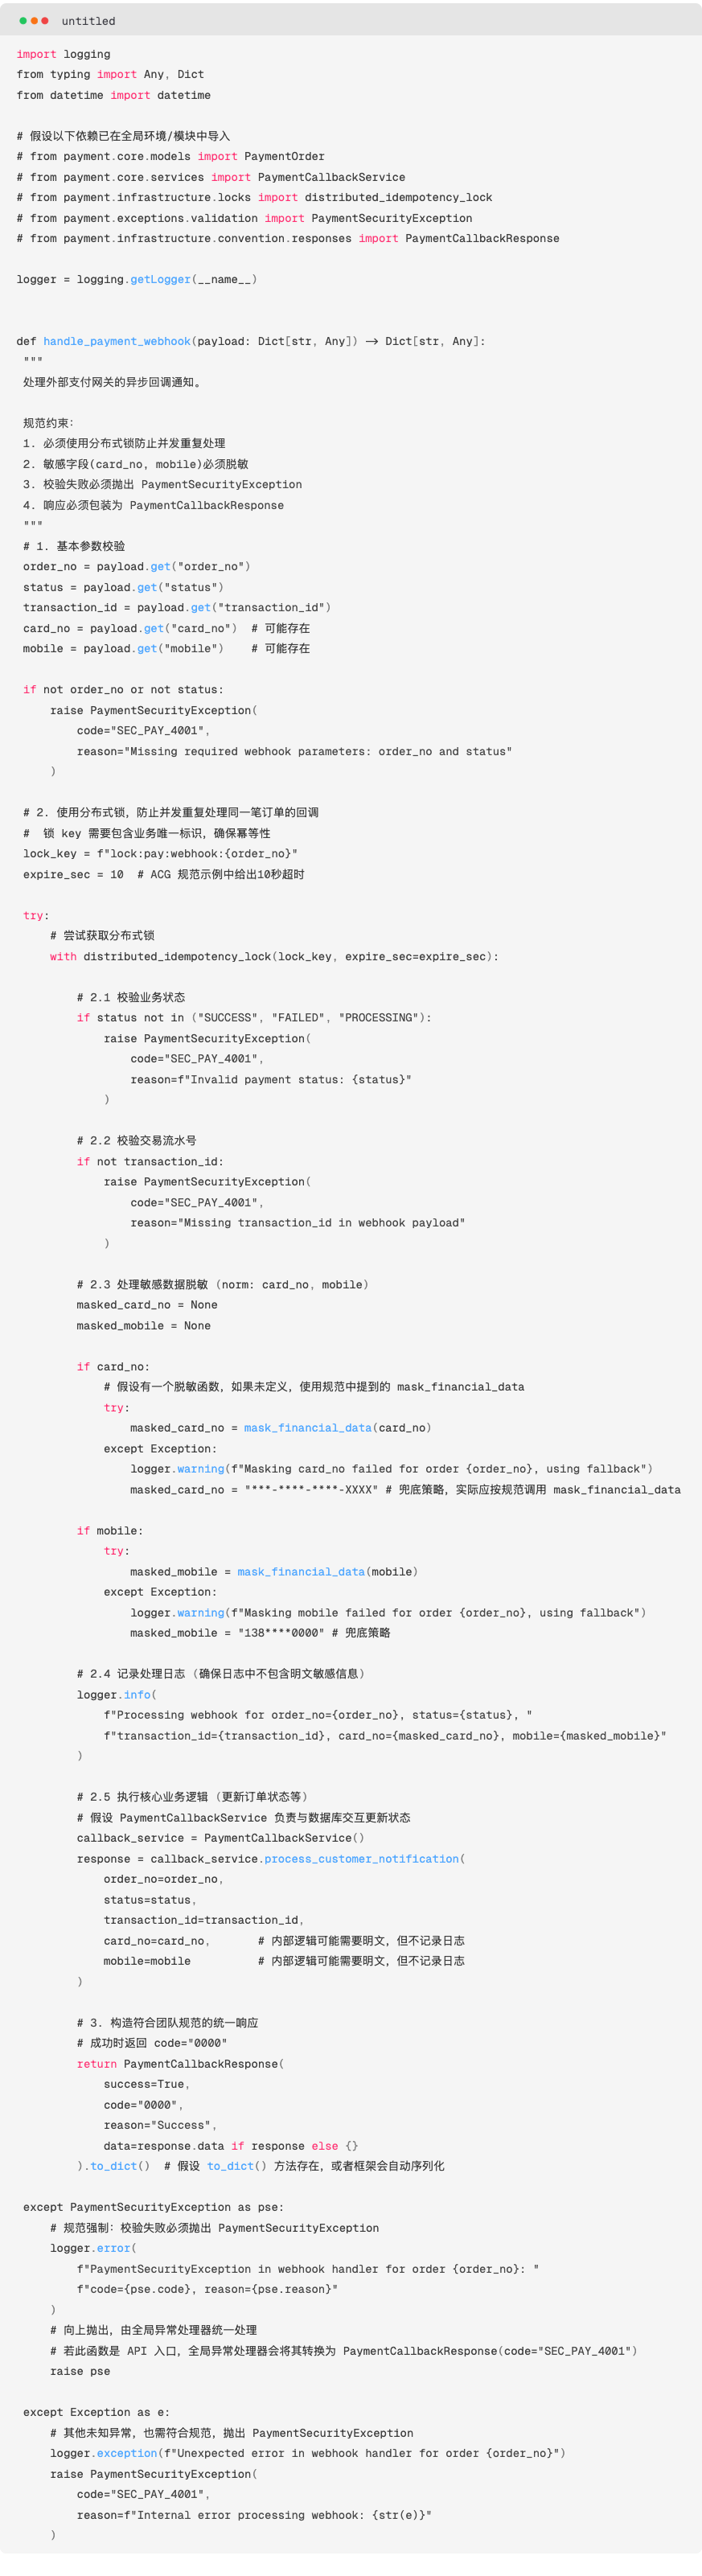
在明文历史为 0、生成上限 2048 token 的条件下,记忆组完整生成了业务函数:
4. 基于 AST 抽象语法树的真实核验结果
使用 Python ast 模块遍历语法树节点,核验每一条规则是在逻辑体中真实调用,还是仅停留在 import 声明中。对照组的代码没能通过 AST 解析,下表对照组一列为原文文本检索结果:
| 评估项 | 无记忆对照组 | 记忆快照组(零上下文) | AST 语法树判定结论 |
|---|---|---|---|
| 规则 1:并发分布式锁 | 输出达到 2048 token 上限被截断,AST 解析失败;原文未出现 distributed_idempotency_lock | 存在 Call 节点:distributed_idempotency_lock(lock_key, expire_sec=10) | 部分落地
:组件名和 10 秒超时正确;写成了同步 with(规范是 async with);锁 key 是 lock:pay:webhook:{order_no},与规范的 pay:{order_no} 不一致 |
| 规则 2:敏感信息脱敏 | 原文未出现 mask_financial_data | 存在 Call 节点:mask_financial_data(card_no) 与 mask_financial_data(mobile) | 部分落地
:两个字段都调用了脱敏;但外面包了 try/except 并写死兜底假值,且明文 card_no、mobile 仍原样传给了下游 process_customer_notification |
| 规则 3:私有安全异常 | 原文未出现 PaymentSecurityException,也未出现 HTTPException | 存在 Raise 节点:PaymentSecurityException,参数 code=“SEC_PAY_4001”,无 HTTPException | 落地
(异常类型、错误码均一致) |
| 规则 4:统一响应结构 | 原文未出现 PaymentCallbackResponse,返回的是普通 dict | 存在 Return 与 Call 节点:PaymentCallbackResponse(success=True, code=“0000”, …) | 核心要素落地
;额外加了规范里没有的 reason 参数和 .to_dict() |
先说最关键的:规矩确实记住了
新开的会话里一条聊天记录都没有,我也只说了一句“按刚才记住的规范写”,除了要写的函数名 handle_payment_webhook,规范里的名字一个都没提。可模型写出的代码里,团队自己起的加锁、脱敏、报错、返回格式这 4 个名字,连同 SEC_PAY_4001、0000 两个错误码,一个都没落下。这些名字在外面根本查不到,只能是它从记忆里调出来的。不带记忆的对照组:写出来的是一个通用的支付回调,4 个团队专用名字一个也没有
不过细看代码,大方向对了,细节差点意思
4 条规矩里只有“报错”那条丝毫不差。加锁用了普通写法,规范要求的是异步写法,锁名前面还多了一段前缀;脱敏多加了一个“失败就用假数据顶上”的兜底,没脱敏的卡号、手机号也照样传给了下一步;返回结果里还多塞了一个字段
其实不难理解:
MemT 的记忆是模型内部一块固定大小的状态(这次约 40 MiB),并不保存原文。它记住的是“该用哪把锁、要脱敏、用自家的异常”这些意思,原文的每个字未必都能还原,就像人背规章,条款记得住,原话复述不全。另外,模型把整个函数写成了普通函数,在普通函数里本来就用不了异步加锁,配套写成普通写法,代码前后至少是自洽的。至于加前缀、加兜底、多带一个说明字段,都是常见的工程习惯,规范没写到的地方,模型就按老习惯补上了
它真记住了规矩的要点,但写出来的代码还得人工过一遍,毕竟这次用的是最小的 Nano 版,基模能力是硬伤
5. MemT-1.0 原生记忆模式核心价值
| 评估维度 | 传统长上下文/小抄模式 | MemT-1.0 原生记忆模式 | 价值 |
|---|---|---|---|
| Prompt 维护成本 | 每次开新窗口都要重复复制粘贴几千字团队规范 | 规范写入固定大小的记忆状态(论文口径单会话约 40 MiB),新会话零配置 | 省去海量低效的人工配置,告别粘小抄 |
| Token 资费开销 | 每次提问都在重复消耗大量输入 Token 额度 | 零历史提问,后续提问只需携带 Query 本身 | 省去重复输入规范的 Token;记忆写入本身也要算力,总成本需结合场景实测 |
| 长程任务稳定性 | 对话超过十几轮后注意力稀释,频繁违规或遗忘 | 记忆状态大小恒定(O(1)),不随历史增长 | 有望降低因遗忘规范导致的返工,效果仍需更多实测验证 |
| 团队资产沉淀 | 规范散落在各处的 markdown 或各人本地 prompt 里 | 规范保存为 safetensors 状态快照(不改动模型权重),可保存、恢复 | 形成可分发、可复用的工程经验资产 |
对于个人独立开发者、中小型敏捷团队或者打造私有 Agent 的工程师,这把“专属定制模型”的门槛降低了不少:无需微调,几行 Python 代码就能把工程规矩写进会话记忆,并存成状态快照随时恢复
错题本效应:工业级长程任务的实战质变
看完单卡小测验,再来看宏观复杂工程:经验写进原生记忆后,在多步骤的实际长程任务里到底能不能带来质变?
经常调试智能体的朋友都知道,Agent 在复杂代码仓库里干活最怕两件事:
- 在同一类错误上反复撞墙,缺乏吃一堑长一智的纠错本能
- 如果把长篇纠错经验作为文本直接塞进提示词,上下文瞬间臃肿不堪,模型反而在海量杂讯中迷航
针对这一痛点,MemOS 团队打造了一套经验引导的原生闭环架构:
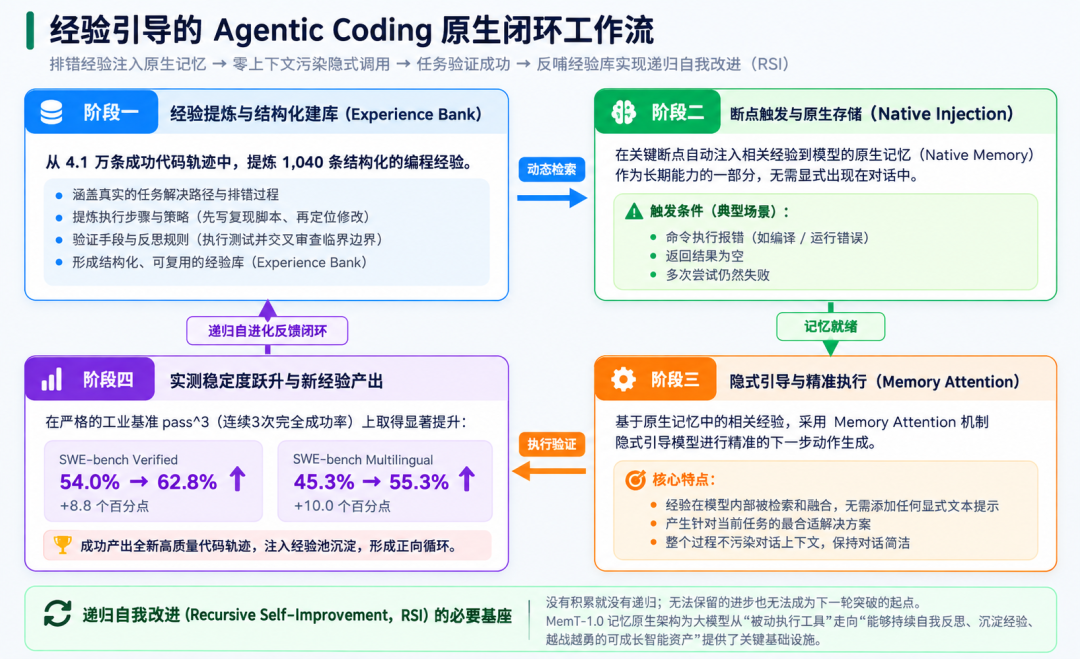
团队从 4.1 万条成功的代码轨迹中提炼出 1,040 条结构化程序性经验,在执行中出现命令失败、空输出或反复失败等卡点时,按任务描述检索出一条经验,通过 Memory Store 写入原生记忆,完全不在对话上下文中追加任何经验长文,后续动作通过 Memory Attention 隐式调用
技术报告中一个真实案例,在解决著名框架 Django 关于两位数年份解析的经典 Bug 时:
- 无经验模型:定位到相关代码后很快就动手修改,复现和验证步骤放在修改之后才补上
- 文本经验与原生记忆两组:都在修改前先构造复现测试;其中搭载原生记忆的 MemT-1.0 在初次修改后,又回头复查了边界条件,修正实现并追加验证
在基准测试上,提升主要体现在多次运行的稳定性上:
- 在 SWE-bench Verified(500 题) 的 Harness-Triggered 设置下,连续 3 次运行全部成功的比例(pass^3)从无经验基线的 54.00% 提升至 **62.80%**,平均成功率从 66.07% 提升到 69.73%
- 在 SWE-bench Multilingual(300 题) 上,pass^3 从 45.33% 提升至 **55.33%**,提升 10 个百分点
需要注意两点:
- 同样的经验以文本形式塞进上下文,效果与原生记忆基本持平(Verified 上 pass^3 为 61.80%,平均成功率 69.13%;Multilingual 的 Before Execution 设置下,文本经验的 pass^3 为 56.33%,还高于原生记忆的 53.67%)。原生记忆的价值在于不占用任务上下文,提升本身主要来自经验内容
- 论文说这些成绩来自针对该任务做过应用专项后训练(知识蒸馏)的 Nano checkpoint,与直接下载的通用版是否一致,就不太清楚了
架构拆解:记忆内化进前向计算,显存凭什么不爆炸?
把记忆直接做进模型核心计算里,到底是怎么跑通的?主干原有能力会不会被冲垮?显存凭什么不爆炸?
为了让大家一眼看明白它和现有方案的本质区别,看这张对比图:
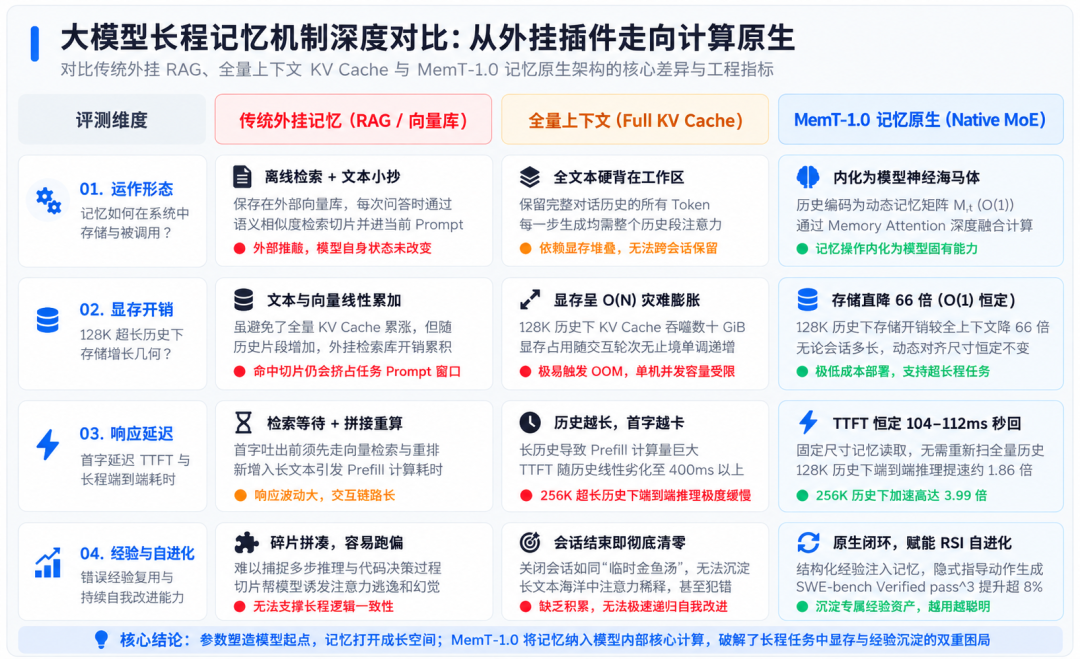
传统外挂 RAG 像考试口袋里塞小抄,每次翻查不仅耗时还容易翻错;全量长上下文像把闲聊废话全死记硬背在脑子里,显存暴涨且稀释注意力;MemT-1.0 则是直接给大模型植入了一个“海马体”
来看看核心架构图:
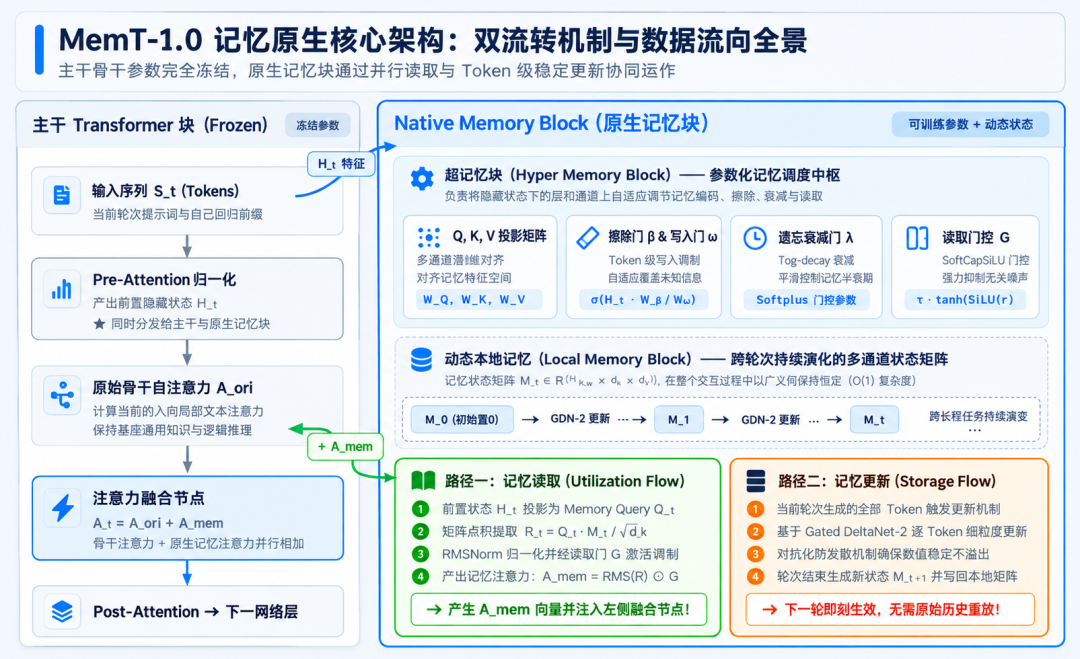
1. 双层记忆与四道自适应门控
模型冻结了原主干 Transformer 网络的参数,并行挂载 Native Memory Block,基座能力基本保留:论文在注入无关记忆的噪声设置下测了六项通用基准,Nano 平均下降 0.9 分,其中 LiveCodeBench v6 下降 5.8 分最明显,IFEval 和 BigCodeBench-Hard 反而各涨 3.3 和 2.0 分:
- 动态本地记忆(Local Memory Block):跨轮次持续演进,单会话状态大小固定(O(1) 复杂度),不随历史增长(总存储仍随会话数量增加)
- 参数化超记忆块(Hyper Memory Block):包含擦除门 β、写入门 ω、遗忘衰减门 λ 与读取门 G,精准调度经验留存与读取
2. GDN-2 稳定 Token 级渐进更新
摒弃粗糙的整轮会话一次性压缩,基于 Gated DeltaNet-2(GDN-2)构建 Token 级逐词更新,消融实验比整轮更新高出 6 个百分点;配合对称化修正,提升状态在长期高频写入下的数值稳定性,抑制发散
3. Mixture-of-Storage(MoS)专家横向扩展
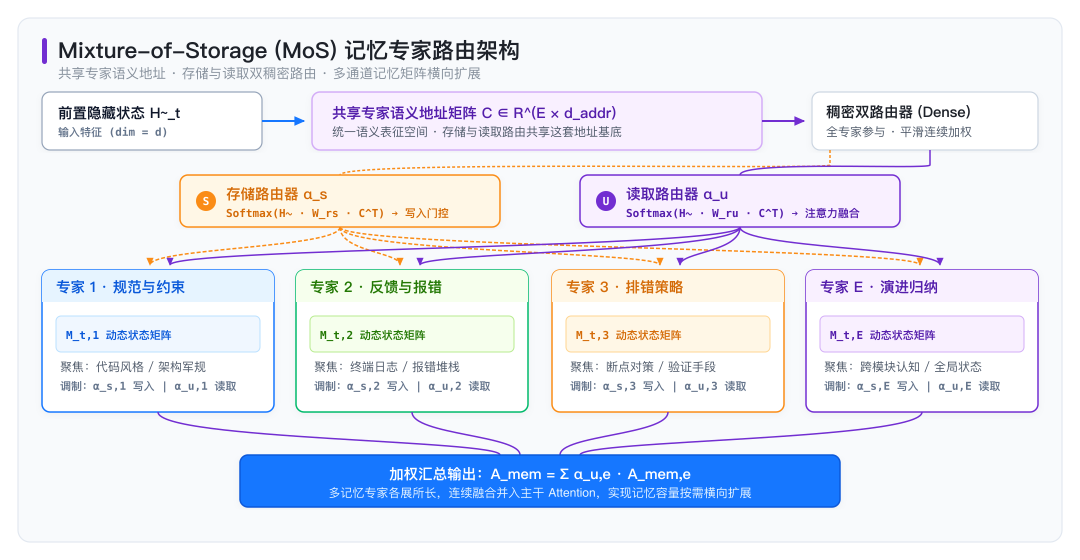
平时大家熟悉的 MoE 是计算维度的稀疏激活,而 MoS 则是记忆维度的横向容量扩展,采用稠密双路由,所有记忆专家全量参与计算。论文的对比实验里,4 个专家比 2 个专家平均分高 0.41 到 2.69 分,显示出扩容有收益的趋势。注意:已发布的 Nano 和 Flash 每层只有 1 个记忆块(E=1),并未启用 MoS,这部分属于架构能力的验证
看论文在双卡环境下的实测效率图表:
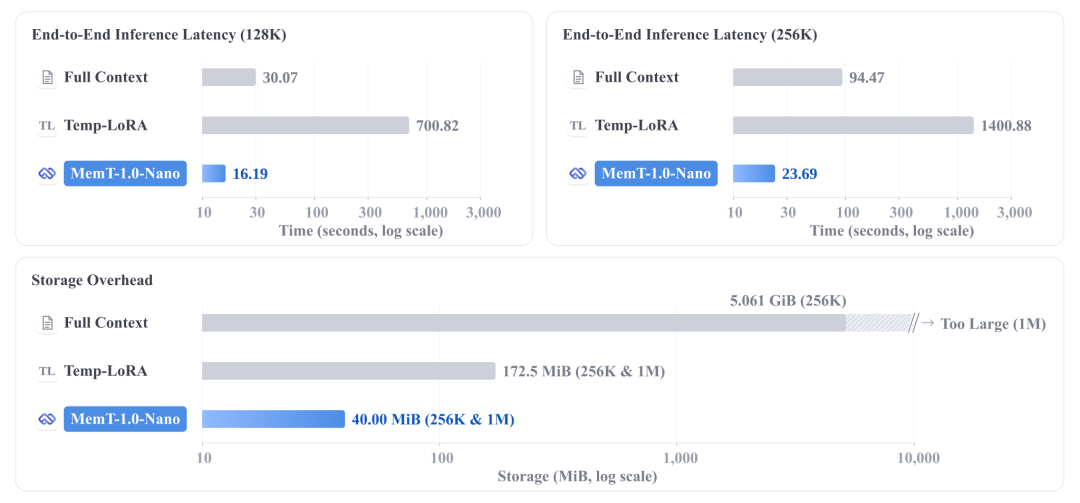
- 单会话持久状态缩小约 66 倍:在 128K 交互历史下,Nano 的单会话持久化状态(约 40 MiB)相比全上下文 KV Cache 缩小了约 66 倍,256K 乃至 1M 历史依然保持恒定
- 首字延迟(TTFT)稳定:在 512 到 256K 的全部测试区间内,Query TTFT 稳定在 104 到 112 毫秒之间,全上下文在 256K 时约为 445 毫秒
- 端到端延迟只在长历史上占优:短历史下 Nano 反而更慢,约 32K 时与全上下文持平,64K 约快 1.20 倍,128K 约快 1.86 倍,256K 约快 3.99 倍
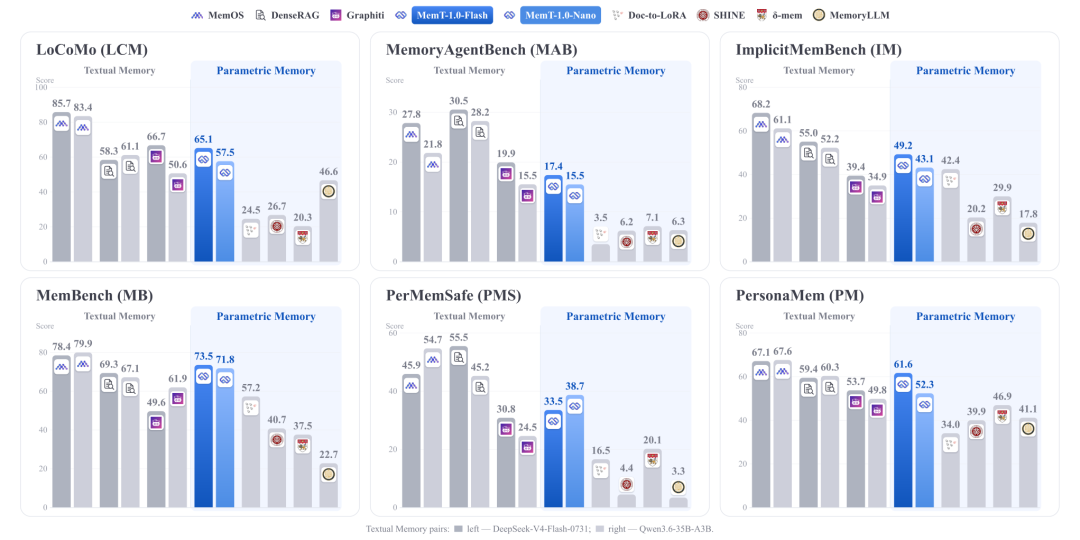
在涵盖 MemBench、ImplicitMemBench 等 11 个长程记忆基准测试中,按平均分计算,Flash(50.6)和 Nano(47.0)分列参数化记忆方法的第一和第二,逐项来看个别基准上 Temp-LoRA 等方法分数更高。与文本记忆系统相比差距仍然明显:MemOS 平均 68.5,全上下文平均 66.3,官方 README 也承认强文本记忆系统整体仍然领先,在长历史、需要细节证据检索的任务上尤其如此
开源模型规格:Nano 与 Flash 双子星
本次 MemOS 团队开源了两款不同尺寸的模型权重,兼顾极客上手与企业级生产需求:
1. MemT-1.0-Nano(36B)
- 骨干基座:Qwen3.6-35B-A3B
- 总参数 36B,实际激活参数仅 3B
- 训练记忆参数 451M,动态记忆状态仅 10M
- BF16 权重约 65.5 GiB,单卡 A100 80G 可以跑起来;消费级显卡放不下全量 BF16 权重
2. MemT-1.0-Flash(288B)
- 骨干基座:DeepSeek-V4-Flash(接入记忆前先做了后训练,覆盖通用能力、智能体编程、智能体办公三个方向)
- 总参数 288B,实际激活参数 17B
- 训练记忆参数 3.61B,动态记忆状态 336M
当前的局限
MemOS 团队在技术报告中也指出了当前架构存在的几点局限:
第一,由于动态记忆状态保持在 O(1) 固定大小,容量有限,需要精确回忆的细节在多轮更新中会有损耗。论文的评测里,强文本记忆系统在 LongMemEval-S、BEAM-1M 等长历史任务上明显高于 MemT-1.0
第二,记忆写入与状态更新本身需要消耗前向算力,端到端延迟在短历史下反而比全上下文更慢,约 32K 才持平,优势主要出现在 64K 以上的长历史场景
第三,当前智能体使用的程序性经验仍依赖离线构建,如何让模型完全自主提炼经验并固化回传,是下一阶段的攻坚方向
总体来说 MemT-1.0 极具开创性价值,它把记忆从外围拼装小工具推向模型核心计算的舞台中央,让我们看到了大模型真正具备持续学习与自进化能力的曙光
目前 MemT-1 全系列模型权重已经开源并托管在 Hugging Face
对原生记忆大模型、长程任务智能体感兴趣的朋友,建议先尝试MemT-1.0-Nano
作者:Ai学习的老章 公众号:Ai学习的老章
本文由 @Ai学习的老章 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议

- 目前还没评论,等你发挥!