起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
人类一思考,AI就发笑


「人类一思考,上帝就发笑」被引用得太随便,昆德拉原本说的是理性的有限。如今上帝的位置换成了 AI:围棋要靠它校准,奥数拿满分,代码接近满分。当所有人的表达都被同一批模型校准过,AI 笑的是人类的一致。
01 这句话的来路
1985 年 5 月,米兰·昆德拉在耶路撒冷领一个文学奖。领奖台上,他讲了一句犹太谚语:
“人类一思考,上帝就发笑。”
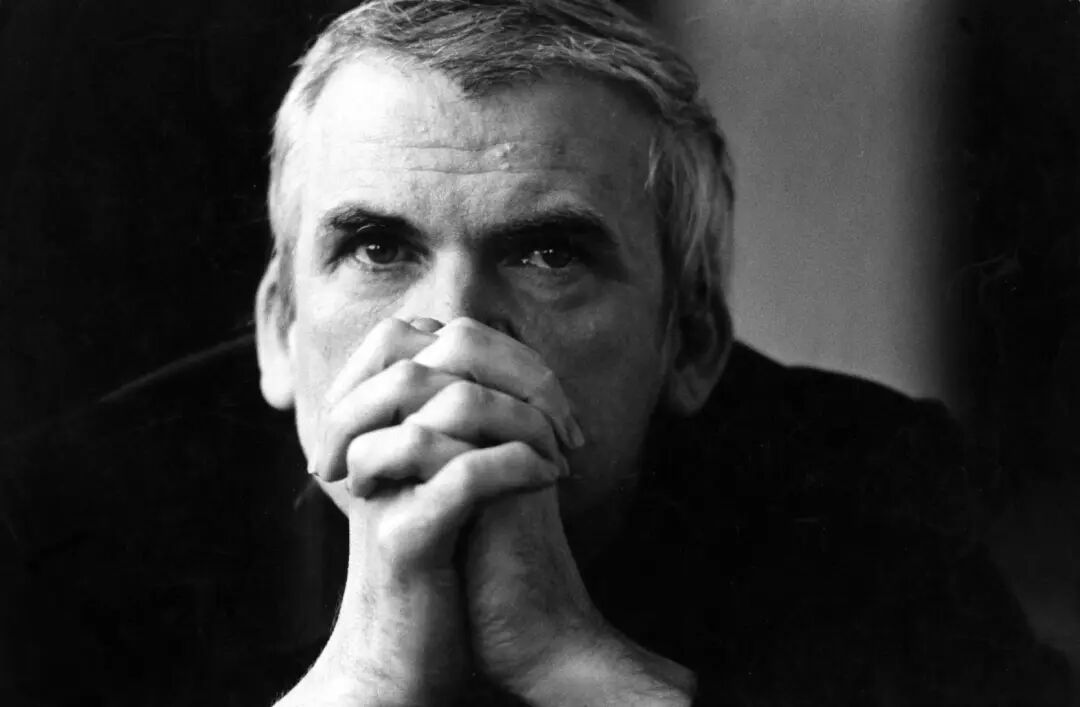
(米兰·昆德拉像)
他解释了三层原因。人越想抓住真理,真理离他越远;人越思考,一个人和另一个人的想法就隔得越远;还有最后一条,人永远不是自己所想的那个人。
后来他把这句话写进《小说的艺术》,从此流传开来。四十一年过去,这句话被引用得太随便了,几乎成了一句“别想太多”的口头禅。它原本的意思其实很硬——昆德拉不是在反智,他承认的是理性的有限性。
这句谚语的锋利处,在于“发笑”的那个人是谁。上帝笑得出来,因为他全知。人怎么想都是徒劳,所以他站在高处,笑一声。
现在,“上帝”这个位置,被AI取代了,就像现在的围棋,人类下每一步棋,都会去找AI校准,因为在围棋现在的世界里,AI就是全知的那一位。然后人类高手们硬记住这些招式,在比赛中应用,谁的符合度高,谁胜出的机会就最大,申真谞目前是围棋世界里最强的一位,所以被称为“申工智能”——在要求胜负的明确结果的围棋棋盘上,人类的想像力正在萎缩。
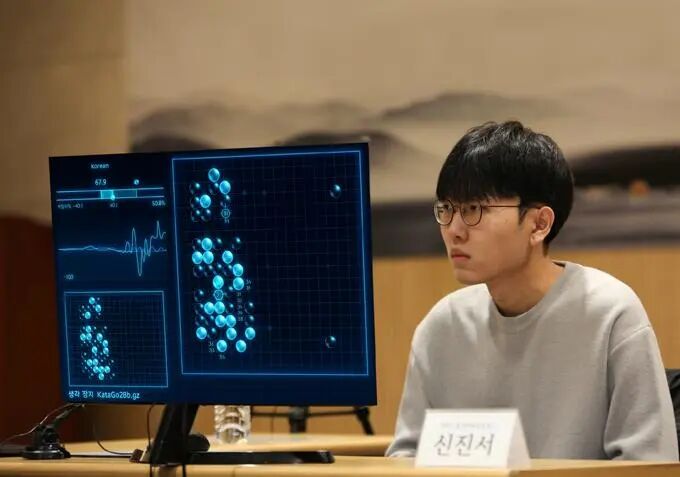
(申真谞与 AI 围棋对弈)
02 能写清楚的事,AI已经赢了
来看一组 今年的数字。
写代码。
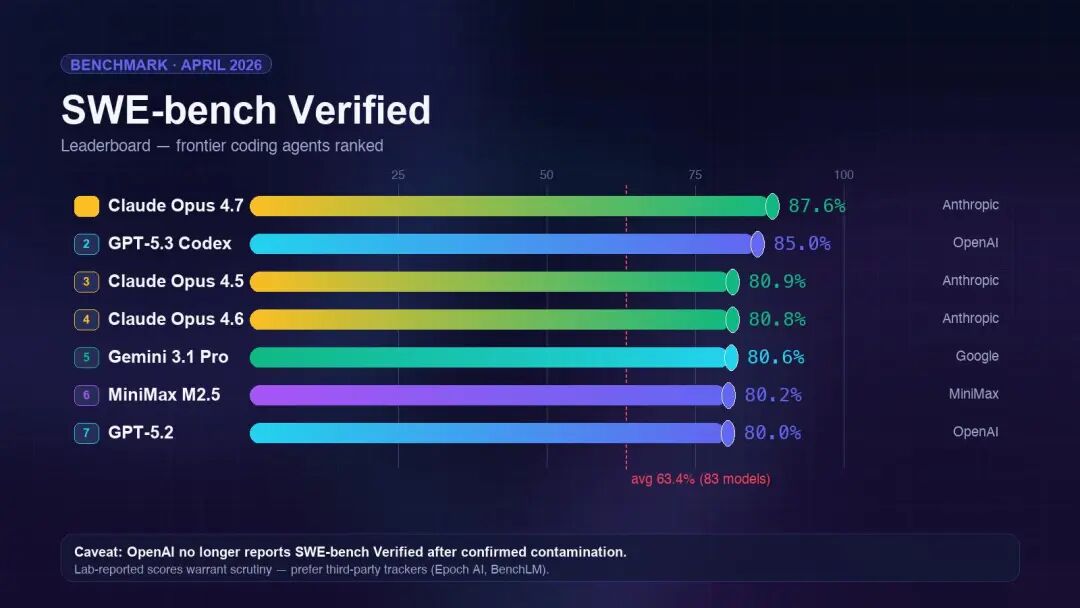
SWE-bench Verified 是公认最难的编程测试之一,题目全部来自真实开源项目,每一道都有一个能跑通的正确答案。7 月 24 日发布的 Claude Opus 5 拿了 96%,在更难的 SWE-bench Pro 上是 79.2%。半年前的 Opus 4.7 是 87.6%。
做数学。
2026 年 7 月的国际数学奥林匹克,六道证明题,满分 42,金牌线 29 分。Opus 5 拿到 42 分满分。英伟达的 Nemotron 3 在同一场比赛里得 30 分,过了金牌线;在信息学奥赛 IOI 2026 上,它拿了 535.4 分(满分 600),而那一届人类选手的最高分是 498.27。
这些成绩里藏着一个共同点,值得单独拎出来说:它们问的每一道题,都有一个能被验证的答案。代码要能跑通,证明要能一步步检查,要么对要么错,没有第三种可能。
也就是说,AI 赢下来的地方,全都是“能精准表达”的地方。
这不是巧合。AI 的本质是语言与符号的学徒。而编程语言和数学证明,恰恰是人类发明出来的、最严谨、最精确、最不留歧义的语言——语法严格、可验证、有唯一正确答案。在这些地方,AI 不需要“理解”什么,它只需要掌握规则。一个人要花十年练成的手艺,它一次推理就做完了,还更快、更便宜。
于是有了 AI 的第一声笑:在有唯一答案的地方,人成了那个更慢、更贵、更容易出错的选手。
上帝笑人,是因为人想知道一切却做不到。AI 笑人,是因为在这些地方,人本来就不必在场。
03 写不清楚的事,人和AI都没赢
但把同一批模型拉到场外,画风立刻变了。
Humanity’s Last Exam(“人类最后的考试”)是近千名专家出题、专门用来卡住 AI 的一套题。2026 年 4 月的最新成绩:最强的Claude Opus 4.6 开启长思考是53.1%,Gemini 3Pro是 37.2%,GPT-5.2 是35.4%,
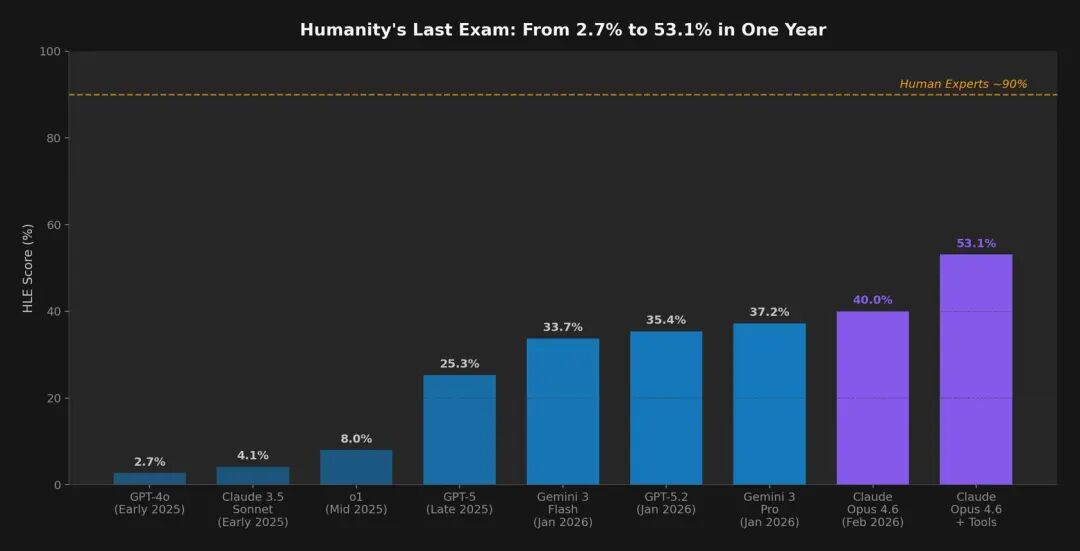
而人类专家在同一套题上的平均分,大约是 90%。
差距这么大,是因为这套题问的大多是说不清楚的东西。有一道题是这样的:给出一段 14 世纪修士的医学笔记,拉丁文、希腊文和他自创的符号混在一起写,让 AI 推断这套知识在一间没有现代安全规范的实验室里会怎么被使用。人类专家耸耸肩就答了。AI 卡住了。
为什么卡住?化学家波兰尼有句话说得最准:“我们知道的,比我们能说出来的多。”他把这类东西叫默会知识——你会骑自行车、会分辨一幅画是真是假、会一眼看出某个人能不能合作,但你说不出你是怎么做到的。波兰尼还说,有些默会知识在结构上就是说不出来的:铁匠抡锤子的时候,注意力根本不在锤子和钉子上,你一旦让他去注意,他反而会砸到手。
再往前一步,维特根斯坦在《逻辑哲学论》的结尾写:凡是不能谈论的事情,必须保持沉默。和默会知识不太一样——默会知识是“你说不出来,但你知道”,而这一类是“你说不出来,你也不知道怎么验证”。没有标准答案,没有对错可查。
《逻辑哲学论》封面
而这恰好是人和 AI 处境最像的地方。
AI 是语言模型。说不出来的东西没进过语料,它就学不到。人也一样:这类问题真问到你头上,你能拿出来的无非是个人偏好和模糊感受,第二天自己可能就改了主意。
但真正的麻烦在于:它不知道自己没学到。
这就是幻觉。Vectara 的幻觉率榜单在 2026 年 9 月 22 日更新到了 108 个模型,表现最好的是蚂蚁的金融专用模型 finix_s1_32b,1.8%;OpenAI 的 GPT-5.4 nano 是 3.1%。反倒是那些旗舰模型、“会推理”的模型更差:GPT-5.5 是 9.3%,Claude Opus 4.7 是 12.0%,Gemini 3.1 Pro Preview 是 10.4%;开了推理模式的更离谱——Grok 4 Fast 20.2%,o3-pro 23.3%。
为什么会越想越假?因为模型在推理时,会顺手把自己逻辑里的空白一并补全,补得越起劲,离原本的事实就越远。这个现象在业内有个名字,叫“推理税”。
写到这里,那个四十一年前的笑话突然响了一声。
昆德拉说,人越思考,真理离他越远。
今天这句话在机器身上被实测了出来。AI 越推理,离真相越远——它第一次活成了这句谚语里的主角。
还有一层。那些不能精准表达的部分,人自己也在往外丢。
2026 年 3 月,南加州大学的 Zhivar Sourati 团队在《认知科学趋势》上发表了一篇论文,讲的是 AI 正在让人类的表达趋同。论文引用的研究里,有几组数字很扎眼:一项针对 22 个 AI 模型和 102 个人的发散思维测试显示,AI 在个体层面比人更“有创意”,但彼此之间更相似;检查了 40 多万篇科学论文后发现,ChatGPT 发布之后,每个作者的发文量涨了,但内容和语言风格的相似度也涨了;在印度与美国受访者之间做对比,用了 AI 补全之后,印度人的措辞开始“听起来更像美国人”。
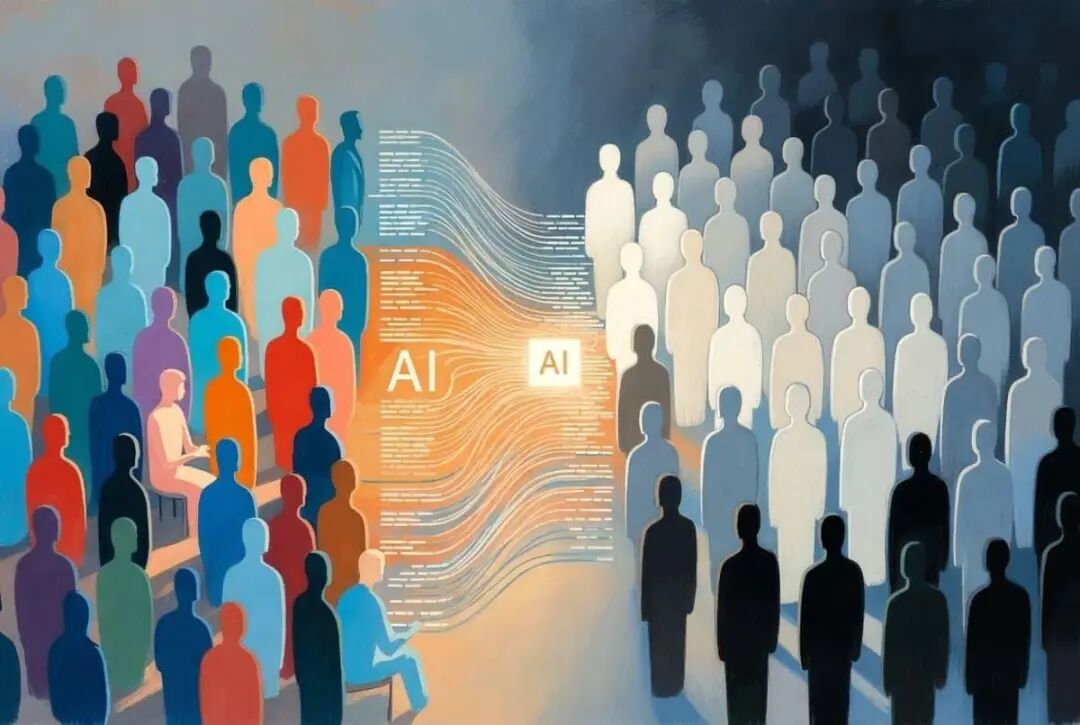
所以这一节真正的结论不好听:那些说不清楚的地方,不是“人懂而 AI 不懂”,而是人也在丢,AI 也摸不到,而两边都以为自己懂了。
AI 的第二声笑在这里:它笑,不是因为它明白,是因为它连自己不明白都不知道——而我们却以为它明白。
04 同一个笑话,第三次响起
所以这句谚语今天要读三遍。
第一遍是昆德拉的原版:上帝笑,因为人想知道一切,却抓不住真理。
第二遍是 2026 年的第一层意思:AI 笑,因为在能写清楚的地方,人成了多余的那个。
第三遍还是 2026 年:AI 继续笑,因为在写不清楚的地方,它不知道自己不知道,我们也不知道自己不知道。
三声笑,笑的都不是“思考”这件事本身。上帝笑人的自大,AI 笑人的多余,最后一声笑——笑的是所有人都在假装。
昆德拉那句话,说到底不是让人别思考。他提醒的是别自负:人越想抓住什么,越得承认自己抓不住什么。他在那场演讲的结尾说了一句很轻的话:“我不应再饶舌了,我似乎忘记了,上帝看见我在这儿煞有介事地思索,他正在一边发笑。”
一个能让全世界听见他说话的人,还在提醒自己:我可能也是好笑的那一个。
现在轮到我们了。今天缺的不是算力,也不是创意,缺的是“我说的这句话,只有我这么说”的能力。
当所有人的表达都被同一批模型校准过一遍,AI 笑的就不再是人类的局限,而是人类的一致;笑的是人类的作茧自缚,失去独立思考和表达的能力。
本文由人人都是产品经理作者【微果酱】,微信公众号:【AI微果酱】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议
- 目前还没评论,等你发挥!