
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
从小学到高中,12 年教材被做成了一张能追溯知识断层的地图


高一函数听不懂,病根可能藏在两年前那节没听懂的旧课里。一个上线不到一个月就冲上 GitHub 趋势榜的开源项目,把 12 年教材拆成 3383 个知识点和 4873 条先修边,用有向无环图往回追,直到揪出最底层的薄弱环节。
很多人在辅导孩子或者自己上学时,都经历过一种深深的无力感:高一的「函数概念」怎么都听不懂,初三的「配方法」一做就错。传统的应对办法通常是买本练习册,对着不会的章节反复刷题,结果往往收效甚微。
原因其实很残酷。卡住学生的往往并非眼前的这道新题,真正的病根可能藏在两年前某节没听懂的旧课里。
最近在 GitHub 上,一个名为 cn-math-taxonomy 的开源项目给出了非常惊艳的工程解法。这个仓库于 10 月 18 日刚刚创建,上线还不到一个月,Star 数量就已经突破了 7600 个,连续多日冲上 GitHub 趋势榜。
项目地址
https://github.com/xiaoyang111222/cn-math-taxonomy
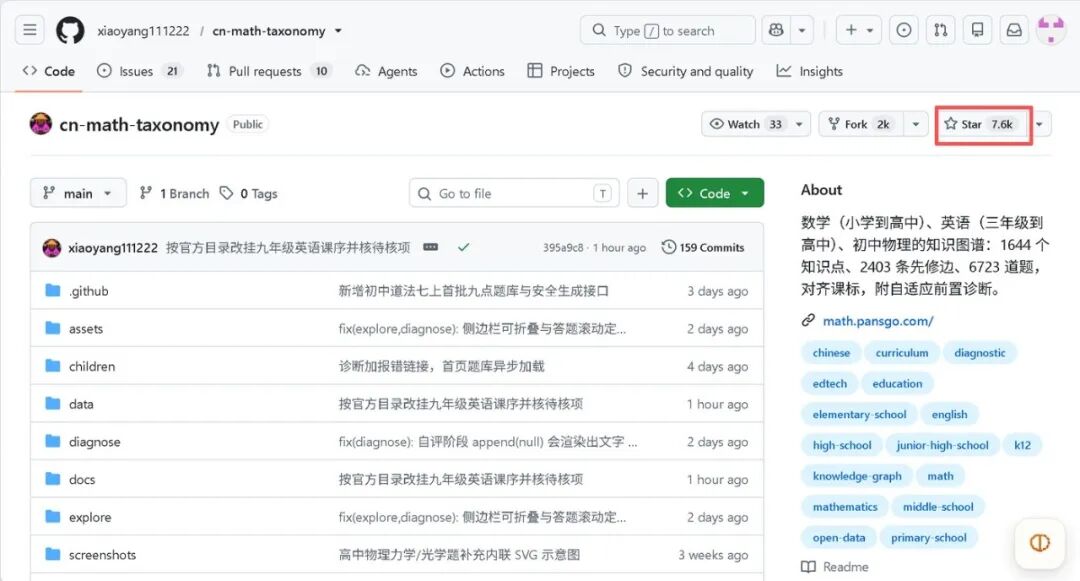
GitHub 仓库首页,10 月 18 日创建
01 把 12 年课本,拆解成一张「代码依赖图」
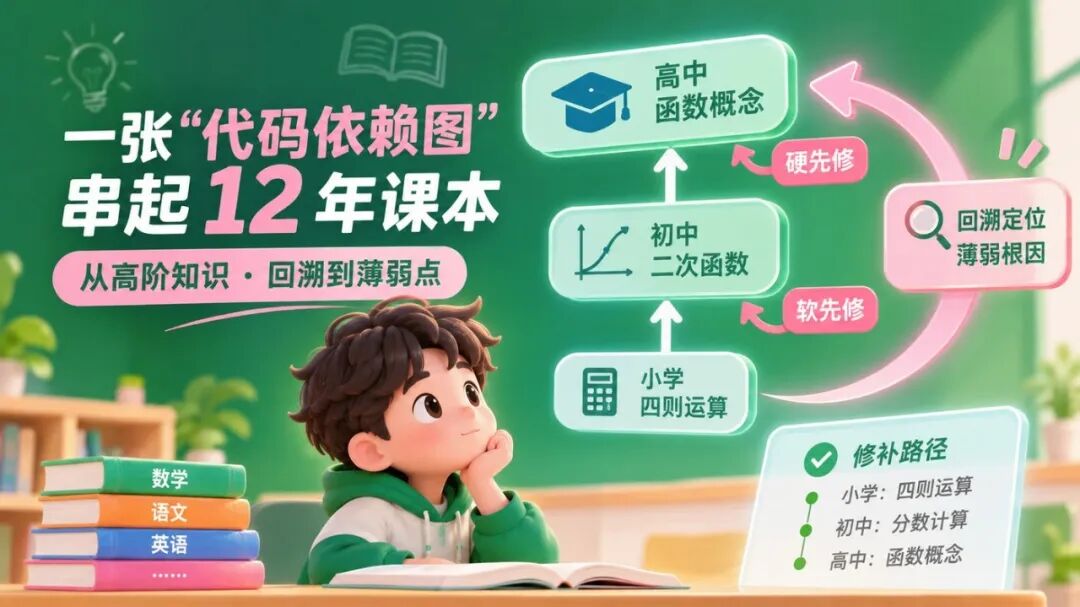
项目介绍页:一张代码依赖图串起 12 年课本
如果用一句话来概括,cn-math-taxonomy 是一套覆盖中国小学、初中、高中共 10 门学科的开源课程知识图谱与自适应前置诊断系统。
在工程设计上,它借鉴了海外知名教育科技项目 Marble os-taxonomy 的「知识点节点(Topics)+ 依赖关系边(Dependencies)」双层数据结构。熟悉编程的朋友可以把这套逻辑理解为管理软件包的 npm:你想运行一个高级模块,系统必须先检查它的底层依赖包有没有装好。
作者将中小学教材的章节拆解为颗粒度极细的微知识点,再用有向无环图(DAG)把它们之间的先修关系串联起来,并且将依赖强度细分为两类:
硬先修:
必须掌握的前置门槛,前面的概念不会,后面的内容根本无法推进。例如「规则动词过去式」之于「现在完成时」。
软先修:
掌握后能提供类比、简化或背景支撑的知识点,顺着教学顺序学下来会更轻松。
当学生在某个高年级知识点频繁答错时,系统会停止在原地机械出题,转而顺着「先修边」一路向低年级回溯。比如从高中必修的「函数概念」回溯到初中的「二次函数」,或者从初中的「配方法」一路穿透回溯到小学的算术基础,直到揪出最底层的薄弱根因,最后自动生成一份按年级从低到高排列的修补路径。
划重点
知识点拆到微粒度之后用有向无环图连起来,硬先修画实线、软先修画虚线。诊断时沿先修边往低年级查,最后按年级从低到高排一份修补清单。
02 十大学科盘点与新课标考据
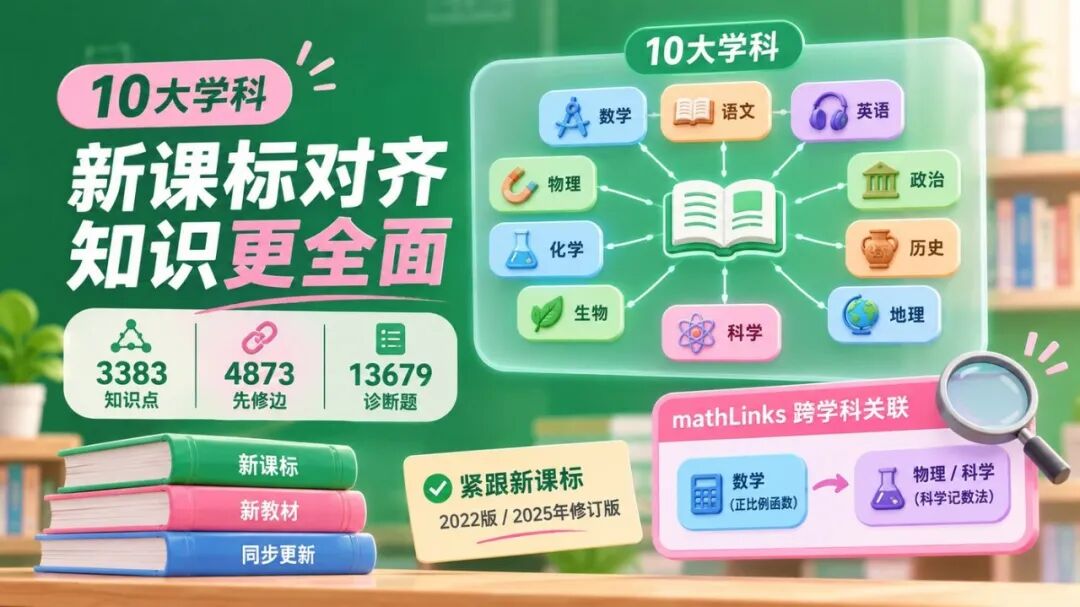
十大学科与新课标对齐
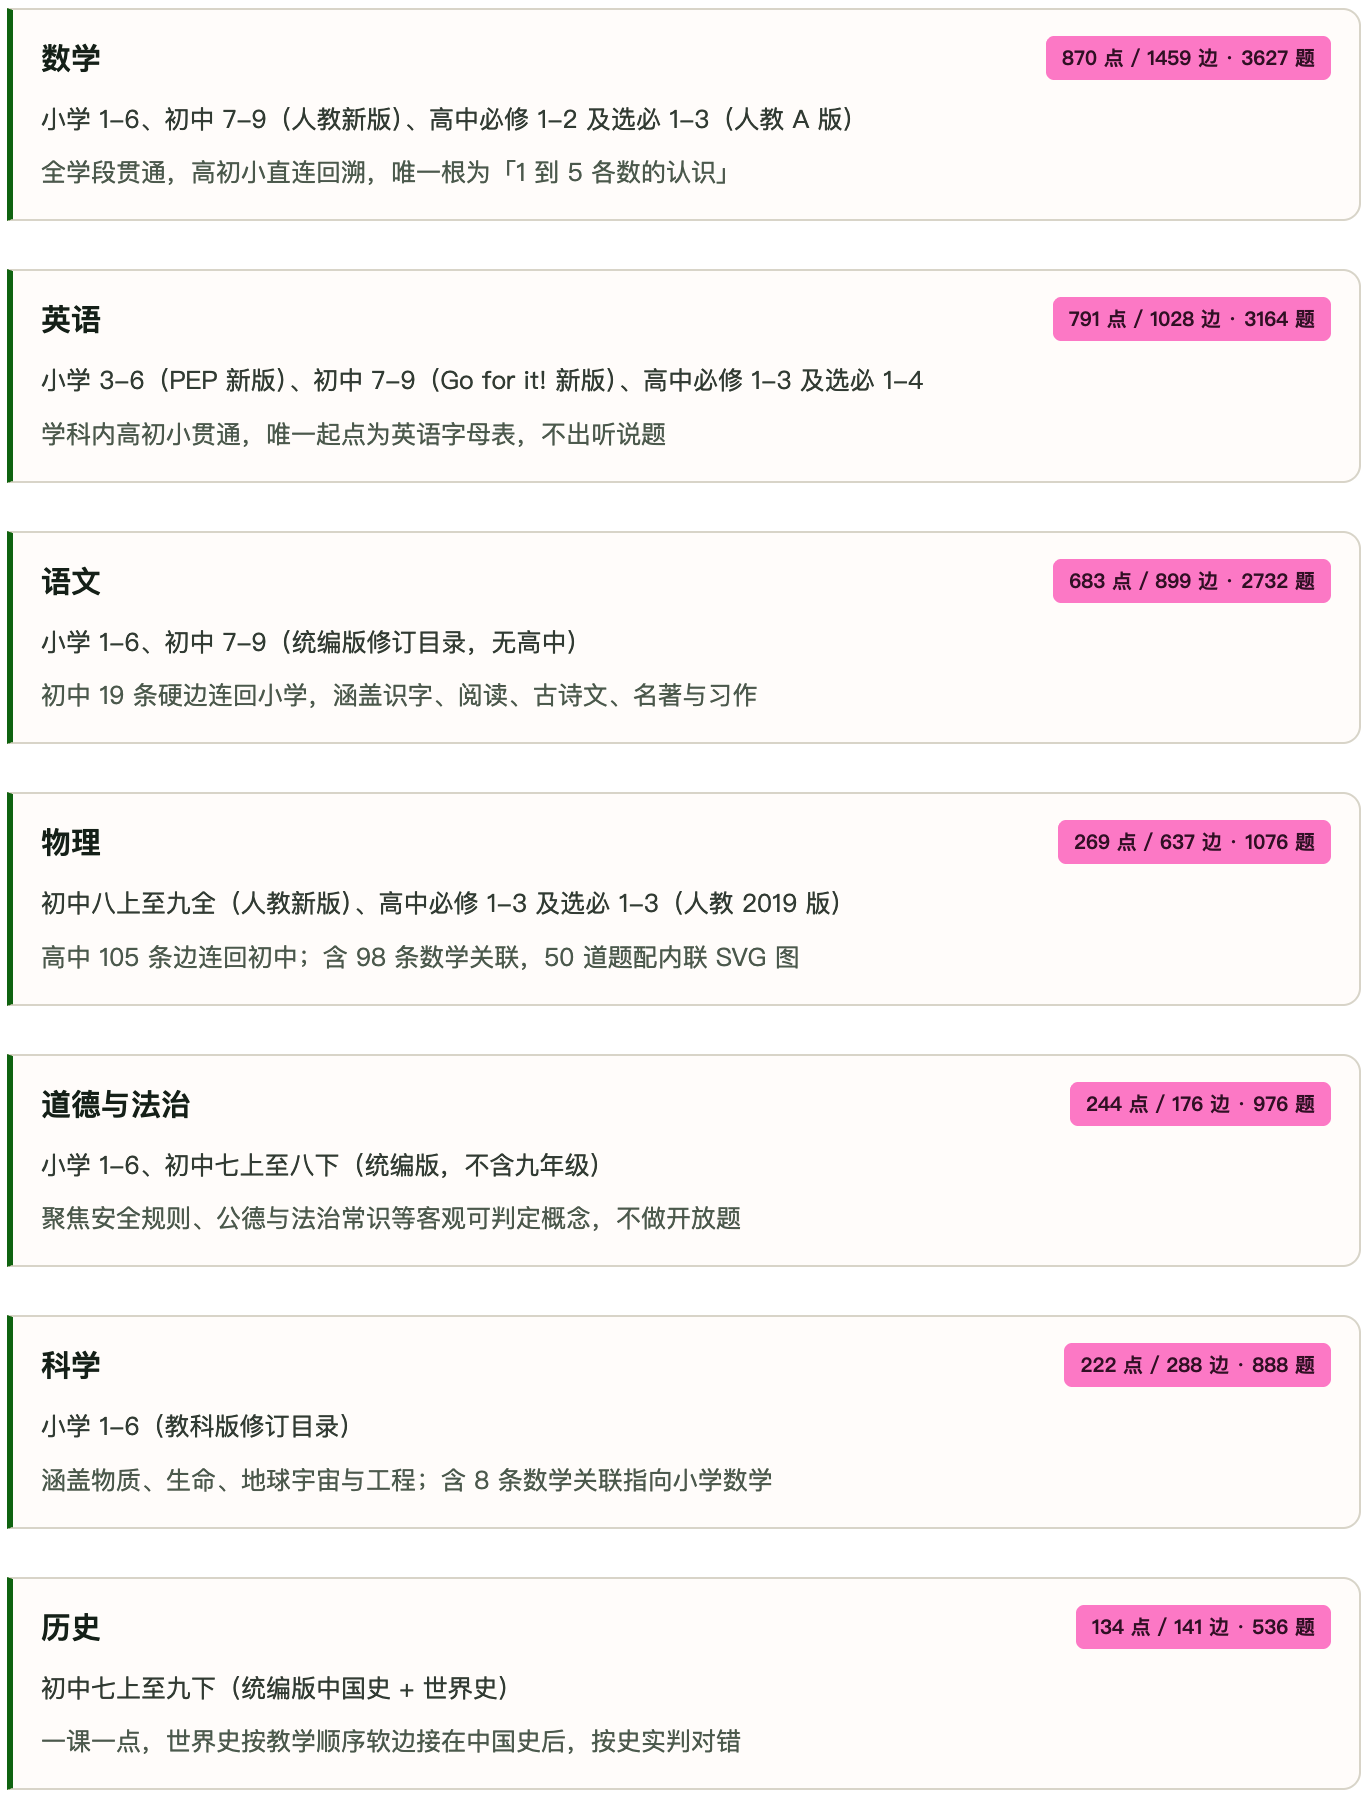
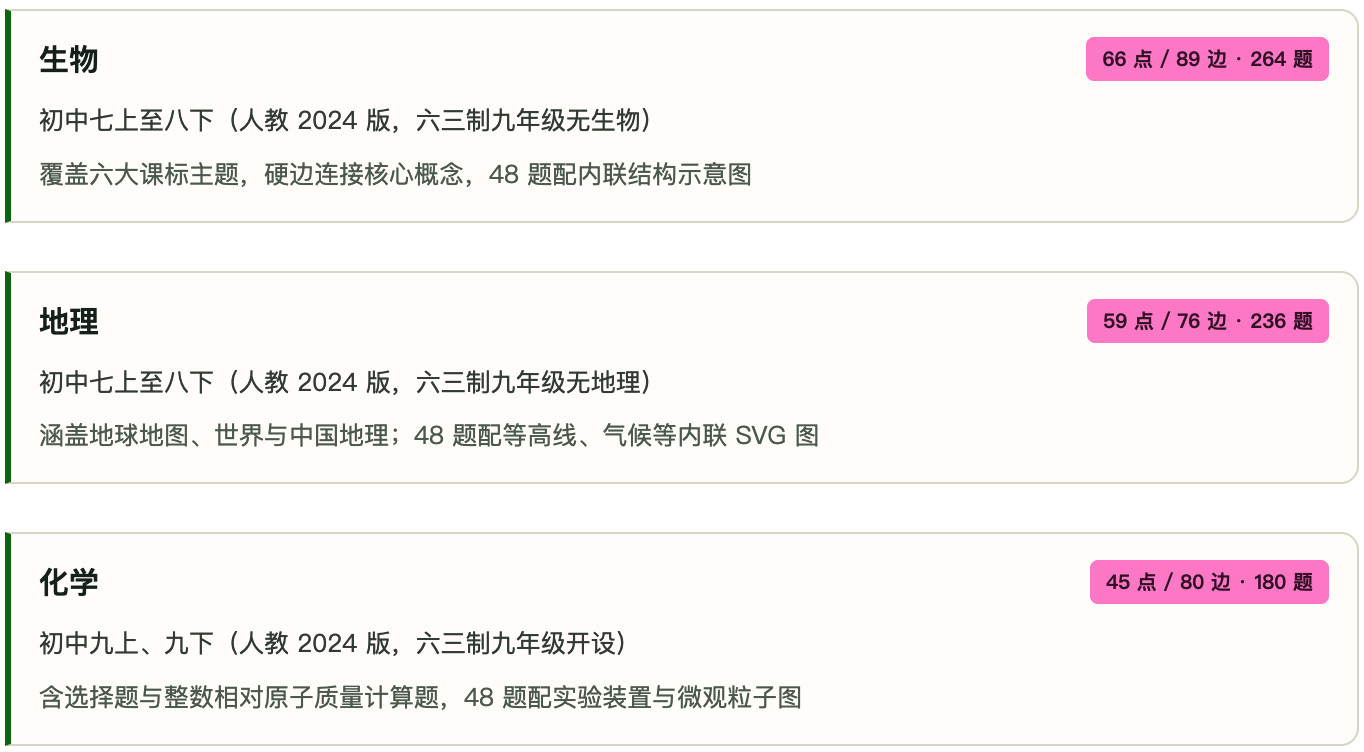
虽然仓库名叫 math(最早确实从初中数学起步),但在短短二十多天里,项目已经迅速扩展到了 10 门学科,累计沉淀了 3383 个知识点、4873 条先修边和 13679 道诊断题(还在持续更新)。
更难得的是它在教材对齐上的考据深度。项目紧跟教育部《义务教育课程标准(2022 年版 / 2025 年日常修订版)》以及《普通高中课程标准(2017 年版 2020 年 / 2025 年修订)》,连 2024 至 2026 年刚投入使用的新版教材目录变动(比如小学语文一年级改为「先识字再学拼音」、初中数学将反比例函数移入九上)都做了精细的同步。
为了防止不同学科缠绕成一团乱麻,各学科在底层独立成图,诊断回溯严格限制在本学科内部。不过,物理和科学这两门重度依赖数学工具的学科,在节点中专门设计了 mathLinks 字段,用来显式关联「正比例函数」「科学记数法」「条形统计图」等数学前置节点,点击即可一键跨图跳转。
各科核心家底(数据持续更新):
划重点
十门学科各自成图,回溯不跨学科;物理和科学用 mathLinks 单独挂到数学节点上,点一下跳过去。表格里的数字每天都在变,用之前回仓库核对一次。
03 三大核心功能与交互拆解
功能 01 局部知识图谱浏览(explore/)
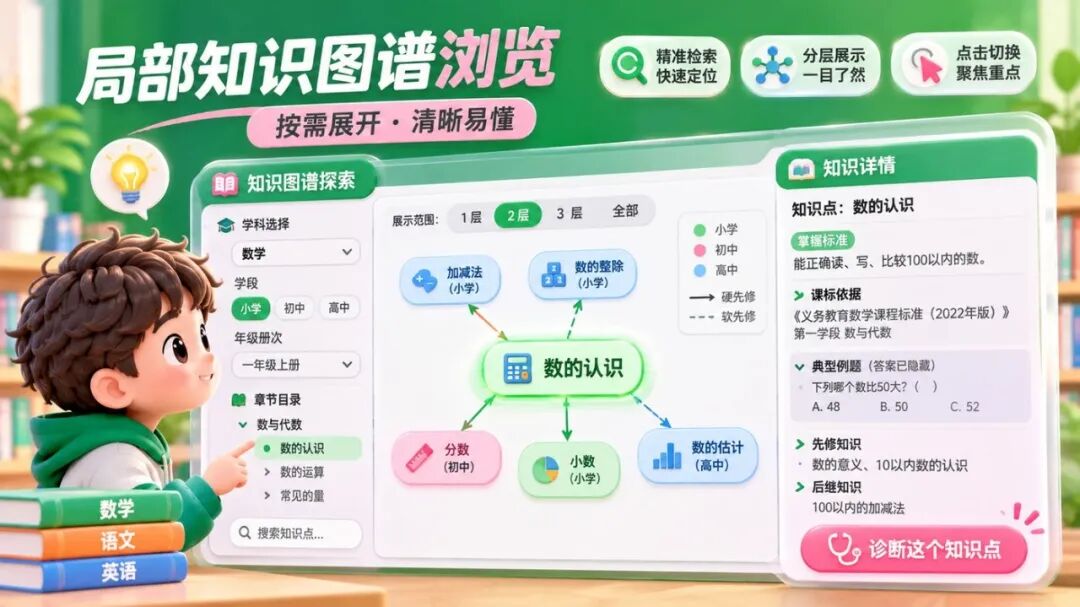
局部知识图谱浏览页
如果一次性把几千个节点全画在屏幕上,整张图会缩成一团无法辨认的毛线球。为此,图谱浏览页采用了「三栏布局 + 局部子图按需渲染」的克制设计:
- 左侧筛选与检索:支持切换学科、学段、年级册次与课程领域,按章节目录折叠展示,也支持直接搜索关键词。
- 中间交互画布:基于 Cytoscape 与 dagre 引擎,默认只渲染当前选中知识点的「向上 2 层先修祖先」与「向下 1 层后继节点」(可手动切换为 1/2/3 层或展开全部祖先)。小学、初中、高中节点用不同颜色区分,硬先修画实线,软先修画虚线,点击任意邻居节点就能平滑切换视觉焦点。
- 右侧知识详情:集中展示该知识点的掌握标准、对应的教育部课标条文、折叠了答案的样题,以及完整的先修与后继列表。底部放了一个醒目的「诊断这个知识点」按钮,点击即可进入实测。
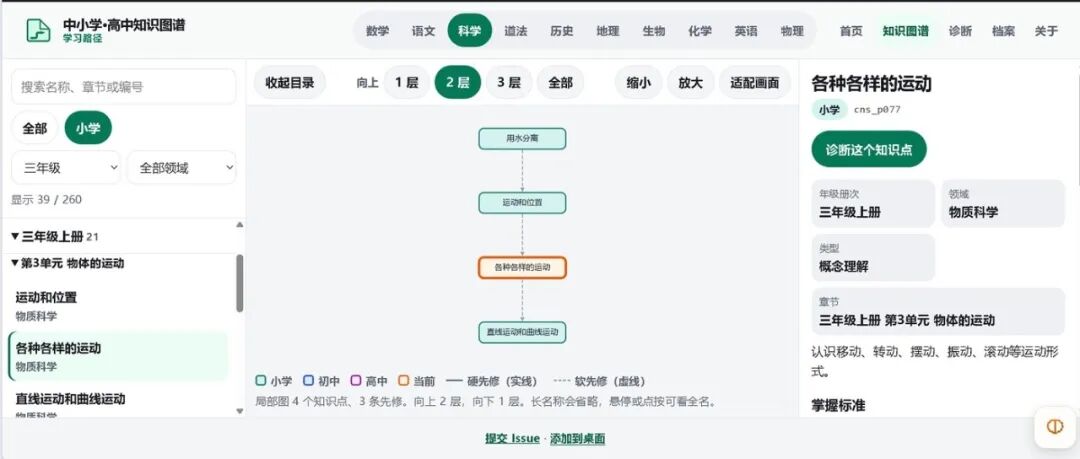
图谱浏览页:左侧筛选与中间局部子图
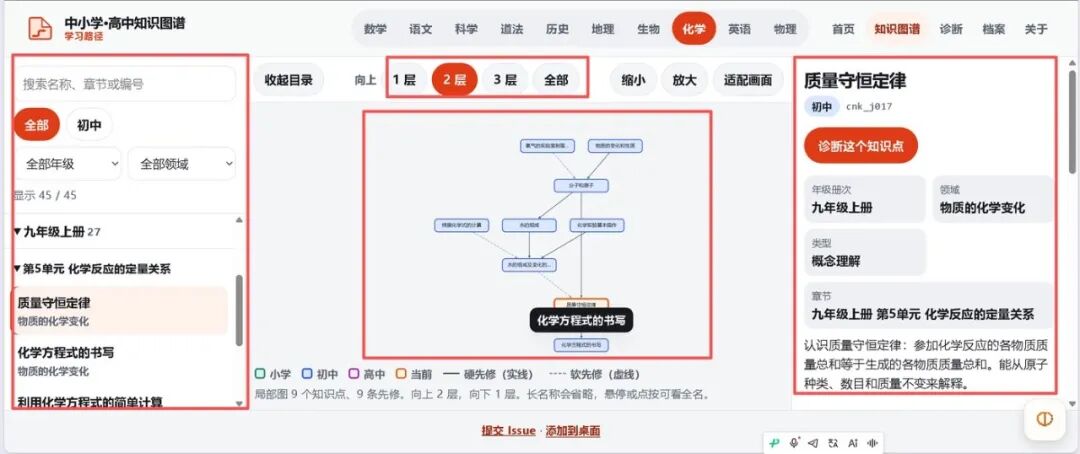
节点详情与红框标注的先修关系
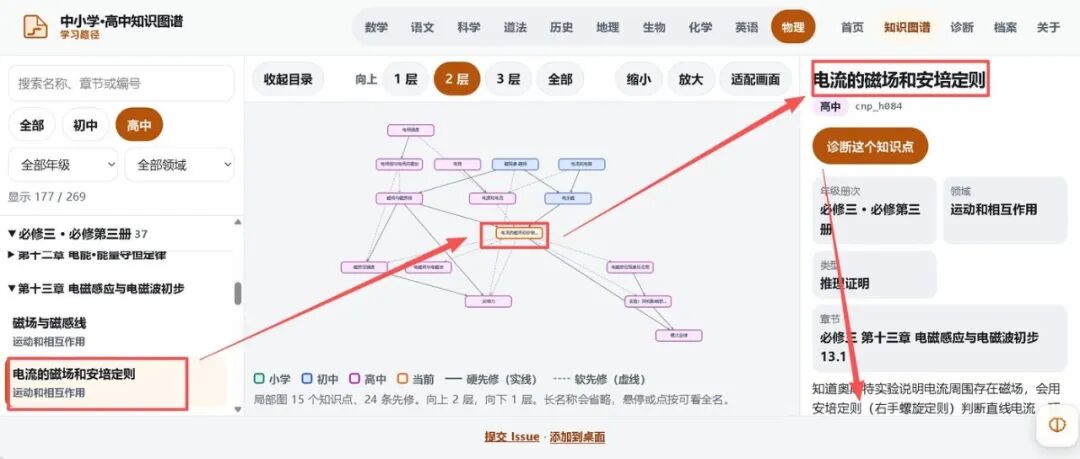
手绘箭头标出的回溯路径
功能 02 自适应前置回溯诊断(diagnose/)
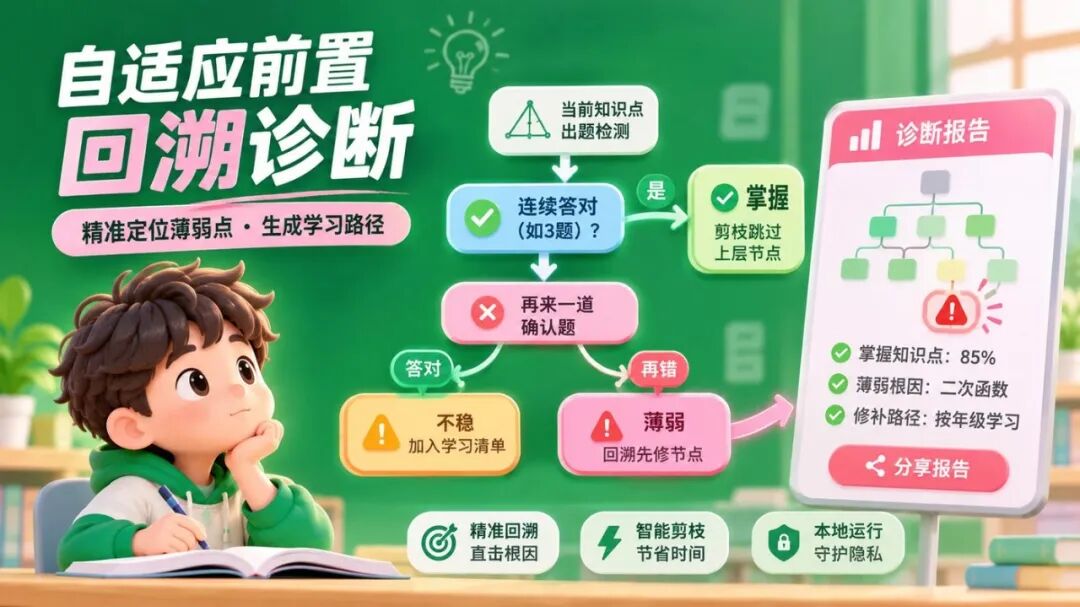
自适应前置回溯诊断
这是整个项目最核心的应用层(纯函数引擎位于 diagnose/engine.js)。你可以挑单个知识点精准排雷,也能按整章、整册甚至整年级发起大范围筛查。
出题与回溯算法的分寸:
- 连续确认与剪枝:针对当前考察点出题,用户连续答对满额题数(默认 3 题,可在开始页调整为 2/3/5 题)即判定为「掌握」,系统会直接剪枝,跳过该节点底下的所有先修祖先,节省答题时间(整册筛查模式下仅沿硬先修推断掌握,防止答对一两题就跳过整本书)。
- 容错复测机制:如果中途答错或点击「不会」,系统不会武断地直接定性,它会再出一道同难度或更基础的确认题。假如确认题答对了,说明刚才大概率是粗心或掌握不牢,系统会将该点标记为「不稳」(Shaky),放进学习清单但不再往下深究;只有当确认题也答错时,才正式判定为「薄弱」(Weak),随即将它的直接先修节点(硬先修优先)压入待测队列,一路顺藤摸瓜追查到底层根因。
- 可视化报告与防隐私分享图:诊断结束后,结果页会在路径图上用红框圈出最底层的「薄弱根因」,同时按从低年级到高年级的拓扑顺序拉出一份修补清单。此外,前端还能用 Canvas 直接在本地绘制一张 1080×1920 的竖版分享图,包含统计概况与薄弱点,不带任何孩子姓名等隐私信息,也支持直接导出 JSON 或打印成纸质报告。
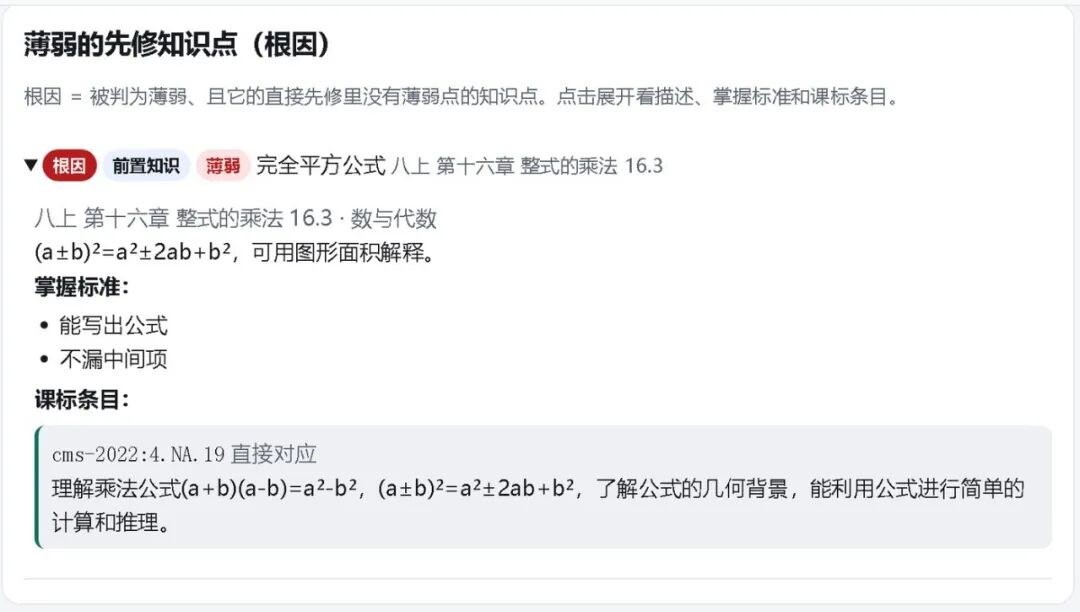
诊断说明与题库复核记录
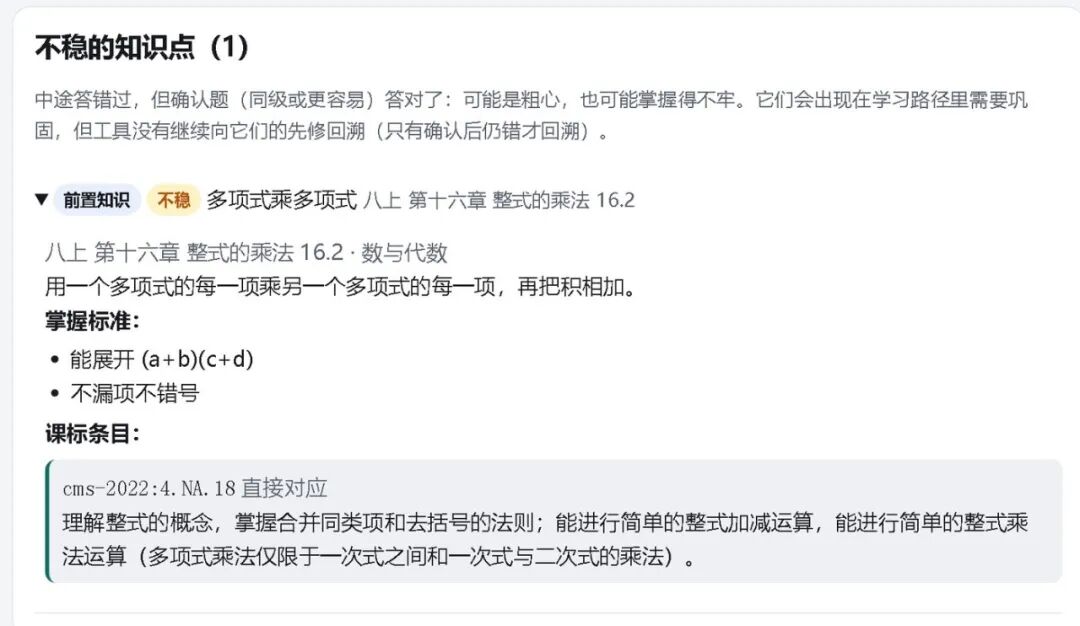
答题过程中的确认题
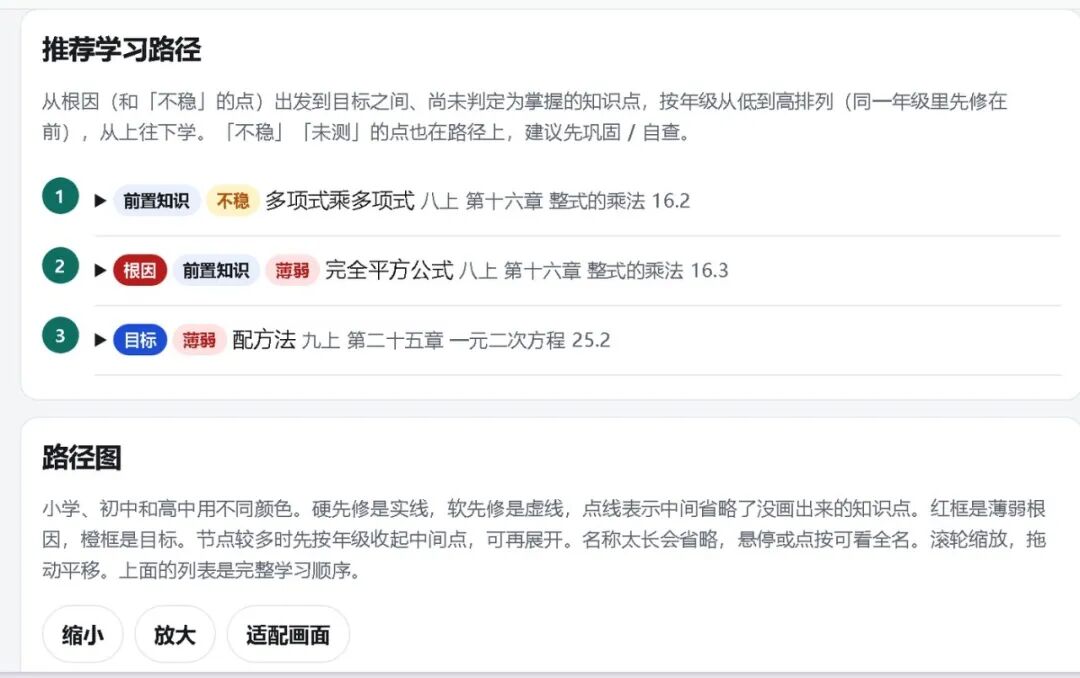
回溯路径与课标条文对照
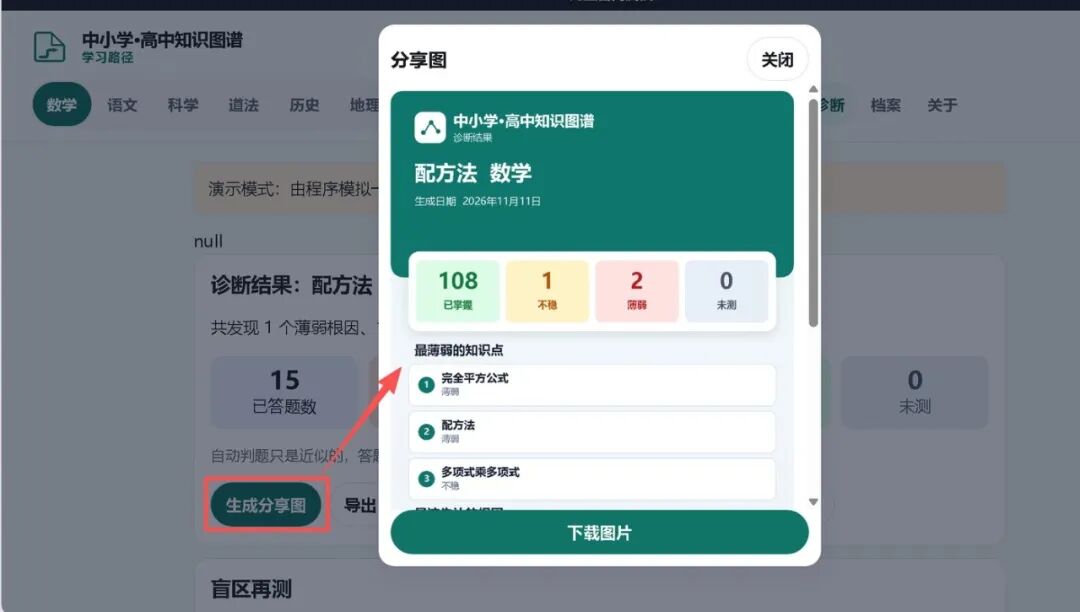
诊断结果页:薄弱点标记与一键再测
功能 03 本机盲区账本与多孩档案(children/)
每次诊断测出来的「薄弱」与「不稳」知识点,都会自动记入浏览器本地的 localStorage 错题账本中。家里如果有两个以上孩子,家长可以在 children/ 模块里创建最多 8 个本地档案,分别记录各自的年级和历史诊断轨迹,随时针对薄弱章节发起「一键再测」。
所有答题数据完全留在你自己的设备里,支持一键导出 JSON 备份文件跨设备恢复,不设账号体系,也不向任何云端服务器上传半个字节。
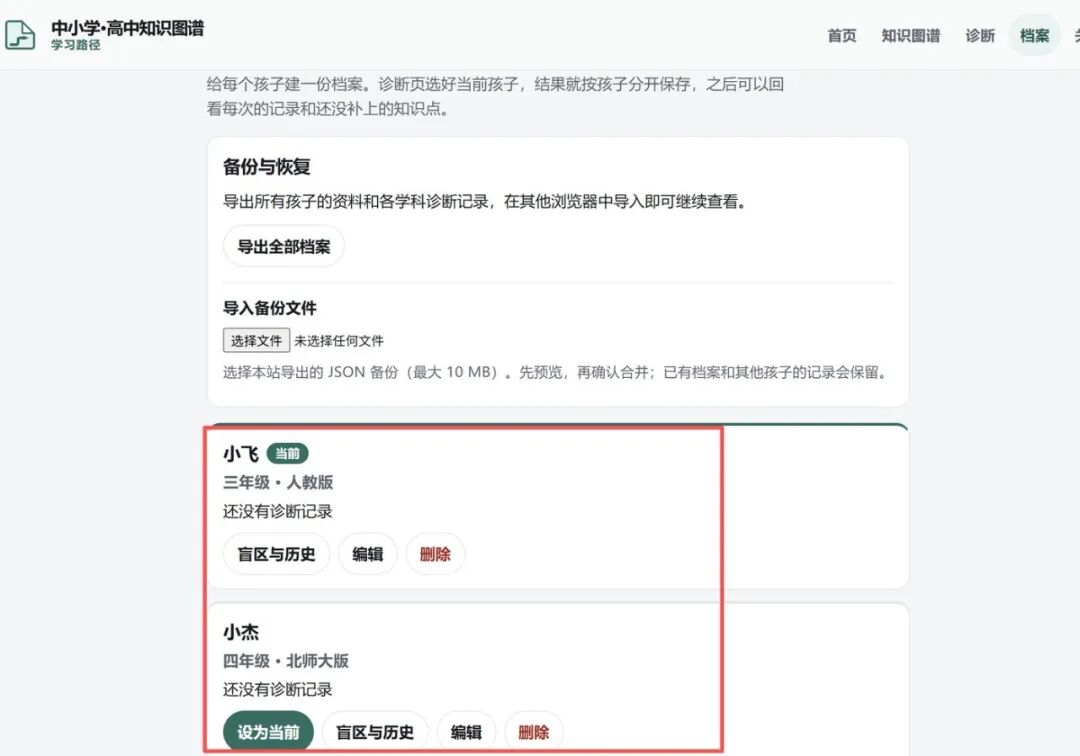
本机错题账本
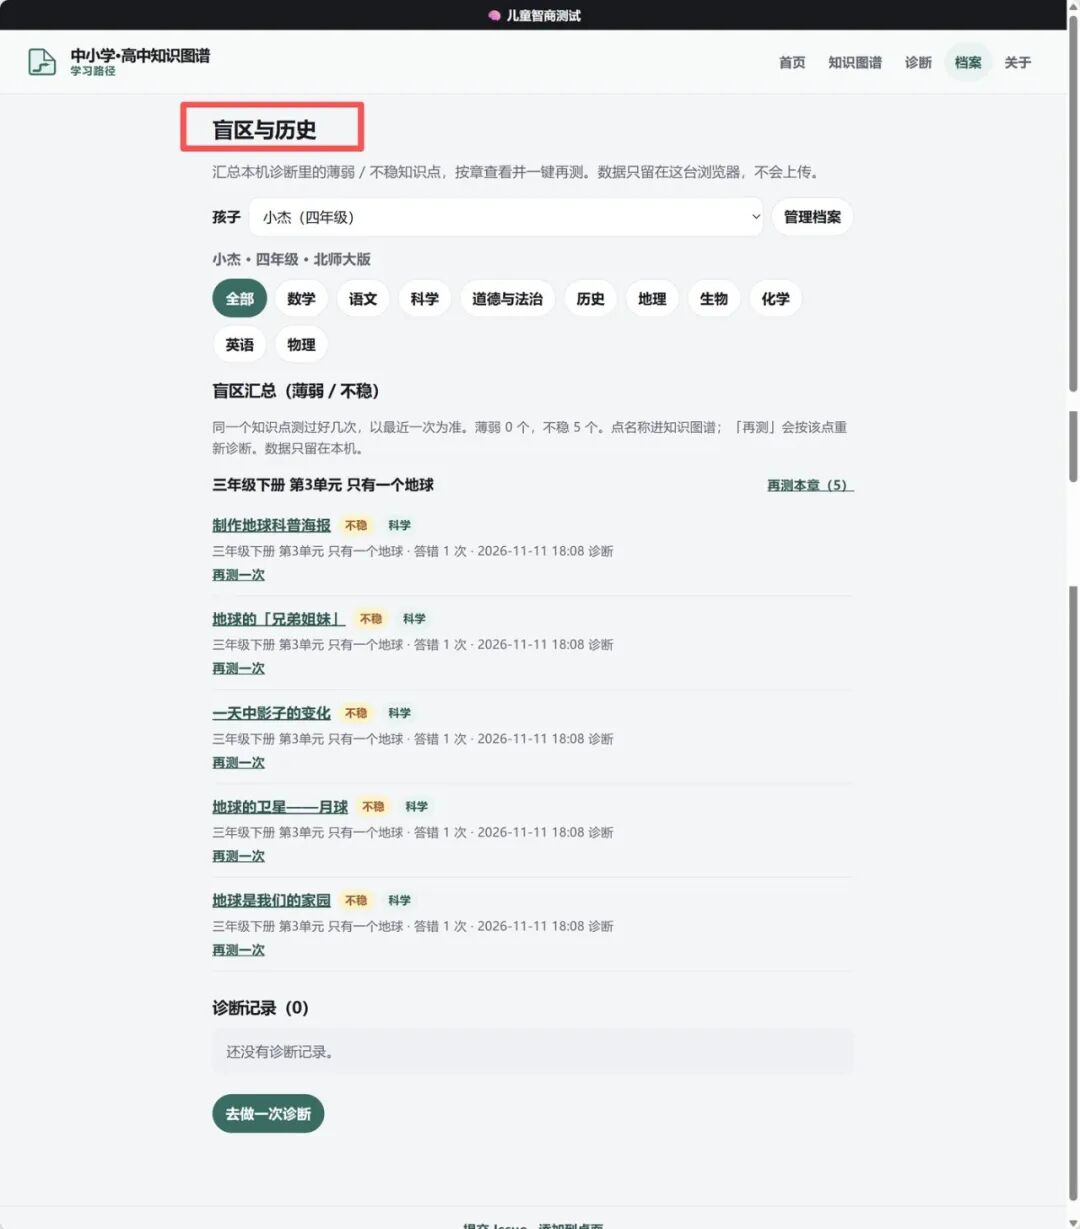
多孩档案与历史诊断轨迹
划重点
答对满额题数就剪枝跳过整条先修链;答错会先补一道确认题,两道都错才判为薄弱。答题数据只写进浏览器本地,导出 JSON 才能换设备。
04 零门槛体验与极简架构
作为一款极客范儿十足的作品,cn-math-taxonomy 在工程架构上做到了极致的克制:没有后端、没有数据库、不需要安装任何 npm 依赖,甚至连 Cytoscape、dagre、qrcode 这些前端图形库都直接打包在了仓库的 assets/vendor/ 目录下,不向外部 CDN 发任何请求。
方式一 在线直接使用
打开浏览器访问官方站点 math.pansgo.com 即可体验(作者也配置了 GitHub Pages 备份站)。因为内置了完整的 PWA 离线缓存机制,你在手机或电脑上打开过一次后,直接把它「添加到主屏幕/桌面」,哪怕断网也能照常浏览图谱和做题。
备份站地址
https://xiaoyang111222.github.io/cn-math-taxonomy/
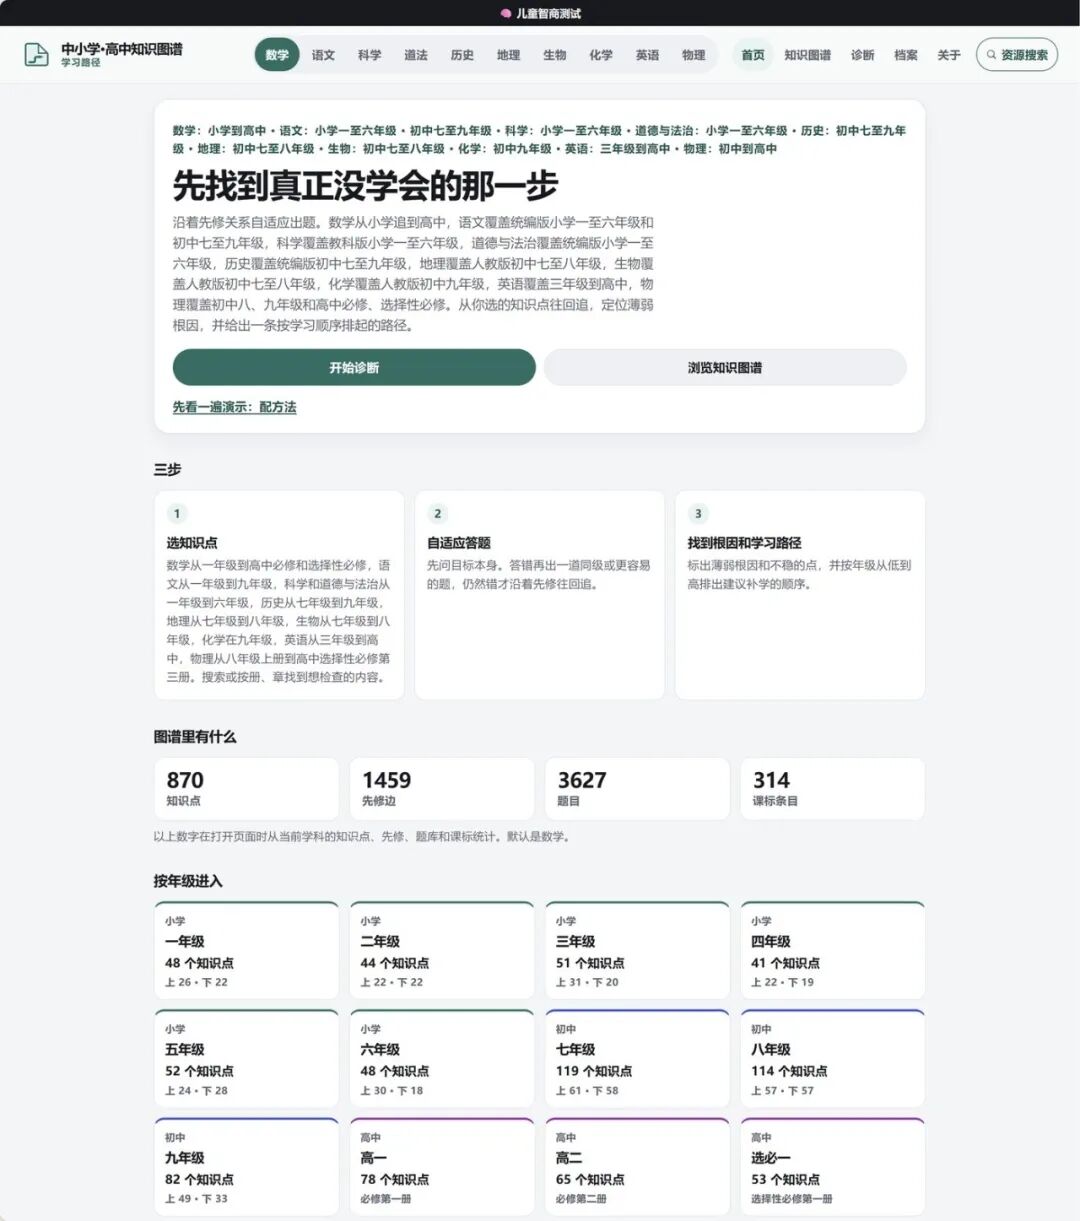
官方站点首页与 PWA 离线缓存
方式二 两行命令本地运行
如果你想在本地研究它的数据结构或修改题库,克隆仓库后只需启动一个最基础的静态服务器,随后在浏览器访问 http://localhost:8000/ 即可看到完整页面。
本地运行
git clone https://github.com/xiaoyang111222/cn-math-taxonomy.git
cd cn-math-taxonomy
python3 -m http.server 8000 # mac 或 linux
py -m http.server 8000 # windows
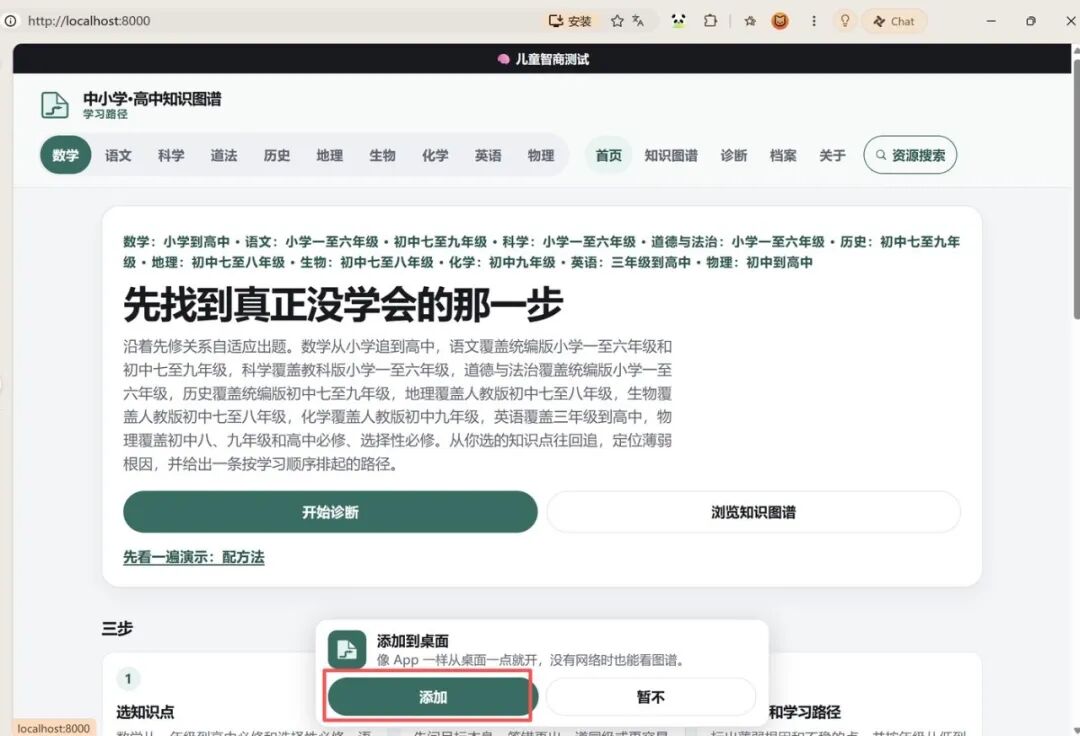
本地静态服务器打开后的页面
划重点
整个项目没有后端、没有账号、不发外部 CDN 请求,图形库一起放进仓库的 vendor 目录,离线打开照样做题。
05 难得的「数据诚实度」
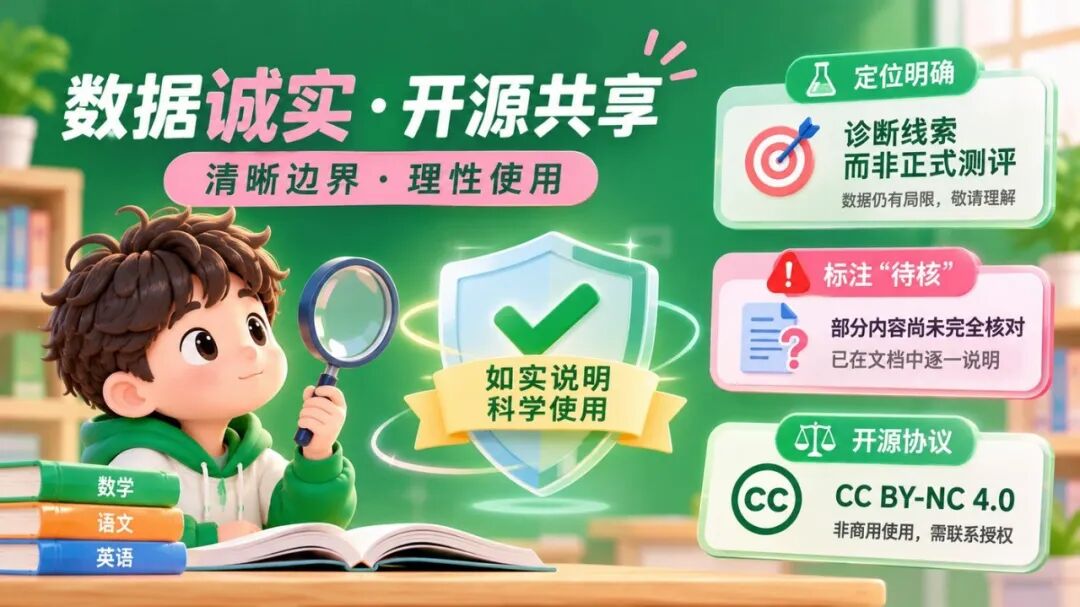
数据诚实与开源共享
看完全部文档,这个项目最打动人的地方,其实是作者在 README 里展现出的近乎严苛的「数据诚实度」。在如今遍地鼓吹「AI 颠覆教育」的浮躁环境里,作者用大段篇幅坦诚交底了当前版本的真实边界:
- 定位为「诊断线索」而非正式测评:仓库里的知识点拆分粒度、先修边的强弱划分以及题库主要由 AI 生成。尽管作者写了专门的 Python 校验脚本(verify_questions.py 受限表达式求值核验,并对初中数学等题库做了多轮独立盲解复核,将计算错误清零),但它尚未经过大规模一线教师审定,也没有经过真实学生作答数据的心理测量学(如 IRT 项目反应理论)区分度校准。
- 明确标注每一处「待核」:凡是国家中小学智慧教育平台尚未公开新版目录的册次(例如预计 2027 春才投入使用的数学九下,以及部分高年级下册教材),或者尚未逐字比对教育部纸质原件的课标转述(标注为 verbatim: false),作者都在文档和代码里逐一列出了参考来源与「非官方、待核」字样,绝不鱼目混珠。
- 非商用开源协议(CC BY-NC 4.0):项目的图谱数据、题库与代码均采用 CC BY-NC 4.0 协议开放。个人学习、一线教师教学、学术研究均可免费使用、修改与再分发(需署名);但任何商业用途(如嵌入付费 App、教培机构收费服务或售卖题库)必须联系作者获取单独的商业授权。
划重点
README 里逐项列出哪些目录还没拿到官方原件、哪些课标转述没做逐字比对,题库由 AI 生成这件事也写在前面。商用要单独找作者拿授权。
写在最后
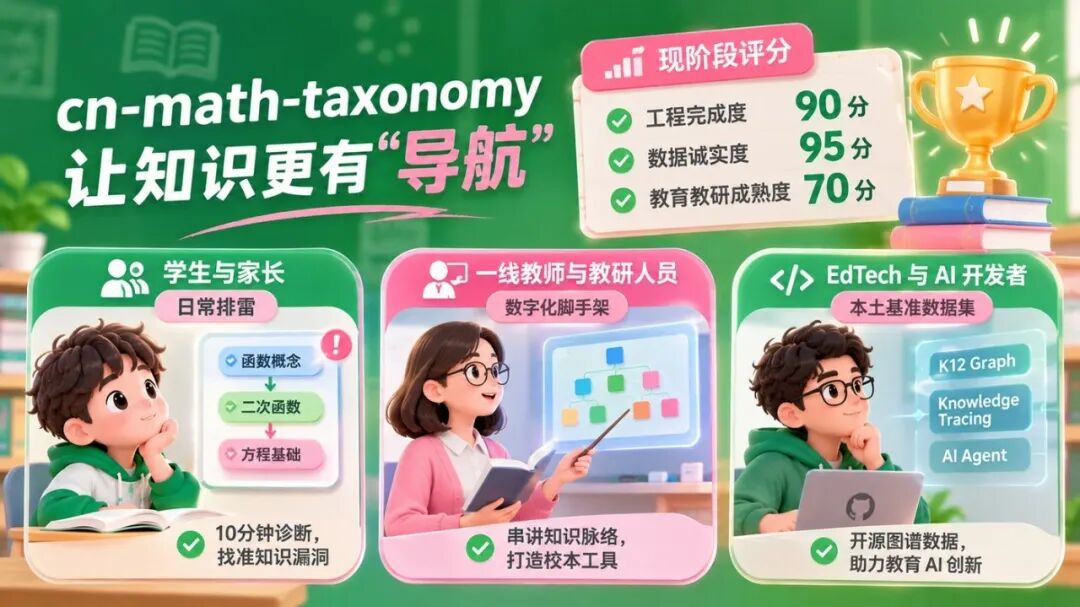
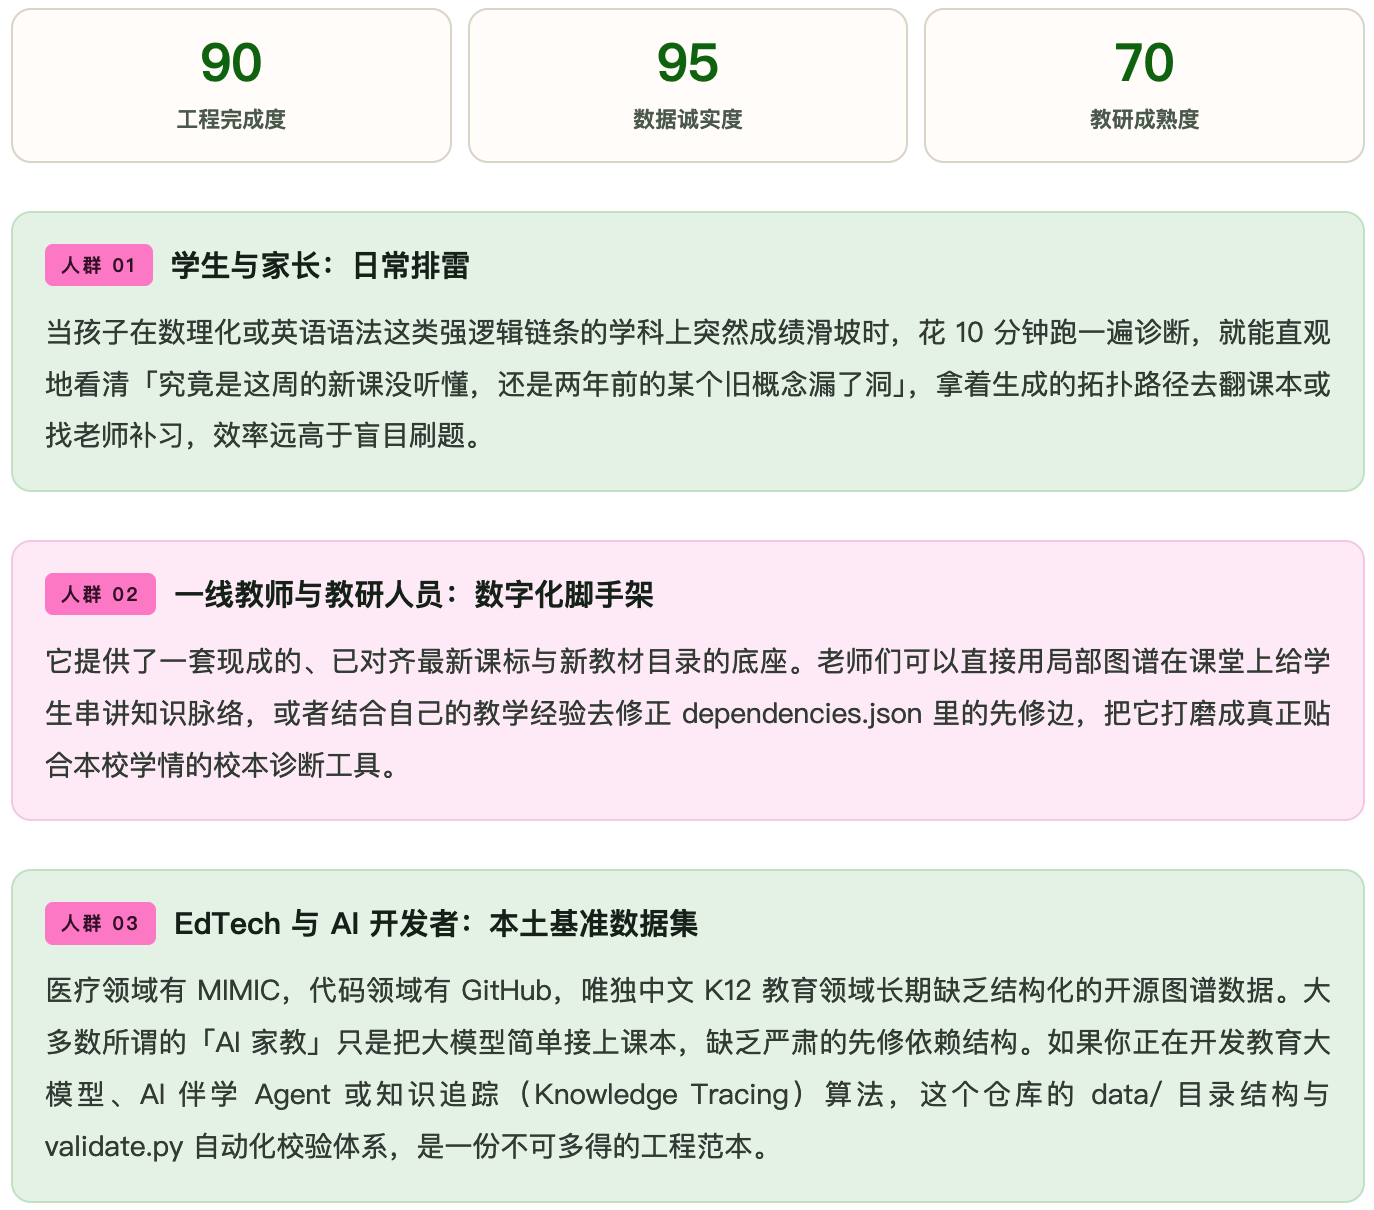
如果给现阶段的 cn-math-taxonomy 打个分,它的工程完成度可以给到 90 分,数据诚实度高达 95 分,教育教研成熟度则在 70 分左右。不同人群可以这样最大化利用它的价值:
本文由人人都是产品经理作者【AI李子】,微信公众号:【AI李子】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!