
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
决策模型杀到GPT-6身后!只差3分,速度快40倍、成本仅1/15


Decision Index v2 把置信度算进得分:Drex Max v1.1 与 GLiDE v1.2 拿到 73 分,只比 GPT-6 Luna 低 3 分,成本却是它的十五分之一,单项任务速度快四十倍。专业决策模型第一次有了独立的成本价值。
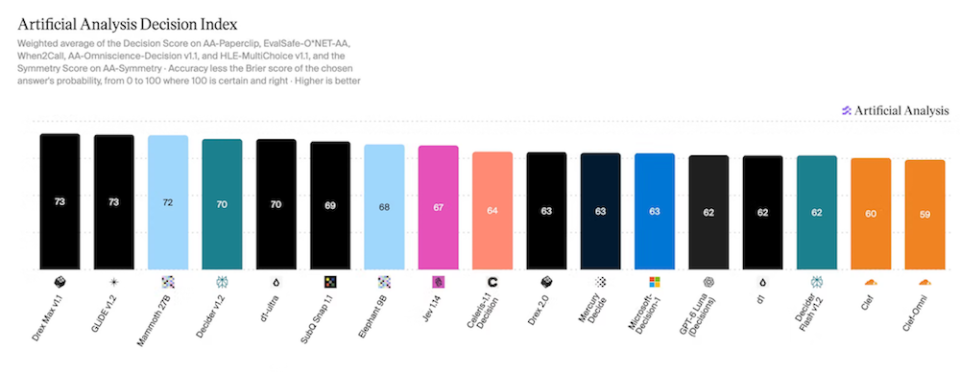
AI 模型评测正在从“谁更聪明”转向“谁能以更低成本做出可靠决策”。Artificial Analysis 最新 Decision Index v2 中,专业决策模型 Drex Max v1.1、GLiDE v1.2 得分 73,Mammoth 27B 得分 72;通用模型 Claude Haiku 5.5(Max)为 77,GPT-6 Luna(Max)为 76。
通用模型只领先 3 到 4 分,却付出了更高成本和更长耗时:GPT-6 Luna(Max)每百万项任务约 1530 美元,是 Drex Max v1.1 的 15 倍,单项任务耗时约 40 倍;Claude Haiku 5.5(Max)每百万项任务约 6240 美元,单项耗时约为 Drex 的 119 倍。
对企业开发者来说,榜单真正传递的信号不是“通用模型没用了”,而是专业决策模型开始具备独立的成本价值:在文档审核、事实抽取、合规判断和工具调用等固定任务中,轻量模型可能比旗舰模型更适合规模化部署。
Decision Index v2测什么
新版 Decision Index 不只统计答对多少题,还把模型的置信度纳入决策得分。每道题得分为:
Decision Score = 50 × (1 + c – (p – c)^2)
其中,p 是模型给出所选答案的概率,c 表示答案是否正确,答对为 1,答错为 0。汇总后等价于:
Decision Score = 50 × (1 + Accuracy – Brier Score)
Brier Score 用于衡量置信度校准。如果模型答错却非常自信,会受到更大惩罚;如果不确定时主动转人工或升级到更强模型,实际系统可能更安全。
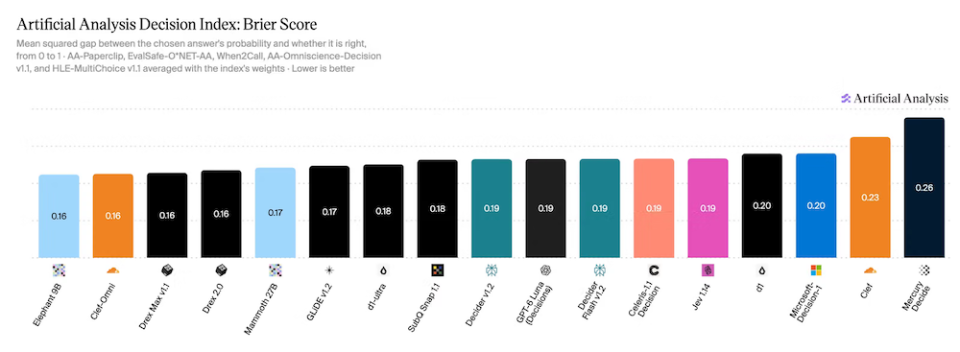
Decision Index v2 整合了 AA-Paperclip、EvalSafe-O NET-AA、AA-Omniscience-Decision、HLE-MultiChoice、AA-Symmetry 和 When2Call,覆盖文档决策、事实抽取、知识掌握、推理、答案一致性和工具调用。
AA-Paperclip 包含 1500 份简历、收据、发票及研究论文,每份文档有 5 道决策题和 10 道事实提取题,必须全部答对才算通过。新版还提高了私有数据集的占比,并移除已经接近饱和的测试项目。
专业模型只差1分,头部竞争已经很近
专业决策模型中,Drex Max v1.1 和 GLiDE v1.2 都拿到 73 分,Mammoth 27B 为 72 分。三款模型只差 1 分,说明专业模型在固定决策任务上的能力已经接近。
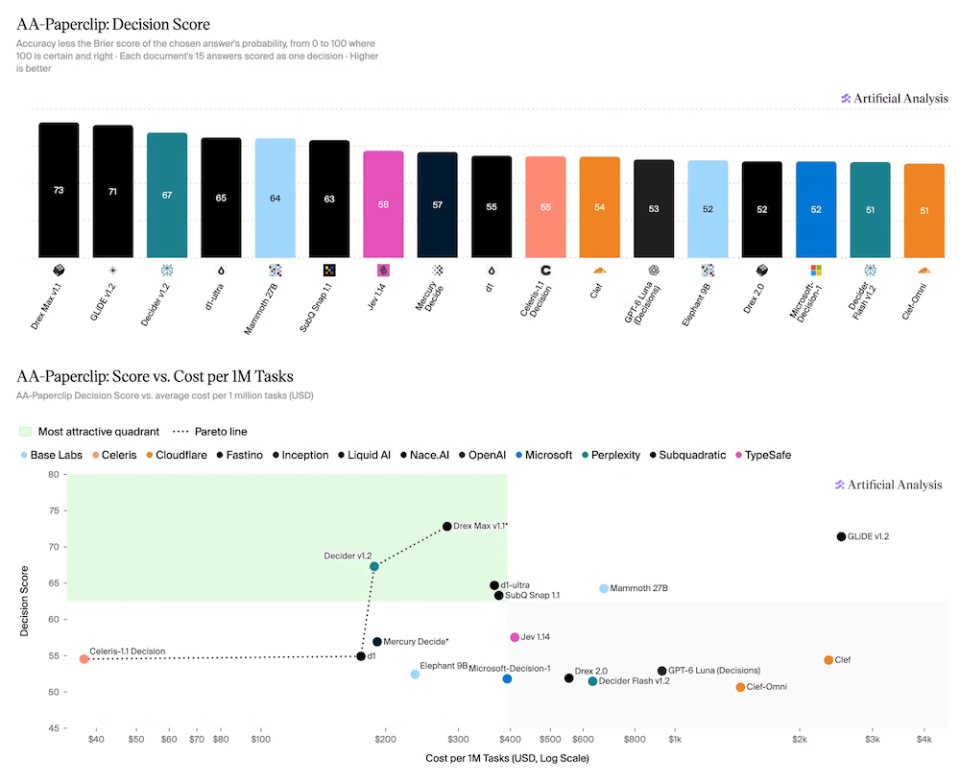
但综合得分接近,不代表每个维度相同。Drex Max v1.1 的单项答案正确率达到 97%,但在 Paperclip 中只有 71% 的文档完成全部 5 道决策题,88% 的文档完成全部事实抽取。模型可能“多数题答对”,却在整份文档级任务上失败。
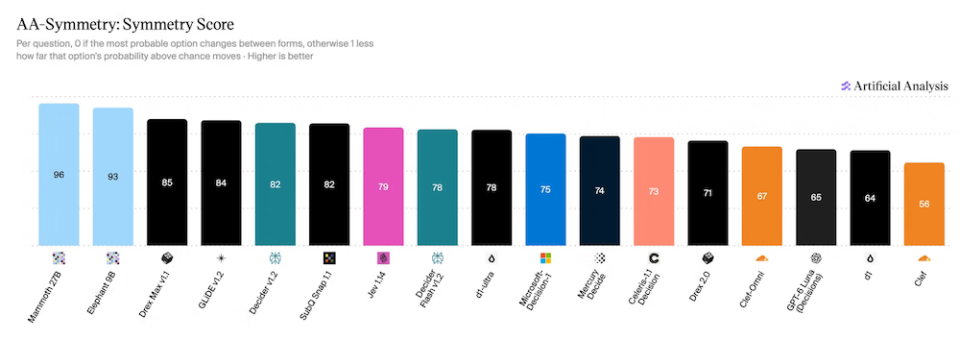
AA-Symmetry 则测试模型面对不同措辞时能否保持答案一致。Mammoth 27B 得分 96,Elephant 9B 得分 93;部分模型的高分与较高弃答率有关,因为它们面对不确定问题时更愿意承认不知道。
这对企业系统很重要:可靠决策模型不只要准确,还要知道什么时候应该停止、转人工或升级。
通用模型更强,但成本和耗时更高
Claude Haiku 5.5(Max)和 GPT-6 Luna(Max)分别拿到 77 分和 76 分,领先专业决策模型 3 到 4 分。但性能差距带来了巨大的成本差异。
| 模型 | 综合得分 | 单项耗时 | 每百万项任务成本 |
|---|---|---|---|
| GPT-6 Luna(Max) | 76 | 11.34 秒 | 1530 美元 |
| Claude Haiku 5.5(Max) | 77 | 32.65 秒 | 6240 美元 |
| Drex Max v1.1 | 73 | 275 毫秒 | 102 美元 |
| Celeris-1.1 Decision | 未列核心第一 | 56 毫秒 | 14 美元 |
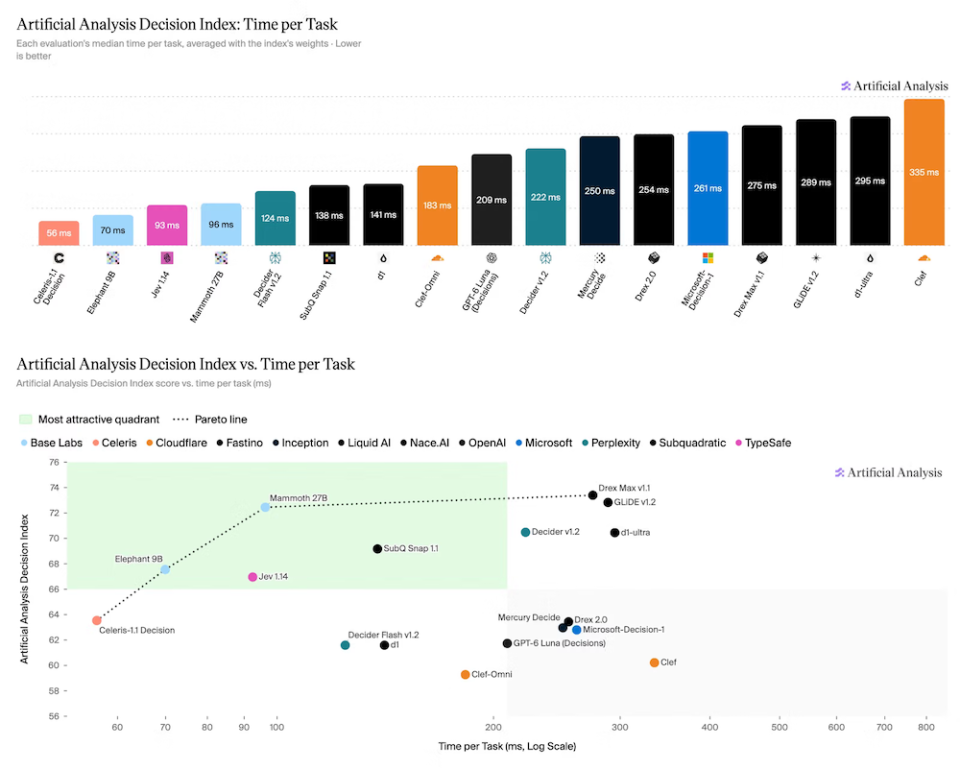
Mammoth 27B 与 GPT-6 Luna(Max)只相差 4 分,但任务速度快 118 倍。对于每天处理百万级文档的业务,少量精度差距是否值得几十倍成本,需要用真实业务损失计算,而不是直接选择最高分模型。
调用方式可能比Token单价更重要
专业模型的成本差距超过 60 倍。Celeris-1.1 Decision 每百万项任务约 14 美元,Drex Max v1.1 约 102 美元,Clef 则达到 859 美元。
差异不只来自 Token 单价,还来自文档输入是否复用。Drex Max v1.1 和 Decider v1.2 处理同一份文档的多道题时,可以只计算一次文档输入;GLiDE v1.2 和 Decider Flash v1.2 则会为每道题重新输入整份文档。
在 AA-Paperclip 中,GLiDE v1.2 每项任务平均需要约 6.3 万输入 Token,Drex Max v1.1 只需要约 9000。结果是 GLiDE 每百万项任务成本约 780 美元,接近 Drex 的 8 倍,尽管 Token 标价只高约 33%。
这给开发者一个直接提醒:优化成本时,先看请求结构和缓存策略,再看每百万 Token 单价。相同文档的多轮问题应该复用输入,能够缓存的上下文不要重复发送,评测和生产都要记录真实 Token 消耗。
给企业的模型路由建议
可以把决策任务分成三层:
- 低风险高频任务:分类、字段抽取、规则匹配,使用低成本专业模型。
- 中等风险任务:文档审核、合规判断、跨文档分析,使用具备良好置信度校准的专业模型,低置信度时转人工。
- 高风险开放任务:复杂研究、异常案例和需要解释的决策,升级到通用旗舰模型或人工专家。
路由系统至少要保存模型版本、输入 Token、缓存命中、输出、置信度、升级原因、人工结果和最终业务结果。没有这些数据,企业只能看到账单,无法判断模型到底省了多少钱或造成了多少返工。
国内开发者如果需要将决策模型或 Claude Code 等工具接入兼容 API,可通过 [Code80]https://code.ai80.vip/home 配置 endpoint;模型路由、数据权限、密钥隔离、预算和生产审计仍应由项目侧管理。
常见问题
专业决策模型已经超过通用大模型了吗?
没有。通用模型在综合得分上仍然领先,但专业模型在固定任务中的成本、速度和置信度校准可能更有优势。
Decision Score为什么要加入置信度?
因为生产系统不仅需要答案,还需要知道答案是否可靠。模型答错却非常自信,会比明确表示不确定更危险。
为什么同样的Token单价,任务成本会差很多?
如果每道题都重新输入同一份文档,输入 Token 会重复计算。缓存和文档复用策略会显著影响最终成本。
企业怎样选择决策模型?
用真实业务数据比较准确率、文档整体通过率、置信度校准、响应时间、Token、人工升级率和错误损失,不要只看榜单总分。
什么时候应该升级到通用旗舰模型?
当任务开放性强、证据复杂、风险高或专业模型置信度不足时,可以升级到通用模型或人工专家,并记录升级原因。
国内开发者如何接入兼容 API?
可以通过 Code80 了解接入方式,同时自行管理模型权限、密钥、数据留存、调用预算和审计日志。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!