


 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Claude Opus 5.5发布:能力追平Fable 5.1,成本低四成


Opus 5.5 已上线 Claude 及 AWS、Google Cloud、Azure,输入每百万 token 4 美元、输出 20 美元,典型任务成本比上一代低约四成,速度提升三成以上。Terminal-Bench 4.0 默认档接近 Astra,成本仅四成。
刚刚,Opus 5.5 发布,堪比 Fable 5.1,但价格更低:每百万 token 输入 4 美元、输出 20 美元,典型任务成本较 Opus 5 低约 40%
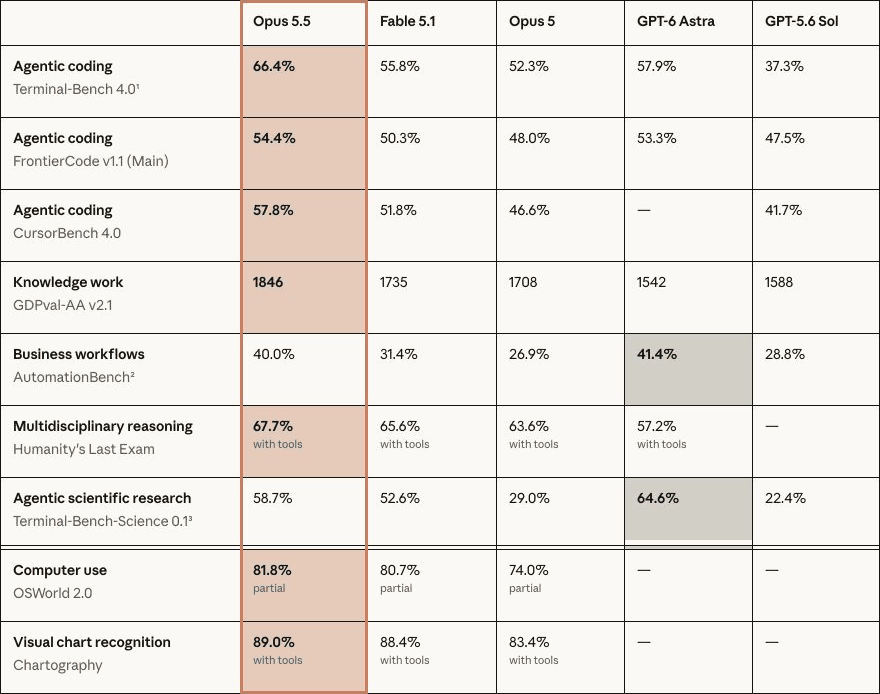
Anthropic 公布的完整 benchmark 对比
Opus 5.5 已上线 Claude 及 AWS、Google Cloud、Microsoft Azure 等平台,API 模型名是 claude-opus-5-5
价格降低
这里先放一下目前 Anthropic 的各个模型的价格
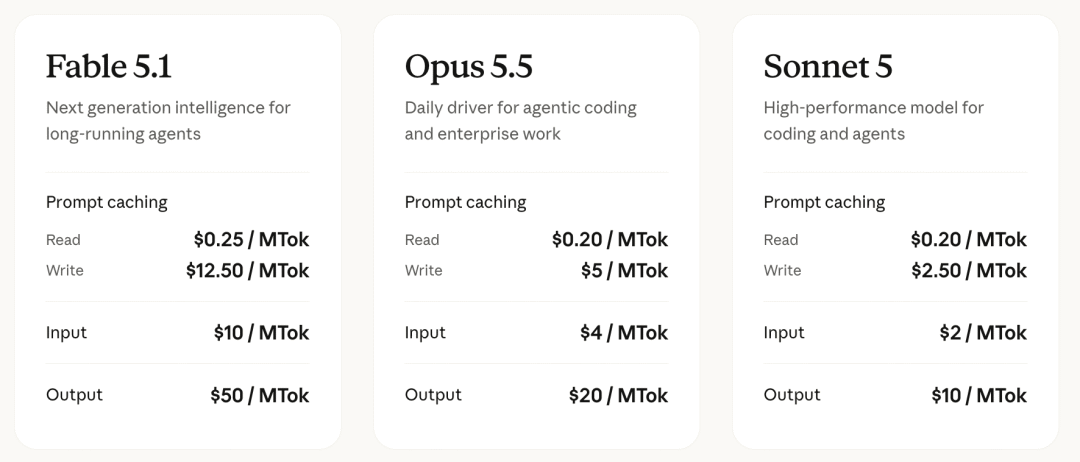
Fable 5.1、Opus 5.5 与 Sonnet 5 定价,美元/百万 token
Opus 5.5 的输入、输出单价是 Fable 5.1 的四成、Sonnet 5 的两倍,定位是日常 Agent 编程和企业工作的主力
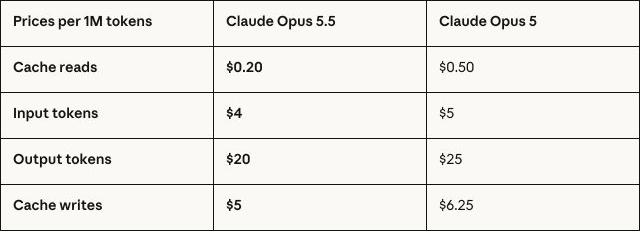
Opus 5.5 与上一代 Opus 5 的价格对比
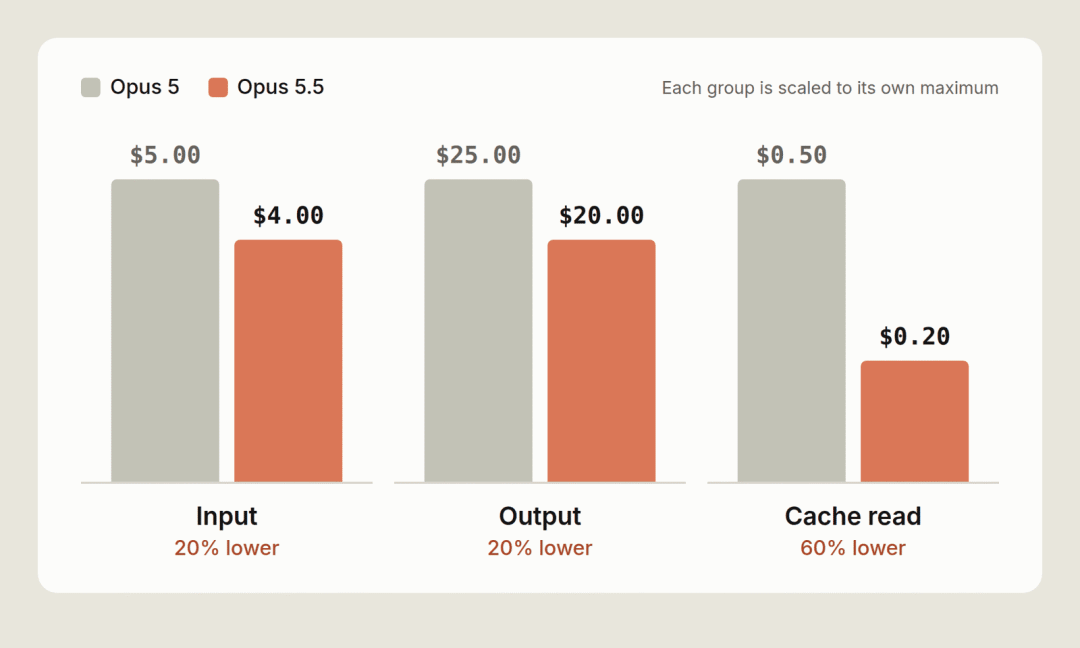
三种单价的降幅,柱高分别归一化
相较 Opus 5,输入、输出、缓存写入和读取分别从 5、25、6.25、0.50 美元降到 4、20、5、0.20 美元
输入输出降价 20%,缓存读取降价 60%;典型任务总成本下降约 40%
官方举了一个假设账单:200 万缓存读取、20 万新输入、6 万输出 token,Opus 5 为 3.50 美元,Opus 5.5 为 2.40 美元,单靠降价就省约 31%
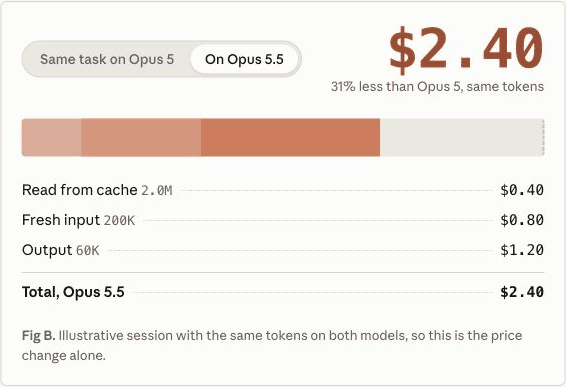
相同 token 用量的任务账单示例
思考 token 也按输出计费,单价是缓存读取的 100 倍。少绕路、少重试往往比单纯减少输入更有价值
普通模式的输出生成速度比 Opus 5 快了 30% 以上。Claude Code 和 Claude Platform 还提供最高 2.5 倍速度的 Fast mode,输入、输出分别为每百万 token 8、40 美元
编程相关
Terminal-Bench 测命令行复杂任务
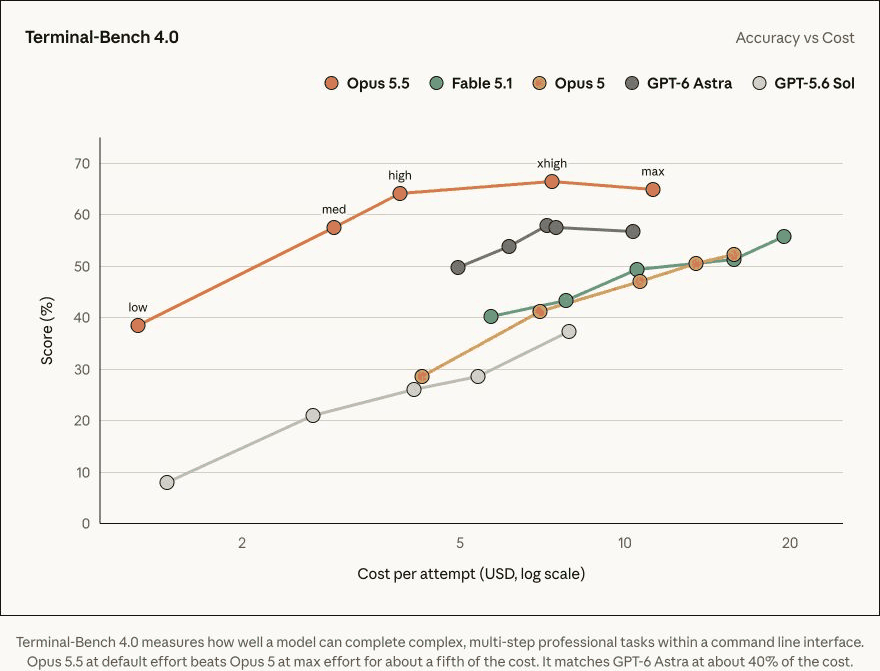
Terminal-Bench 4.0:能力与成本
Opus 5.5 默认 medium 档位得到 57.6%,每次约 2.94 美元;GPT-6 Astra 的 high 档位为 57.9%,约 7.21 美元。成绩接近,成本约为四成。相较 Opus 5 的 max 档位,它默认档位的成绩更高,成本约为五分之一
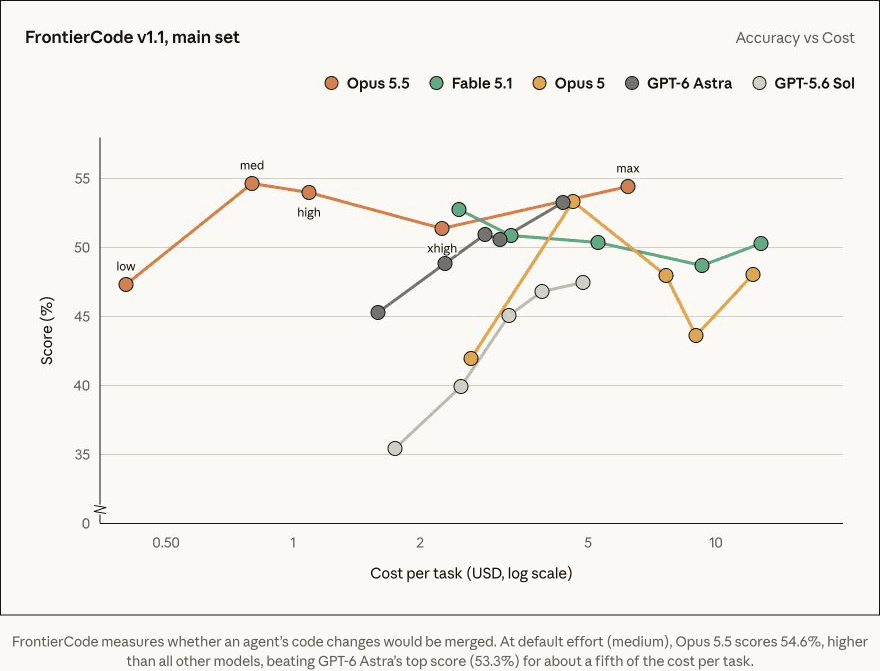
FrontierCode:代码修改质量与任务成本
FrontierCode 看代码修改能否合入。Opus 5.5 默认档位 54.6%,高于 Astra 最高的 53.3%,成本约为五分之一
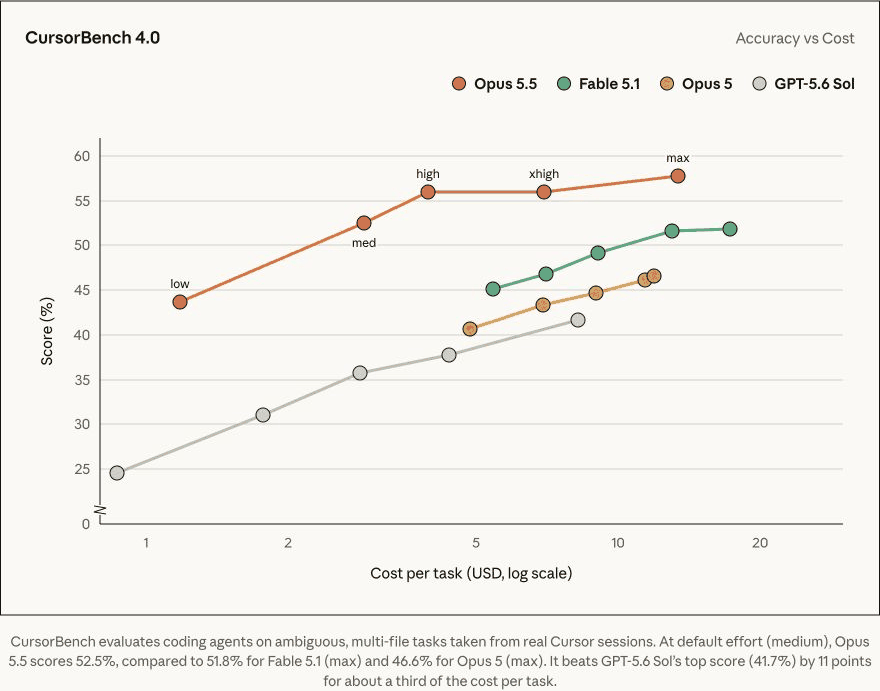
CursorBench 4.0:真实编程会话中的多文件任务
CursorBench 测真实会话中的多文件任务。Opus 5.5 默认档位 52.5%,超过 Fable 5.1、Opus 5 的 max 档位;比 GPT-5.6 Sol 最高成绩高约 11 个百分点,成本约为三分之一
实际工作里的变化更直观:
- 一位早期测试者在不到一天里完成了 68 万行代码迁移,官方称原本需要工程团队数周
- 另一位测试者审查并修复 20 万行代码,Opus 5.5 不到 3 小时完成;Opus 5 超过 20 小时,token 消耗是它的 2.5 倍
- 把 HAProxy 从 C 改写成 Rust,两者都通过了原项目几乎全部回归测试,Opus 5.5 用时 9.5 小时,Fable 5.1 用时 12 小时,前者成本低 51%
- 优化一个 Web 应用所有页面的加载速度,Opus 5.5 在 40 次尝试中成功 39 次;Opus 5 改善较小,还改变了原有行为
- 用同一个提示词让不同 Claude 模型做游戏,测试者给 Opus 5.5 的画面和完成度最高分,官网未展示可玩成品
客户反馈里,GitHub 用不到一半步骤解决更多终端任务;Lovable 步骤减少三分之一到一半;Quantium 的任务从 4 天、38 次提示缩到 3 小时、11 次;Kiro 调用次数少约 40%、token 减半;Spotify 也观察到提速降本
Clio 让它跨 6 个仓库连续工作超过 18 小时,梳理服务通信,进度更快、返工更少。Optiver 达到 Opus 5 质量所需轮次、时间和输出 token 约减半,成本下降 40%—50%;交易支持及一项 8 模型分析测试也取得最佳成绩
Column 发现它更会分派子 Agent 和自查,找出云账单节省机会,并通过第三方文档发现早先的集成错误
知识工作
GDPval-AA 覆盖 44 种职业。Opus 5.5 最高为 1846 Elo,超过 Fable 5.1 的 1735 和 Opus 5 的 1708;默认档位也超过 Astra max,成本约五分之一
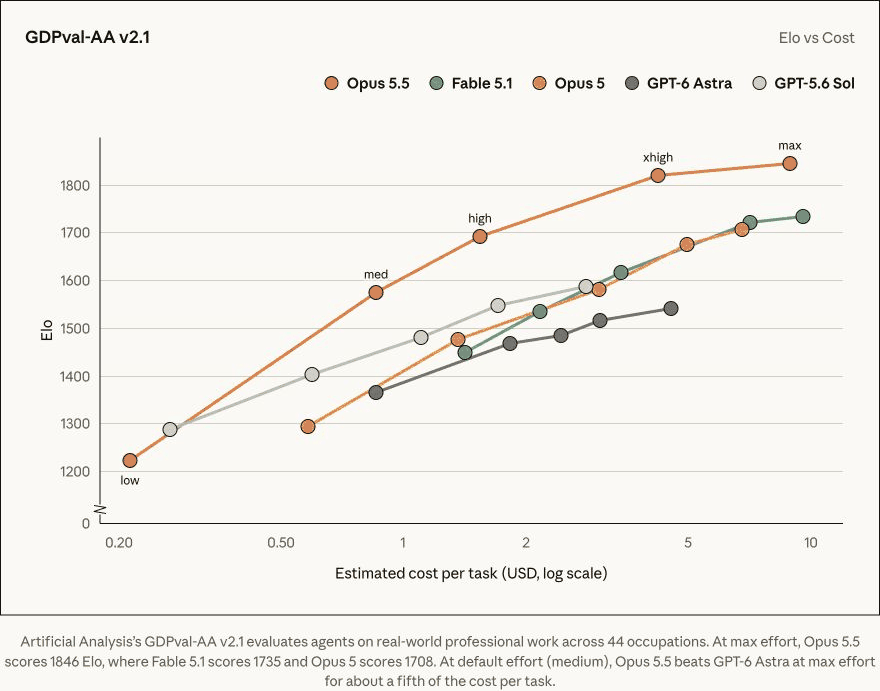
GDPval-AA v2.1:知识工作质量与成本
不过注意,Elo 衡量相对质量,不是正确率
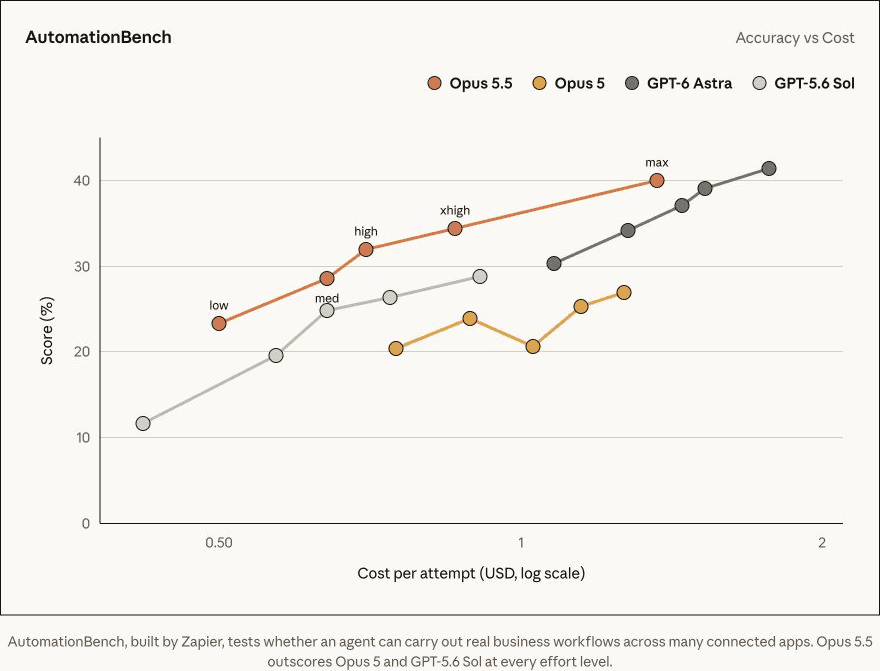
AutomationBench:跨应用业务流程
Zapier 的 AutomationBench 测跨应用执行真实业务流程。Opus 5.5 在各档位超过 Opus 5 和 GPT-5.6 Sol,但最高成绩 40.0% 仍略低于 Astra 的 41.4%
总表中的科学研究评测也一样:Opus 5.5 为 58.7%,Astra 为 64.6%,各模型标准误差约 ±3.5—5 个百分点。Opus 5.5 并非所有项目都领先
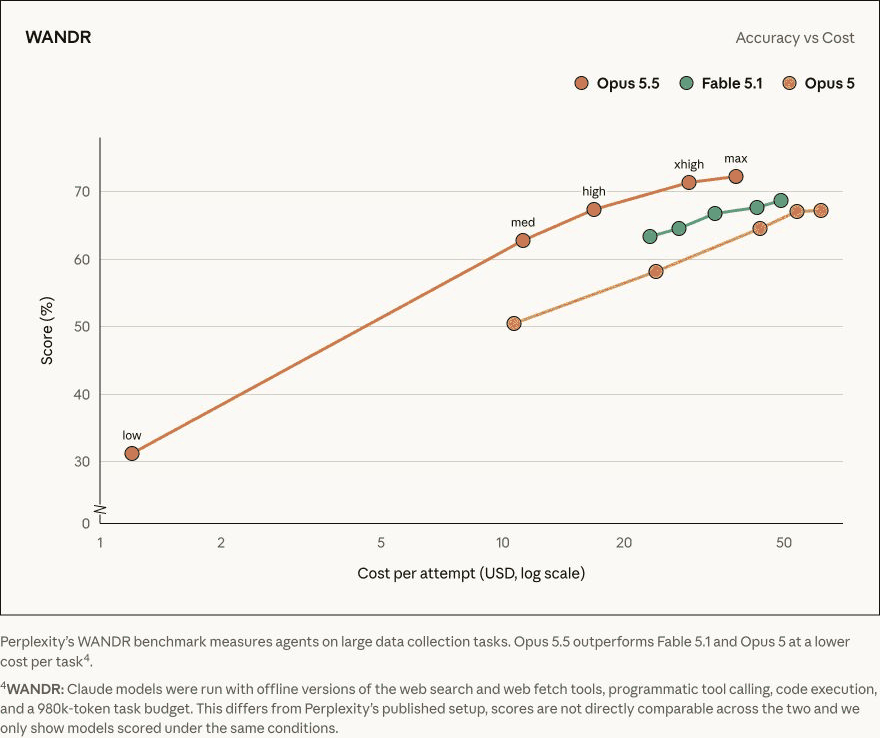
WANDR:大规模信息收集
WANDR 考察大规模数据收集,Opus 5.5 以更低成本超过 Fable 5.1 和 Opus 5。这组测试用了离线搜索与网页抓取、程序化工具调用、代码执行,以及每项 98 万 token 的预算,与 Perplexity 原始环境不同,只能比较同条件结果
Anthropic 让模型在财报难检索的网页副本中写业绩报告,数字或引文有任何编造都不通过。Opus 5.5 的 18 份报告有 16 份通过;Fable 5.1 和 Opus 5 在这项测试中均未通过
Hex 让模型判断包裹延误还是追踪更新慢。Opus 5 看签收记录后认为追踪正常;Opus 5.5 查出包裹晚到、追踪也坏了,避免停在第一个合理解释
Walleye Capital 的量化测试中,最低档位已基本解决任务;更高档位还发现评测指令的分钟索引错一位。它修正并提示可能被扣分,客户确认判断正确
评估两家虚构 HR 软件公司的合并,要在 Excel 建模并做演示。两代结论相同,但 Opus 5.5 模型更完整、演示更易读,Opus 5 有小错误;用时 63 对 93 分钟,前者便宜 50%
其他客户的结果也覆盖了专业工作:
- Deloitte:最低档位发现 72% 的已知代码 bug,Opus 5 high 档位为 56%,且前者误报更少;咨询分析中,低档位用约一半输出量达到较高档位质量
- Rogo:最低档位在 BigFinance Bench 超过 Opus 5 high 档位,输出 token 少约 60%,回答和幻灯片更紧凑
- Hebbia:按专家标准检查端到端财务流程,要求覆盖率从 Opus 5 的 60.3% 提高到 86.6%,引文召回也创下内部最佳记录
- LexisNexis:更稳定地找到相关引证,并围绕法条、核心框架和问题组织回答;Thomson Reuters Labs 的法律评测也观察到质量、速度和效率提升
- Viktor:相同思考档位下,步骤和工具调用更少,成本接近减半,做对的最难任务数量翻倍
Opus5.5 的风格
在对话风格方面,Opus 也有所不同
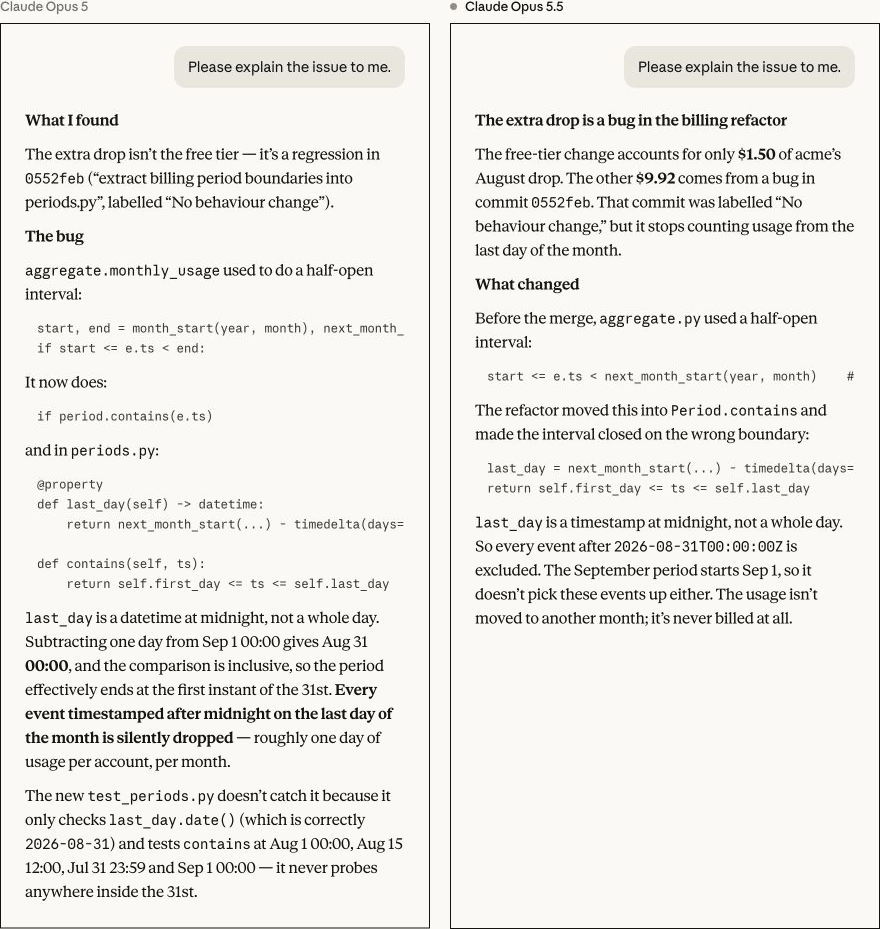
Opus 5 与 Opus 5.5 对照
这里做一个对比,对于同样的 Debug 问题,Opus 5 先讲重构和代码;Opus 5.5 先讲影响:账单下降中,免费额度只解释 1.50 美元,另外 9.92 美元是漏算月末用量
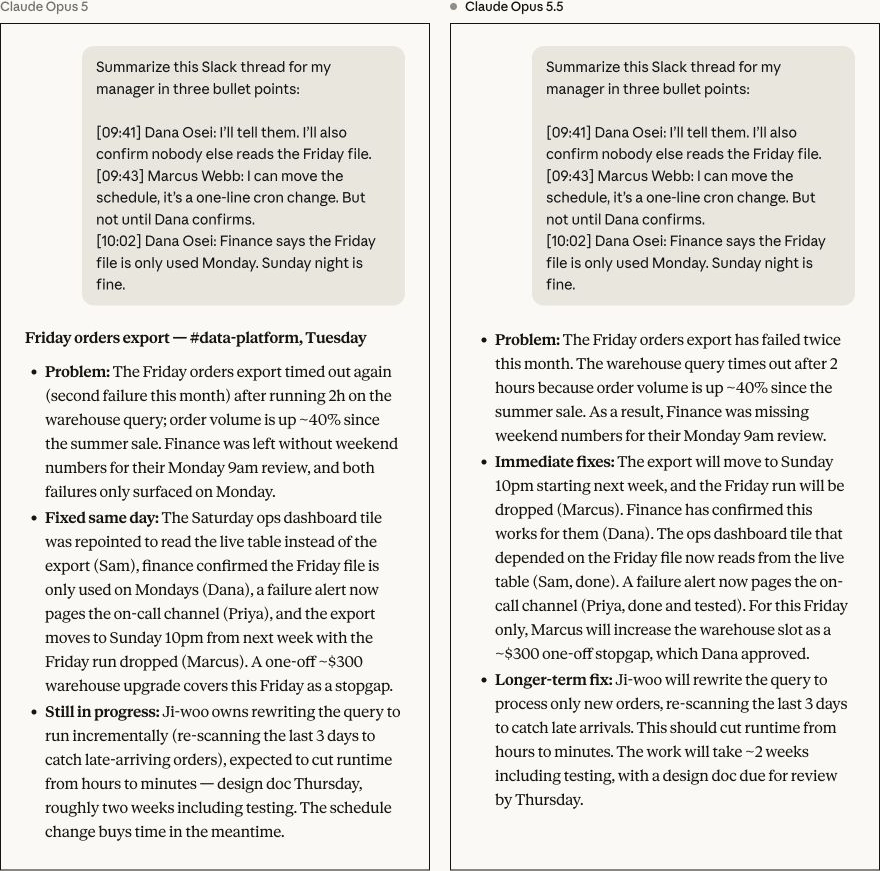
把 Slack 讨论整理成经理需要的摘要
而在总结 Slack 讨论时,Opus 5.5 则会区分问题、立即措施和长期修复:仪表盘、告警已完成
怎么用更划算
官方建议日常工作从 medium 开始,机械修改用 low,卡住再试 high;搜索、读日志可交给 Sonnet/Haiku 子 Agent。高档位仍反复失败的难题,再考虑 Fable。给模型可运行的测试,也能减少无效重试
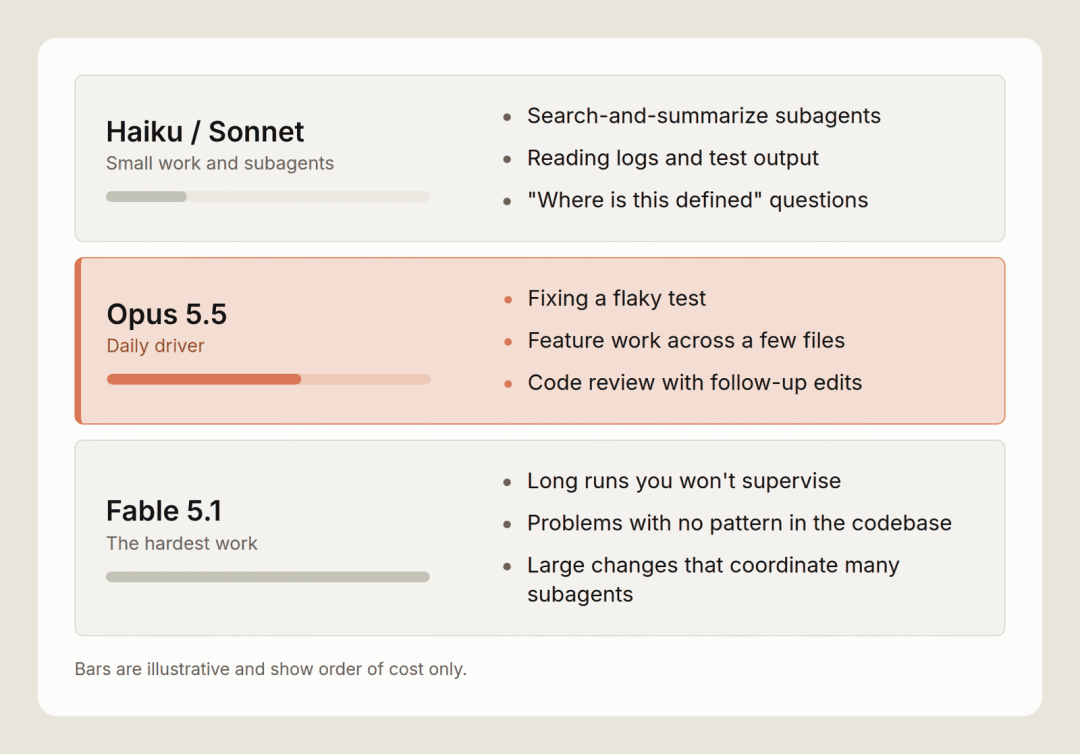
按任务选择模型,条长仅示意成本顺序
一次 44 张工单的内部测试,从 Opus 4.8 换到 Opus 5.5 low 后成本降约 18%;再用 /claude-api prompt-audit 清理强制六步、重复验证等指令,进一步降约 9%,累计约 25%。这是单项测试,不是通用承诺
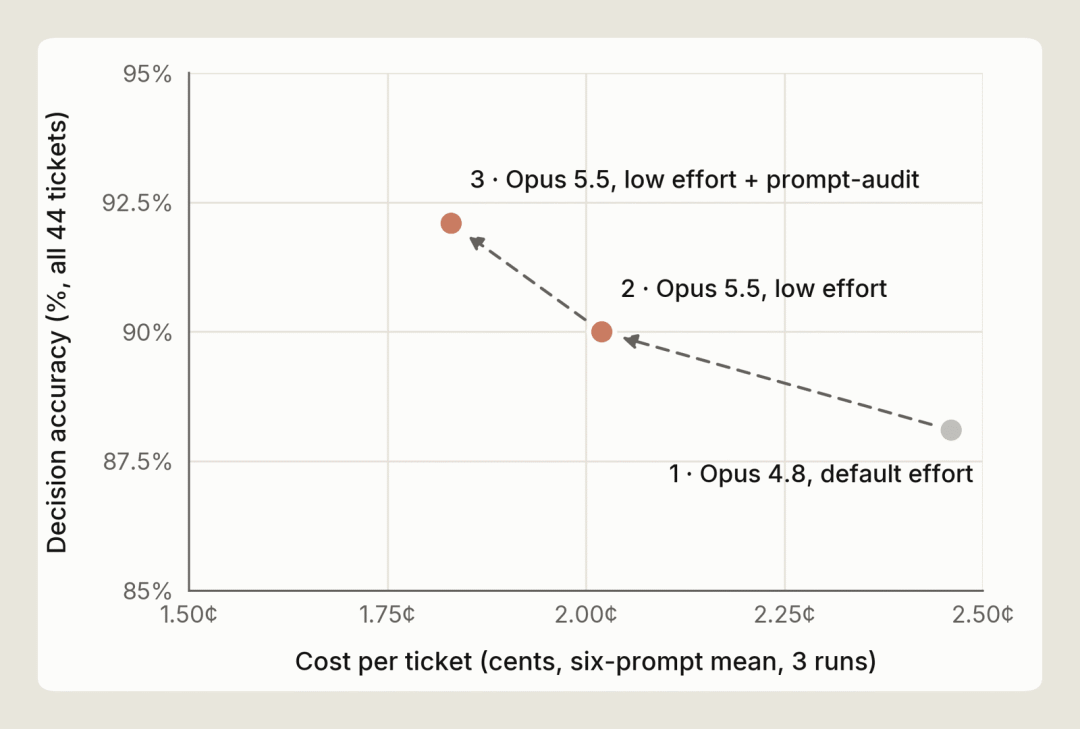
客服评测中的迁移与提示词优化
本文由人人都是产品经理作者【赛博禅心】,微信公众号:【赛博禅心】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于CC0协议


确实,现在很多团队卡在高端模型能力强但成本扛不住,低端模型便宜但做复杂Agent任务掉链子,Opus 5.5刚好补了这个中间档,尤其是它默认档位就能打平甚至超过上一代最高档,不用为了能力硬上高价档,日常开发用真的能省不少预算。