
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
AI 圈又在造神?这次我想给 Jev 泼点冷水


Jev 火了,但它究竟是什么?在作者看来,它就是一个给程序调用的语义判断器:根据上下文对限定答案做概率评估,返回选择、是非或评分。它能力未必强过大模型,切的是分类、判断、评分这类高频小任务,此前业界多用小模型微调,难点在数据整理、标注和维护。
对于 AI 行业一段时间一定会出来一个“不太有用的东西”这件事我们已经见怪不怪了,那么在子弹已经飞了这么久以后,居然还有人在讨论,那么就让我们来看看这东西到底是什么吧!
Jev 是新出的一个模型,在国内外模型卷得一笔的情况下,这东西有什么特点可以吸引到我们的注意力呢?
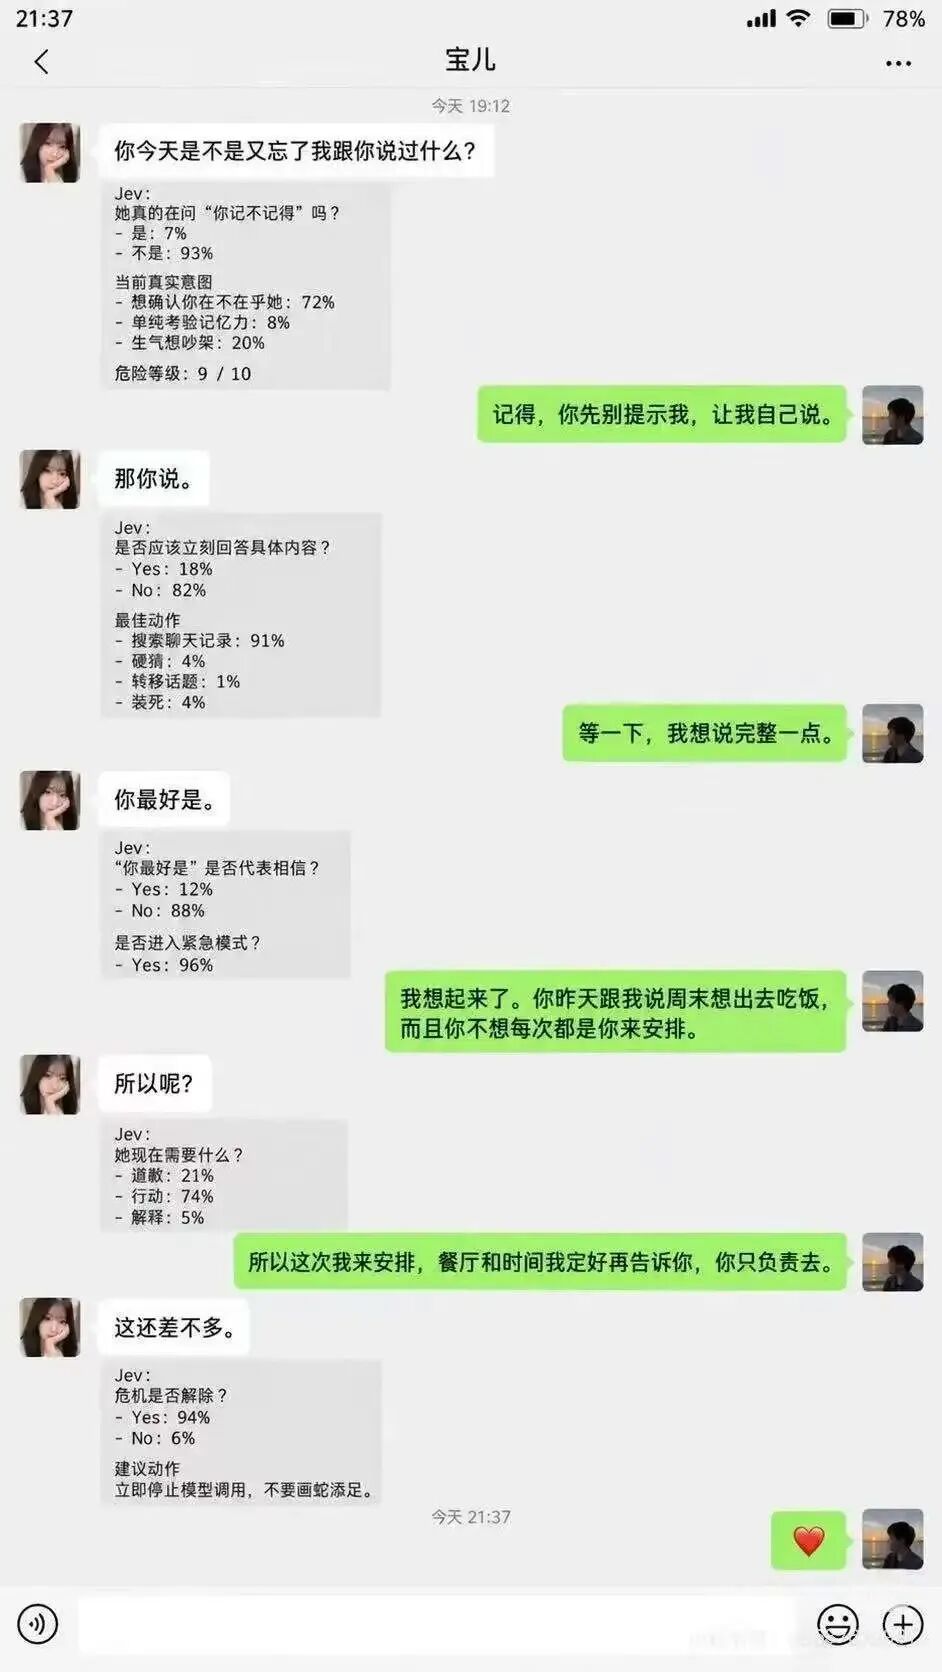
官方给他的定位是 System One Model 系统一,一套凭借“本能”快速决策的系统,与之对应的是系统二,需要经过详细思考决策的系统:
PS:其实从快慢系统的角度来说,Jev 作者的理解应该是错的,这里我们后面会说到
这里用大白话的介绍就是:
Jev 是给程序调用的语义判断器
为解决业务中大量小判断调用通用大模型时成本高、响应慢的问题,它根据上下文对限定答案进行概率评估,返回程序能直接使用的选择、是非或评分,再由业务规则和工作流决定如何执行,再看看如何使用:
# 这里直接走 API 调用即可
{
“model”:”jev-1.13.0″,
“state”:”东西三天了还没到,我不想等了,给我退吧。”,
“questions”: {
“intent”: {
“type”:”choice”,
“instructions”:”判断用户当前的主要诉求。明确要求退款时,不要仅因为提到物流就归为查物流。”,
“criteria”: {
“track_order”:”询问物流进度,没有提出退款要求”,
“refund”:”明确要求退款或取消订单”,
“other”:”其他诉求”,
“unclear”:”信息不足,无法判断主要诉求”
}
}
}
}
其实这里就已经说得比较清楚了,他就是为了解决复杂 AI 项目多次调用产生的东西,他能力未必比大模型好,但追求的就是便宜、效率,而这个确实是有用的,场景切得比较好。
那么在 Jev 之前,我们一般是怎么做的呢?
Token 的成本与效率问题
大家知道 AI 并不便宜!而对于生产级 AI 应用来说,我们不得不面临一个很实际的问题:
一轮 AI 对话,可能会有多次模型调用
比如,一个做售后的 AI 客服,收到用户这样一句话:
东西三天了还没到,我不想等了,给我退吧
用户只说了一句话,后台可能已经有好几个任务在排队:
先判断他是查物流,还是申请退款;再判断有没有明显的不满;查完订单以后,筛选适用的售后知识;生成回复以后,还要检查有没有答非所问、有没有作出不能兑现的承诺。
这些任务全部交给通用大模型做,开发会很方便,但成本和效率就难办了,而且越是要准确就越是需要模型校验,而校验得越多,那么成本也就更高了。
那么在之前我们是怎么办的呢?答案是:小模型微调!
小模型微调的价值在于,去处理特定任务、去完成那些定义明确、边界清晰、对速度和成本极度敏感的任务
比如以下场景:
- 输入输出标准化:输入是短文本(如用户query、一句话、一个搜索词),输出是结构化数据(如分类标签、布尔值、JSON对象);
- 高频率、低延迟要求:每秒可能需要处理成千上万次请求,对响应要求较高的场景;
- 领域特定:任务高度依赖企业自身的业务逻辑和数据;
把复杂问题转译成结构化小任务,用小模型+微调解决成本与时延,他特别适合处理的场景是:标准化/归一化,如意图分类、槽位抽取、脏数据纠正,大家可以感受下面的数据集:
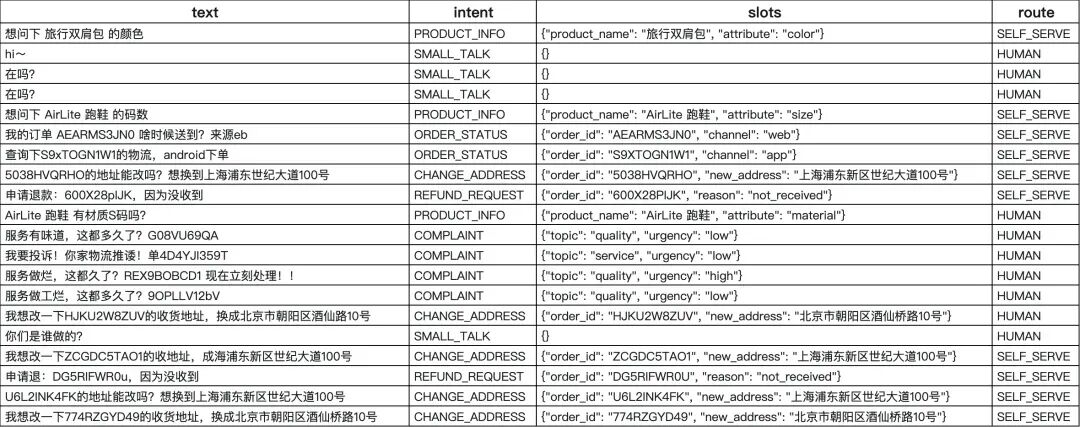
至于效果如何,结论是:这条路线有效。
只不过,小模型运行便宜,背后的数据整理、标注、训练、部署和维护,也都是成本。
Jev 切入的就是其中的分类、判断和评分环节:把业务背景、判断标准和候选答案交给它,就可以直接调用,减少为特定任务训练和维护模型的工作。
所以它值得关注的地方,是把这些反复需要的小判断做成一个现成的服务,至于效果能不能达到业务要求,仍然要拿真实数据来测。
然后在这里我们再来说下原作者所述的系统一和系统二吧!
快系统 or 慢系统
怎么说呢?按照作者的定义,jev 是快系统没问题,但大模型其实也不是系统二,慢系统!
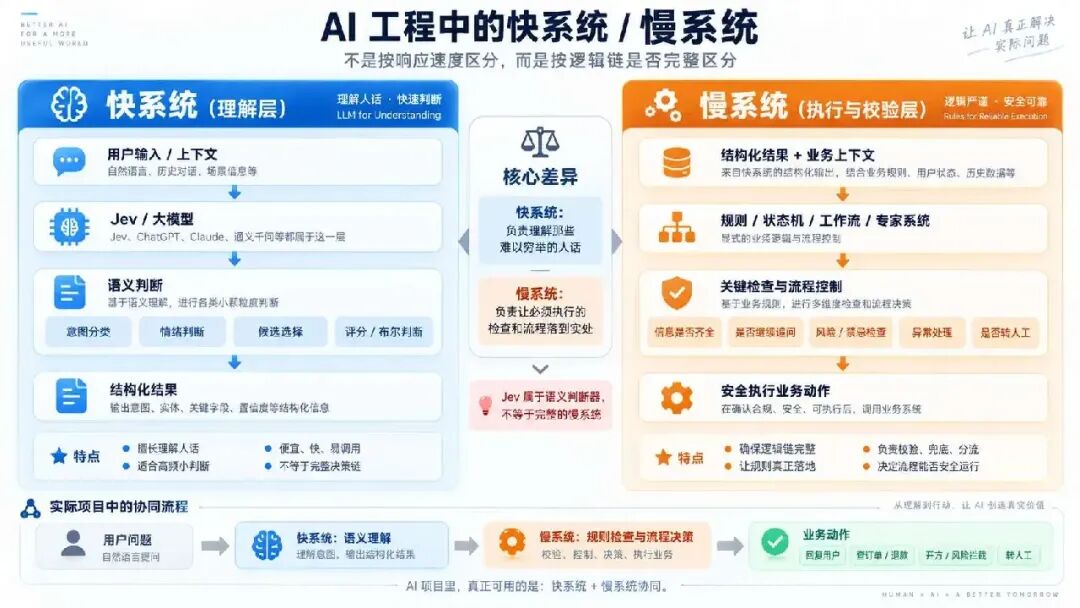
因为模型多想几秒、写出一段更长的推理,并不意味着业务要求就会被逐条执行。在我们做项目时所说的快慢系统里,大模型和 Jev 都依靠模型理解和判断,而慢系统要把具体的检查逻辑明确写出来:
比如之前我们讲过一个医疗案例:患者描述咳嗽、低烧、上楼比平时累,模型判断是上呼吸道感染,后续检查却确诊了肺炎。
这时候,如果要引入系统二(慢系统)就一定会关注关键决策点:哪些信息已经明确,哪些症状还需要追问,当前证据是否足以支持结论。
如果缺少必要信息,就继续收集,或者交给医生进一步评估,不能让一个看起来合理的答案直接结束流程。
这里就需要引入我们之前说的专家系统:把专业知识整理成明确的检查条件,对模型的结果进行校验和兜底
开方场景更容易理解。模型给出一个用药方案以后,系统还要结合患者的年龄、过敏史、正在使用的药物,逐项检查剂量、禁忌和相互作用,总之逻辑是很复杂、很严谨的。
所以在 AI 工程场景是如何理解(快慢)系统的呢:快系统负责理解那些难以穷举的人话,慢系统负责让必须执行的检查和流程落到实处。
这里就是核心差距了,速度快未必是快系统,而是要有完整的逻辑链
这里再说回 Jev,他可以让其中大量的语义判断更快、更便宜,但规则是否完整、信息是否齐全、异常如何处理,仍然需要我们把整套系统设计好。
而大模型并不是我们以为的慢系统,这里要说清楚!
好,接下来我们来说说 Jev 是怎么实现的,然后效果到底怎么样,如果不靠谱的话,再快也不行啊!
实现原理
官方没有公开内部实现,社区有实现思路,解释这类判断服务为什么能做快。
Jev 的快和便宜,其实也是一种能力换时间的方式,让模型换了一种工作方式,比如同样的问题这句话是在申请退款吗?,GPT 是这样工作的:
它会一个字一个字地写出一段话:根、据、这、句、话、的、内、容……
写完之后,程序还要从这段文字里把答案抠出来,所以必须做很多强制限制,如果它写的是看起来像是在申请退款,解析代码可能就直接崩了。
这个过程有点慢、甚至显得模型有点笨,但他就是现在模型工作的方式,没什么好说的,人家 3 年来一直工作得好好的。
Jev 做的事情,是把决策没用的全部删了:
第一步,答案提前定好,模型只负责选
我们是这样使用 Jev 的:
{
“model”:”jev-1.13.0″,
“state”:”东西三天了还没到,我不想等了,给我退吧。”,
“questions”: {
“intent”: {
“type”:”choice”,
“instructions”:”判断用户当前的主要诉求。明确要求退款时,不要仅因为提到物流就归为查物流。”,
“criteria”: {
“track_order”:”询问物流进度,没有提出退款要求”,
“refund”:”明确要求退款或取消订单”,
“other”:”其他诉求”,
“unclear”:”信息不足,无法判断主要诉求”
}
},
“dissatisfied”: {
“type”:”noul”,
“instructions”:”用户是否表达了明显的不满情绪?”
}
}
}
这里的关键:答案的范围在你调用之前就已经圈死了。intent 只能是四个选项之一,dissatisfied 只能是“是”或“否”的概率。
这里就是我们之前做知识库常说的、常用的一套逻辑:用户无穷的表达需要用知识库有限的意图去圈死。
这里对于模型的点是,不需要做填空题了,只需要做选择题。
普通大模型必须逐字生成,第一个字出来才能算第二个字,Jev 不生成文本,所以一次请求里的所有问题可以同时算出来。
官方叫并行采样器,总而言之这是他快的原因……
第二步,模型的概率是可信的
普通模型最大的问题是:它不知道自己不知道。它可能用极其肯定的语气说了一个错误答案,程序拿到的就是看起来对、实际错的结果。
Jev 的训练目标不一样。它采用的训练方法叫 RLCD(面向校准决策的强化学习),核心目标只有一个:当 Jev 说“90% 的概率是申请退款”时,在真实统计中,就真的有大约 90% 的情况确实是申请退款。
他想要尽量去追求这个数字是可信的。拿退款意图识别来说,是真正需要模型学会的,不是“看到退款两个字,就进入退款流程”,而是分清这些表达的区别:
问题:用户是否明确要求现在办理退款?
“不等了,给我退吧。”
→ 明确要求退款
“我不是要退款,就是想问什么时候到。”
→ 没有要求退款
“明天再不到,我就申请退款。”
→ 表达了条件性的退款意向,尚未要求现在办理
至于 Jev 是如何实现当 Jev 说“90% 的概率是申请退款”时,在真实统计中,就真的有大约 90% 的情况确实是申请退款。这块我没有找到答案。
这里可以总结下,Jev 在小场景决策上很厉害的原因,应该是模型训练的结果,当然其中肯定也有很多工程优化。
这里反正是猜想实现,大家感受下就行…
结语
至于 Jev 的实际效果方面,自媒体圈这里是吹得比较厉害的,但我们自己社群的反馈很一般:
- 这个jev有点感人,帮你们试了
- 意图分析太简单,推荐回复有点2,我之前是关键对话给到GPT,其实效果也不太好
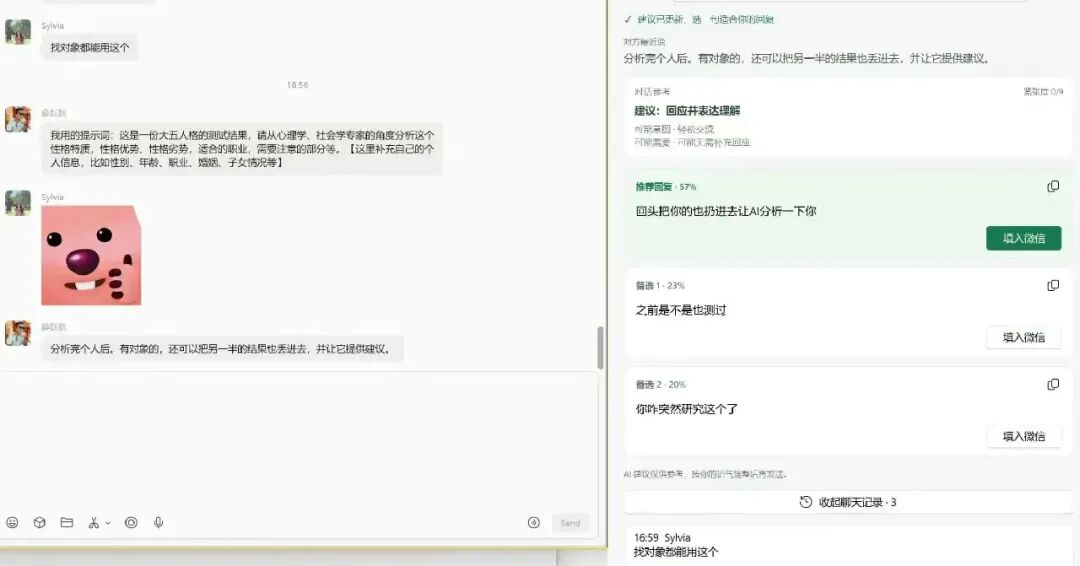
jev = 把传统LLM 的回消息,变成了 直接回几种 制定好的决策,快确实是快,但好却未必好了…
不过,光看群里的反馈也不够,也可以看看论文的测试结果:
| 模型 | 判断准确率 | 平均每份合同费用 | 响应时间中位数 |
|---|---|---|---|
| Jev 1.13.0 | 77.38% | 0.000228 美元 | 1.24 秒 |
| Gemini 3.5 Flash-Lite | 82.54% | 0.001353 美元 | 1.60 秒 |
从这组测试看,Jev 的费用大约只有对照模型的六分之一,但准确率也低了约 5 个百分点,响应时间则没有拉开特别大的差距。
所以,便宜是真的,但这个便宜值不值得,得看判断错了以后要付出什么代价。
到这里,我觉得可以输出结论了:别去关注这玩意,没撒东西,模型下个月估计就支持了,而且 GPT 这些模型可以用来训练学习的数据多太多了…
本文由人人都是产品经理作者【叶小钗】,微信公众号:【叶小钗】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Pixabay,基于 CC0 协议。

- 目前还没评论,等你发挥!