
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
生鲜商城AI接待小助手,从意图识别到满意度(上)


社区生鲜商城自研智能助手,意图识别竟成核心命门。本文从真实咨询数据出发,拆解“AI客服”与“自助路由助手”的本质差异,并完整呈现六步处理链路与三级级联架构,看小团队如何用低成本撬动高转化。
我们是一家做社区生鲜的连锁商城,规模不大,门店服务客群在80到160人这个量级。去年我接了个活儿:在商城里做一个智能助手。领导的原话很朴素——”客服电话接不过来了,能不能搞个AI顶一下”。
就这么一句话,差点把这个项目带沟里去。因为按这个理解,你要做的是一个”AI客服”。而我们做完需求分析后发现,要做的东西和”客服”两个字关系不大。
这篇先讲我们怎么想清楚这件事的,以及最核心的模块——意图识别——是怎么设计的。路由分层和效果数据放下篇。
先看场景,再谈定位
动手之前我把近半年的客服咨询记录拉出来做了一遍归类。不看不知道,生鲜这个品类的咨询结构和普通电商差别很大,有四个特点:
第一,查询型问题占大头。“订单到哪了””什么时候送””能改地址吗”,这类问题占了咨询量的一多半。原因也好理解,生鲜对时效极度敏感,用户下单后的焦虑感比买衣服买电器强得多,恨不得半小时刷一次物流。
第二,商品咨询又散又专业,人工答不齐。“怎么挑西瓜””贝柱怎么保存””A级贝柱和普通B级的差在哪”——问法天马行空,答案还跟着品类、季节、产地变。客服不是买手,十个坐席能答出十个版本。更要命的是这类问题发生在下单前,它不是售后成本,是临门一脚的转化环节:答得专业,用户当场下单;答不上来,用户扭头就去别家了。
第三,优惠券咨询量大,而且人工也常答错。“我有哪些券””满减能叠加吗””活动到几号”。活动规则多个并行、叠加互斥关系复杂,坐席自己都要翻内部文档才能确认。这类问题内部还分化成两种:政策类(规则固定)和个性化类(要查用户账户实时状态),人工处理又慢又容易错。
第四,真客诉占比低,但杀伤力大。比如收到的菜不新鲜、缺斤少两。这类问题对时效要求极高,用户情绪上来之后,每多等一分钟都在发酵。
看完这四种场景,我们做了一个后来被反复验证的关键判断:这个场景需要的不是”AI客服”,而是”自助路由型智能助手”。
区别在哪?AI客服的潜台词是”AI模拟一个客服坐席”,什么问题都接、什么都聊两句。自助路由型助手的逻辑是:能机器办的当场办掉,办不了的准确送到位。它比客服轻,比FAQ重。
后来连命名都跟着这个判断走了。产品不叫”智能客服”,叫”订单助手”。别小看这个名字——一旦叫”客服”,用户预期里就有人工接,期望抬上去了,体验反而崩得快。
一句话定位:面向商城用户的轻量级自助查询加智能路由助手,覆盖订单物流、生鲜常识、知识库检索三类高频低复杂度场景,识别客诉意图自动转人工,目标是把人工接通率打下来四到五成。
意图识别:整个系统的大脑
定位定了,接下来最关键的一环是意图识别。它决定每句话去哪条流水线。
先说清楚意图识别的定位:它是路由层,不是处理层。它自己不回答用户任何问题,只输出一个判断——这句话属于哪个意图大类。我们线上控制在20个意图以内,再多就管不过来了。
为什么它必须放在所有处理层前面?用反例想一下就明白:如果查询层先跑,那句”帮我看看那单能不能改配送时间再退个券”会被物流模块接走,退券的诉求直接丢了;如果客诉模块先跑,一句带情绪的普通查询会被当成投诉转人工,人工量瞬间爆炸。分拣员不上岗,后面所有流水线都在裸奔。
拿一句最难听的话做例子
讲流程之前,先请出我们真实会话里的一句典型输入(做这行,什么话都得接):
“你妈这榴莲坏了cnm,单3792到底几点能送到啊”
这句话同时包含骂人、坏果投诉、订单号、物流追问——四件事搅在一起。它正好能把处理链路的每一层都逼出来。整条链路六步。
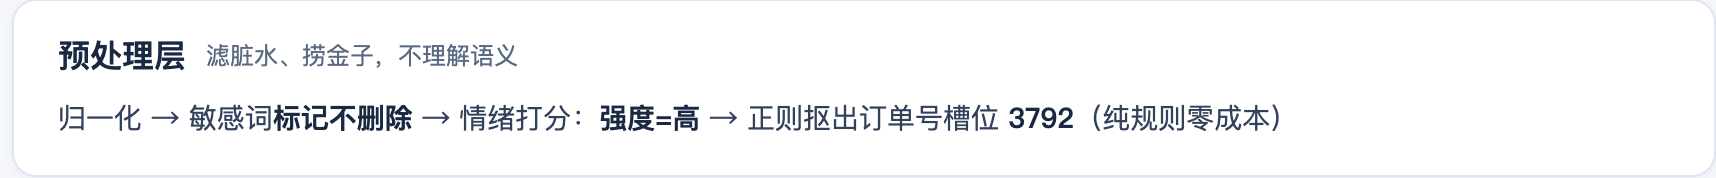
第一步,预处理。
这一层做的是纯机械动作:全半角和大小写归一化;敏感词过滤——”你妈””cnm”替换成占位符或者标记情绪强度,注意不是删掉;情绪打分——检出两个脏话词,情绪强度标记为高,这个标记后面有大用;实体抽取——正则抠出订单号3792,这一步纯规则,不要钱。
出来的是三样东西:干净一点的文本、订单号槽位、情绪标记(高)。
这里有个我们内部吵过一轮的决策点:”去敏感词”和”敏感词拦截”是两回事。前者是修改用户输入,把脏话删掉——后果是情绪强度信号丢了,后面客诉路由、话术降温全靠情绪标记,删了等于断供。后者是原句照传、加标记。一个词之差,背后是”清洗还是拦截”的路线选择。我们的原则是:线上只拦截不修改,目的是安全和成本,不是替模型把话听懂。
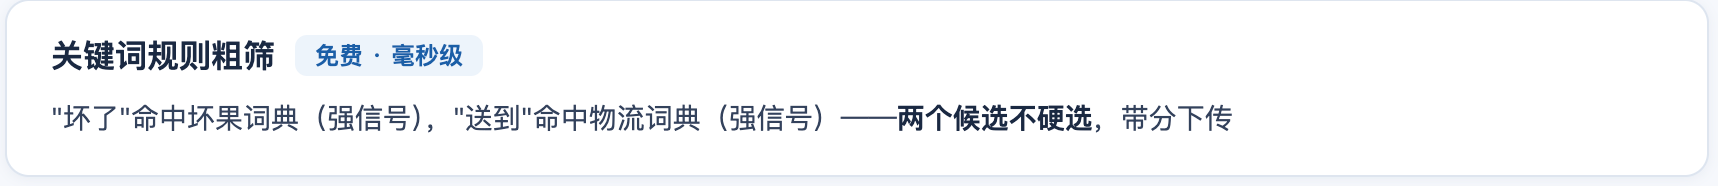
第二步,关键词规则粗筛。
分词后查字典,”坏了”命中坏果词典(强信号),”送到”命中物流词典(强信号)。两个意图都命中了。这一层不硬选,把两个候选带着初步分数往下传。
第三步,向量分类器做主力裁决。
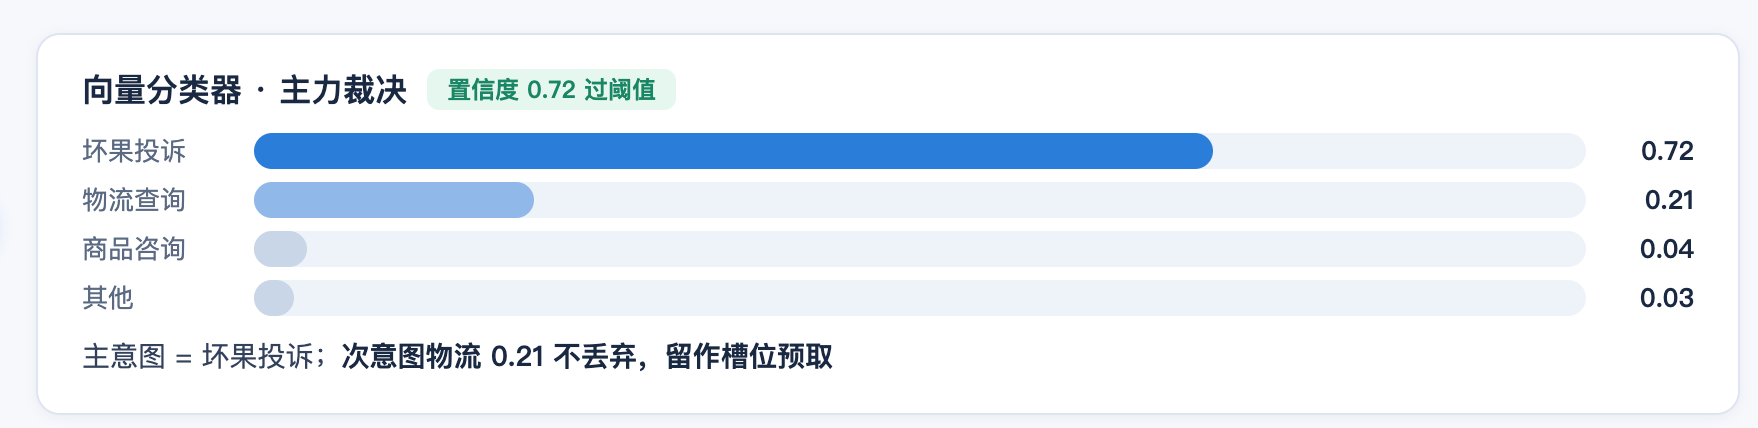
整句转向量,分类器输出一个概率分布:坏果投诉0.72,物流查询0.21,商品咨询0.04,其他0.03。置信度0.72过了阈值,主意图定为坏果投诉。但注意,物流那个0.21没有消失——留作次意图,马上有用。
第四步,查路由映射表。
坏果投诉对应售后流程走多模态识别,叠加情绪高强度,触发人工优先规则。这一步是查配置,零计算。要强调的是:分类器只负责贴标签,这张映射表才决定去向。表是运营可以随时改的配置,不是写死在模型里的东西——这一点后来救过我们好几次命,活动改规则,改表就行,不用动模型。
第五步,按意图取数执行。
主意图是坏果投诉,回复走客诉路径:情绪确认、优先转人工、索要照片喂给多模态初筛。同时顺手把次意图办了——槽位里已经有订单号3792,坐席接入前系统直接查好物流状态推到坐席屏幕上。用户骂着榴莲坏的同时问几点送到,坐席接入的时候两个问题的答案都在屏上。
这个设计我们叫槽位预取:意图裁决出主次之后,能机器办的次意图当场办掉。别小看它,它直接决定了坐席的接话效率——开口就是解决方案,而不是”您好请问有什么可以帮您”。
第六步,异常兜底。
如果第三步置信度只有0.4,两个意图咬得很紧,那就不硬分,降级处理:要么给选项让用户自己点(”您是想投诉坏果还是查物流?”),要么带着情绪标记保守转人工。我们的铁律是:**情绪高的模糊输入,一律从保守。宁可多转一次人工,不能对骂完街的用户再答错一次。**这个道理很朴素——用户已经处于爆发边缘,AI再答错一次,事情就从退款升级成发帖了。
把六步连成一条线看:输入进来,先预处理滤掉脏东西、捞出订单号、打上情绪分;关键词粗筛出两个候选;向量分类器裁决出主次意图;查路由表定去向;执行时槽位预取顺手把次意图办了;置信度不够就兜底降级。
这套流程跑起来之后,日均500到2000条消息里,绝大部分在毫秒到秒级就有了正确去向。
意图识别为什么不能一步到位
有人问过:为什么不直接上大模型识别意图,一步到位?
因为算账。我们的量级,每条消息都过一遍大模型,成本和延迟都扛不住,而且大模型在简单问题上毫无优势——”订单到哪了”这种话,一个关键词字典就能接住,何必动用千亿参数。所以我们用的是三级级联:关键词规则打头,向量分类器做主力,大模型兜底。
第一级是关键词字典。关键细节是词要带权重:”退款”是强信号词,权重2.0;”榴莲”是弱信号词,权重0.8——用户提到榴莲不一定是问售后,可能是问保存方法。加权命中才判意图,避免字面撞车。
第二级是向量分类器,主力。原理一句话:语义相近的句子在向量空间里位置相近——”退款到账没”和”钱什么时候退”落在一起,和”榴莲怎么保存”隔得很远。它接得住关键词接不住的口语化、同义改写,毫秒级返回。
第三级才是大模型,只处理前两级都低置信度的模糊难题,比如”帮我看那单能不能改配送时间再退个券”这种复合意图。贵但准,只用在刀刃上。
三层工具的选择原则就一条:能规则不模型,能小模型不大模型。这条原则贯穿了我们整个系统,下篇讲路由分层时会反复看到它的影子。
意图识别为什么不能一步到位
有人问过:为什么不直接上大模型识别意图,一步到位?
因为算账。我们的量级,每条消息都过一遍大模型,成本和延迟都扛不住,而且大模型在简单问题上毫无优势——”订单到哪了”这种话,一个关键词字典就能接住,何必动用千亿参数。所以我们用的是三级级联:关键词规则打头,向量分类器做主力,大模型兜底。
第一级是关键词字典。关键细节是词要带权重:”退款”是强信号词,权重2.0;”榴莲”是弱信号词,权重0.8——用户提到榴莲不一定是问售后,可能是问保存方法。加权命中才判意图,避免字面撞车。
第二级是向量分类器,主力。原理一句话:语义相近的句子在向量空间里位置相近——”退款到账没”和”钱什么时候退”落在一起,和”榴莲怎么保存”隔得很远。它接得住关键词接不住的口语化、同义改写,毫秒级返回。
第三级才是大模型,带意图清单和few-shot例子,只处理前两级都低置信度的模糊难题,比如”帮我看那单能不能改配送时间再退个券”这种复合意图。贵但准,只用在刀刃上。
三层工具的选择原则就一条:**能规则不模型,能小模型不大模型。**这条原则贯穿了我们整个系统,下篇讲路由分层时会反复看到它的影子。
这一级半怎么训练出来的
向量分类器不是天上掉下来的,得喂训练数据。完整链条五步:捞原始对话、人工贴标签、转向量、训练画边界、上线判新问题。
我们从客服系统导出3到6个月的历史对话,比如捞到一句”我买的榴莲怎么还没送到”,标注员贴上【物流查询】的标签。每个意图贴够200到500条,这批”句子+标签”就是训练集。
然后每句话用embedding模型转成向量,相当于钉进一张巨大的语义地图:”榴莲怎么还没送到”和”我的菜呢,到哪了”钉在一起,”榴莲怎么保存”钉在很远的地方。这一步之后,”话”就变成了”坐标”。
训练分类器,本质是在地图上画线:物流查询区里聚着”还没送到””我的菜呢””咋还没消息”,商品咨询区里聚着”怎么保存””产地哪里”。训练完成的标志是每个意图在向量空间里有了自己的领地。上线后新问题转向量、落地图,落在哪块领地就是哪个意图。
落点离边界的远近,就是置信度:落在领地中心,置信度0.95;落在两块领地交界处,置信度0.5,触发降级交给大模型重判或转人工。
所以标注的数量和质量直接决定边界画得准不准——样本少的意图,领地小而模糊;样本多的意图,领地清晰。这也是为什么每个意图要200到500条起步,不够的点,画不出清晰的线。
理解了这一点,后面所有的调优都有了抓手:bad case多在哪类意图,就说明哪块领地画歪了,要么补标注,要么调边界。
上篇小结
到这里,上半场讲完了三件事:
- 先看数据再定定位——四类咨询的结构决定了我们要做的是”自助路由型智能助手”,不是”AI客服”
- 意图识别是路由层不是处理层,六步流程里藏着两个关键设计:情绪标记贯穿全链路、槽位预取顺手办事
- 三级级联加向量地图,让意图识别在成本和准确率之间找到了平衡
但意图识别只是分拣员。分拣完了,每条流水线上发生了什么?FAQ为什么能毫秒级秒回?”双路召回”是什么?客诉的等待窗口里藏着哪四个动作?最后那些”人工解决率从100%降到20%”的数据是怎么来的?
这些放下篇,也是整个系统里更有意思的部分。
本文由 @Totoro畅 原创发布于人人都是产品经理,未经许可,禁止转载
题图来自 Unsplash,基于 CC0 协议



- 目前还没评论,等你发挥!