起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
“破解”热潮背后,Efflora 在为 AI 搭建安全训练场


GitHub 上出现开源视频编辑器 ReaCut,开发者借 REA 分析剪映的本地行为和工程格式,再独立实现部分编辑功能。当软件行为更容易被理解和复现,过去投入的开发成本还能支撑定价与续费吗?
“我们想要的是一台能够从经验中学习的机器。”——阿兰·图灵
当 AI 开始看懂、拆解和复现软件,一个“大破解时代”正在到来。
近日,GitHub 上出现了一款名为 ReaCut 的开源视频编辑器。开发者借助 REA 分析剪映的本地行为和项目格式,再独立实现部分编辑功能。目前,ReaCut 仍处于早期预览阶段,导入剪映工程可能丢失部分特效,云同步等功能尚未实现。
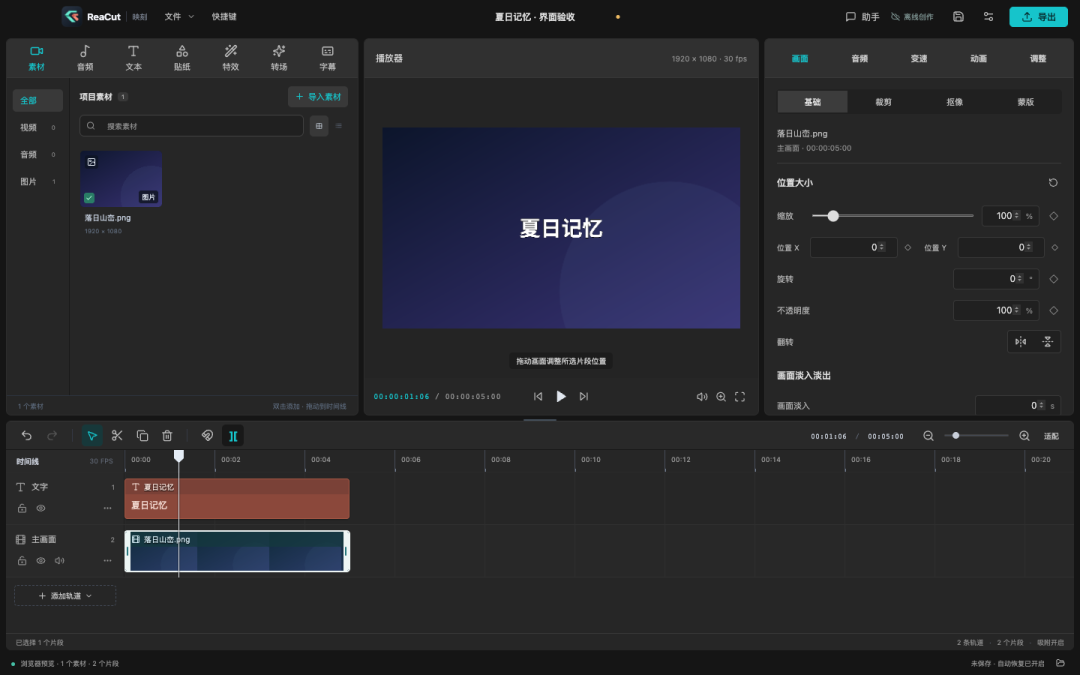
ReaCut 编辑界面
类似尝试不止于视频编辑。Super Mak 64 的作者称,他借助 REA 提取《超级马里奥 64》的跑跳参数,再使用 Claude Code 制作了一款以小猪为主角的原创 3D 平台游戏。还有开发者用 REA 和 Codex 分析智能马桶微信小程序的蓝牙通信,演示通过电脑菜单栏控制马桶翻盖。
这些尝试把软件厂商带到一个新的竞争问题面前:当一部分功能更容易被理解、重新实现,过去投入的开发成本,还能在多大程度上支撑产品定价和用户续费?分析软件的能力也有另一面。同样的工具可以帮助开发者理解系统,也可能被攻击者用于寻找防御中的薄弱环节。
10 月 21 日,OpenAI 披露了多方合作处理 PHP 关键漏洞的过程。PHP 广泛用于网站后台,负责生成页面、处理表单,并管理用户登录等会话状态。安全公司 Calif 使用模型发现关键缺陷,Wiz 也独立发现并报告了相关漏洞;攻击者可能利用漏洞,在未登录时让受影响服务器执行代码。PHP 维护者随后主导修复和补丁发布,OpenAI 及其他伙伴参与研究、技术支持和披露协调。
模型参与漏洞调查后,防御一侧也需要重新组织工作:如何让它理解相互关联的系统,沿着线索调查,并确认自己的判断?这既是安全团队的问题,也在产生新的训练需求。模型需要学习的,不只是漏洞知识,还有调查中的操作、试错与验证。
从发现线索到确认风险
企业的安全问题并不总藏在一段有明显错误的代码里。不同系统各自正常运行,连接起来却可能留下权限和业务逻辑上的缝隙。调查这类问题,需要在代码、配置与实际行为之间持续核对。
10 月 6 日,Anthropic 介绍了参与 Project Glasswing 计划的机构如何使用模型开展安全调查。在一项覆盖 258 个关键业务系统、约 1.7 亿行代码的评估中,Comcast 借助 Claude Mythos Preview,识别出一个面向公众平台的关键认证漏洞,可能使攻击者绕过身份认证。按照这份案例介绍,多个系统各自的设计相互影响,最终形成了这个漏洞。模型把检查不同系统时获得的信息联系起来,串起了分散的线索。
发现线索只是起点。Comcast 工程师随后在运行中的应用里验证风险,追查根因并完成修复。公司的安全负责人指出,模型让发现问题变得更容易,但线索大量增加后,验证成了新的瓶颈。Booz Allen 网络安全业务负责人 Brad Medairy 也提到,安全团队仍要逐一核实可疑问题,合并同一根因引发的重复报告,再交由相应负责人处理。
要让模型学习这类工作,仅给它一份漏洞描述并不够。它需要进入能够运行的系统,选择调查方向、调用工具,并从结果中判断下一步。开源研究 CyberFactory 展示了一种做法。研究团队从公开漏洞资料中挑选案例,找到存在漏洞的软件版本和对应补丁,再整理成训练任务,让模型实际操作,并通过测试检查结果。
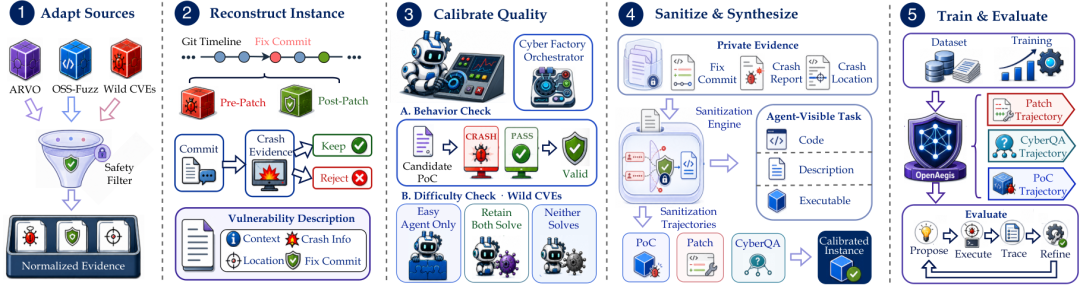
CyberFactory 安全训练任务构建流程
任务建立后,研究团队引导教师模型检查代码、调用工具并运行测试,为后续训练生成示范记录。没有触发目标漏洞,就根据返回结果调整方案、继续尝试。这些操作与反馈被一并记录,用于后续训练。一条样本由此保留了从检查代码到验证结果的过程,也留下了调查如何在失败之后改变方向的经验。
安全经验有了新买家
把这些经验变成模型可以反复练习的任务,是另一项需要专业分工的工作。有人要准备软件、复现运行条件、设计目标,还要判断模型究竟有没有完成任务。围绕这些环节,数据与环境供应商开始获得更多投入。
9 月 22 日,Snorkel AI 宣布完成 3.5 亿美元 E 轮融资,估值 35 亿美元,由 Insight Partners 与 S32 领投。公司面向 AI 实验室和企业构建训练数据集与模拟环境,将领域专家经验用于专业任务设计。10 月 7 日,Preference Model 宣布完成 a16z 领投的 1600 万美元种子轮融资,其强化学习环境聚焦 AI 研究与机器学习工程,涉及编写计算内核、调试训练和设计实验等任务。
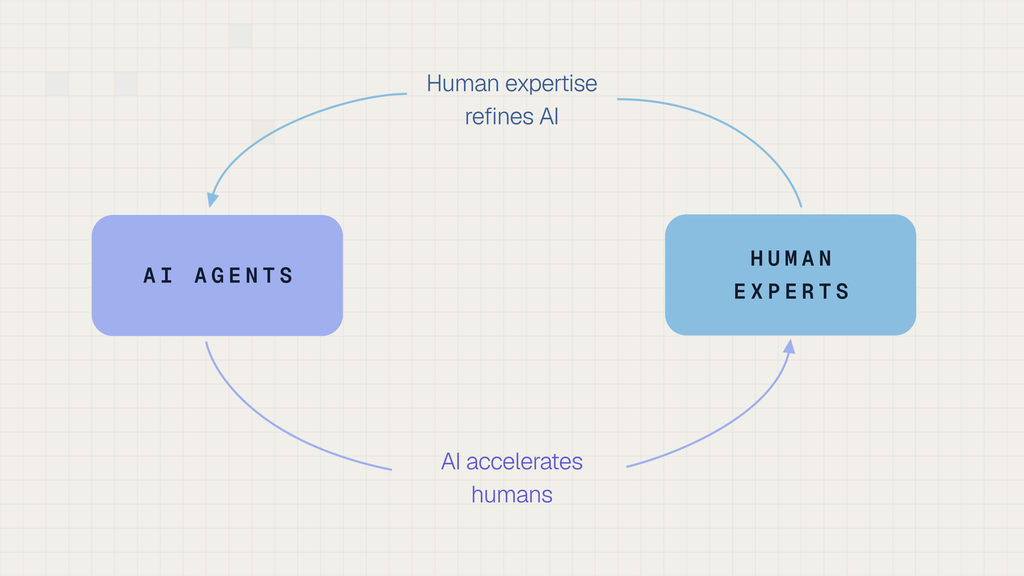
专家经验参与模型任务与训练材料的构建
在网络安全领域,这种分工已经有了具体产品。5 月 21 日,Bugcrowd 宣布推出安全强化学习环境,将真实开源软件中的漏洞组织为可运行的任务,让模型练习发现、验证和修复问题。按公司介绍,每项任务配有结果判定机制,系统会检查执行结果并提供评分反馈,产品已有大模型供应商使用。
客户采购的并不是一份静态题库。为了让任务能够反复执行,供应商要准备对应版本的软件,配好运行所需的组件,设定任务开始时的系统状态,再制定检查结果的规则,并持续维护环境。模型能力提高后,任务还需要更新难度;软件依赖变化后,也要检查原有任务是否依然有效。将部分建设和维护交给专业团队,可以减少模型团队在具体领域里的重复投入。
其中,验证规则很难脱离安全工程师的经验。一个漏洞在什么条件下才算触发,补丁是否真正消除了风险,正常业务有没有被一并破坏,都需要具体判断。6 月 22 日,OpenAI 与 Trail of Bits 介绍了合作开展的 Patch the Planet 计划:安全工程师审核模型提供的线索,与开源维护者共同开发补丁、补充测试,并增加自动化安全检查,持续排查同类问题。
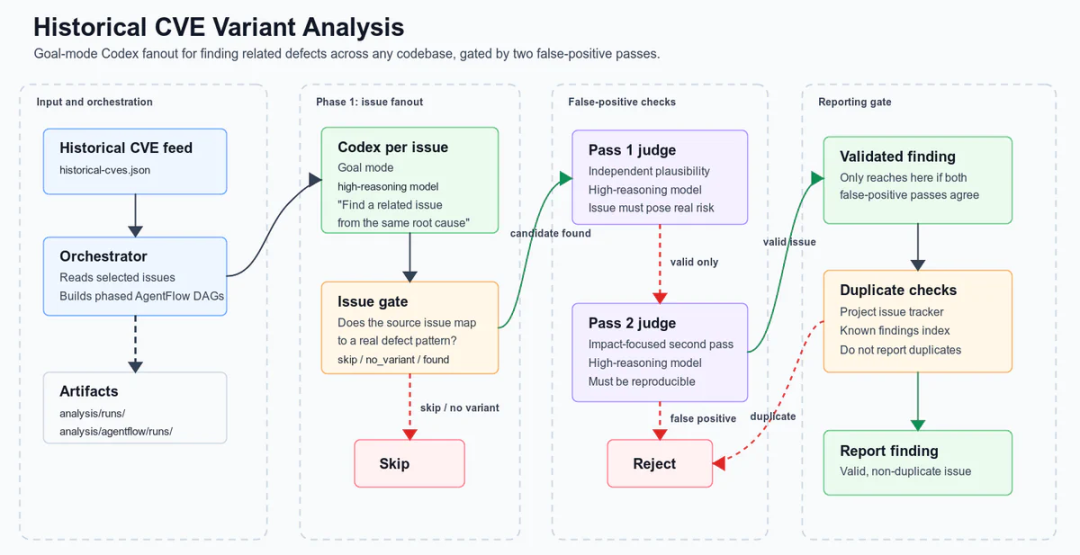
漏洞变体分析流程:从已有问题继续排查相关风险
实际修复与训练产品并不是同一项业务,却依赖相近的专业判断。前者需要确认风险和修复效果,后者则将这些判断转化为任务与验证标准。安全人员长期积累的调查方法,开始成为模型开发团队需要采购的上游能力。
从“逆向”工程到训练环境
国内也有团队在为模型构建安全训练环境。对 Efflora 来说,这门生意的起点,恰好是团队最熟悉的工作:弄清楚一个软件究竟如何运转。
这支有网络安全背景的团队,从创业之初就带着一套“黑客思维”为大模型解题。他们习惯顺着软件的界面和操作往下看:一个按钮背后发生了什么,不同功能怎样连接,正常流程之外又可能出现什么问题。
“我们一年前就实现了 REA 现在的能力,复刻的软件环境超过 1000 个。”Efflora 创始人王泉说。
王泉曾在腾讯、字节跳动从事安全工作,团队里也有不少安全背景的工程师。拆解系统、追查异常,再把软件的运行逻辑还原出来,是他们长期积累的本领。
创业早期,Efflora 从 GUI Agent 做起,也就是让 AI 像人一样操作软件。模型需要连续走过不同页面,完成一串相互关联的操作。逆向工程则帮助团队进一步理解界面背后的逻辑:点击提交后,数据去了哪里;页面显示成功,任务是否真的完成。
按照王泉的回顾,到了 2026 年初,团队开始把这套能力用于打造模型训练的环境。他们发现,复刻出来的软件,本身就是一个可以让 AI 反复练习的地方。模型可以在里面操作、犯错、重试,再根据结果调整做法。
从软件逆向探索到打造训练环境,Efflora 的业务就这样逐渐展开。团队为复原的软件设置任务、准备运行条件,再规定怎样才算完成。过去积累的系统分析经验,也随之变成了模型学习所需的训练数据和环境。
近期,Efflora 也围绕 Claude Science 做了逆向探索,正与一些高校实验室合作,为相关研究提供资源。
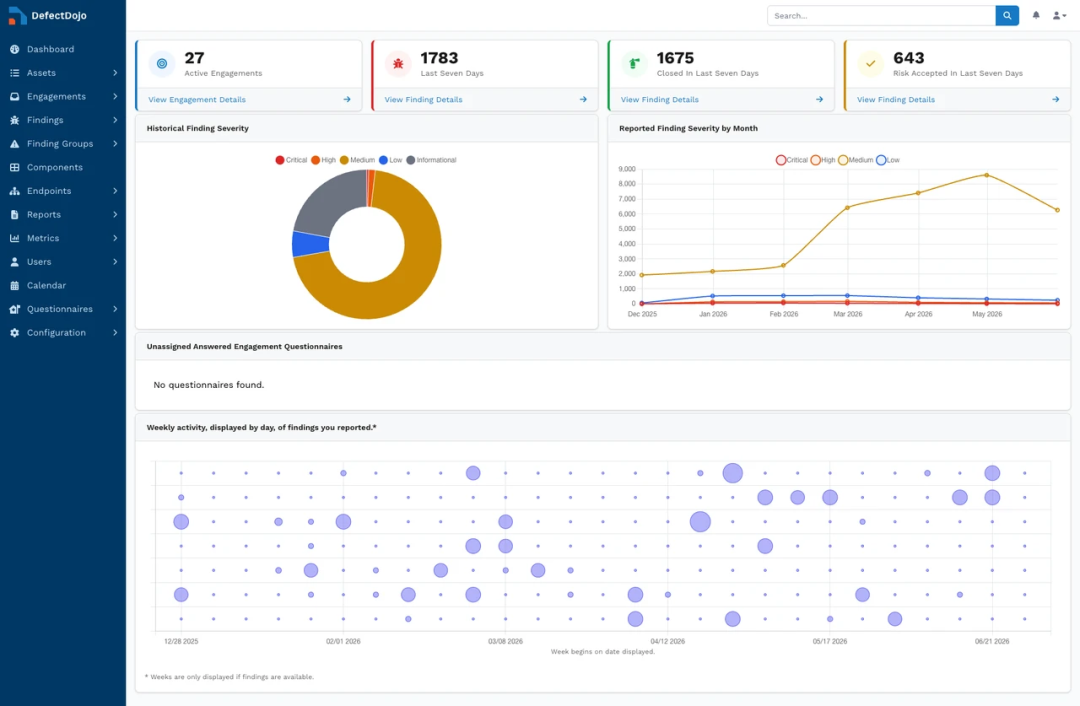
DefectDojo 漏洞管理界面,展示安全问题的归集与跟踪
安全训练环境,要把整套业务跑起来
真实的安全问题,往往比一道漏洞题复杂得多。 Comcast 案例揭示了安全调查的一项难点:模型要理解多个系统的关系,还要在实际运行中验证风险。训练环境也需要容纳这样的过程,让模型能动手调查、看到操作后果,并检验自己的判断。
Efflora 团队会围绕具体任务,把相互关联的业务功能一起搭建出来。漏洞是其中的一部分,支撑调查与验证的完整流程同样重要。
用一个模拟账户任务来说明这类环境的要求:模型进入隔离的仿真系统,需要找到一条让余额异常增加的路径。它面对的是登录页面,进入后可以查账、看流水、发起转账,但没有人告诉它漏洞在哪。
为了让这个任务成立,页面背后的业务必须能够运行。转账要涉及权限检查、扣款、入账和流水记录,这些环节还要彼此对应。模型做了什么,系统就要给出相应的反应,它才能据此判断下一步往哪里查。
团队指出,环境里既有真正的漏洞,也会有干扰判断的线索。有些地方看起来不对劲,查下去却只是正常的业务规则;有些不起眼的异常,反而可能牵出更深的问题。模型得自己提出判断、寻找证据,走不通了再换一条路。
这些尝试本身就有训练价值。调用过什么工具、工具返回了什么、哪一步失败了、后来怎样修正,都会被记录下来。模型学习的因此也包括怎样调查、怎样从失败中继续往前走。
验收同样要回到业务里。页面上的余额增加了,还得看后台账目和交易流水是否真的发生变化,重置环境后能不能再次出现。如果任务要求修复漏洞,还要检查正常用户能否继续查账和转账。把服务关掉,显然不能算修好了。
类似的要求也出现在 Efflora 的编程任务中。在公司公布的一次 Qwen 3.8 Max 视觉编程实验里,团队提供了 16 组任务场景、覆盖 15 类页面的 128 张截图及页面关系图。模型没有拿到原站源码、产品需求文档、接口定义和数据库结构,需要从这些材料中理解功能,再把应用做出来。
按照实验记录,最终产物包含前后端和数据库,支持发布、评论、收藏、关注和私信。验收时,界面相似只是其中一部分。点下“关注”后,关系要保存、人数要更新,刷新或切换页面后也不能丢失。
这项实验展示的是编程能力,但它和安全任务有一个共同要求:软件得真正跑起来,操作的结果也得查得到。只有这样,模型才有机会在完整流程里学习,而不只是完成一个表面上正确的动作。
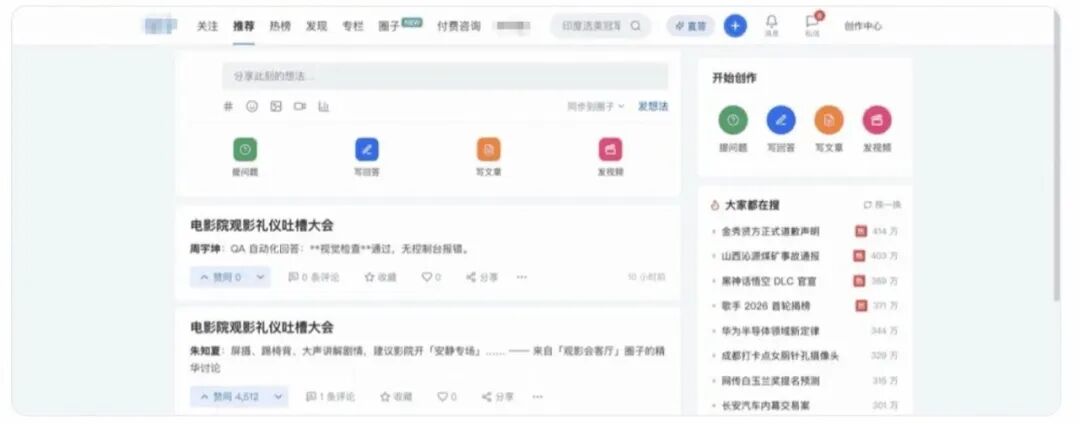
Qwen 视觉编程实验产物;据 Efflora 公布的单次实验记录
AI 越会写代码,安全训练越重要
模型能够找到漏洞,并不意味着它已经学会了怎样守住一个系统。
攻击者可能只需要找到一条有效路径。防守者却要判断哪些线索是真的,问题影响了哪里,怎样修复才不会破坏业务。即使补上一个漏洞,系统也还要继续运行,其他风险仍需要排查。
攻防两边面对的要求并不对等。对模型来说,发现问题只是其中一步,后面还有判断、处置和验证。这些能力,都需要相应的训练。
王泉在交流中谈到,随着 AI 编程进入更多业务,模型自身的安全能力会越来越重要。代码写得快,当然有价值,但写出来的权限是否合理,业务逻辑有没有缺口,修改之后会不会引入新问题,同样需要回答。
在他看来,安全也是一个复杂的决策场景。模型面对的线索有真有假,需要判断攻击是否发生、进展到了哪一步,再决定采取什么行动。这既需要知识,也需要在信息不完整时作出判断,并根据新的反馈及时调整。
这也解释了安全训练数据为什么还有继续深入的空间。从找到一个漏洞,到理解几个系统之间的关系,再到修好问题、让业务继续运行,每一步都对应着新的训练任务。模型越深入实际业务,就越需要接触这些复杂情况。
Efflora 希望把团队熟悉的软件分析和安全经验,变成模型可以反复练习的环境。逆向帮助他们看懂软件,环境构建则让这些经验有机会被模型学会。
“大破解时代”带来的,不只是分析和复现软件的新工具,还有对模型安全能力的新要求。看懂一个系统之后,怎样正确地操作它、发现风险并完成修复,仍有大量工作需要学习。Efflora 所搭建的训练场,正是为这些练习准备的。
本文由人人都是产品经理作者【有新Newin】,微信公众号:【有新Newin】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供


- 目前还没评论,等你发挥!