起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
这个模型一个字都不会写,0.7秒做完了777次判断


参与发明ChatGPT的DiogoAlmeida隐身两年后发布模型Jev,官方称速度快二十到两百倍、成本低四十到四百倍,输出token免费,却有一个反常限制:它一个字都写不出来。文章拆解这条路线。
9月16日凌晨,Diogo Almeida 在 X 上发了一条推文,到我们写稿时浏览量约967万。
他的开场白很硬。参与发明 ChatGPT 之后,他一直在问自己一个问题,为什么聊天能力已经超过人类的模型,没有带来通用人工智能。
他给的答案不是模型还不够强。他认为方向从一开始就偏了。
隐身两年之后,他和 TypeSafe AI 发布了一个叫 Jev 的模型。官方说法是快20到200倍,便宜40到400倍,输出 token 免费。
而这个模型有一个很反常的限制。它一个字都写不出来。
01 先说清楚它不能做什么
Jev 被归到一个新类别下面,公司管它叫 System One 模型。这个名字来自心理学里的系统一,指的是快速、直觉式的判断,对应的系统二是缓慢的推理。
按官方博客的描述,Jev 不能生成字符串,不能写解释,不能推理。
它能做的是另一件事。输入是非结构化的内容加上结构化的程序状态,输出是预先定义好类型的结构化值,每个值带一个校准过的概率和置信度。可选的输出和结构必须提前定义,支持的选项基数最多到255。
官方给的比喻是,把 Jev 当成一次前沿智能的函数调用。非结构化的状态进去,带概率的类型化决策出来。
用日常的话讲,你不能让它写一段话,但你可以问它这段文字里有没有出现某个问题,它会回答有或者没有,同时告诉你它有多确定。
02 一个 RLHF 作者对 RLHF 的指控
这件事最有意思的部分不在模型,在他的论证。
Diogo Almeida 此前在 OpenAI 和谷歌大脑工作,据公开资料,他参与了 InstructGPT、RLHF、ChatGPT 和 GPT-4 的工作,2024年离开 OpenAI。RLHF 的中文一般译作基于人类反馈的强化学习,是让大模型变得好用的关键方法。
现在他说问题就出在这里。
他的几句原话值得完整放在这儿。今天的 AI 是为辅助而设计的,方式是优化人类偏好。为什么所有大模型都需要一个人在回路里,简单的答案是,我们真的把人放进了回路里。
接着是最狠的一句。过度承诺是一个特性,这是设计出来的。按构造,每一个 RLHF 模型都会在人类偏好和实际结果之间留下很大的差距,哪怕结果本身不错。
然后他补了一句结论。无论模型错得多离谱,它们看起来都会是对的。
03 为什么优化人类偏好会挡住自动化
上面那段话如果展开,逻辑是这样的。
RLHF 的训练目标是让人类评分者更喜欢模型的回答。一个人在什么情况下会更喜欢一个回答,通常是它读起来流畅、自信、有条理、把话说完整。
这套偏好里没有一项是准确。
于是模型学到的是怎么让人满意,而让人满意和把事做对是两个不同的目标,大部分时候它们方向一致,但在模型不确定的时候,两者会分开。一个诚实的回答应该是我不太确定,而一个能拿高分的回答是一段流畅的、听起来很确定的话。
后果落在自动化上。如果你要把一个决定交给软件自动执行,你需要知道这个决定有多可靠。模型给你一段自信的文字,你没法从中读出它的把握有多大,所以你只能再找个人来看一眼。
他的说法是,真正想要自动化的话,你需要它别管人类怎么想,只是用校准过的方式把任务做对。
这里要解释一下校准这个词,因为整套论证都压在它上面。
一个概率是校准的,意思是它说七成把握的那些判断里,大约真有七成是对的。说九成把握的那批,大约九成是对的。它不要求每次都猜对,只要求它报出来的把握和实际的正确率对得上。
这个性质对自动化极其重要。如果概率是校准的,你就可以画一条线,比如把握在95%以上的自动执行,剩下的转人工。被转走的那部分是可预期的,整个系统的错误率也是可预期的。
大模型给不了这个。它输出的是一段文字,你可以让它自评一个分数,但那个分数同样是被人类偏好训练出来的,倾向于给自己打高分。把握和正确率之间没有稳定的对应关系,那条线就画不下去。
Jev 的训练方法因此叫做面向校准决策的强化学习,缩写 RLCD。优化目标从人类偏好换成了带诚实概率的决策。
需要说明的是,官方博客里把为什么需要一个新训练算法列成了一个问题,但没有展开技术细节。这一层目前是黑箱。
04 把串行换成并行
除了训练目标,架构上也换了一件事。
大模型生成文字是串行的,一个 token 接一个 token,后一个依赖前一个。Jev 的做法是并行采样,一次查询里把所有输出一起生成。
Almeida 自己给了一个类比,用并行计算替换串行计算,正是当年 Transformer 超越循环神经网络的同一个动作。
速度上的差别,按官方数字,端到端响应时间在70毫秒到500毫秒之间,而前沿大模型在同类任务上是3秒到329秒。官网首页挂的数字是快193.6倍、便宜444.6倍,博客自己注明这是真实收益的高端。
05 价格低到公司说不想计量
定价是这次公布里最扎眼的部分。
Jev 的输入价格是每百万 token 0.042美元,换算成每十亿 token 是42美元。输出 token 免费,公司的说法是永远免费,因为在新架构下它们便宜到不值得计量。
作为参照,官方给出的大模型输入价格区间是每百万 token 0.2美元到10美元,输出通常约为输入的5倍。
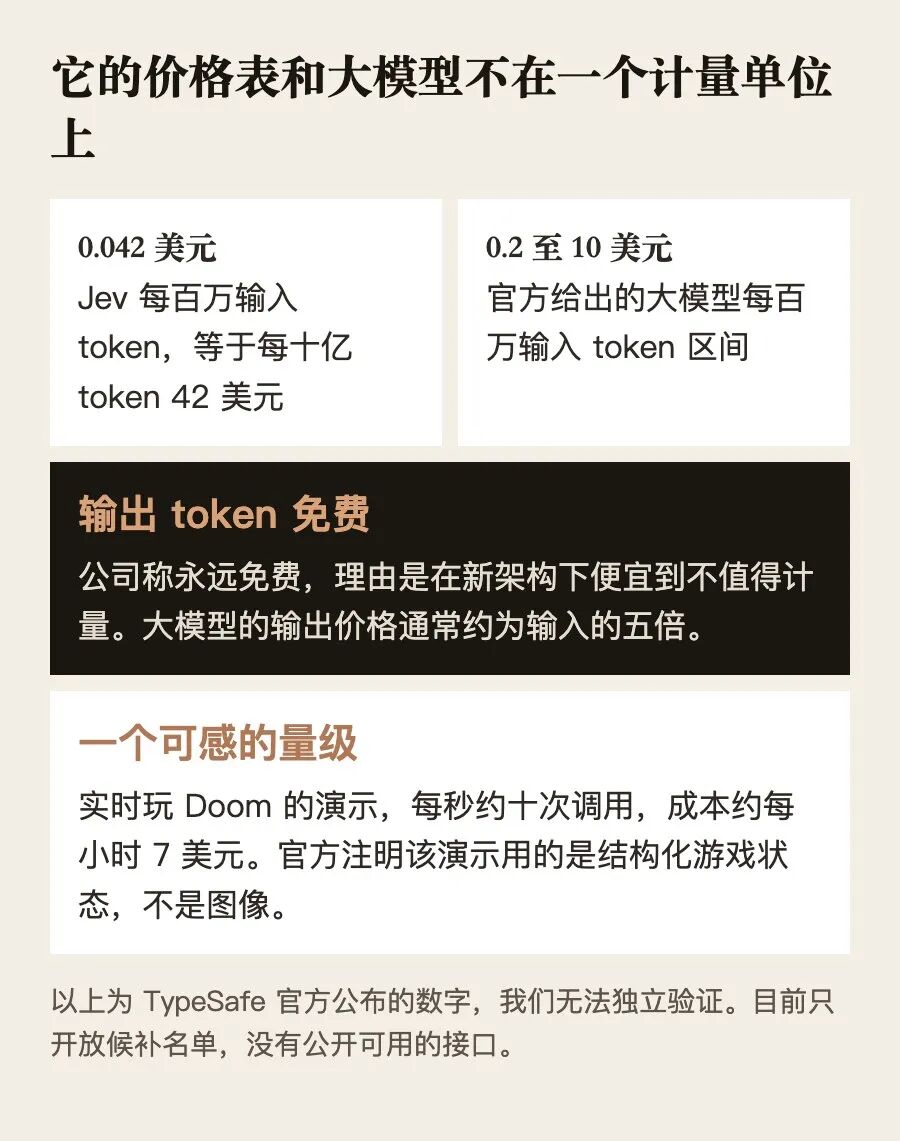
Jev 与大模型的计价方式对照。以上为 TypeSafe 官方公布的数字,我们无法独立验证
有一个演示可以感受这个量级。他们让模型实时玩 Doom,每秒约10次调用,成本约每小时7美元。需要注意官方注明了这个演示用的是结构化的游戏状态数据,不是图像。
06 一次独立测试,给出了更有用的数字
官方还公布了一张准确率与成本的对照图,它比任何倍数都更能说明问题。图上 Jev 那个点在最左边,成本比所有对手低一到三个数量级,但它的准确率并不是最高的,比图中最准的那个模型低几个百分点。这张图要看的是形状,不是某一个点的精确读数。
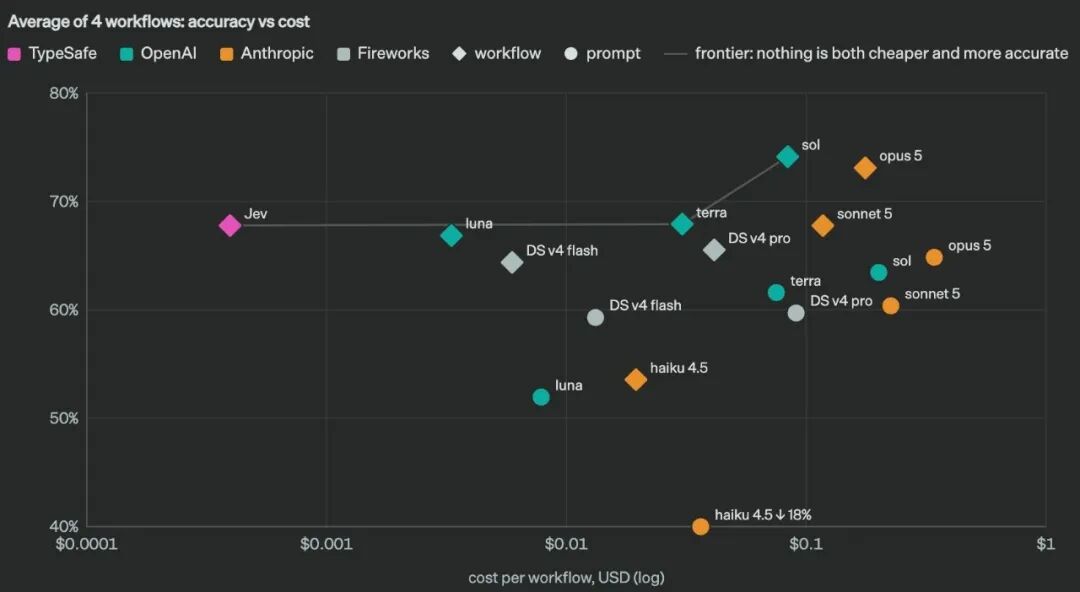
TypeSafe 官方发布的四个工作流平均准确率与成本对照图。横轴为对数刻度的每工作流成本,灰线标出的是当前最优边界,含义是没有任何模型同时更便宜且更准。Jev 为最左侧的品红色菱形。图片来自官方发布材料
官方数字之外,已经有第三方做了实测。
Every 的 Mike Taylor 做了11组实验,覆盖找上下文、检查工作和做决定三类任务。他把自己写的27篇文章加上10篇由 AI 写的文章,一共37份文档扔进去,同时问21个关于常见 AI 写作特征的问题。
结果是777次判断在0.7秒内完成,花费约四分之一美分。他全部实验加起来1709次判断,总成本不到一美分。
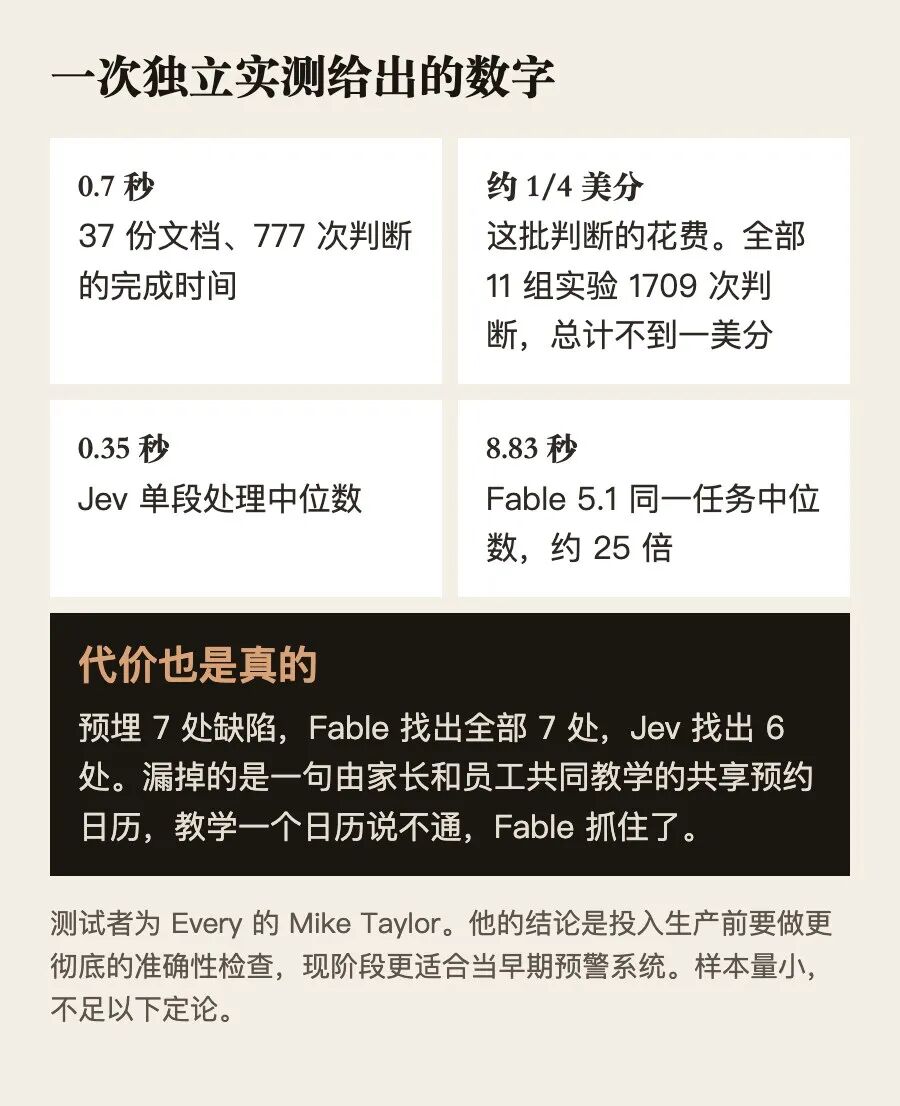
Mike Taylor 独立实测的关键数字。Sense AI 整理自其公开实验记录
更有价值的是他和 Fable 5.1 的对比。单段处理时间,Jev 的中位数是0.35秒,Fable 是8.83秒,约25倍差距。成本上 Jev 约便宜580倍。
然后是那个不该被跳过的数字。他预先埋了7处缺陷,Fable 找出了全部7处,Jev 找出6处。
他还给了漏掉的那一处是什么。有一段文字提到一个由家长和员工共同教学的共享预约日历。教学一个日历是什么意思,Fable 抓住了这个说不通的地方,Jev 没有。
他自己的结论是,投入生产之前,他想做一次更彻底的准确性检查,而现在这个东西最适合当作一个早期预警系统。
这组数字比官方的倍数更有信息量。它说的是,便宜和快是真的,代价也是真的。
580倍这个量级值得单独想一下。它不是让一件已经在做的事变便宜,它是让一整类事情从不划算变成随手可做。检查自己过去三年写的所有东西,以前要么不做,要么抽样做,现在花不到一美分、等不到一秒。一个每天跑几百万次的判断,以前要算预算,现在可以当成一次普通的函数调用写进代码里。
07 零幻觉这句话要怎么读
官方材料里有一个说法需要特别小心,Jev 的幻觉率是0%。
这句话在博客里有一个限定词,是由 schema 保证的,不是实测出来的。这个限定很关键。
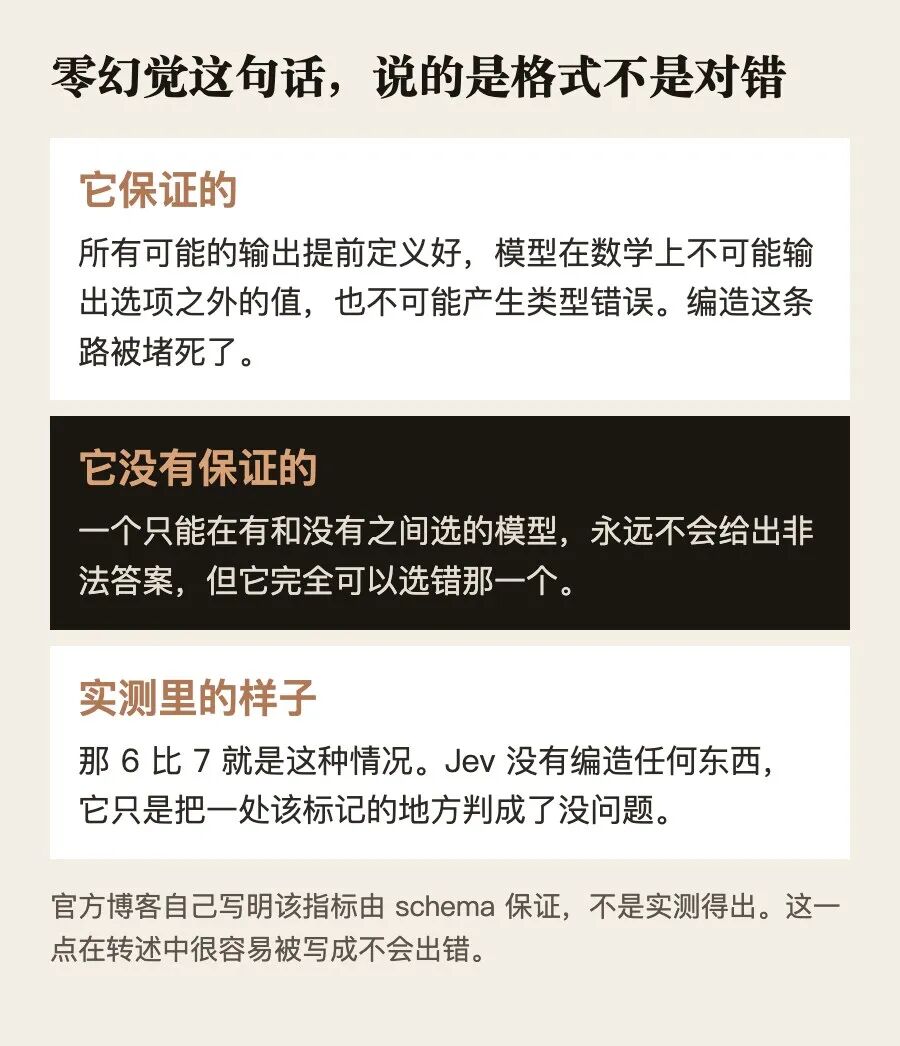
零幻觉这个指标保证了什么,没有保证什么。Sense AI 依据官方博客的限定条件整理
它的意思是,因为所有可能的输出都提前定义好了,模型在数学上不可能输出一个不在选项里的值,也不可能产生类型错误。你问它这段话有没有问题,它只能回答有或者没有,不可能凭空造出第三个答案。
但这和答对是两件事。
一个只能在有和没有之间选的模型,永远不会给出非法答案,它完全可以选错那一个。Mike Taylor 测出来的6比7,正是这种情况。Jev 没有编造任何东西,它只是把一处该标记的地方判成了没问题。
所以零幻觉在这里是一个关于格式的保证,不是关于正确率的保证。这两件事在大模型的语境下经常被混在一起说,因为大模型的幻觉通常表现为编造内容。换到 Jev 这里,编造这条路被堵死了,判断失误这条路仍然敞着。
我们把这一点单独拎出来,是因为接下来大概率会有很多转述把零幻觉直接写成不会出错。
08 官方博客自己列了一串局限
有一件事值得记一笔。这份发布博客在列自己的局限时,比多数同类材料坦诚得多。
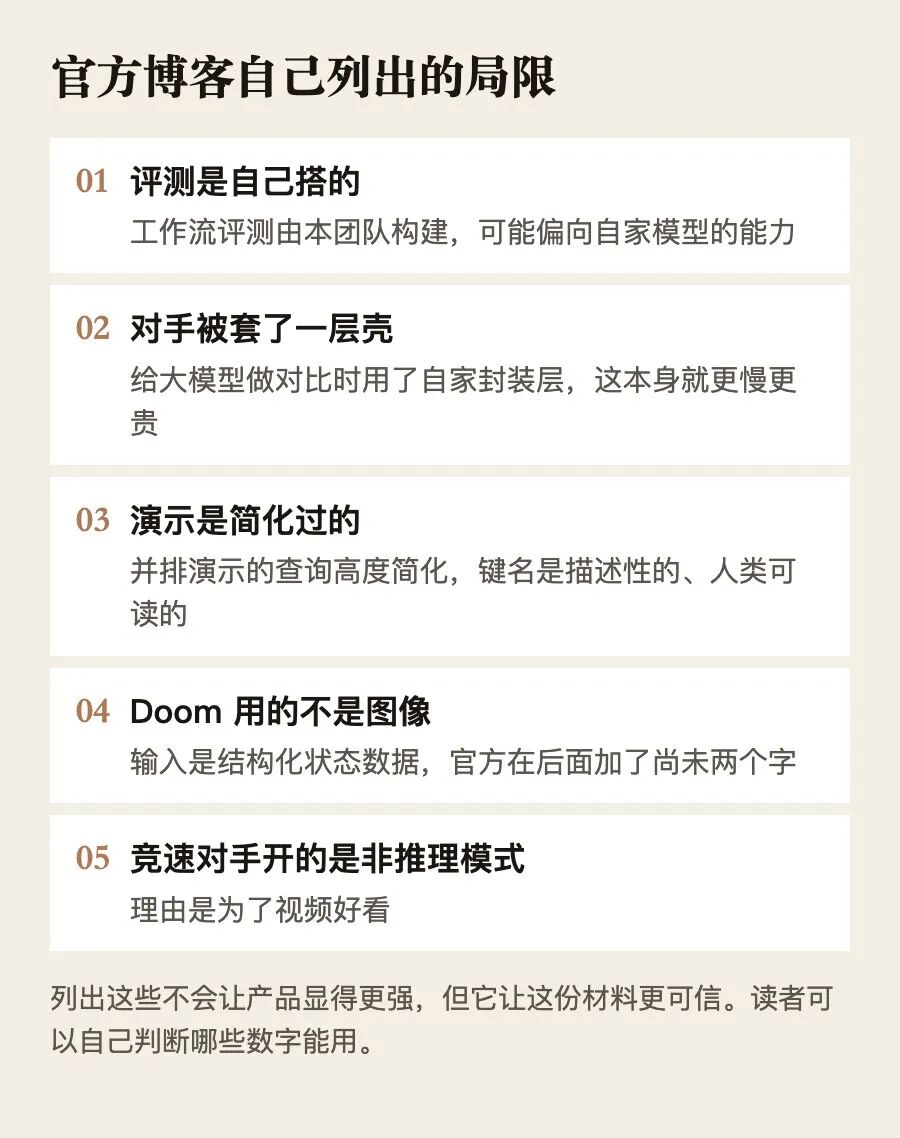
官方博客自己列出的六项局限。Sense AI 整理自该博客
它写明工作流评测是自己团队构建的,可能偏向于自己模型的能力。
它写明在给大模型做对比测试时,用的是 TypeSafe 自家的 System One 封装层,而这个封装会把模型约束成结构化输出,这种做法本身就比让模型直接给出不带概率的决策更慢也更贵。
它写明并排演示用的是高度简化的查询,键名是描述性的、人类可读的。
它写明 Doom 演示用的是结构化状态数据,不是图像,并且加了一个尚未两个字。
它写明维基百科竞速的对手开的是非推理模式,理由是为了视频好看。
参照模型选的是 GPT-6 Astra 和 Fable 5.1 的平均值,博客说这个选法可能反过来低估了 Jev 的相对表现。
把这些限定列出来不会让产品显得更强,但它让这份材料更可信。读者可以自己判断哪些数字能用。
09 名字里的那个经济学家
Jev 这个名字来自19世纪的英国经济学家 William Stanley Jevons。
他提出过一个反直觉的观察。蒸汽机效率提高之后,煤的消耗量没有下降,反而增加了,因为效率降低了使用成本,从而打开了以前不划算的用途。
公司在博客里明确说,他们预期机器智能会走同一条路。
这个命名本身就是一句判断。他们赌的是一件更间接的事。把价格压到某个位置之后,会出现一批以前根本不会有人做的用法,总量因此变大,而不是从现有大模型的调用量里分走一块。Mike Taylor 那个1709次判断花不到一美分的实验,就是这类用法的样子。以前没人会为了检查自己的旧文章去调用三十次大模型。
10 这件事成立的话,改变的是分工
如果这套东西站得住,它的意义不在于取代大模型。
一个真实的工作流里有很多步骤,其中一部分需要写东西、需要解释、需要推理,另一部分只是在做选择。这条内容要不要标记,这个字段属于哪一类,这个请求该转给谁,这一步要不要重试。
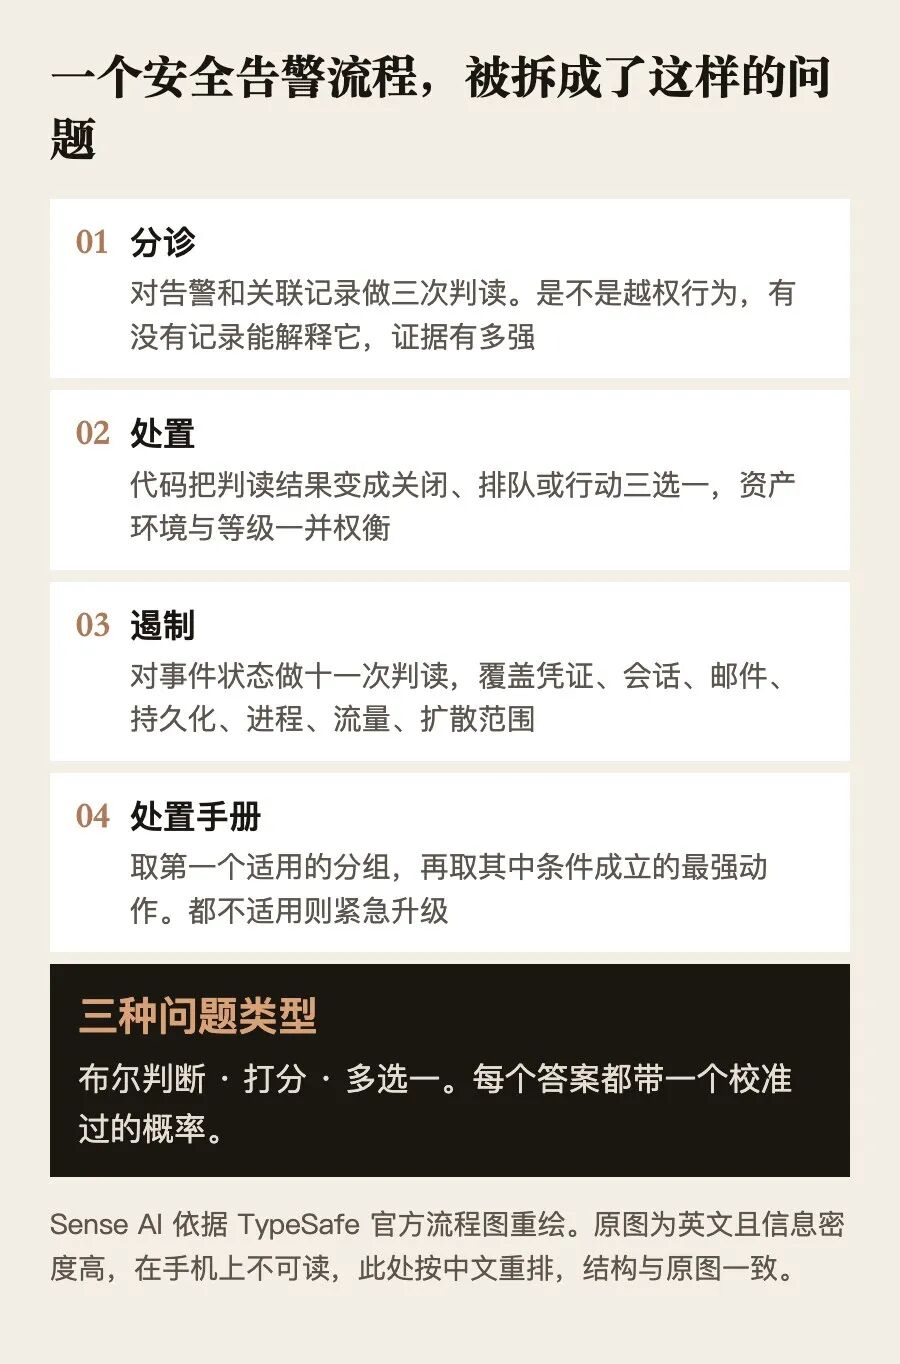
官方给出的一个安全告警处置流程,被拆解成布尔判断、打分与多选一三类问题。Sense AI 依据官方流程图重绘
在真实系统里,这类判断的密度很高。一条用户反馈属于哪个类别,一笔交易要不要进人工复核,一段日志是不是同一个已知故障,一份简历符不符合硬性条件,一个爬回来的页面值不值得存,一次模型输出要不要重试。这些环节的共同点是,答案的取值范围提前就知道,需要的只是选对。
后面这一类占的比重比想象的大,而它们现在大多也在用大模型做,因为没有别的选择。用一个能写小说的模型去回答是或者否,成本和延迟都花在了用不到的能力上。
Almeida 的另一句话是这个意思。他说他想要的不是即时生成的软件,那个只是很酷,他想要的是更聪明的软件。
他还预测,将来回头看,现在这个以规模扩张为中心的阶段会被写成一次跑偏。
这是一个很大的判断,而且来自一个参与建立了这个阶段的人。
需要留意的是,他现在有一家公司要卖。一个人说自己参与开创的路线跑偏了,同时拿出一条新路线,这两件事放在一起时,论证的力度和利益的方向是重合的。这不代表他说错了,只是意味着这段话应该按有立场的表述来读。
11 怀疑应该放在哪里
他自己在推文里写了一句,非凡的主张需要非凡的证据。这句话也适用于评价他。
目前缺的证据有几类。
第一类是独立的、覆盖面更广的准确率评测。现在只有官方的自建评测,加上一位作者11组实验的结果。6比7这个比分来自一次样本量很小的测试,它既不能证明 Jev 不行,也不能证明它行。
第二类是复杂任务上的表现。所有演示都在做定义清晰的分类和选择,选项基数上限是255。真实业务里大量判断没有这么干净。
第三类是生产环境的稳定性。延迟数字标注了是在西海岸的笔记本上跑出来的,有地理偏差。并发、限流、长期一致性都还没有外部数据。
第四类是这套方法的适用边界。哪些任务用它合适,哪些任务会因为缺少推理而失败,目前只能靠试。
12 几个还不知道的
把没有答案的部分列清楚。
新架构的具体形态没有公开,博客只说是新的模型架构。RLCD 的技术细节没有展开。
模型规模、训练数据、训练成本,全部没有披露。
输出 token 永远免费这个承诺没有附带条件说明,公司也没有解释商业模式如何支撑。
20到200倍和40到400倍这两个区间跨度很大,具体取决于任务,官方没有给出各区间对应的任务类型分布。
公司目前只开放候补名单,没有公开可用的接口,所以我们无法自己测试。本文所有性能数字要么来自官方,要么来自 Mike Taylor 的公开实验记录。
Diogo Almeida 参与发明 ChatGPT 这个说法来自他本人和公开资料,具体贡献的范围和权重我们没有独立核实。
资料来源:
Diogo Almeida 发布 Jev 的推文(2026年9月16日)原文 https://x.com/CompleteSkeptic/status/2099925682726002904
TypeSafe AI 官方博客,Introducing System One Models and Jev原文 https://typesafe.ai/blog/introducing-system-one-models-and-jev
TypeSafe AI 官方网站原文 https://typesafe.ai/
Every,Mike Taylor 对 Jev 的独立实测记录原文 https://every.to/also-true-for-humans/mini-vibe-check-typesafe-s-jev-judged-everything-i-ve-written-in-0-7-seconds
BigGo Finance 报道 Diogo Almeida 关于 RLHF 与跑偏的表述原文 https://finance.biggo.com/news/58ea28526de2d7e9
Diogo Almeida 的 LinkedIn 页面原文 https://www.linkedin.com/in/diogomda/
TestingCatalog 对 Jev 模型定位的说明原文 https://x.com/testingcatalog/status/2099968075861008781
本文由人人都是产品经理作者【深思SenseAI】,微信公众号:【深思SenseAI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供



- 目前还没评论,等你发挥!