起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
存量应用跨平台迁移:别急着改代码,先理清三方依赖链#1024鸿蒙实战共创#

很多团队接到“存量应用迁移到新平台”的任务时,第一反应是排页面重写、交互适配和功能联调的工作量。但真正做过迁移的人往往有另一种体会:最耗时间的,常常不是页面,而是工程里那些“大家都以为没问题”的依赖。
比如,一个多年没更新的 SDK、一个封装很深的原生模块、一组不同架构的二进制库,或者构建脚本里默认存在的本机环境假设。开发在本地能编译,测试机也能跑,但一换到目标平台,问题就可能集中冒出来。产品经理看到的表象是“迁移进度卡住了”,技术团队实际面对的却是依赖链没有摸清。
所以,存量应用跨平台迁移,建议先把依赖链弄清楚,再谈改代码。目标平台可以是 HarmonyOS,也可以是其他跨平台场景,方法相通。
一、先建一张“能执行”的依赖清单
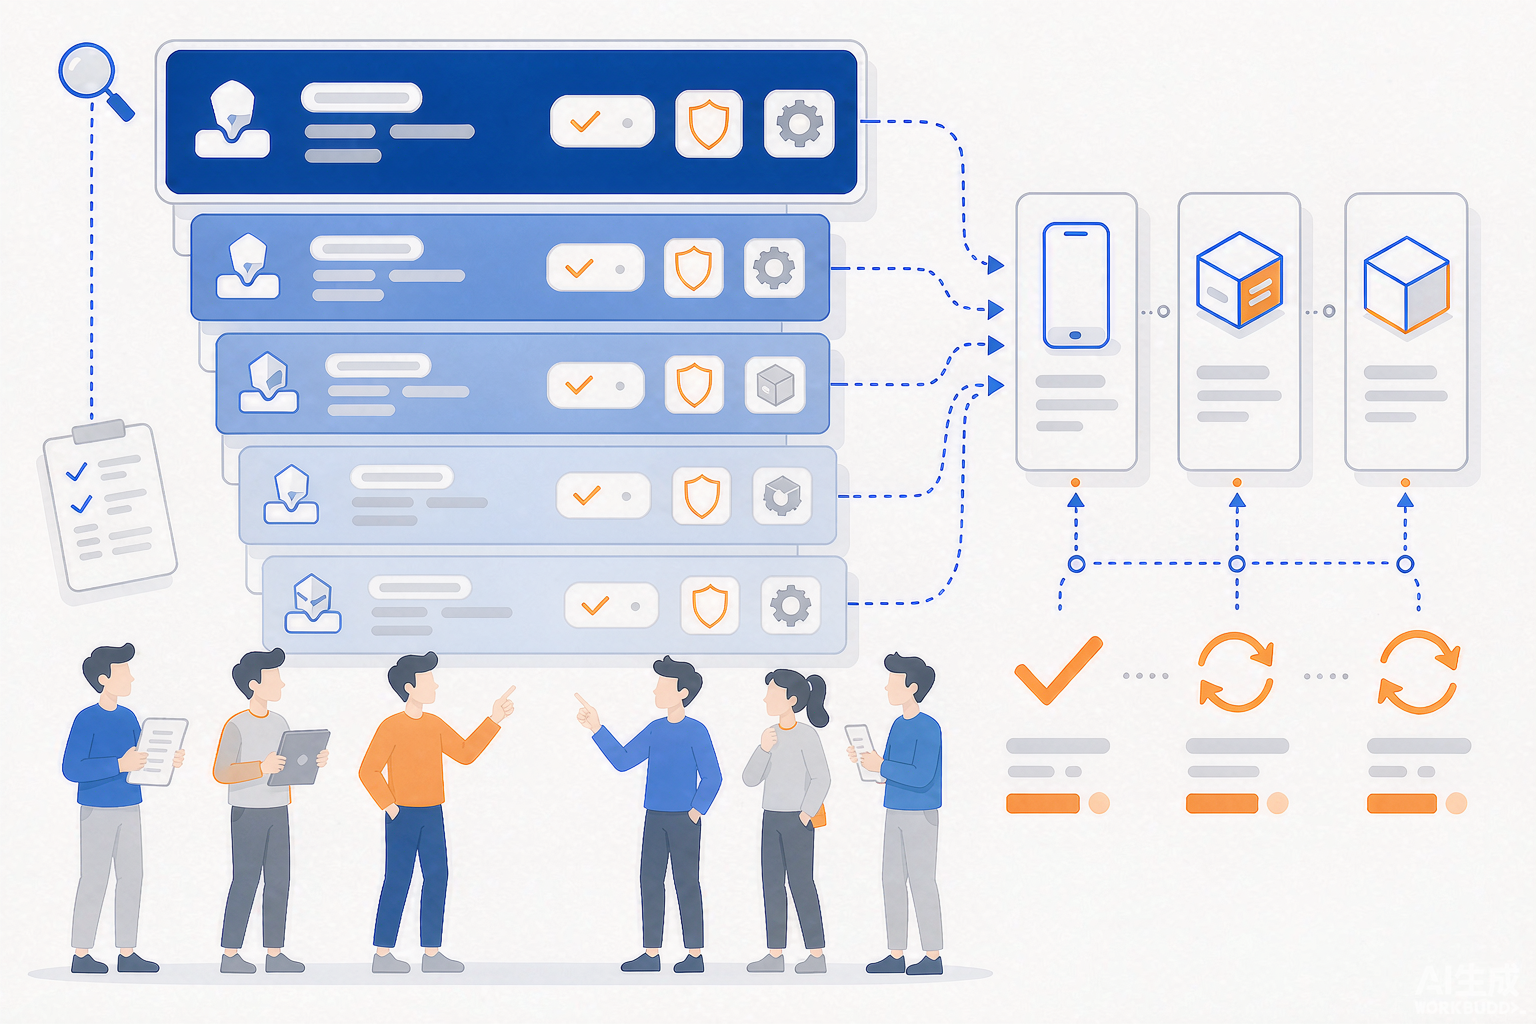
依赖盘点不能只列一个库名。更有效的做法,是按来源和运行路径分层:应用直接依赖、跨平台框架插件、原生模块、C/C++ 组件、构建工具与发布脚本。
每个条目至少记录:版本、维护状态、目标平台支持情况、许可证、是否包含预编译产物,以及当前功能是否真的被业务使用。尤其最后一条很重要——有些依赖只是历史遗留,产品上早已没有核心价值,迁移时反而应该借机做减法。
一个能落地的起点,是先把工程里的依赖配置读出来。鸿蒙工程中,依赖声明集中在 oh-package.json5 的 dependencies 和 devDependencies 字段里,远程三方包、本地模块、本地 HAR/HSP 都可以在这里登记。例如:
// entry/oh-package.json5
{
  "dependencies": {
    "@ohos/lottie": "^2.0.0",
    "some-ui-kit": "file:../some-ui-kit",   // 本地模块
    "legacy-sdk": "file:../legacy-sdk.har"  // 本地 HAR
  },
  "devDependencies": {
    "@ohos/hypium": "1.0.18"
  }
}
但“声明了什么”和“实际装了什么”是两件事。真正有用的依赖树,需要用 ohpm list 拉出来。默认只显示直接依赖,加上 --depth 才能看到嵌套层级;对于多模块工程,-r 可以打印所有 module 的依赖关系:
# 查看 entry 模块的依赖树,深度 3 层
ohpm list -d 3

# 查看工程所有 module 的依赖关系
ohpm list -r --depth 3

# 大工程控制台可能截断,直接导出到文件
ohpm list -r --depth 4 > deps-tree.txt
拿到依赖树后,再逐项对照下面的表格做处置判断。清单本身不是目的,让产品团队能据此判断“哪些功能可以平稳迁移、哪些可能要换方案”,才是目的。
| 依赖类型 | 首要检查 | 常见处置 |
|---|---|---|
| UI/跨平台插件 | 是否支持目标平台,是否仍在维护 | 升级、换插件或局部原生实现 |
| C/C++ 库 | 二进制接口兼容性、编译选项、系统调用和产物来源 | 重编译、封装接口、替换实现 |
| 网络/存储 SDK | 权限、生命周期、TLS 与后台行为 | 对照官方适配文档逐项验证 |
| 构建插件 | 工具版本兼容、仓库和缓存依赖 | 固定版本,重建干净环境 |
二、“依赖能下载”不等于“依赖可用”
迁移中最容易误判的一点,是看到依赖能下载、能编译,就认为问题解决了。实际上,有些库编译顺利,运行时却会因为系统能力、文件路径、线程模型或权限变化失败;也有些库功能正常,但打包产物、隐私披露或许可证不符合发布要求。
因此,建议把验证拆开记录:编译是否通过、运行是否正常、功能是否覆盖、性能是否可接受、安全与隐私是否合规、发布检查是否通过。不要用一个“能跑”掩盖所有风险。
三、构建失败和运行问题,要分开排查
遇到构建失败,不要一上来就同时升级所有版本。先固定当前分支,保存完整错误日志,确认工具链、SDK、依赖锁定文件和本机环境,再从最小工程复现。
排查的第一步不是猜,而是把“当前环境到底用了什么”固化成可对照的快照。hvigorw buildInfo 可以输出构建环境信息,-v 查看版本,clean --no-daemon 排除缓存和守护进程干扰,再带上 --stacktrace 重新构建,拿到完整堆栈:
# 固化环境信息
hvigorw -v
hvigorw buildInfo -p json

# 干净环境 + 完整堆栈重新构建
hvigorw clean --no-daemon
hvigorw assembleHap --mode module \
  -p product=default -p buildMode=debug \
  --no-daemon --stacktrace
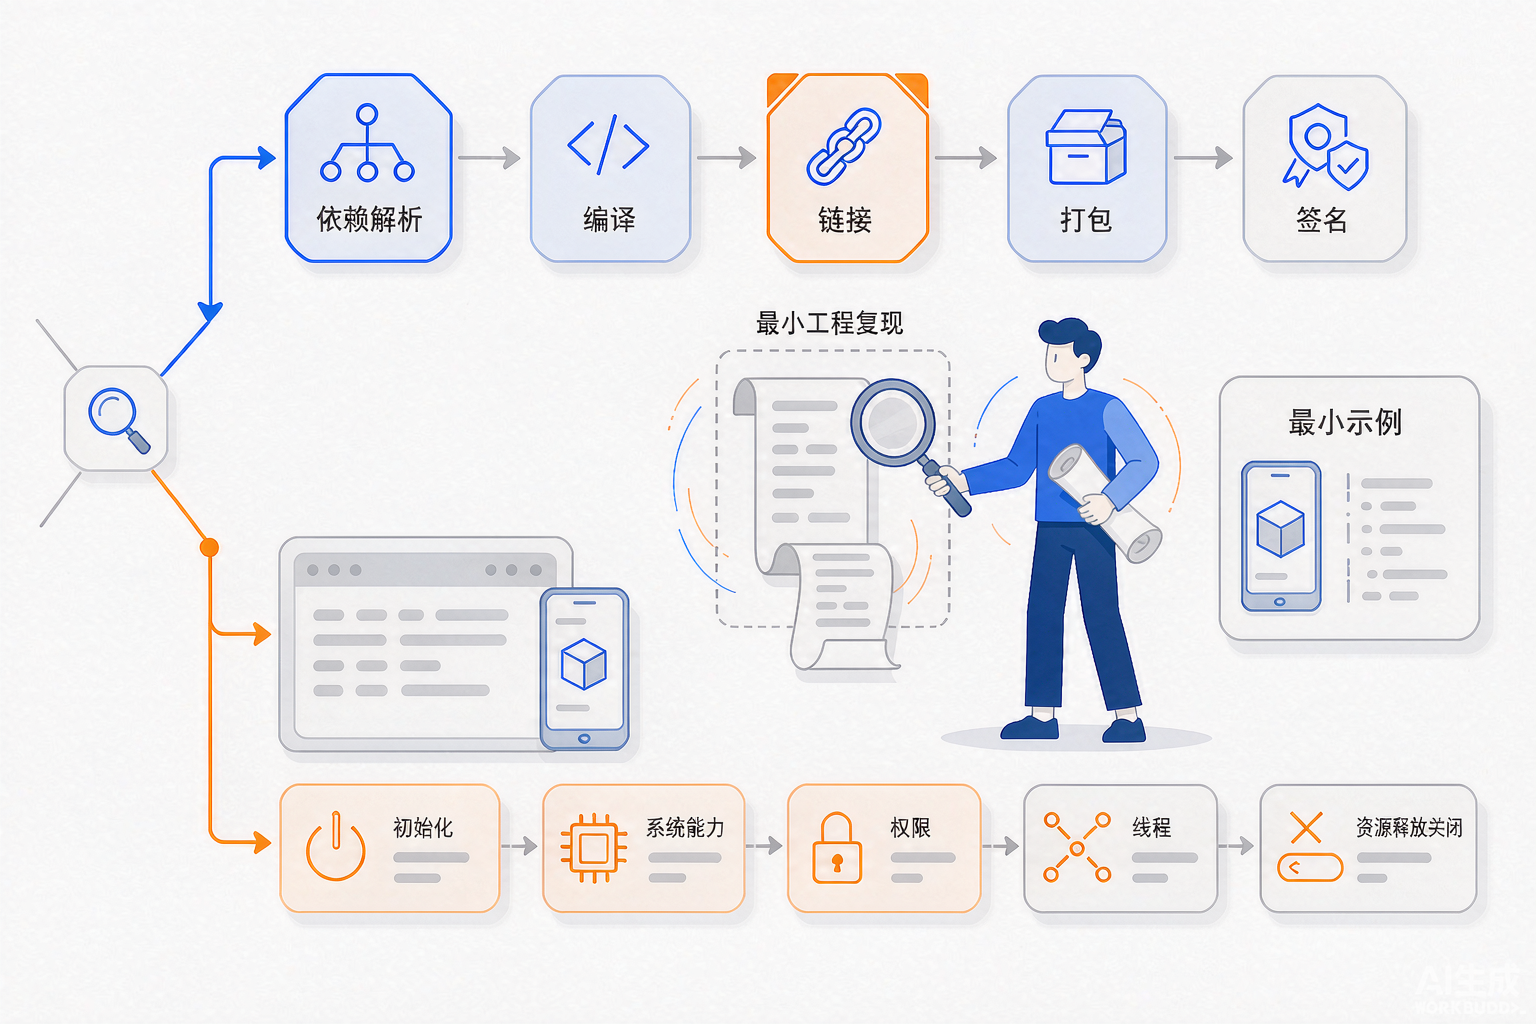
构建日志里优先搜索 hvigor ERROR,比在 warning 堆里翻找高效得多。先判断问题卡在依赖解析、编译、链接、打包还是签名——阶段不同,排查方向完全不同。
如果是运行期问题,就围绕最小调用路径查:初始化是否成功、系统能力是否存在、权限是否授予、线程是否正确、资源是否关闭。跨平台框架还要区分是框架层问题,还是插件层问题。最好能提供可独立运行的最小示例,而不是一句“迁移后整体不工作”。
对于 C/C++ 依赖,运行期崩溃往往和 .so 的动态链接有关。可以用 NDK 自带的 llvm-readelf 检查一个原生库实际依赖了哪些动态库,判断是否存在“编译能过、运行时找不到符号”的情况:
$OHOS_NDK_ROOT/toolchains/llvm/prebuilt/linux-x86_64/bin/llvm-readelf \
  -d libnative.so | grep 'Shared library'
这一步的价值在于:它把“运行期失败”从一句模糊的描述,变成了一条可以核对的具体依赖链。
四、没有现成支持时,方案不止一种
当某个依赖没有目标平台支持时,不一定只有“继续硬改”一条路。常见选择包括:换维护活跃的替代库;把非核心能力封装成独立服务;只对少量关键路径做原生实现;或者删掉产品价值不足的功能。
继续维护一个无人负责的分叉版本,往往是最贵的方案。产品经理在这里可以发挥的作用,是尽早参与功能取舍:哪些能力必须保留,哪些可以降级,哪些可以延后。越早讨论,越少返工。
五、把验证前移到每次合并
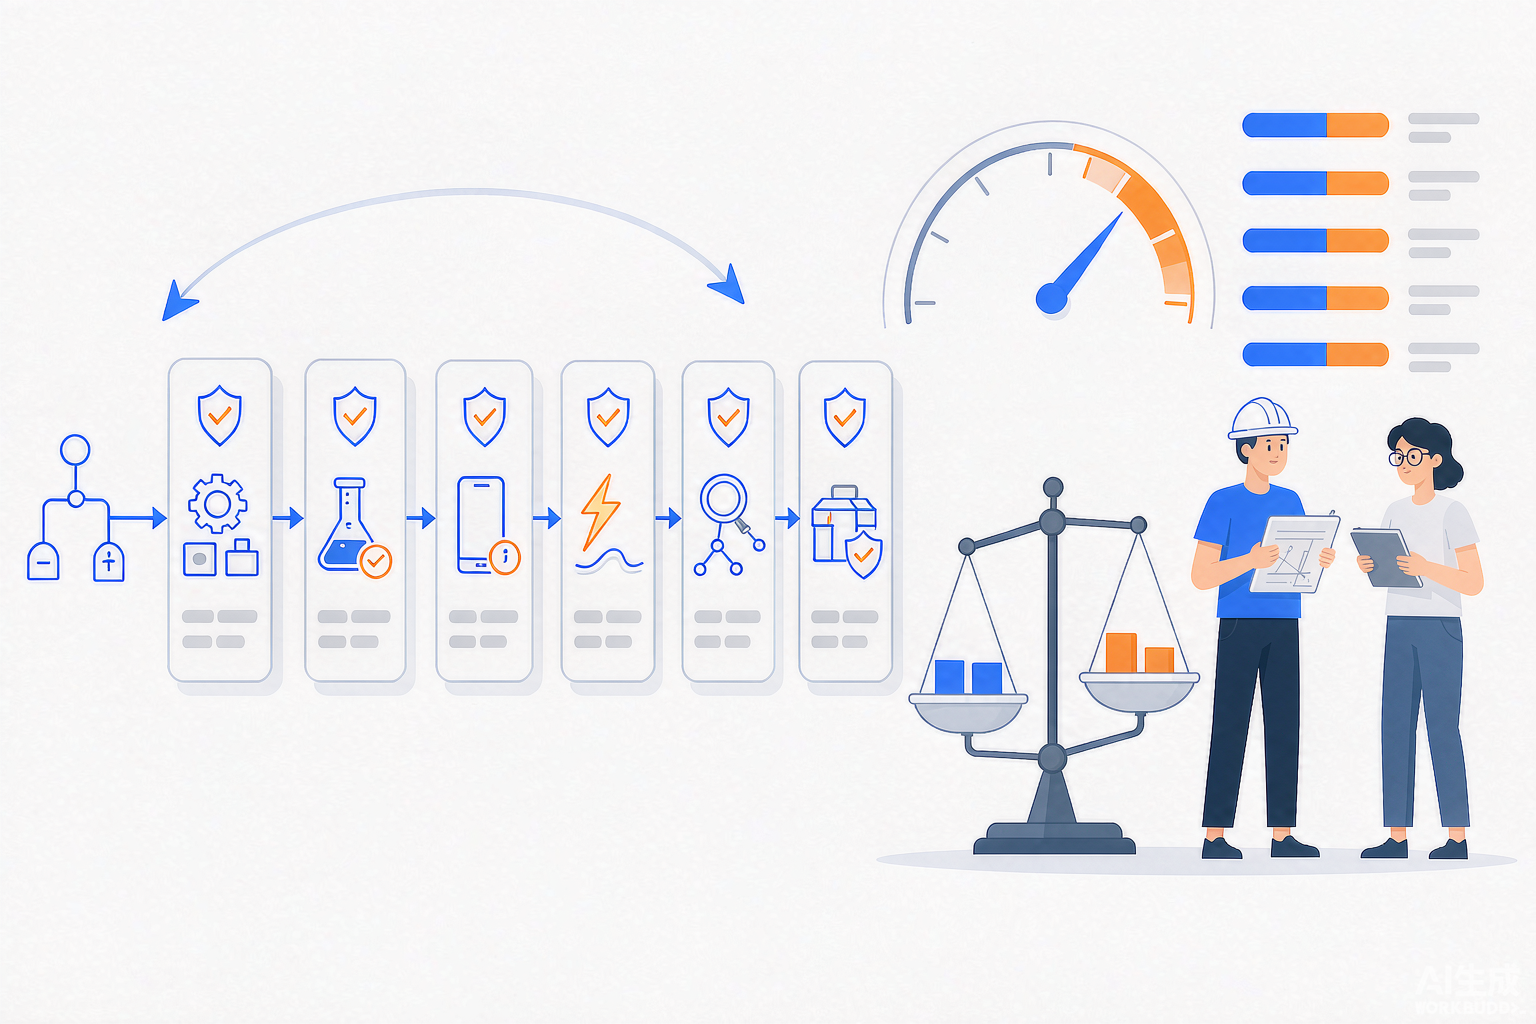
迁移期间,建议设置一个最小但稳定的持续集成(CI)流程:干净环境构建、单元测试、目标设备启动、关键业务冒烟、依赖扫描和产物检查。每次只处理一类风险,避免把依赖问题、架构改造和 UI 调整混在同一个大提交里。
CI 脚本不需要一步到位,但核心命令要固定下来。下面是一个精简的 GitHub Actions 片段,覆盖“装依赖 → 干净构建 → 留存产物”这一最小闭环:
# .github/workflows/harmonyos-ci.yml(节选)
steps:
  - uses: actions/checkout@v3

  - name: Install dependencies
    run: ohpm install --all

  - name: Clean build
    run: |
      hvigorw clean --no-daemon
      hvigorw assembleHap --mode module \
        -p product=default -p buildMode=debug \
        --no-daemon

  - name: Upload build output
    uses: actions/upload-artifact@v4
    with:
      name: build-output
      path: entry/build/default/outputs/default
如果是 GitLab CI,核心环节同样是一条命令链:ohpm install --all、hvigorw assembleHap -p buildMode=release --no-daemon,签名和发布阶段再按需追加。关键不在于用哪个平台,而在于把“干净环境能构建、关键路径能冒烟”变成每次合并都要过的门槛,而不是等“能跑起来”之后再补。
六、最后算总成本,而不只是迁移成本
技术方案最终要算总账:迁移周期、后续维护成本、功能覆盖程度、启动和运行表现,以及团队能否持续跟进。可以像依赖清单一样,把成本项也列成一张可对照的表:
| 成本项 | 要回答的问题 |
|---|---|
| 迁移周期 | 依赖替换和重写分别占多少时间? |
| 后续维护 | 替换后的库有没有人持续维护?分叉版本谁来跟? |
| 功能覆盖 | 哪些能力降级或删除,产品是否能接受? |
| 运行表现 | 启动、内存、包体积在目标平台上是否可测、可接受? |
| 团队能力 | 原生模块和 C/C++ 依赖,团队能否长期承接? |
先把依赖链摸清楚,能减少后期返工,也能让产品团队更早发现哪些功能要调整计划。对产品经理来说,可以推动三件事:让技术团队输出可执行的依赖清单;把依赖风险纳入排期,而不是只排页面工作量;为迁移设置最小验证门槛。存量应用迁移不是单纯“改代码”,而是一次对依赖、功能和交付节奏的重新盘点。
本文由 @王越 授权发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务
- 目前还没评论,等你发挥!