起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Codex GPT-6 Astra额度掉得太快?我用一段提示词,把上下文消耗大幅降低了!


GPT-6 Astra 上线之后,Codex 操控电脑的能力确实更强了,但额度下降速度也让我感受非常明显。原来可以用三天的额度,做同样的内容,大半天就能用完。我退回 GPT-5.6 后,消耗依然很快,最后只好把历史任务和本机配置完整翻了一遍。
众所周知,Codex 一致是我的最佳 CP,我一直在用 Codex 做产品、写文章、跑脚本。
讲真,GPT-6 Astra 上线之后,性能确实很强,尤其是操控电脑这一块。让它根据屏幕上的状态继续操作,整个执行过程比以前更顺,这个提升我超级认可。
但额度消耗也让我感受非常强烈。以前一轮额度通常能用三天左右,现在做同样的内容,大半天就能用完。
对,就是这么夸张。
比如,参考下图,从使用记录看,9 月 10 日、11 日是这一周的用量高位,虽然它不能直接换算出每个任务究竟消耗了多少额度,但至少能说明:那几天的 Codex 任务明显消耗更多。
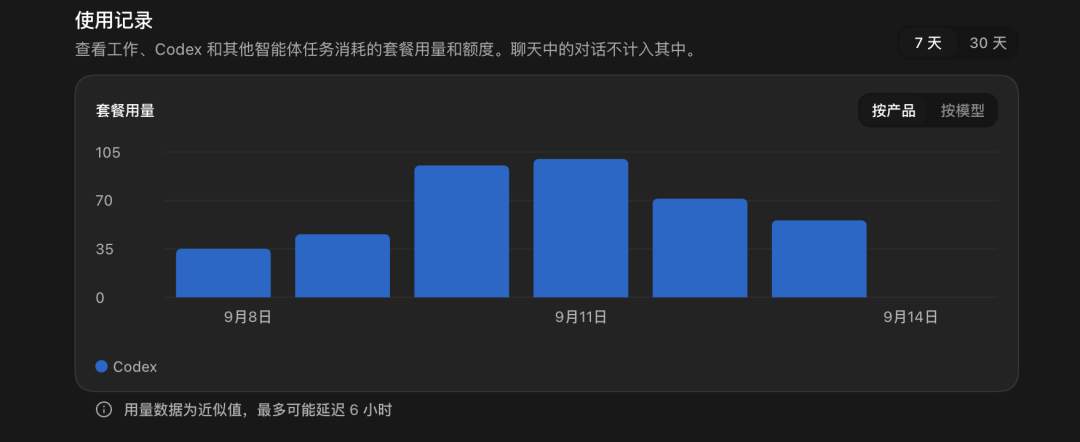
Codex 近 7 天套餐用量记录
正是因为这个体感,我不太敢继续用 GPT-6 Astra,先退回了 GPT-5.6 Sol。
结果很扎心:切到 GPT-5.6 以后,额度下降速度还是很快。
再按模型和工具拆开看,7 天内一共有 299 轮产品活动,GPT-6 Astra 和 GPT-5.6 Sol 都有持续使用;
同期插件调用 984 次,其中 Computer Use 和 Unified Computer Use 占了主要部分。
这也符合我的实际工作场景:大量任务都不是纯聊天,而是在让 Codex 操控电脑、调用工具、连续完成工作流。
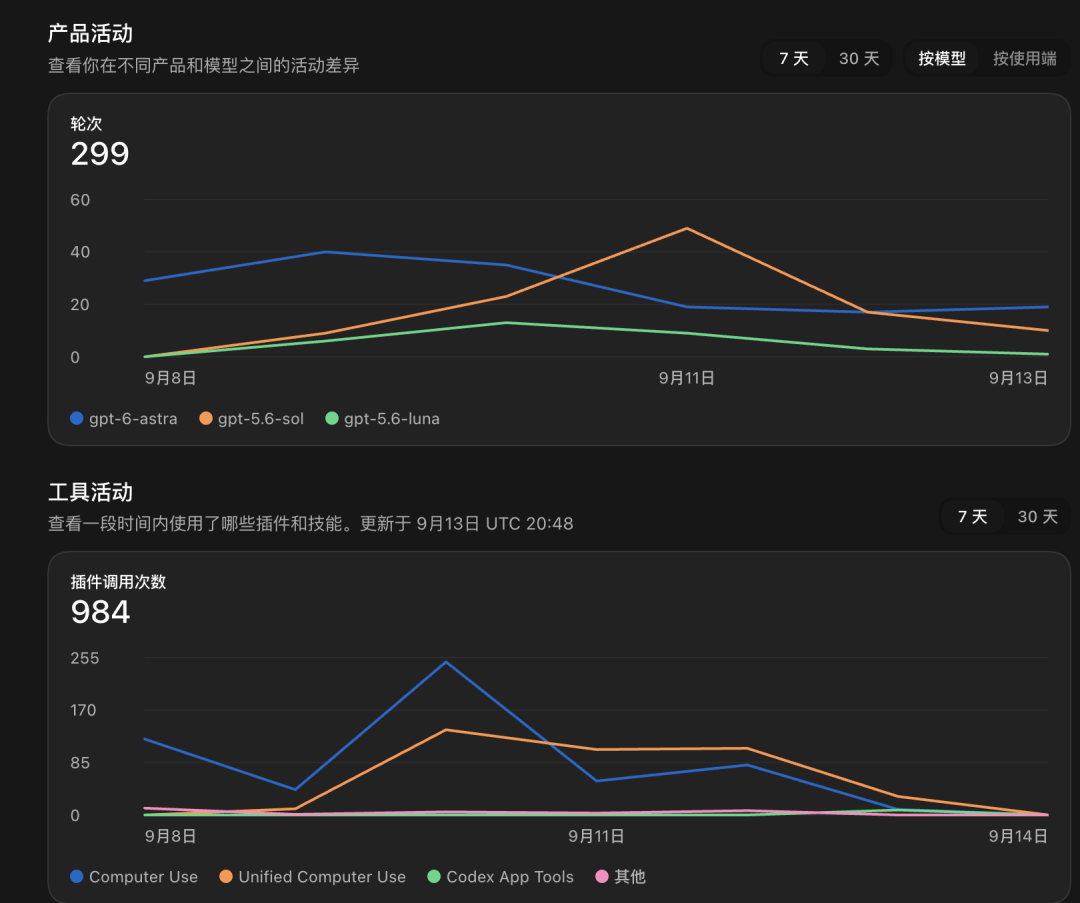
Codex 近 7 天模型活动与工具调用
下图,近 7 天产品活动与工具活动:GPT-6 Astra、GPT-5.6 Sol 均有连续使用,工具调用主要集中在 Computer Use。*
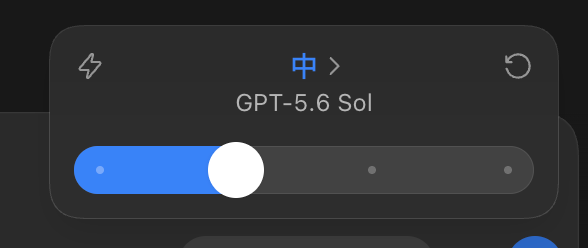
GPT-5.6 Sol 中等推理强度
01 额度不是突然消失,而是被上下文一点点吃掉
这次检查里,我看到两条使用 GPT-5.6 Sol、中等推理强度的长任务,累计输入 token 分别接近 1599 万和 1582 万。
任务进行到后面,单次调用携带的输入已经达到 22.8 万到 25.4 万 token。
这类消耗很容易被忽略。你在界面里只发了一句短话,模型收到的却不只是这句话。前面的聊天记录、工具返回、项目规则、Skills 描述、插件说明,都可能继续跟着进入下一轮。
所以一个任务用得越久,每次调用就越重。表面上还是问一句、改一个小地方,背后可能已经拖着二十多万 token 的上下文在跑。
我还检查了自己的 Codex 环境:一共有 274 份 Skill 定义,全局 `AGENTS.md` 原来有 5284 字节。
其中很多规则本身有用,但写得过长、重复解释,或者要求每次任务都读取大量资料,就会继续增加上下文。
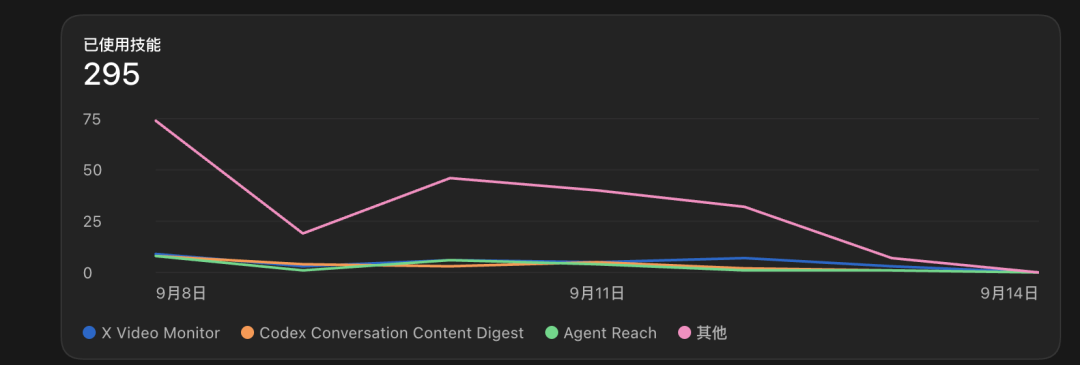
Codex 近 7 天技能使用活动
近 7 天 Skill 活动记录:「已使用技能」为 295,多个工作流 Skill 在这一阶段被实际调用。
这与 OpenAI 最近针对 GPT-6 Astra 发布的文章基本一致:
《Rethinking skills and prompts for GPT-6 Astra》
OpenAI 官方说明:Skill 描述太多、太长,会持续占用上下文;AGENTS.md 也不应该要求模型在每个小任务开始前都读取一整套文档。更合适的方式,是只在当前任务确实需要时再加载对应规则和资料。
额度掉得快,不一定是模型突然变贵了,也可能是每一轮都在重复携带越来越重的上下文。
于是,我这次实际做了三类调整。
第一,把全局 `AGENTS.md` 从 5284 字节压缩到 1705 字节。品牌名、公众号发布规则、飞书操作方式这些关键约束都保留,只删掉重复说明和不需要每轮都出现的内容。
第二,给 Codex 增加自动压缩和工具输出限制:
model_auto_compact_token_limit = 160000
model_auto_compact_token_limit_scope = “total”
tool_output_token_limit = 8000
[skills]
max_context_tokens = 4000
这些数字不是所有电脑都必须照抄的标准答案。它们解决的是同一个问题:不要让单个任务和工具输出无限膨胀。
第三,没有看到插件多就直接卸载。插件、MCP 和 Skills 都可能承载真实工作流,粗暴关闭很容易把原本能用的能力弄坏。
当然,更稳妥的方式是先判断它们是否真的在每轮注入上下文,再决定要不要处理。
02 直接把这段提示词交给 Codex
自己逐项翻配置当然可以,但对大多数人来说,最省事的方式还是让 Codex 先检查自己的运行环境,再做一次可回滚的优化。
下面这段提示词,你可以直接复制给你的 Codex:
请帮我优化本机 Codex 的额度消耗。你可以直接检查并修改配置,但必须遵守以下要求:
1. 先读取并检查:
– ~/.codex/config.toml
– ~/.codex/AGENTS.md
– 已安装的 Skills、Plugins 和 MCP
– 最近 Codex 会话的 token 使用情况
– 是否存在 OpenCodex、第三方代理、自定义 model_catalog_json 或自定义 openai_base_url
2. 先诊断额度消耗快的主要原因,重点检查:
– 单个任务是否长期累积上下文
– 每轮输入 token 是否越来越大
– AGENTS.md 是否过长
– Skills 描述是否大量注入上下文
– 工具输出是否过长
– 是否加载了过多 MCP、插件或无关能力
– 当前模型和 reasoning effort 是否与界面选择一致
– 是否被第三方工具自动改成“自定义模型”
3. 修改任何文件前,必须为原文件创建带时间戳的备份。
4. 在不影响主要功能的情况下,进行以下优化:
– 压缩 ~/.codex/AGENTS.md,保留原有关键规则、品牌名、发布规范和个人偏好,但删除重复解释和冗长描述
– 在 ~/.codex/config.toml 中设置:
model_auto_compact_token_limit = 160000
model_auto_compact_token_limit_scope = “total”
tool_output_token_limit = 8000
– 如果不存在 [skills] 配置,添加:
[skills]
max_context_tokens = 4000
– 如果相关配置已经存在,则修改现有值,不要创建重复字段
– 不要随意卸载或禁用插件、Skills、MCP
– 不要修改项目目录、代码仓库和业务文件
5. 模型处理规则:
– 优先保留我当前明确选择的模型和推理强度,不要擅自升级到 GPT-6 Astra、Astra Extra High 或其他消耗更高的档位
– 如果当前模型已经不在 Codex 原生模型列表中,不要伪造或强行添加
– 如果模型 ID 与界面选项不一致,说明原因并恢复为 Codex 原生可识别的配置
– 如果发现 OpenCodex 或其他第三方代理修改了模型目录,只做诊断,不要擅自停止或卸载;明确告诉我它会导致界面显示“自定义”
6. 完成后必须验证:
– config.toml 能被 TOML 正常解析
– Codex CLI 能正常启动并识别配置
– 配置中没有重复字段
– AGENTS.md 的关键规则没有丢失
– 告诉我修改前后的 AGENTS.md 大小
– 列出实际修改的配置
– 给出所有备份文件路径
– 告诉我是否需要重启 Codex
7. 最后用中文给出简洁结论,包括:
– 额度消耗快的主要原因
– 已完成的优化
– 哪些地方为了安全没有改
– 后续使用建议
直接执行检查、备份、优化和验证,不需要让我逐步确认;但如果需要停用第三方代理、卸载插件或更换成另一个模型,必须先询问我。
这里有一个容易踩坑的地方:不要让 Codex 为了“省额度”擅自换模型。 模型是否出现在选择器里,会受到账号、客户端和灰度发布影响。
OpenAI 的模型文档也明确提到,不同套餐和发布阶段看到的选项可能不同。
我这次就遇到了一个额外问题。电脑里运行的 OpenCodex 代理修改了模型目录,原来选择过的 GPT-5.6 Sol 在列表里消失,界面只显示“自定义”。
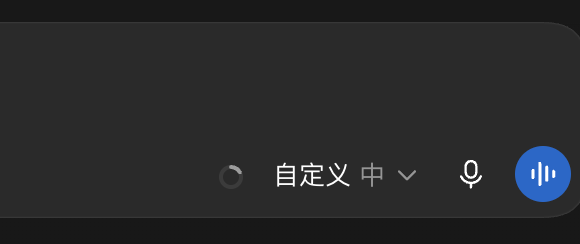
Codex 显示自定义模型
这与额度优化不是一回事。如果提示词看到自定义模型就直接删配置、停服务,可能把同事正在使用的代理环境一起破坏。
因此我在提示词里专门加了一条:先诊断,涉及停止第三方代理或更换模型时,必须单独确认。
03 优化之后,使用方式也要跟着变
配置调整之后,我继续按原来的方式跑任务,额度下降速度确实明显变慢了。以我这几天的体感看,已经和 GPT-6 Astra 推出以前的下降速度差不多。
这个变化让我确认,前面的优化不是只把配置文件改得更整齐,它确实影响了实际使用。不过有一件事不能完全交给配置解决:一个任务不要无限续下去。
同一篇文章、同一套代码,在一个任务里连续改几十轮,看起来方便,后面的每一轮却可能越来越重。
一个阶段已经完成,就新建任务,把必要文件和最终结论交给新任务。它不需要重新背着前面所有试错记录继续工作。
日常明确的小任务,也没必要默认使用最高推理强度。
OpenAI 官方建议是,先从账号提供的默认档位开始,只有在任务确实需要更深规划和分析时再提高;推理强度越高,通常使用的 token 也越多。
这次优化让我重新意识到,Codex 的消耗不只由模型名字决定。模型、任务长度、全局规则、Skills 和工具输出,共同组成了每一轮真正送进模型的内容。
如果最近也感觉额度下降得比以前快,可以先不用急着换套餐,可以先把上面的提示词复制给 Codex,让它从自己的历史任务和本地配置开始检查。
先看清 token 花在了哪里,再决定该压缩上下文、拆任务,还是调整模型。
还是那句话:驾驭 AI 的首要前提是,跟随 AI的变化而变化!
本文由人人都是产品经理作者【AI产品大峡谷】,微信公众号:【AI产品大峡谷】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于CC0协议

- 目前还没评论,等你发挥!