起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Anthropic 优化 30 多个生物模型,蛋白质设计成本最高降 98%


Anthropic 让 Claude 用不到四周优化了 30 多个生物研究开源模型,覆盖蛋白结构预测、蛋白设计与基因组学,平均提速数倍,并把大型分子系统压到单张 GPU 节点上推理。此前要花上万美元算力的蛋白设计流程,如今约 150 美元即可完成计算设计。
9 月 17 日,Anthropic 公布 Claude 在生物分子建模上的一组新结果:不到四周,Claude 优化了 30 多个用于生物研究的开源深度学习模型,覆盖蛋白结构预测、蛋白设计、Protein Language Model 和基因组学等任务。
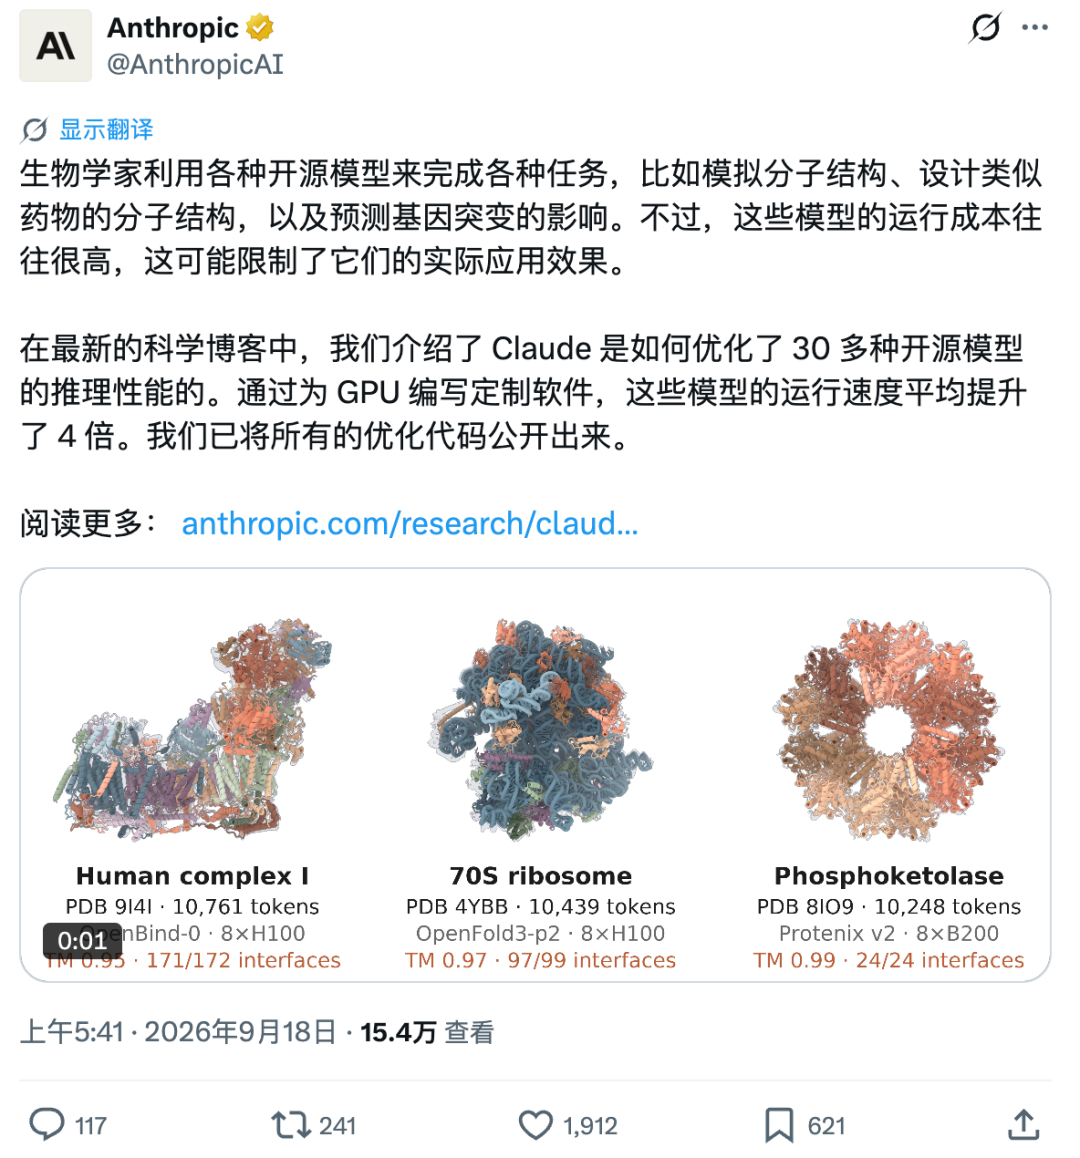
在允许极小精度损失的情况下,这批模型平均提速约 4 倍;如果要求输出结果完全一致,平均也能实现接近 2 倍的加速。Claude 还进一步降低模型运行时的显存占用,让部分原本需要多节点 GPU 才能处理的大型生物分子系统,可以在单个 NVIDIA GPU 节点上完成推理。Anthropic 已将相关优化代码开源。
这项工作的起点来自 Anthropic 此前的一次蛋白设计实验。当时 Claude 可以调用多个开源蛋白设计和结构预测模型,每个靶点最多消耗约 1 万美元算力,相当于约 2500 个 NVIDIA H100 GPU 小时。模型能够完成任务,但这一计算成本很难被大多数蛋白设计团队长期采用。
先把模型本身跑得更快
蛋白结构预测里,计算量最重的部分之一来自 triangle attention 和 triangle multiplication。
AlphaFold3、OpenFold3、Boltz-2 等模型都会大量使用这两类操作,用来处理不同 Token 之间的几何关系。问题在于,它们的时间和显存开销会随着系统规模迅速增长:输入规模扩大一倍,相关计算量和显存占用约增加到 8 倍;扩大三倍,则会达到 27 倍。
为此,Anthropic 让 Claude 直接参与底层 kernel 优化,并开发出一套名为 FlashPairformer 的自定义 kernel,专门加速 triangle attention 和 triangle multiplication。
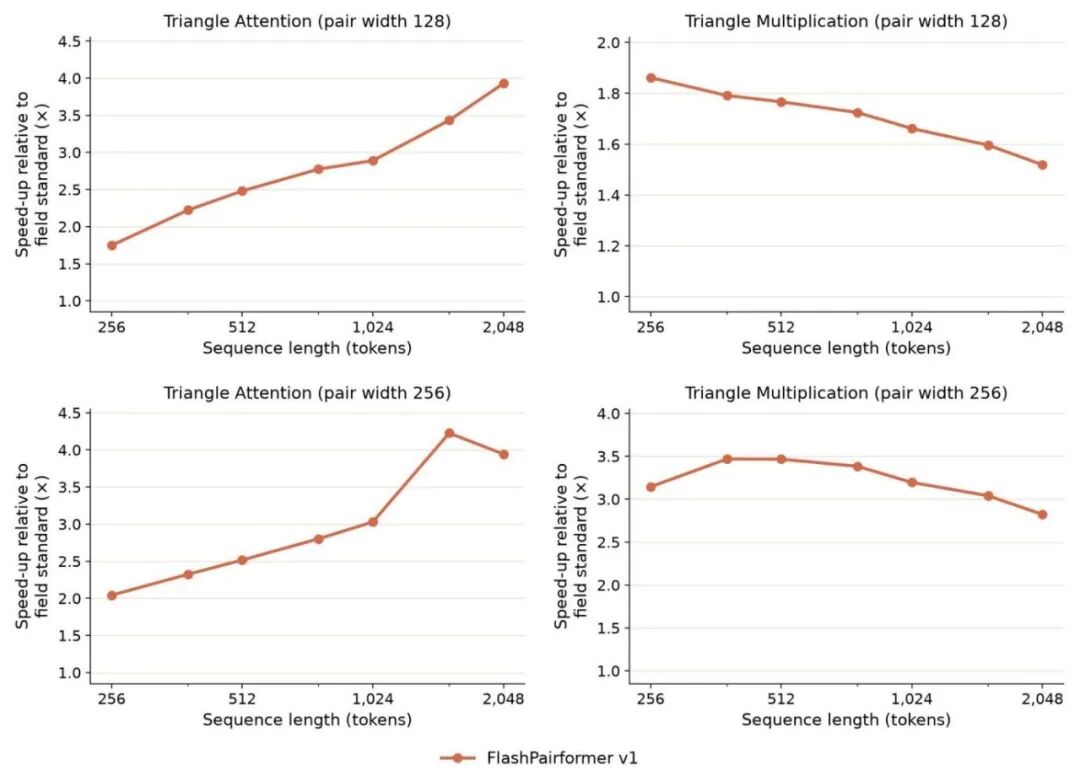
根据 Anthropic 的测试结果,相较 NVIDIA cuEquivariance,FlashPairformer 在 triangle attention 上平均快 2.7—2.9 倍,在 triangle multiplication 上快 1.7—3.2 倍,具体结果取决于不同模型配置。
Claude 做的也不只是写一套通用 kernel。Anthropic 随后让它逐个检查不同模型,根据每个模型自己的代码结构继续优化,包括缓存此前会被反复重新计算的结果、删除不会实际发生变化的分支,以及针对不同模型修改具体推理路径。
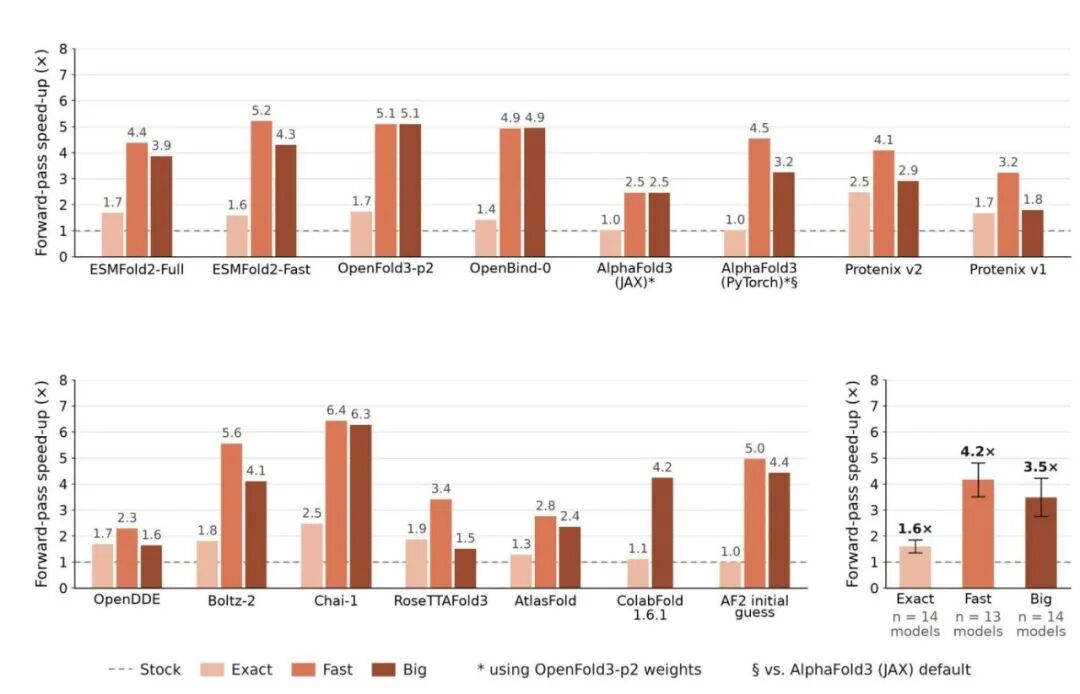
这些通用优化和逐模型优化叠加之后,结构预测模型平均获得约 4 倍加速。Anthropic 同时重新测试了这些模型在结构预测等下游任务上的表现,没有观察到优化版本造成任务性能下降。
整个过程由两名 Anthropic 技术人员监督。两人都有生物分子建模经验,但此前没有 inference optimization 或 kernel engineering 经验。
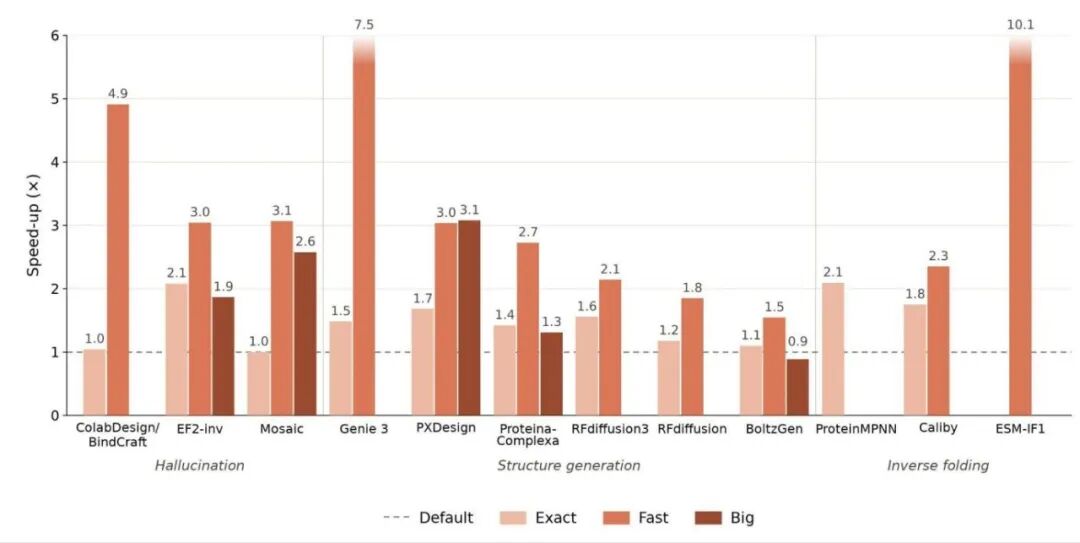
不到四周,Claude 完成了 30 多个开源模型的优化,覆盖生物分子结构预测、蛋白设计、Protein Language Model 和基因组学。蛋白设计部分涉及的模型架构也并不统一,包括 AlphaFold 类结构 Transformer、diffusion、flow matching 和 GNN。
提速同时控制预测精度
模型提速之后,另一个问题是结果有没有发生变化。Anthropic 对结构预测模型进行了两种测试。一种追求更高速度,允许数值精度发生很小变化;另一种要求优化前后的输出完全一致。
前一种情况下,十多个生物分子结构预测模型平均提速约 4 倍;后一种情况下,平均仍能实现约 1.6 倍加速。
Anthropic 还单独测试了一套 Fast mode。在一组生物分子界面数据上,Fast mode 与默认设置得到的结果在统计上没有显著差异。测试以 DockQ 大于 0.23 作为可接受界面的判断标准。
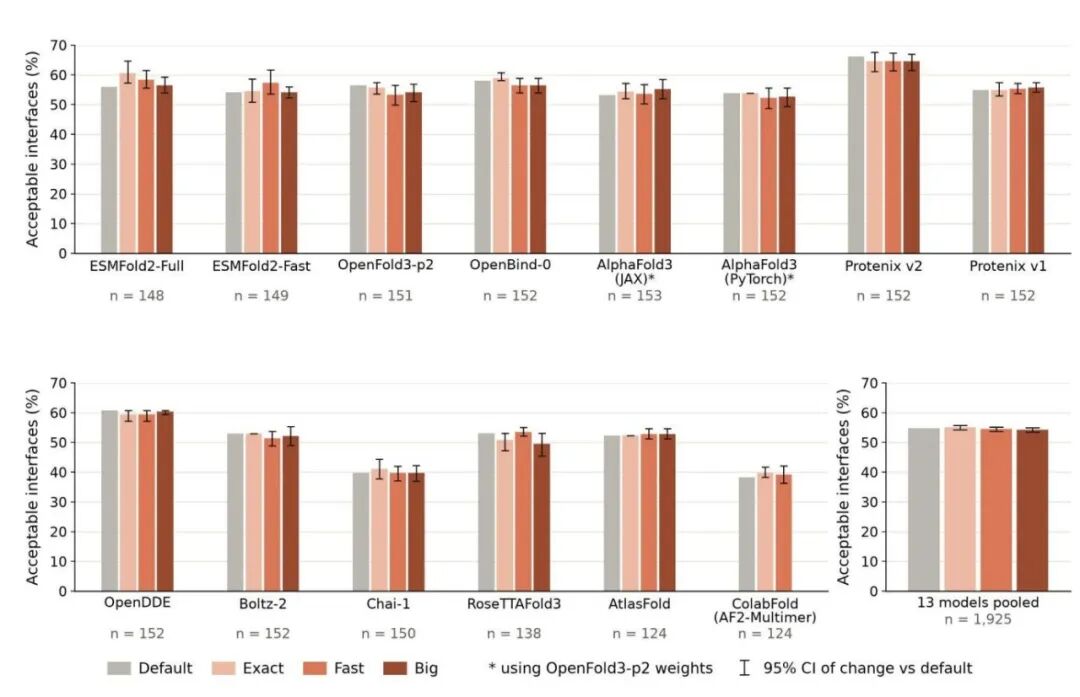
这里的优化目标并不是重新训练这些专业模型,也不是让 Claude 代替 AlphaFold 类模型直接做所有结构预测,是需要 Claude 修改已有模型的底层实现、推理流程和资源使用方式。
同一个结构预测或蛋白设计模型,在核心能力基本不变的情况下,可以更快完成推理,并减少 GPU 和显存消耗。
单节点开始跑更大分子系统
速度之外,Anthropic 还让 Claude 继续解决另一个限制:显存。很多大型分子机器都由几十个不同组件组成,比如负责合成蛋白质的核糖体、参与细胞供能的呼吸链复合物,以及帮助其他蛋白完成折叠的伴侣蛋白复合物。
这类系统的结构预测不仅输入规模大,不同组件之间还存在大量相互作用。此前,要预测这样的大型系统,往往需要把任务拆到多个 GPU 节点上完成。
Claude 为此开发了一个低显存的 “Big” mode。 Anthropic 结果显示,Big mode 可以在单个 NVIDIA GPU 节点上准确预测超过 1 万 Token 的生物分子系统,并让超过 7 万 Token 的系统成功完成推理。这里的 Token 包括氨基酸、核苷酸,以及小分子和离子中的原子。
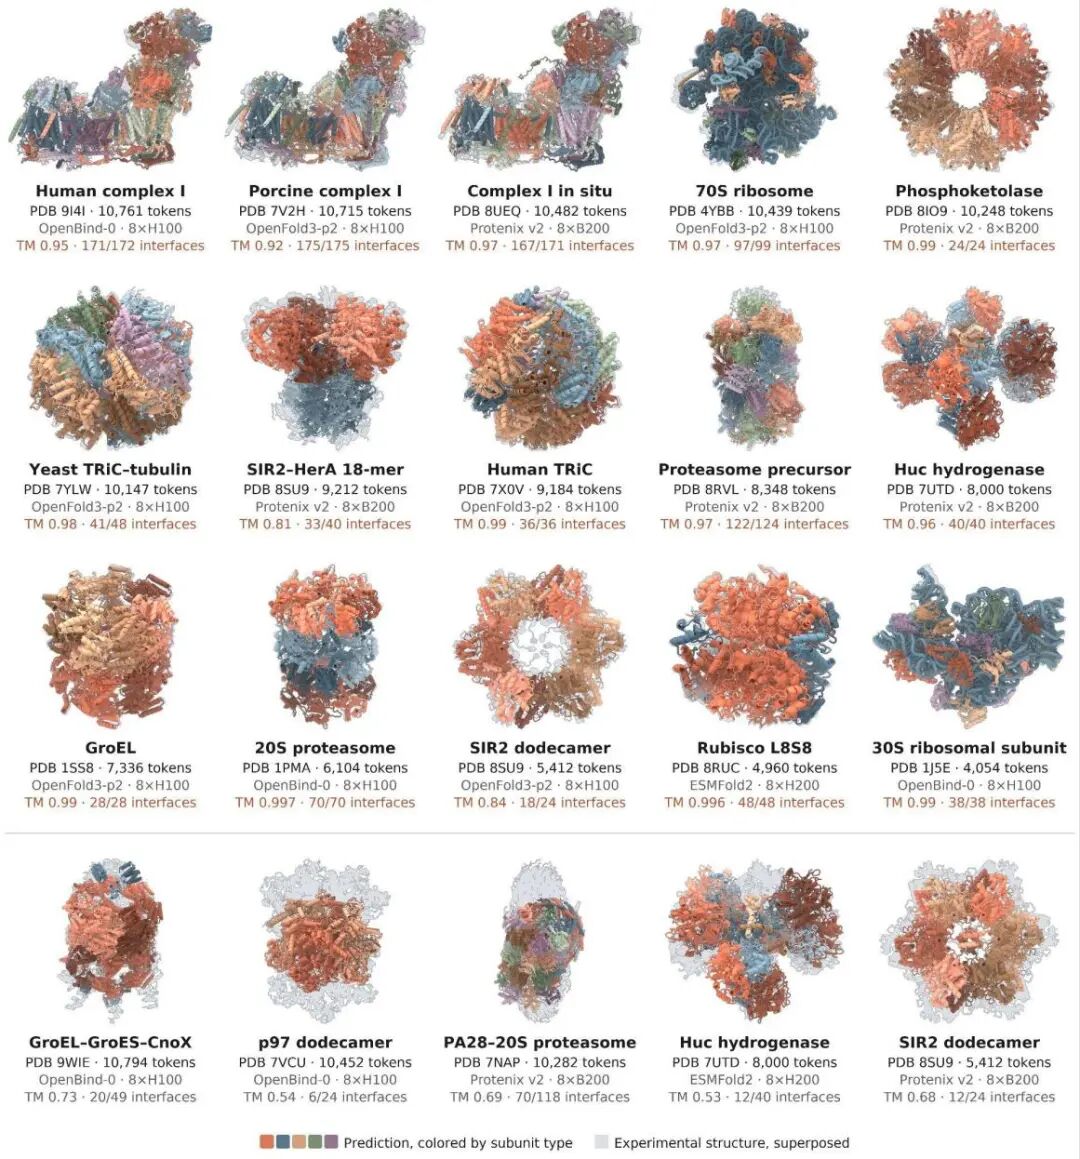
Anthropic 测试的对象包括人类线粒体复合物 I、TRiC 伴侣蛋白复合物、蛋白酶体和细菌核糖体。
其中,人类线粒体复合物 I 和 70S 核糖体的规模都超过 1 万 Token,预测结果与实验测得的结构较为接近。作为对比,AlphaFold3 此前准确预测的 40S 核糖体规模为 7663 个 Token。
但系统能跑起来,并不代表模型已经能够正确预测任意规模的分子结构。Anthropic 随后继续把规模往上推。在单个 8-GPU B300 节点上,Claude 对完整病毒衣壳和蛋白质区室进行了推理,输入规模从超过 3.1 万 Token 一直到超过 7 万 Token。
这些系统的规模已经接近相关结构预测模型训练上下文的两个数量级之外。模型能够完成计算,但最终预测出的结构发生了坍缩,并不正确。
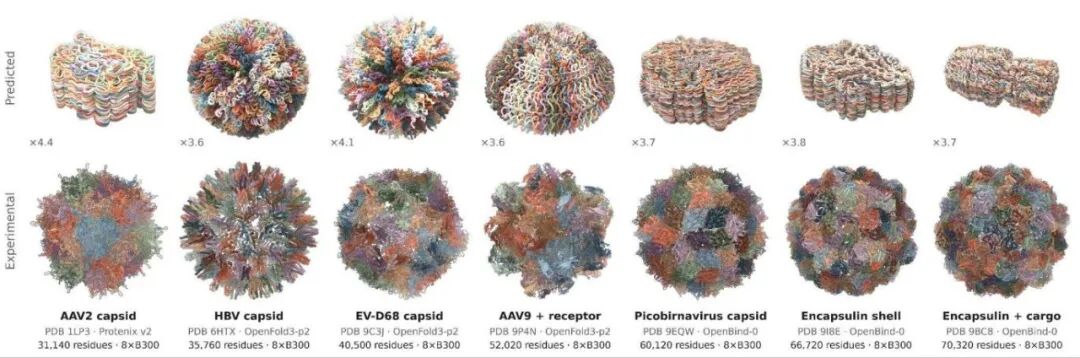
因此,这部分结果证明的是推理资源门槛已经下降,而不是结构预测模型已经具备了对 7 万 Token 生物系统的可靠预测能力。
蛋白设计成本降到约150美元
完成模型优化后,Anthropic 又重新跑了一次此前的 de novo protein binder 设计流程。两次实验使用的资源差距很大。此前的实验中,Claude 获得了一份约 1.6 万词的 Prompt,可以调用 sub-agent,并允许每个靶点在 24 小时内消耗最多约 1 万美元算力,相当于约 2500 个 NVIDIA H100 GPU 小时。
这一次,Anthropic 把条件压缩到单个 Claude 模型、一张 NVIDIA H200、24 小时时间,以及一份约 1100 词的 Prompt。
同时取消 sub-agent,也没有人在实验过程中干预具体蛋白设计,只向 Claude 提供已经安装好的工具和对应参考说明。
Anthropic 分别使用 Mythos 5.1、Mythos 5 和 Opus 5,对 16 个靶点进行了测试,并让 Claude 调用此前已经优化过的生物计算模型完成设计。
测试使用 ipSAE 作为 in silico binding score。这个指标此前被用于评估蛋白设计结果与实际湿实验结合能力之间的相关性。
在 16 个靶点上,三个 Claude 模型生成结果的中位数和最高 ipSAE,与此前 Mythos 5.1 实验大致相当。区别在于,这一次消耗的 GPU 小时数减少了大约两个数量级。 Anthropic 的数据统计显示,如果把 GPU 和 Claude Token 成本放在一起,约 150 美元的总支出,可以达到此前高算力实验相近的 in silico 表现。
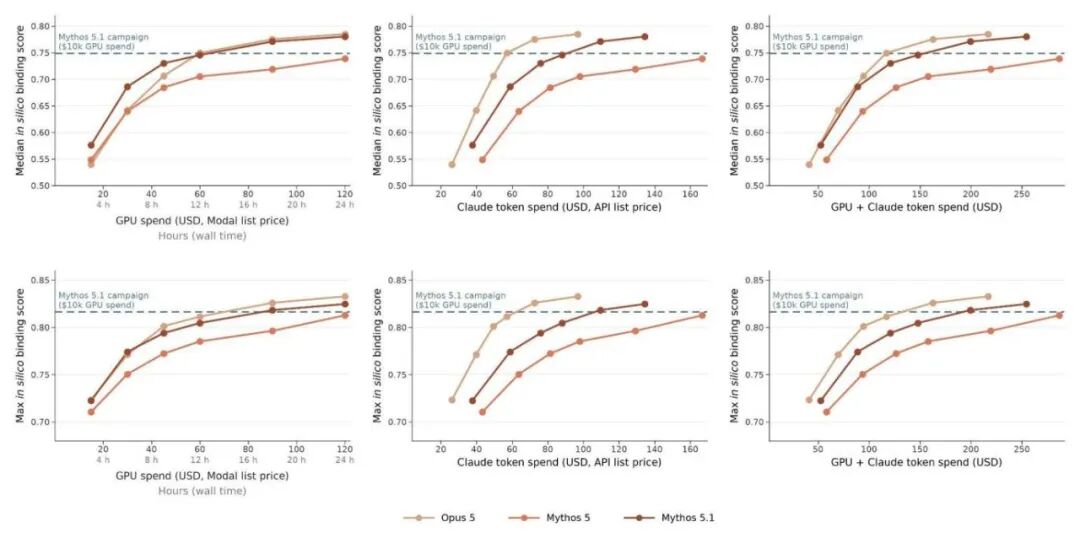
这里的 150 美元并不是一套蛋白从设计到湿实验验证的完整成本,也不包括后续实验环节。Anthropic 这次给出的是 Claude 调用这些优化后模型完成计算设计时,GPU 与 Token 的合计支出。
此前 Anthropic 展示的重点更多是 Claude 如何调用蛋白设计和结构预测工具完成科研任务。这一次,它开始直接参与这些专业模型的 kernel、推理代码和显存使用优化,再调用优化后的模型完成蛋白设计。
目前,这批 30 多个开源模型的优化代码已经由 Anthropic 对外开放。
代码链接:
https://github.com/anthropics/uplifting-biomolecular-modeling
技术报告:
https://www-cdn.anthropic.com/c03643714397d9d396fa1ce1794f5f9f7863a82c.pdf
本文由人人都是产品经理作者【有新Newin】,微信公众号:【有新Newin】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供


- 目前还没评论,等你发挥!