起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
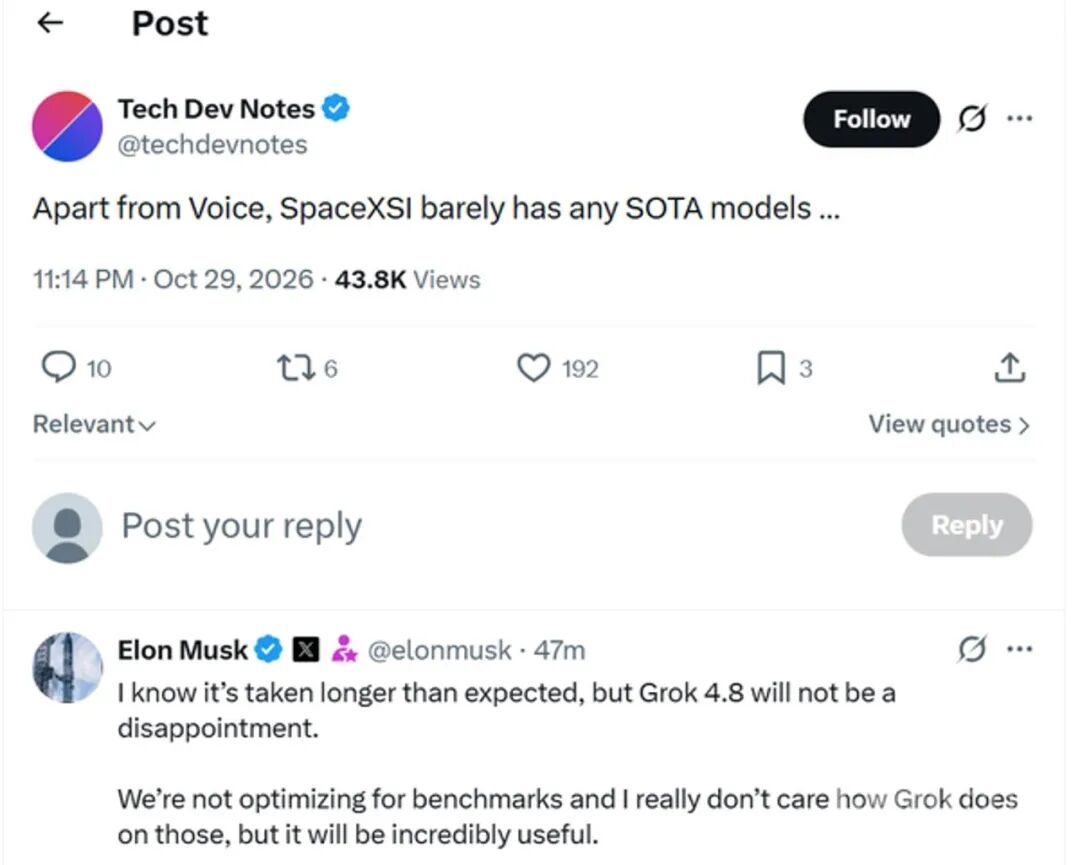
马斯克:Grok 4.8不会让人失望 我真的不在意跑分


马斯克在 X 上回应 Grok 4.8 延期:比预期久,但不会让人失望,而且真的不在意跑分。文章顺着这条回复梳理发布时间线,复盘已经落地的语音与 Agent 能力,并给出不看跑分时的验收思路。
模型发布越来越像一场倒计时:参数量、上下文窗口、Benchmark 分数和发布日期先被反复讨论,真正能不能把一项工作做完,反而要等模型进入真实环境后才知道。
10 月 30 日,马斯克回应 Grok 4.8 延迟发布时说,这个模型不会让人失望,而他并不在意跑分,更在意模型能不能解决真实问题。现阶段 Grok 4.8 仍没有正式发布时间和公开 Benchmark,网络流传的参数规模、训练栈和后续强化学习计划也都只能作为待确认信息观察。
这件事对开发者的价值,不在于提前猜中一个模型的分数,而在于重新审视 Agent 应该怎样验收:任务是否完成、工具调用是否可靠、失败后能否恢复、成本是否可控,这些指标往往比榜单上的一个数字更接近生产结果。
Grok 4.8还没发布,为什么讨论已经开始了
目前流传的说法是,Grok 4.8 可能拥有约 2.5 万亿参数,采用 SpaceXSI 新 C++ 技术栈,完成预训练后进入强化学习阶段。但这些信息没有对应的正式发布时间,也没有公开可复现的评测结果,不能写成已经上线的产品能力。
开发团队如果现在就开始围绕“4.8 肯定更强”改造系统,风险很高。模型名称、接口、上下文限制、工具协议和价格都可能在正式发布前变化。更稳妥的做法是先把业务任务抽象成可替换的模型调用层,再用固定数据集和固定工具权限等待真实版本。
可以把模型能力拆成四个维度:
| 维度 | 要验证的问题 | 适合记录的指标 |
|---|---|---|
| 任务完成 | 需求是否真正交付,而不是只生成一段看似合理的回答 | 端到端成功率、人工返工率 |
| 工具使用 | 是否能正确选择搜索、代码、数据库或浏览器工具 | 工具调用成功率、无效调用次数 |
| 长程执行 | 多轮任务中是否保持目标、上下文和中间状态 | 任务耗时、状态丢失率、恢复成功率 |
| 运行成本 | 低价模型是否因重试和返工变得更贵 | Token、重试次数、单任务总成本 |
先看已经落地的Grok产品路线
比尚未发布的 Grok 4.8 更适合拿来验证工作流的,是已经公开的产品线。Grok 4.7 于 9 月 21 日发布,面向编程、Agent 和知识工作,支持 500K 上下文,并针对长时间复杂任务进行优化。
500K 上下文不等于 Agent 可以无成本地吞下整个代码仓库。上下文越大,越需要控制输入内容的质量:仓库索引、变更记录、测试结果和任务状态应该分层保存,只有与当前决策相关的内容才进入模型窗口。否则,长上下文会变成昂贵的噪声容器。
Grok Voice 3.0 于 10 月 14 日发布,支持语音到语音交互,开发者可以通过 API 接入。语音入口看起来和编程关系不大,但它会把 Agent 的交互边界从聊天框扩展到会议、客服、移动端和现场操作。接入这类能力时,音频转写、意图确认和外部动作必须分开,不能因为模型听懂了一句话就直接执行高风险操作。
Grok Bot、图像生成和视频生成也在持续推进。产品形态变多之后,开发者更需要关注统一的身份、权限和任务状态,而不是把每种模态当成一套孤立的 Demo。
不看跑分,Agent应该怎样验收
“不在意跑分”不代表不做评测,而是把评测从单一榜单扩展到完整任务链。一个模型在知识问答榜单上领先,并不能证明它能在真实仓库里完成跨文件重构;一个代码生成分数很高,也不能证明它能安全地修改生产配置。
建议为每类任务准备最小可复现样本,并固定以下条件:
- 固定仓库版本、输入材料和验收标准,避免每轮测试题目发生变化。
- 固定工具权限,明确模型能读哪些目录、执行哪些命令、访问哪些网络地址。
- 记录完整轨迹,包括提示词、上下文摘要、工具调用、失败原因和最终变更。
- 把人工返工纳入结果,不能只统计模型是否输出了答案。
- 对高风险动作增加回滚测试,验证任务失败后能否恢复到可用状态。
对于代码 Agent,可以用下面的方式计算单任务价值:
任务净收益 = 节省的开发时间 – 模型调用成本 – 失败重试成本 – 人工审查与返工成本 – 回滚和事故处理成本
如果一个模型每次输出都很快,却需要开发者重新检查大量无效补丁,它的真实效率可能并不高。相反,一个延迟稍高、但能稳定完成测试和说明变更原因的模型,往往更适合放进持续交付流程。
把“解决真实问题”落实成工程约束
模型能否解决真实问题,最终要落在任务编排和系统边界上。建议把 Agent 拆成四层:
- 规划层:把自然语言目标拆成可检查的子任务,并声明完成条件。
- 执行层:通过工具读取文件、运行测试、调用 API 或修改代码。
- 观测层:记录状态、成本、工具结果和异常,不让关键信息只存在于上下文里。
- 治理层:控制权限、网络、密钥、预算、审批和回滚。
尤其是长时间任务,必须设计中间检查点。每完成一组变更就保存 diff、测试结果和任务摘要;模型发生上下文切换或服务重试时,从检查点恢复,而不是重新猜测已经做过什么。
如果 Agent 可以操作仓库,至少应限制三类风险:工作区之外的写入、未经批准的网络访问、无法撤销的外部副作用。权限策略可以按任务分级:临时目录允许自动清理,生产配置要求人工确认,发送通知或变更数据库则必须经过独立审批。
Grok适合怎样接入开发流程
现阶段可以把 Grok 4.7 或已开放的 Grok API 放在低风险、高频的工作中,例如代码解释、测试草稿、日志归类、文档问答和受限仓库内的修复建议。涉及生产发布、凭证、数据库和外部消息时,应先让模型生成计划,再由权限网关决定是否执行。
Grok 4.8 尚未公布正式定价和完整接口,不能提前把它写进固定供应商承诺。等正式版本可用后,建议用同一批真实任务与现有模型对比,重点记录首轮通过率、工具调用次数、上下文消耗、平均延迟和人工接管率。
国内开发者如果需要将 Claude Code 等工具接入兼容 API,可通过 Code80(https://code.ai80.vip/home) 配置 endpoint;模型权限、密钥隔离和生产审计仍应由项目侧管理。
常见问题
Grok 4.8什么时候发布?
目前没有正式发布时间。参数规模、技术栈和强化学习计划属于待确认信息,应该等 xAI 的正式公告和接口文档。
Grok 4.8的跑分现在能信吗?
没有公开、可复现的官方 Benchmark 前,任何具体分数都不适合当作产品结论。即便未来有跑分,也需要结合真实任务成功率和成本判断。
500K上下文是不是越大越好?
不是。上下文容量解决的是“能放多少”,不自动解决“应该放什么”。工程上仍需要索引、摘要、状态持久化和输入裁剪。
语音Agent可以直接执行操作吗?
不建议。语音识别、意图确认和工具执行应分层,涉及付款、删除、发布和消息发送的动作必须增加确认或审批。
如何测试模型是否适合代码Agent?
使用固定仓库和固定任务,记录测试通过率、工具调用、耗时、Token、返工和回滚次数,再按任务风险决定是否放大权限。
国内开发者怎样接入兼容 API?
可以通过 Code80 了解兼容 API 接入方式,同时把密钥、权限、数据保留和审计控制放在自己的工程环境中。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!