起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
「工作大脑」的底层基座:产品经理 AI 工作区搭建指南


AI 已经能超越人类,前提是给它完整的上下文——但这件事比想象中难。一个 10 年产品经理把工作大脑拆成知识库、工作流、复盘三大模块,做成开源项目 PMCockpit,用本地文件夹和 AGENTS.md 让 AI 真正读懂你的项目。本文先讲最核心的知识库搭建:三层目录、索引规则、Git 兜底,不碰向量数据库也能让 AI 拥有持续上下文。
如果把问题说得很清楚、给足上下文和指令,AI 已经超过人类——但”给它完整的上下文和指令”这个前提很难达到。——梁文锋四小时会议
之前发布过一篇《搭建自进化的”工作大脑”》,聊作为一个10年产品经理,是如何把产品工作托管给 AI。发完之后,私信里问得最多的还是:
思路能明白,但这套东西到底怎么落地?
我这套方法也是不停地利用AI在大家自己的第二大脑、完成日程工作的过程中,不断让AI帮助我复盘总结出来的。和本地环境的耦合度极高。我在给我的产品助理部署的时候,也遇到了环境不适配、记忆错乱、文件找不到的问题。
所以这段时间以来,我不急着分享别的东西。执着于把现有的工作大脑,分模块、做解耦:
- 知识库。指定本地文件夹,让Codex、workbuddy等桌面智能体的【工作区】机制将所有项目的上下文管理起来,实现AI灵活调用和人工本地维护共存,通过git备份。
- 工作流。提炼出日常工作用到的项目文档/会议纪要入库、需求文档、原型设计、迭代管理等技能(Skill)提炼出来。和技能强相关的模板库、规则库都集成到技能包中,不和知识库混同。根据实际情况来执行场景灵活组合执行。
- 复盘。完善复盘(Skill),能够扫描会话,分析本次工作执行遇到的问题,再从知识库、技能、通用规则文档等规则文档提出具体建议。
我把这套做成了开源项目,叫 PMCockpit。已经适配了 Codex、ZCode、Claude Code、WorkBuddy等本地智能体。
接下来我会继续把知识库、工作流和复盘拆透,让大家能理解、用好这套工具。这篇先讲知识库。
搭建并维护好自己的 AI 知识库,就是解决怎么让 AI 持续拥有完整上下文,并自主维护和补充的问题。
但很多人被”知识库”这三个字吓退了。一搜,向量数据库、RAG、embedding 模型扑面而来。做产品的人看了直接关页面。
其实,让 AI 拥有上下文,不需要数据库。
利用好Codex、Workbuddy等支持工作区能力的本地智能体,通过本地文件夹就能实现类似的效果。
下面我把整个原理拆成几步,你可以照着搭。
第一步:在指定工作区,建一个目录框架
有了Claude Code、Codex和Workbuddy等AI桌面智能体工具后,AI知识库可以是你电脑里的一个文件夹。
你要做的,是根据自己的工作需要,让AI给这个文件夹定一套分区规则——什么放哪,什么不放。
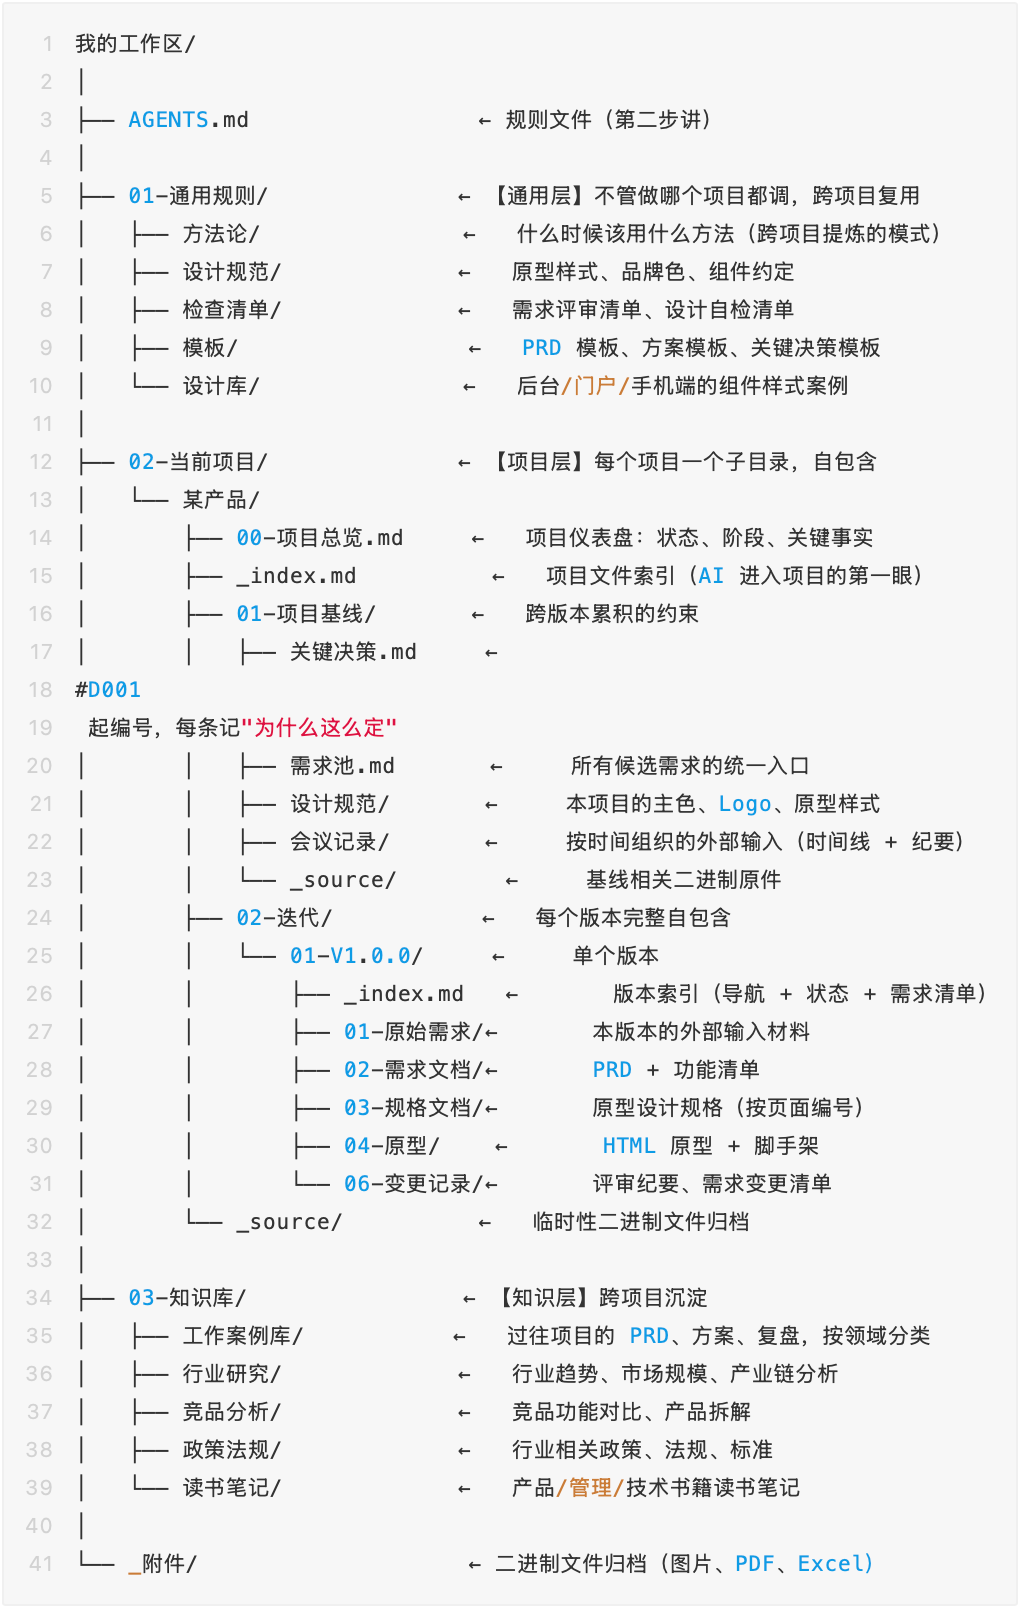
我的目录分工是三层。
- 通用层,放不管做哪个项目都用得上的东西。方法论、模板、设计规范、检查清单。这是底层功力。
- 项目层,每个项目一个独立子目录。这个项目的需求、原型、会议纪要、过程文件,全部存在里面。这是当前战场。
- 知识层,放跨项目沉淀的东西。历史案例、竞品分析、行业研究、政策法规。这是弹药库。
结构大致长这样:
为什么要分三层?
因为三层混在一起,AI 就分不清什么是永久约束、什么是一次性产物。
你把合同条款和某次评审的临时备注放一个文件夹,AI 读的时候权重一样,输出就会打架——它可能拿一条临时备注当设计规范,也可能忽略一条真正的约束。
知识库烂,通常不是文件太少,是分层不清。
项目内部也分两层:基线和迭代。跨版本复用的东西(关键决策、设计规范)放基线,用完就过的东西(这版的需求文档)放迭代。
所有二进制文件入库的时候,优先转化成markdown格式的文档,节省后续的token消耗量。
第二步:建立规则、索引和git同步,让 AI 看懂知识库
目录建好了,你以为 AI 天然就知道往哪放文件?
不是。
你把一份会议纪要丢给它,它可能给你扔进需求文档里。你让它写 PRD,它不知道该参考哪个目录的模板。你问它上次评审改了什么,它一脸茫然。
问题不在 AI 笨,在于你从没告诉它”这个目录是干什么的,每个文件夹是做什么的,文件如何归档”。
解法是让AI写一份 AGENTS.md 的文件,放在工作区根目录。
工作区规则 AGENTS.md
大多数 AI 工具——ZCode、Claude Code、WorkBuddy——使用工作区的时候,会自动读这个文件。它就是 AI 进入你工作区的入职手册。
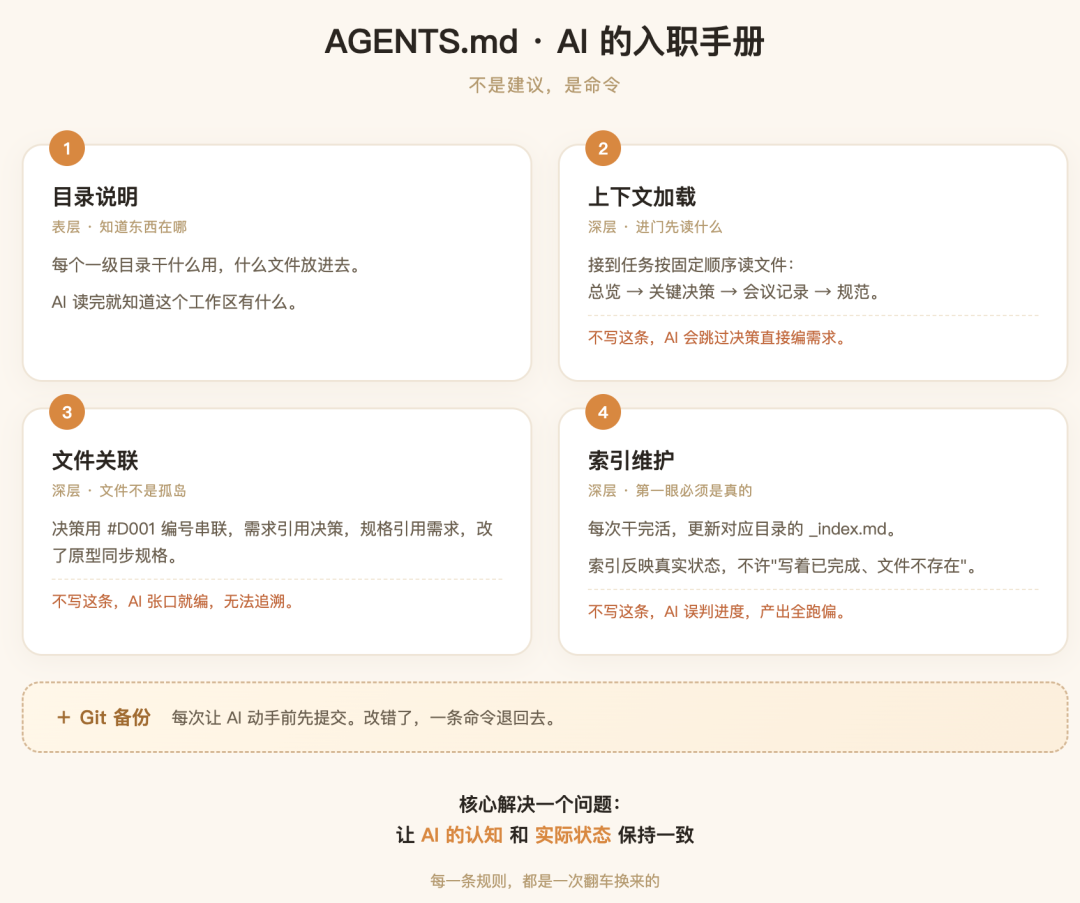
这份文件里至少写三件事。
第一,目录说明。每个一级目录是干什么的,什么文件该放进去。
第二,工作流程。什么阶段做什么事,该调哪个目录的资产,使用哪些skill。
第三,文档纪律。生成文档时要遵守的硬约束,比如”从源文档抽取列表不许丢项”。
截一段我的 AGENTS.md :
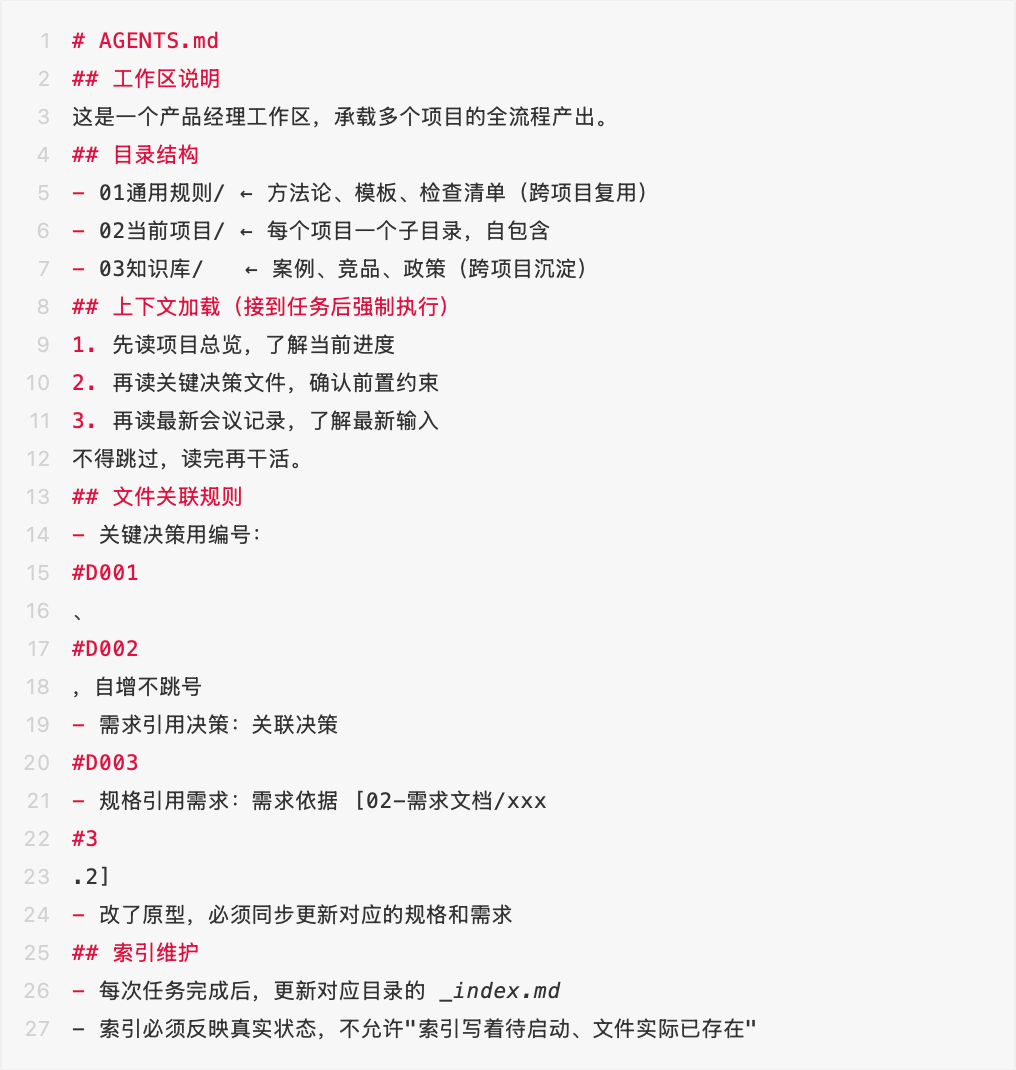
你看,这里面有四块。目录说明是基础,让 AI 知道东西在哪。但真正让这套体系转起来的,是后面三块。
- 上下文加载,规定 AI 接到任务先读什么。不写这条,AI 会跳过读关键决策,直接凭自己的理解编需求。写了,它就得先读完再动手。
- 文件关联规则,让文件之间不是孤岛。关键决策用编号串起来,需求引用决策,规格引用需求,原型改了同步规格。这样你问 AI”这个功能为什么这么设计的”,它能沿着引用链一路追溯回去,而不是张口就编。
- 索引维护,让 AI 进来的第一眼永远是真的。索引写着”需求已完成”,打开一看文件不存在,AI 就会误判进度,后面全跑偏。所以每次干完活,必须顺手更新索引。
你看,这三块解决的是同一个问题:让 AI 的认知和实际状态保持一致。读到的索引是真的,文件之间的关联是通的,上下文是完整的。做到这三点,AI 就不会瞎编。
索引 _index.md + YAML
AI 怎么知道一个目录里有哪些文件?靠索引。
每个关键目录放一份 `_index.md`,列出这里有什么、各自什么状态。AI 进来第一眼读索引,不用扫描所有文件。提升查询速度的同时,节省了大量token。
索引是 AI 的第一眼。索引失真,AI 就会误判进度,产出全跑偏。
现在我还会再加一层文件级索引:在每一份md文档开头写 YAML Front Matter(YAML 前置元数据)。这是 Markdown 文件头部一段可被程序读取的结构化信息。
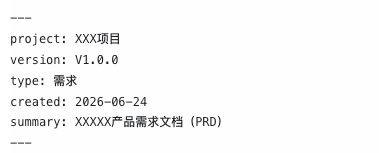
它必须放在文件最开头,并用两行 `—` 包住。目录索引告诉 AI“去哪里找”,YAML Front Matter 告诉它“眼前这份文件是什么”。
AI 先读 YAML Front Matter,就能知道项目归属、版本、文档类型和核心内容,再决定要不要继续读正文。文件多起来以后,这比只看文件名可靠得多。
用 Git 备份兜底
还有一件事,搭知识库时就得一起配上:版本管理与备份。
AI 是直接改你文件的。即使能靠记忆恢复,但还是有无法复原的风险。
所以你必须有退路。退路就是 Git。
Git 不复杂,你只需要会四个操作:提交(commit)、推送(push)、拉取(pull)、回退(checkout)。不会的话,让AI教你就行,这是跟 AI 协作的保命技能。
核心习惯就一个:每次让 AI 动手之前,先提交一次。
提交就像存档。AI 改完,你检查一遍。改对了,再提交一次。改错了,一条命令退回去,什么都没丢。
如果你用 GitHub 或 Gitee 做远程仓库,再配一个推送(push),就有了一份云端备份。电脑坏了、文件误删,都能恢复。
没有 Git 兜底,你不敢放手让 AI 改。不敢放手,这套知识库就白搭了。
第三步:结合日常使用+复盘
前两步搭完,日常用 AI 的方式跟以前几乎一样——正常说话。
区别在于,AI 现在知道你的文件在哪、每个文件是干什么的。
你说”看一下XX项目 V1.0 的需求文档”,它直接定位,不用你翻路径。
几个典型场景。
- 找东西。“上次XX项目的甲方评审提的修改意见在哪”,它去变更记录里翻。
- 写东西。“帮我写给XX项目的XX页面的规格”,它先读设计规范和关键决策,再动笔。
- 入库东西。“这份会议纪要整理一下”,它自动转格式、提炼决策、更新索引、归位。
因为 PM 的工作场景天然是结构化的。你的文件已经有明确归属——哪个项目、哪个版本、哪个目录。AI 顺着你定的结构走就行。
你找的从来不是”语义相似的内容”,是”某个项目的某个文件”。
具体工作流实践我在下个文章里详细描述。
别的知识库方案
有同事问我,为什么不直接上向量数据库?这类方法搜索快速而全面,也适配AI。由此有研究了下市面上主流的AI知识库的搭建方法。
先做个对照,市面上搭 AI 知识库主要有三类思路:
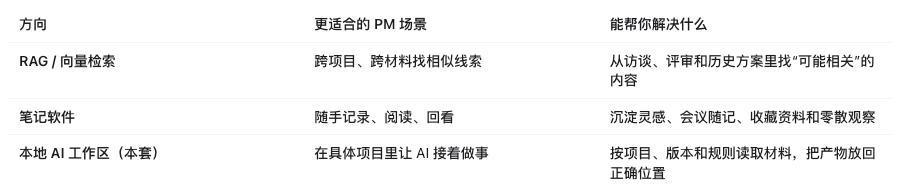
不是说前面两种不好,是场景不同。笔记软件适合”读和记”,向量库适合”搜”,我这套适合”让 AI 按结构干活”。
这套的优势:
- 人能读。文件结构你能看懂、能手动改,git 能追踪每次变更。黑盒不存在。
- AI 能直接调。文件在本地,AI 工具直接读,不经过第三方平台。
劣势也有:
- 不能做模糊语义检索。你问”跟这个类似的设计方案有哪些”,它不如向量库准。它是按结构定位,不是按语义匹配。
- 文件量大了索引要维护。几百个文件以上,需要消耗token建立索引。
- 需定期复盘校准。维护量比较大,需要不停的根据实际工作结果不断复盘校准知识库的规则体系。
但对于中轻量个人工作,这套也够用了。
总结
总结一下,就三步:建目录,写规则,日常用。
下一篇以从需求、规格、原型、交付等完整工作流程为例,讲下我的需求知识库和我的产品工作流如何结合使用。
本文由 @青燃说 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议


- 目前还没评论,等你发挥!