起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
减少AI视频抽卡的7种3D预演技术,从人物走位到镜头调度一次讲透


AI视频生成反复抽卡,根因不在模型,而在自然语言描述空间时天然存在歧义。本文提出DZS-空间预演协议,用三维坐标替代模糊方位词,并详解7种预演技术与五步工作流,帮助创作者从“抽卡赌徒”转变为掌控镜头的“空间导演”。
AI视频生成最让人崩溃的场景,不是模型能力不够,而是提示词写了一大段,生成结果和脑子里想的完全不是一回事。
人物从左边出来,模型让他从右边进来;镜头想拍侧面特写,模型给了一个正面全景。反复抽卡,反复修改提示词,最后发现改来改去还是在碰运气。
问题的根子不在模型,在语言本身。
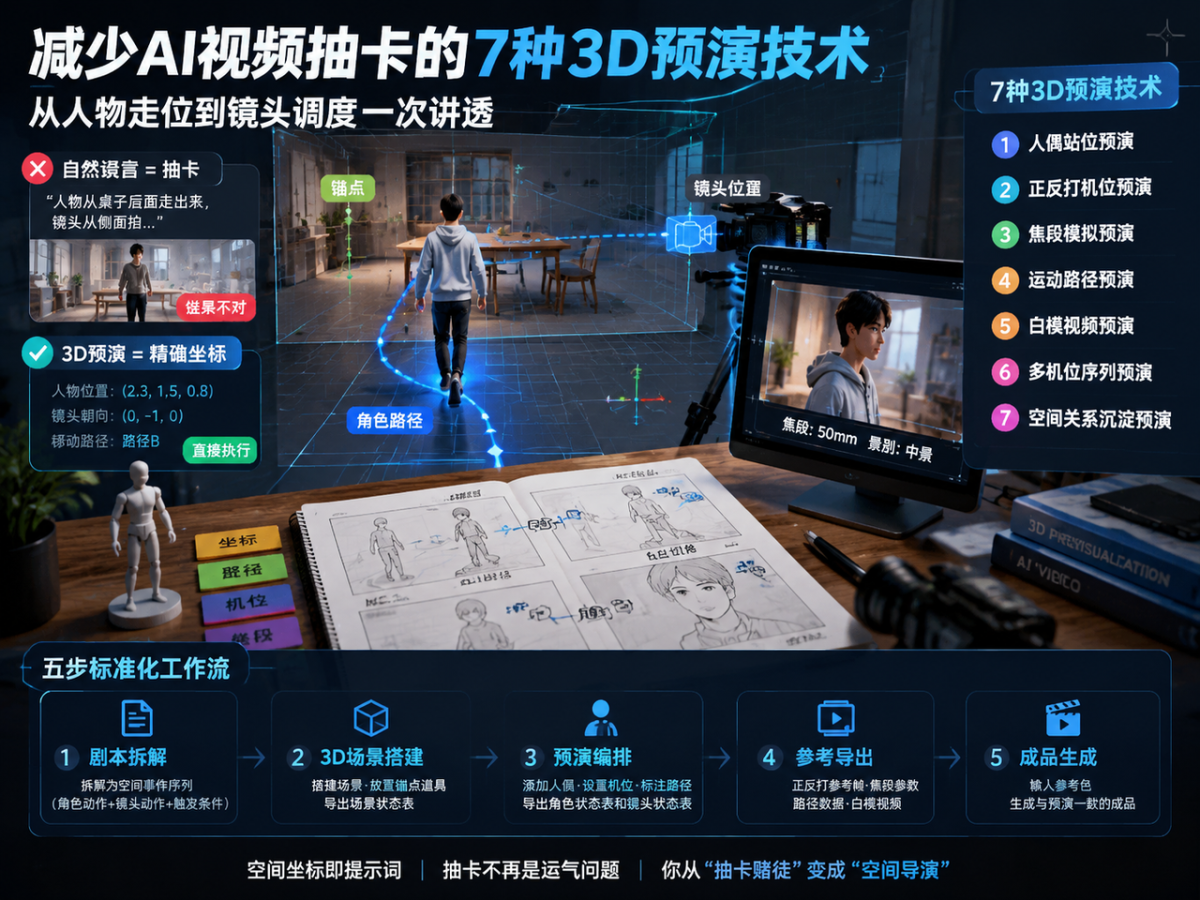
自然语言描述空间关系,天然存在拓扑歧义。“人物从桌子后面走出来”——桌子后面是哪个坐标?是相对于镜头还是相对于桌子?“镜头从侧面拍”——侧面是左侧面还是右侧面?是平视还是俯视?这些信息在自然语言里全是模糊的。
模型每次生成,都是在这些模糊空间里随机采样。采样一次不对,再采一次,还是不对。
这不是模型的问题,是沟通协议的问题。用模糊的语言描述精确的空间,结果必然是抽卡。
核心认知:空间坐标即提示词
3D预演的价值,不在于它是个“辅助工具”,而在于它是一种精确沟通协议。
三维空间里,人物的位置是一个坐标点,镜头的朝向是一个向量,人物的移动是一条路径曲线。这些数据没有歧义。
比如:坐标(2.3, 1.5, 0.8)就是那个点,镜头朝向(0, -1, 0)就是正对前方。模型拿到这些数据,不需要猜,直接执行。
所以3D预演的本质,是用三维空间数据替代自然语言的空间描述。把“人物从桌子后面走出来”翻译成“人物从坐标A沿路径B移动到坐标C,镜头从坐标D以朝向E拍摄”。歧义消除了,抽卡自然减少。
这个认知一旦建立,3D预演就不再是某个软件的功能,而是一种可以跨工具、跨平台复用的方法论。
三个全新知识域
空间锚点:在场景中选取若干固定参考点,用坐标锁定人物、道具、镜头的相对位置。锚点一旦确定,所有空间描述都基于锚点展开,不再依赖“左中右”“前后”这类相对模糊的方位词。
视觉语法对齐:白模预演视频和最终成品视频之间,存在一套映射逻辑。白模里的人物走位、镜头运动、景别变化,对应到成品里是什么效果,需要建立一套视觉语法规则。这套规则一旦对齐,白模预演就能准确预测成品走向。
运动轨迹编码:把“人物怎么走”翻译成可执行的路径数据。是直线还是曲线?是匀速还是变速?在哪个坐标点转向?这些信息用轨迹线标注出来,就是给模型的最精确指令。
DZS-空间预演协议
这个框架的设计逻辑是:把剧本拆解为空间事件序列,逐事件生成预演指令,并在多轮对话中持续维护空间状态的一致性。
DZS-空间预演协议
【场景状态表】
场景ID:
空间边界:(x_min, x_max, y_min, y_max, z_min, z_max)
固定锚点:
A1: 坐标(_,_,_) 描述___
A2: 坐标(_,_,_) 描述___
A3: 坐标(_,_,_) 描述___
道具清单:
P1: 坐标(_,_,_) 尺寸___ 描述___
P2: 坐标(_,_,_) 尺寸___ 描述___
【角色状态表】
角色ID:
当前位置:(_,_,_)
朝向向量:(_,_,_)
移动路径:从(_,_,_)经(_,_,_)到(_,_,_)
路径类型:直线/曲线/折线
速度模式:匀速/加速/减速
【镜头状态表】
镜头ID:
当前位置:(_,_,_)
朝向向量:(_,_,_)
焦段:__mm
景别:远景/全景/中景/近景/特写
运动模式:固定/推/拉/摇/移/跟
【事件序列】
事件1:
触发条件:___
角色动作:___
镜头动作:___
输出指令:___
事件2:
触发条件:___
角色动作:___
镜头动作:___
输出指令:___
【冲突仲裁规则】
当角色路径与道具位置冲突时:优先调整角色路径
当镜头运动与空间边界冲突时:优先调整镜头位置
当多个事件时间重叠时:按事件优先级排序
【降级策略】
当3D预演不可用时:降级为多角度参考图+坐标标注
当白模视频生成失败时:降级为关键帧序列+运动箭头标注
【输出校验】
生成前检查:角色位置是否在空间边界内
生成中检查:镜头朝向是否指向角色
生成后检查:输出是否匹配事件序列描述
这个框架的复杂度在于:它维护了一个跨轮次的空间状态机,每次对话都在更新场景状态表、角色状态表和镜头状态表。冲突仲裁规则确保多事件并行时不会出现空间矛盾。降级策略保证即使3D工具不可用,也能退回到二维标注方案。
启用方式:将上述框架完整复制给AI,然后逐事件输入剧本内容。AI会根据框架中的状态表维护空间一致性,并逐事件输出预演指令。
7种3D预演技术详解
1. 人偶站位预演
在3D场景中添加人偶,放置在角色需要出现的位置。人偶的坐标就是角色的空间锚点。导出时记录人偶坐标,作为后续生成的参考。
2. 正反打机位预演
在场景中设置两个相对的机位,分别模拟正面和反面镜头。通过镜头管理切换视角,确认两个机位的画面构图。导出正反打参考帧,用于后续视频生成。
3. 焦段模拟预演
在机位确定后,手动拖动调整焦段。广角端确认环境关系,长焦端确认人物特写。记录每个镜头的焦段数值,作为生成时的精确参数。
4. 运动路径预演
用轨迹线标注人物的移动路线。直线移动标注起点和终点,曲线移动标注控制点。轨迹线导出的路径数据,直接对应生成时的运动指令。
5. 白模视频预演
用astra模型生成低精度动态参考。白模视频不追求画面质量,只追求动作、走位、空间关系的准确性。白模视频作为Seedance等模型的参考输入,能大幅提升成品与预演的一致性。
6. 多机位序列预演
在场景中设置多个机位,批量导出不同角度的参考帧。每个机位对应一个镜头,按事件序列排列。多机位序列导出后,就是一份完整的镜头脚本。
7. 空间关系沉淀预演
将3D资产、人偶坐标、机位数据、路径信息全部保存。这些数据不仅用于当前项目,还可以复用到后续同场景的创作中。空间关系一旦沉淀,后续生成不需要重新搭建。
五步标准化工作流
第一步:剧本拆解
把剧本拆解为空间事件序列。每个事件包含:角色动作、镜头动作、触发条件。事件序列确定后,后续所有工作都围绕它展开。
第二步:3D场景搭建
根据剧本搭建3D场景。放置固定锚点、道具、空间边界。场景搭建完成后,导出场景状态表。
第三步:预演编排
在场景中添加人偶,设置机位,标注路径。逐事件编排预演,确认每个事件的空间关系。预演编排完成后,导出角色状态表和镜头状态表。
第四步:参考导出
从预演中导出参考素材:正反打参考帧、焦段参数、路径数据、白模视频。参考素材按事件序列整理,形成完整的生成参考包。
第五步:成品生成
将参考包输入视频生成模型。模型根据参考包中的空间数据、路径数据、镜头数据生成成品。生成结果与预演一致,抽卡次数大幅减少。
抽卡的本质是沟通失败。
用模糊的语言描述精确的空间,模型只能猜。3D预演的价值,是把模糊的语言替换成精确的坐标。
7种预演技术,本质上是7种空间沟通协议。人偶站位锁定坐标,正反打锁定机位,焦段锁定景别,路径锁定运动,白模锁定动态,多机位锁定序列,空间沉淀锁定复用。每一种技术,都在消除一个维度的歧义。
当空间坐标成为提示词,抽卡就不再是运气问题。创作者从“抽卡赌徒”变成“空间导演”,每一个镜头都在掌控之中。
这套方法论不依赖特定工具。TapNow的3D片场可以用,其他3D软件也可以用。
核心认知一旦建立,工具只是实现手段。
本文由 @抖知书 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务


- 目前还没评论,等你发挥!