
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
新模型密集发布,该怎么选?分享我的实测感受


九月里OpenAI、Anthropic、Google接力发了五次新模型:GPT-6 Astra最贵也最强,Sol与Luna价格压到五分之一以下;Claude Opus 5.5的看点是写代码直接生成视频与3D,建议按任务出错代价选型。
选错模型,有时比不用更麻烦。
国庆节前,有用户在群里问我:「刀哥,最近我看国外新模型怎么发布这么多,你能聊聊这个吗?」
确实,整个9月就是新模型的密集发布期。说实话,我也跟得气喘吁吁。每款新模型出来,我都要拿一些自己常用的问题去试试看。
结果最后我发现,最苦恼的是,靠我自己的能力已经分辨不出哪个模型的答案最厉害了,感觉各有千秋。
我先跟你掰着指头数一数,光传统上的AI御三家都发布了哪些新模型:
9月3日,OpenAI发布新一代旗舰GPT-6 Astra,综合能力目前最强。
19天后,9月22日,OpenAI又发了两个:GPT-6 Sol和Luna,一个中端,一个轻量。同一天,Anthropic发布Claude Opus 5.5。
再过7天,9月29日,OpenAI在开发者大会上推出GPT-6.1 Sol,编程能力直追Astra,价格却只要自家旗舰模型的五分之一。
第二天,9月30日,Google发布Gemini 4 Argon。
一个月,五次发布,三家公司。上一个模型还没搞明白,下一个就来了。
我感觉这三家在玩「斗地主」:每个人都在出牌,但每个人手里都还捏着一个炸弹。你不出我就不出,你一出,我马上就跟上。
这期我就从几个实际问题来聊:这些模型各自强在哪,贵不贵,普通人用得上吗?
把它们放在一起看,也能看出几个正在影响我们怎么选、怎么用AI的趋势。
咱们先从最近非常活跃的OpenAI说起。
GPT-6 Astra是OpenAI的新一代旗舰,也是目前最强的通用模型之一,比上一代GPT-5在复杂推理和长上下文处理上都有明显提升。
但它也是最贵的,API价格是每百万token输入10美元、输出50美元。普通开发者用它做一次深度对话或者研究报告,花费就相当可观,很容易打爆账单。
它适合处理那些你没法自己验证结果、出错代价又很高的任务,比如复杂的代码架构设计、一份几十页合同的风险分析、多步骤的研究推演。
如果你的日常工作不需要这种精度,其实有更合适的选择。
并且这个模型,我自己用下来会发现,有时候你问一些简单的问题,它很容易把问题想复杂。这有点像我们上学时班里那种惹人讨厌的学霸:
拿到一张简单的卷子,或者发现最后一道大题很简单,他不会开心,而是紧皱着眉头说:「老师应该不会布置这么简单的题吧?我是不是想简单了?」
大模型有时就是这样。我可能只是想问问一加一等于几,它以为我在跟它讨论终极的哲学问题。
就在旗舰模型Astra发布19天后,OpenAI同一天推出Sol和Luna两个型号。
Sol是中端定位,大多数日常任务的表现接近Astra,但价格只有它的五分之一。Luna的价格就低得多了,输入0.1美元、输出0.5美元,比Astra便宜了整整100倍。
Luna适合那些需要大批量调用、对质量要求没那么高的场景,比如客服、摘要、分类这类重复性工作。
毕竟100倍的价差,适合做的事情当然不同。
不过,同样花Luna这个价位的钱,今天能买到的能力,一年前我觉得连全世界最好的模型都达不到这个水平。
同样是9月22日,Anthropic发布了Claude Opus 5.5。从我的体感上,如果只看文字对话能力,Opus 5.5和上一版Opus 5的差距不算特别大。
Anthropic自己说得很直白:Opus 5.5在多数工作上达到了自家Fable 5.1的水平,同时典型任务的运行成本比Opus 5低了大约40%。
不过,这个模型刚出来的时候,大家没有太关注。因为除了Opus 5之外,Anthropic旗下还有Fable这样之前断档领先的选择,它少了些让人眼前一亮的感觉。
让Opus 5.5在社交媒体上刷屏的,是另一种玩法:用纯代码直接生成视频和3D内容。
Opus 5.5自己写代码,代码运行出来就是视频和3D场景,过程中不需要调用视频生成模型。这样一来,语言模型也能做视觉创作了。
过去,「写代码」和「做视频」是两个完全不同的工种,现在同一个模型能把这两件事接起来做。
我看到不少博主就用这个模型来做广告片,质量非常高。而且这些人里,很多之前都不是传统的AI视频工作者。
其实这对很多人来说,是一次非常大的能力横向拓展。我觉得,这种底层能力的变化,可能比跑分的提升更值得关注。
紧接着,9月29日,OpenAI在开发者大会DevDay上发布了GPT-6.1 Sol。
要知道,距离Astra发布,只过了26天。GPT-6.1 Sol在编程能力上已经打平Astra,API价格是输入2美元、输出10美元,恰好是Astra的五分之一。
只过了26天,价格降到五分之一,编程能力就接近旗舰了。这两个数字放到一起,很能说明这一轮更新有多快,简直就是「我狠起来连自己都打」的真实写照。
9月30日,Google发布了Gemini 4 Argon,多项基准测试超过了Astra,输出上限更是提升到了100万token,理论上可以一次性输出一本书。
不过,Gemini 4 Argon目前只向少量合作伙伴开放,咱们普通用户暂时体验不到。
我觉得,Google是着急了,先把实力展示出来。免得就像很多经典的管理学案例一样:一个市场上,老大和老二打架,然后发现老三死了。
如果Google再不发布点新东西,它的模型相比OpenAI或者Anthropic,确实会让人感觉已经不是一个时代了。
不少同学可能还会好奇,那国内的情况怎么样?
同样在提速。Kimi K3、GLM-5.3、DeepSeek V4.1,最近几个月密集更新。在节前的云栖大会上,千问的一批模型也都全线更新,基本上都是更强、更便宜。
除了发布得更勤,哪些模型用得最多,也值得看看。
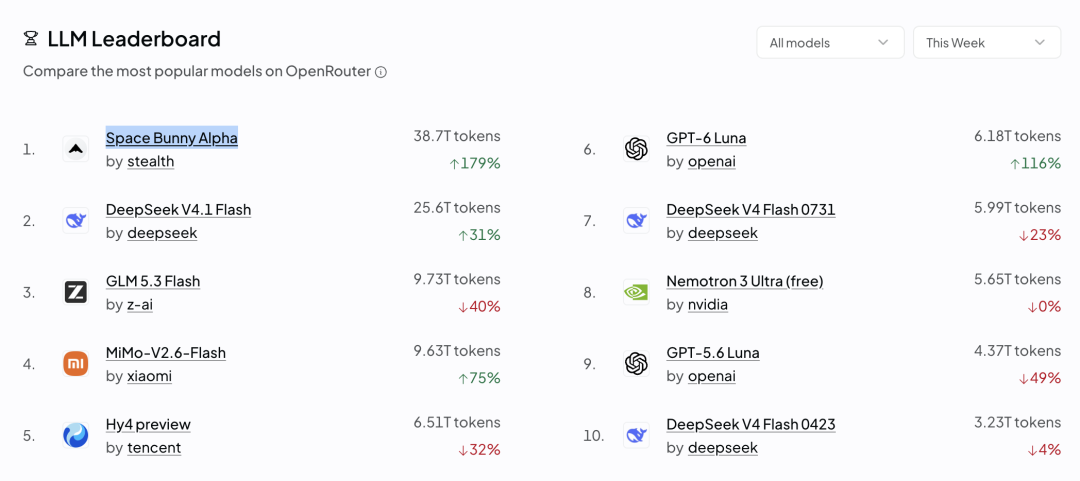
根据OpenRouter平台最新数据,全球周Token消耗量前四名,有三个都是咱们国内的轻量Flash类模型。
排第一的模型是个厂商匿名未公开的模型;DeepSeek V4.1 Flash排第二,一周消耗25.6万亿token;GLM 5.3 Flash排第三,9.63万亿;MiMo-V2.6-Flash排第四,9.63万亿。
前十名里,中国公司出的模型也占了大半。
当然,虽然很多都是国内模型,但不代表使用它们的都是国内用户。因为现在有非常多欧美初创企业,在日常业务场景中,直接使用咱们的轻量级开源模型。
用量跑在最前面的,反而是便宜的模型,旗舰模型排在了后面。就这,DeepSeek还推出了闲时半价策略,把本来就不高的价格再砍一半。
说到这里,9月这一轮密集发布,如果把前面这些模型放在一起看,至少能看出三个变化。
最直观、最显而易见的一条,是过去很贵的AI能力正在迅速降价。
要知道,2021年,GPT-3刚开放API的时候,每百万token收费60美元。到2026年,同等能力水平的模型,价格降到了0.06美元。五年,降了1000倍。
整个行业的价格都在往下走,这不能用某一家公司的促销来解释。a16z的研究算过,大模型推理成本正在以每年10倍的速度下降,比摩尔定律还快。
这些账,如果我们只以月为单位来看,可能还没那么震撼。但如果回头看一年前、两年前的AI能力和价格,你就会对这个迭代速度非常惊讶。
李开复在《AI未来已来》里也算过一笔账,能帮我们理解这个降价速度:在相同智能水平下,AI推理成本两年降了99.4%。如果一辆特斯拉Model Y也经历同样幅度的降价,25万的车现在只要1428块钱。
回头看9月的发布就能理解了。Astra刚出来26天,GPT-6.1 Sol就用五分之一的价格追平了它的编程能力。Luna更夸张,价格只有Astra的百分之一。
第二个变化是,新模型的研发过程里,已经有旧模型在帮忙了,而且起到的作用越来越大。
这也是我和罗老师8月份去硅谷的时候,好几个AI公司的科学家都在说的趋势。
OpenAI在技术博客中提到,GPT-6的训练流程中使用了AI辅助的数据生成和评估。Anthropic的研究报告也显示,Claude参与了自身下一代模型的安全测试和红队演练。
在硅谷调研时,我们采访了一位Anthropic做预训练的专家。那天坐下来,他就跟我和罗老师说:「按照现在AI的迭代速度,我觉得一年半之后,我可能就要退休了。」
他这么说,就是因为看到了AI在训练AI的过程中,发挥的作用越来越大。
不过,「AI参与研发」,现在离「AI自己造出下一代」还差得很远。
目前AI做的更多还是辅助性工作:生成训练数据、做初步评估、加速测试流程。核心的架构设计、训练策略制定,仍然是人类研究员的工作。
但就是这些非常耗时间的辅助工作,已经足够让研发速度快起来很多。
我看到日经中文网的一个统计数字,2023年初到2026年3月,中美头部AI企业发布高性能模型的平均间隔是125天;而2026年4月到9月,这个数字已经缩短到了44天,只有原来的三分之一。
还有一个变化是,这些模型并不是刚研发完就立刻发布的。
我的感觉是,这几家公司内部往往储备了多个已经训练好的模型,选择什么时候发布,本身也是一个商业决策。
最典型的例子是OpenAI。GPT-6 Astra、Sol、Luna、GPT-6.1 Sol,四个模型在一个月内发布。
它们不太可能是在这一个月里先后完成的,更合理的解释是:公司已经备好了这些模型,再根据市场竞争的情况决定什么时候发布。
再看Anthropic在9月22日发布Opus 5.5,OpenAI一周内就跟上了GPT-6.1 Sol。能这么快跟上,说明模型很可能早就准备好了,就等着对手出牌的时候扔出来。
哪怕不能抢走市场,至少也能抢走媒体和大众的注意力。
不过,手里有几个没发布的模型,不等于领先了几代。有些模型是平行分支,测试不同方向,有的适合视频,有的适合代码;有些效果不够好,可能永远不会发布。
这三个变化,让我们能用上的AI能力越来越多。直觉上,模型越来越便宜,对普通人来说应该是纯粹的好消息,咱们选个最便宜的用就行了,反正都挺聪明的。
可便宜的模型和贵的模型,擅长的事不一样。
特别是,选错了模型,有时候比不用模型更麻烦。因为你会拿到一个看起来像回事、但经不起推敲的结果,而且你可能根本意识不到它错了。
写一封邮件,Luna够了。分析一份复杂合同的风险,可能得用Astra。帮你整理会议纪要,Flash模型绰绰有余。
但如果你要让AI帮你做一个关键决策的推演,就值得选最好的模型,也得知道怎么用它。
怎么选,要看出错的代价。
一封邮件措辞不够精准,影响有限;一份合同的关键条款被漏掉,后果可能不可逆。越是你没法自己验证结果的任务,越需要用好模型。
反正现在我建议大家多去尝试不同的模型,不要太专一了。我拿自己节前做的一个特别小的需求来举例。
不少朋友都知道,我们跨年演讲已经做了11年。过去每年的活动都会有至少几千张高清照片,都散落在一些云相册的链接里。
现在想找一些历史素材,翻起来不仅花时间,很多时候也压根记不清楚了。
所以我就用OpenAI的便宜模型Luna,帮我批量按年份下载照片、整理文件夹;用GPT-6.1 Sol对每张照片进行重命名和打标签。
然后,用Anthropic的Opus 5.5做了一个查询历年素材照片的本地网页。之所以用Opus,是因为他们家做网页的审美一直在线。
在这个需求里,我还使用了马斯克的Grok bot。你肯定好奇,既然已经用了前面两家的模型,为什么还要用这个?我再把具体场景描述一下,你就理解了。
虽然AI下载了很多照片,但我希望命名和标签能精准到这种程度:这是罗老师在台上鞠躬致意,这是脱不花在彩排时巡场。
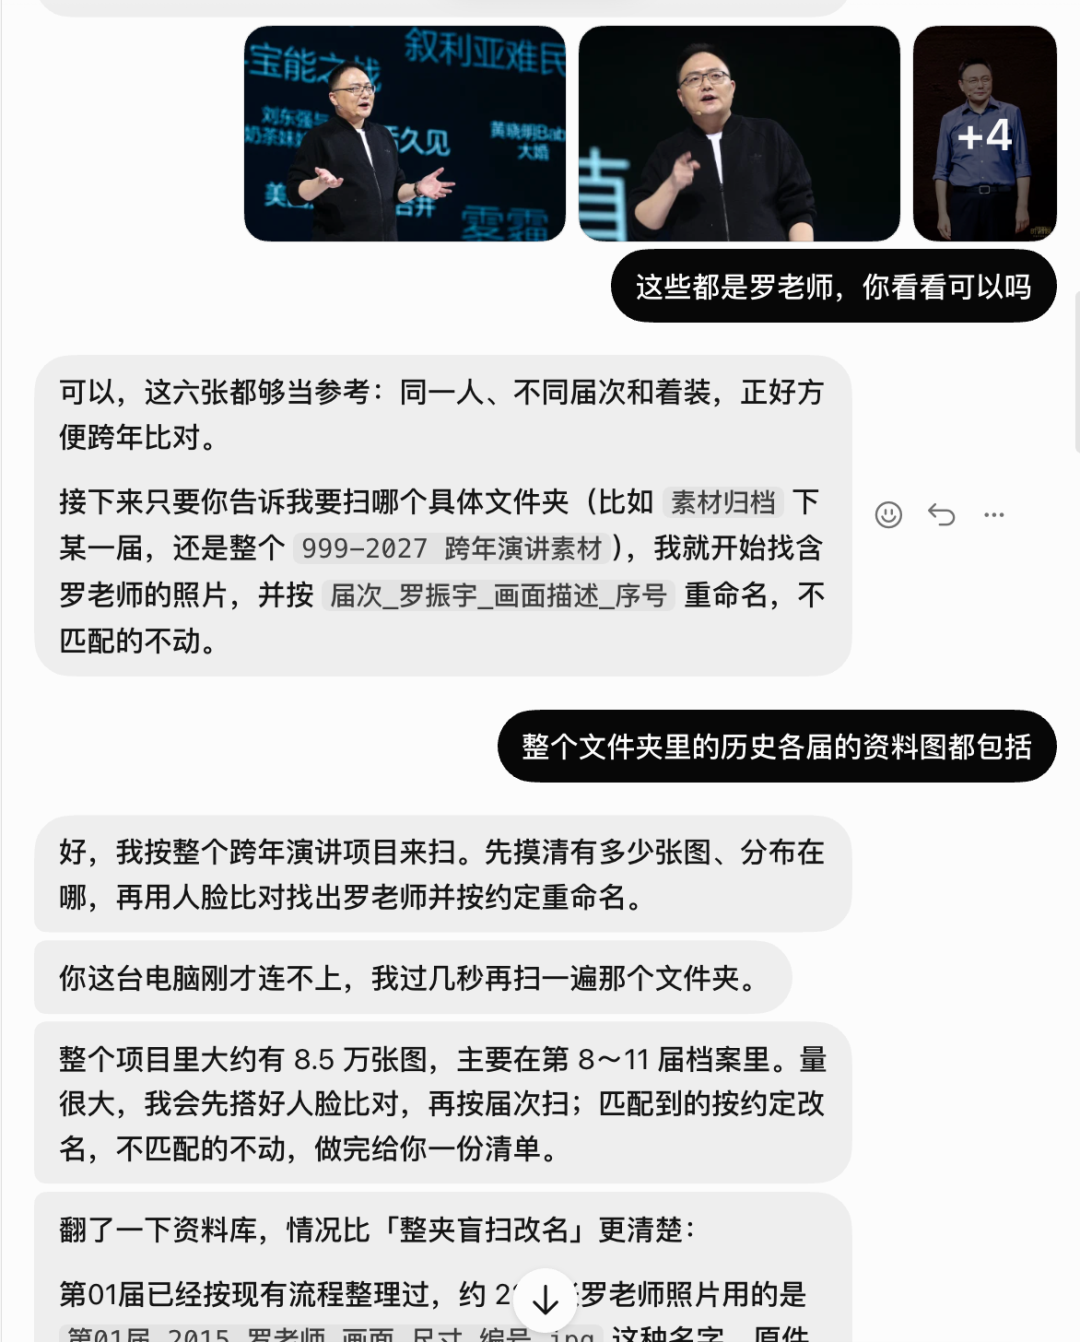
但是,当我扔给OpenAI和Anthropic的模型几张罗老师的照片,让它们帮我找出这个人的所有照片时,这两家的模型都拒绝了我。
给出的理由也差不多,说这涉及用户肖像和人脸识别,不能拿一张照片去判断其他照片里是不是同一个人。
这时,我就想到了马斯克的Grok bot。因为他家的模型一向以肆意妄为而著称。
果然,我把需求跟它一说,它压根没跟我扯这些,直接开始从几万张图片里干活。我把我和Grok bot的对话截张图,你可以看一下。
你看,就这么一个小需求,我调用了三家公司的AI来处理。
不过,因为现在还都是我自己在创建阶段,接下来如果真给跨年项目组用,我肯定会把背后的模型换成DeepSeek或者智谱的GLM,因为省钱、速度也快。
但我想说的是,目前AI还没法替咱们做这种判断,也不会主动告诉你「这个问题,你应该去问一个更贵的模型」。
它更新得再快,能做的事情再多,这三秒钟的判断,还得咱们自己做。
本文由人人都是产品经理作者【快刀青衣】,微信公众号:【快刀青衣】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供

- 目前还没评论,等你发挥!