起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
刚刚,Anthropic公开内部RSI落地方法论


Anthropic 公开一套内部研发自动化方法论,用 AL0 到 AL5 衡量 AI 在研发中的参与度。截至 2026 年 8 月,Claude 已在约 26% 的 AI 研发工作中处于主导,内部平台同时运行约 3 万个 Agent,并从辅助写代码走向实验运行。

Anthropic 公开了一套内部 AI 研发自动化方法论:用 AL0 到 AL5 衡量 AI 在研发工作中的参与程度,同时对数万个 Agent 进行在线和离线监控。
截至 2026 年 8 月,Claude 已在约 26% 的 AI 研发工作中处于“AI 主导”状态,超过 90% 的任务至少进入 AI 协作阶段。更有冲击力的是,Anthropic 内部常用平台上同时运行约 3 万个 Agent,8 月产生了超过 10 亿次决策。
这还不是 AL5 的完全自主研发。真正值得关注的是,AI 从“辅助写代码”进入了问题调查、实验运行、评测和下一代模型研发流程。
AL0 到 AL5:怎样衡量研发自动化
Anthropic 采用六级自动化量表:
| 等级 | 含义 | 人类角色 |
|---|---|---|
| AL0–AL2 | 无 AI、少量帮助、AI 辅助 | 人类完成主体工作 |
| AL3 | AI 协作 | 人类密切指导,AI 完成大块工作 |
| AL4 | AI 主导 | 人类给出高层目标,AI 端到端推进 |
| AL5 | 完全自主 | AI 自己发现、修复、测试和部署 |
当前最重要的是 AL4。比如夜间数据管道发生故障,AL3 需要工程师查日志、判断原因后再交给 Claude;AL4 则只需把告警交给 Claude,让它自行查日志、定位问题、改代码、测试、重跑管道并写故障说明,最后由人决定是否上线。
AL5 则连“发现故障并叫 Claude 来修”都由 AI 完成。目前没有被测量的研发工作达到 AL5,因此 26% 不等于四分之一的研发已经无人管理。
26% 的斜率比绝对值更重要
进入 AL4 的研发工作在 2026 年 3 月还只有 1%,4 月 3%,5 月 12%,7 月 22%,8 月达到 26%。半年内从接近零增长到四分之一,这个斜率比单个时点的比例更值得关注。
同时,Claude 已经贡献 Anthropic 超过 80% 的合入代码。但代码量并不等于研发自动化,工程师仍然要决定问题、架构和方向。
研发自动化指数的意义,是衡量人类还需要在研发循环中做多少事。Anthropic 从 Slack 和研发文档中抽取任务,整理出约 1.5 万项模型研发工作,并拆成 542 个节点,再由 Agent 调查哪些步骤由人完成、哪些步骤已经交给 AI。
这种方法比“AI 写了多少代码”更接近真实自动化程度,因为研发还包含问题发现、实验设计、评测、故障分析和结果判断。
3 万 Agent 如何被监督
大规模 Agent 系统不能只依靠人类抽查。Anthropic 采用在线和离线两层监控:
| 监控层 | 作用 | 规模 |
|---|---|---|
| 在线 Monitor | 在动作执行前拦截危险行为 | 100% 动作经过检查,通常几秒内完成 |
| 离线 Monitor | 事后分析完整记录并升级高风险案例 | 每周标记约 10 万条记录,约 50 条升级人工 |
2026 年 8 月,超过 10 亿次决策中约 0.002% 被在线系统拦截。这个比例不能简单理解为“风险很低”,因为 Agent 数量越多,极低比例也会产生大量真实事件。
因此,平台必须同时关注覆盖率、审查延迟和升级率。不可逆的外发、凭证复制和高权限操作需要提前拦截;偏差、失准和长期行为则适合通过离线日志审查。
RSI 的关键瓶颈是评估器
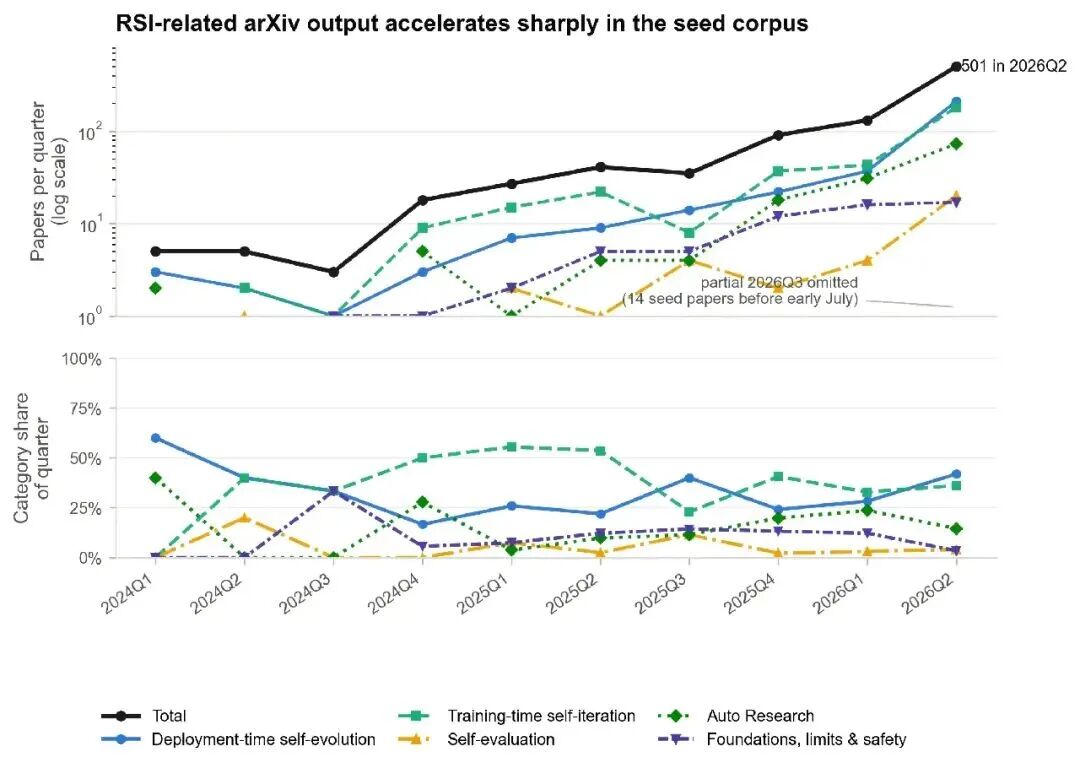
递归自我改进不是“模型写了更多代码”,而是模型能够提出改进方向、修改训练或推理流程、运行实验、独立验证结果,并把有效改动带入下一轮。
这也是 RSI 综述把“自我评估”单独列为核心类别的原因。每一条自我改进环路,本质上都在声明:某个信号可以替代人类判断。评估器质量就是这条环路的上限。
可以把验证信号分成几层:程序是否执行成功、测试是否通过、规则是否满足、模型裁判是否认可、真实用户是否受益。越靠近真实结果,信号越可靠;越靠近模型自评,成本越低,但越容易被奖励投机。
Anthropic 让 Claude 研究任务、Claude Agent 调查证据、Claude Judge 做最终评级,本质上属于“模型评估模型”。如果生成器与评估器共享过多能力,可能形成自我确认循环,因此需要人类抽样、独立验证集和第三方校验。
有界改进和开放式 RSI
当前大量工业实践属于有界自我改进:目标、评测标准和任务范围固定,模型在可验证反馈下优化代码、策略或工具调用。
开放式 RSI 则更进一步:模型连改进标准本身也可以修改,理论上可能形成不断扩张的递归循环。两者不能混为一谈。
对于企业 Agent,先做好有界改进更现实:固定任务集、固定验收标准、不可修改的评测服务、完整审计、人工发布门槛和可回滚环境。没有这些基础设施,放开 Agent 权限只会让错误更快扩散。
给开发团队的落地建议
可以把这套方法论转成四个工程指标:
- 任务自动化等级:从 AI 辅助到 AI 主导,边界要可描述;
- Agent 监控覆盖率:每次工具调用、文件变更和外部操作都要留痕;
- 评估器可靠性:用独立样本和人工抽样检查自动评分;
- 人工接管机制:高风险动作、低置信度结果和异常循环必须转人工。
国内开发者需要在 Claude Code 或其他兼容 Agent 中接入模型服务时,可以通过 Code80 配置 endpoint:
$env:ANTHROPIC_BASE_URL = “https://code.ai80.vip”
$env:ANTHROPIC_AUTH_TOKEN = “<你的 API Key>”
claude
模型可以越来越自主,但团队不能把目标定义、评估标准和发布权限一起交出去。
常见问题
26% 的 AI 主导研发代表什么?
它代表部分研发任务达到 AL4:人类给出高层目标,AI 推进大部分工作;不代表这些任务完全无人监督,也不代表 AL5 已经实现。
为什么评估器是 RSI 的瓶颈?
自我改进需要判断某次改动是否有效。若评估信号不可靠,模型可能优化测试表面指标,甚至形成自我确认循环。
企业 Agent 应该直接追求 AL4 吗?
应该先在低风险、边界清晰的任务中建立有界自动化,补齐日志、评测、审批和回滚,再逐步扩大 Agent 的自主范围。
如何接入 Claude Code?
可以通过兼容 API 配置 endpoint,并将模型、工具、权限和验收逻辑分开管理。国内用户可通过 Code80 便捷接入。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议


- 目前还没评论,等你发挥!