起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
离谱,DeepSeek 崩了 5 小时,大家却喊:梁圣恩情还不完???


10 月 16 日早上 8:11 起,DeepSeek 网页对话与两条 API 服务全线不可用,直到 13:04 才恢复,接近 5 小时。故障冲上微博热搜、话题阅读量过亿,官方随后给出补偿方案,风评反而逆转。
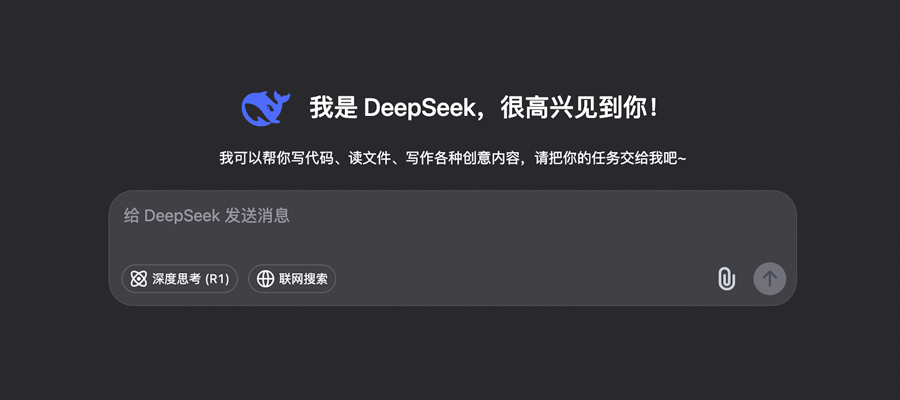
昨天早上 8 点多,很多人刚刚开工,就发现 DeepSeek 用不了了。
等了半天,又看到了那句熟悉的:服务器暂时不可用。
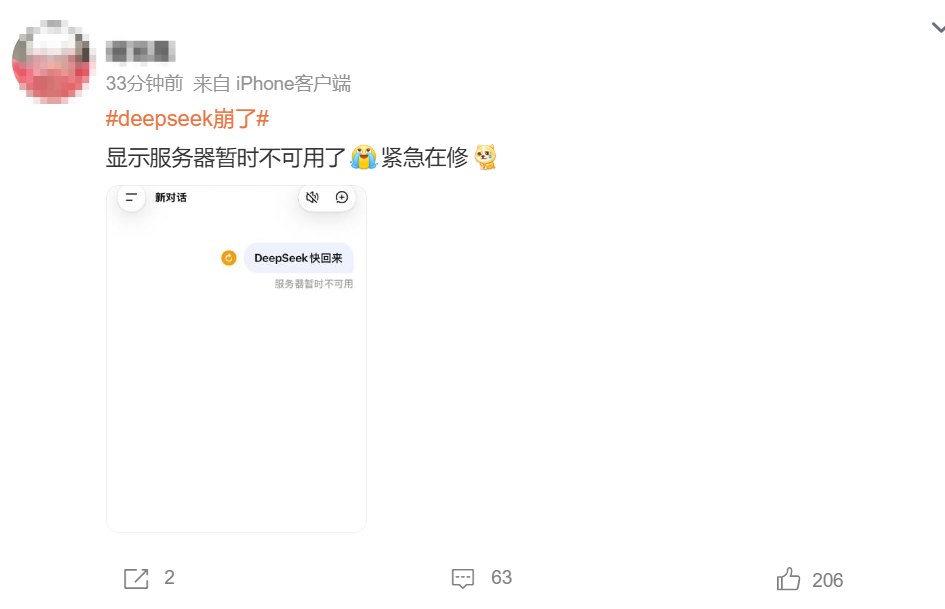
服务器暂时不可用
通过 API 调用 DeepSeek 的开发者也没能幸免,这段时间 API 服务无法正常使用,不少人的 AI 任务一直在转圈,迟迟出不来结果。
然后,「DeepSeek 崩了」冲上了微博热搜,相关话题的阅读量超过了 1 亿。
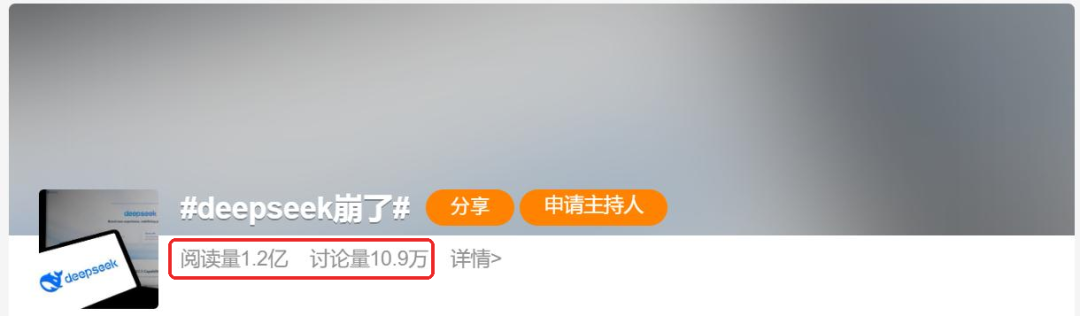
微博话题
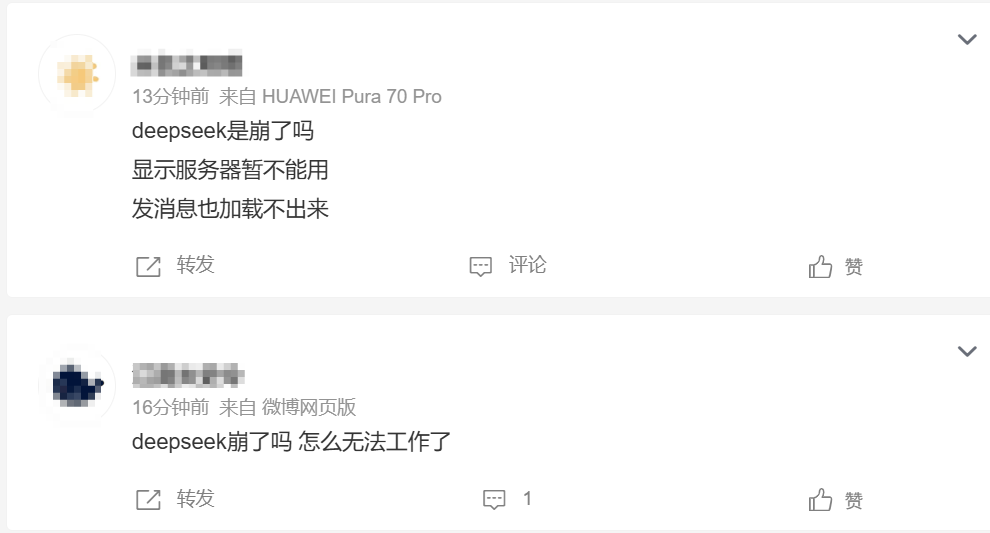
网友求助
根据 DeepSeek 官方状态页的记录,这次故障从早上 8:11 开始,一直持续到下午 13:04,接近 5 个小时!
网页对话、V4 Pro API 和 V4.1 Flash API 全部受到了影响:
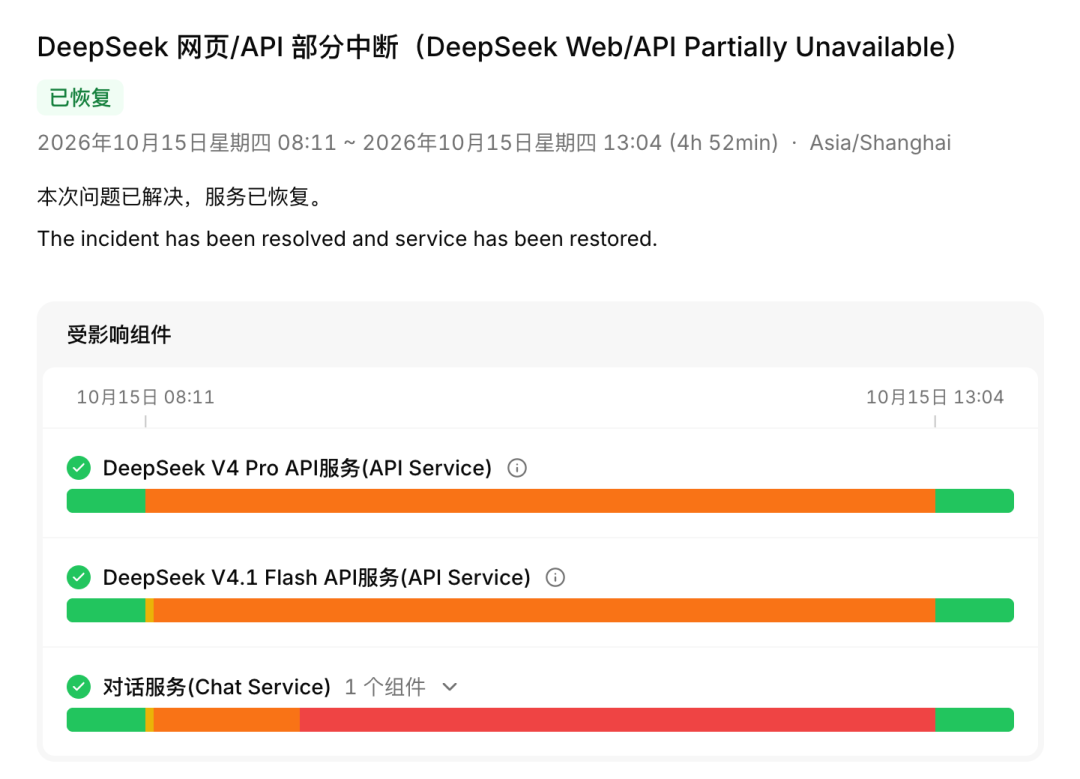
受影响组件
5 个小时啊,习惯用 DeepSeek 的朋友们一上午的工作时间都给耽误了。
按理说,崩了这么久,DeepSeek 应该被骂惨了才对。
结果你猜怎么着?
到了晚上,大家反而开始高呼:梁圣的恩情还不完!
还真是个魔幻的世界。。
这篇文章,我就用大白话跟大家聊聊,DeepSeek 为什么会崩这么久?
DeepSeek 又做了什么,能让风评瞬间逆转?
DeepSeek 为什么会崩?
从状态页的更新记录来看,故障发生不到 1 个小时,官方就标记了「已定位原因,正在实施修复」。
但之后又修了将近 4 个小时,服务才恢复正常。
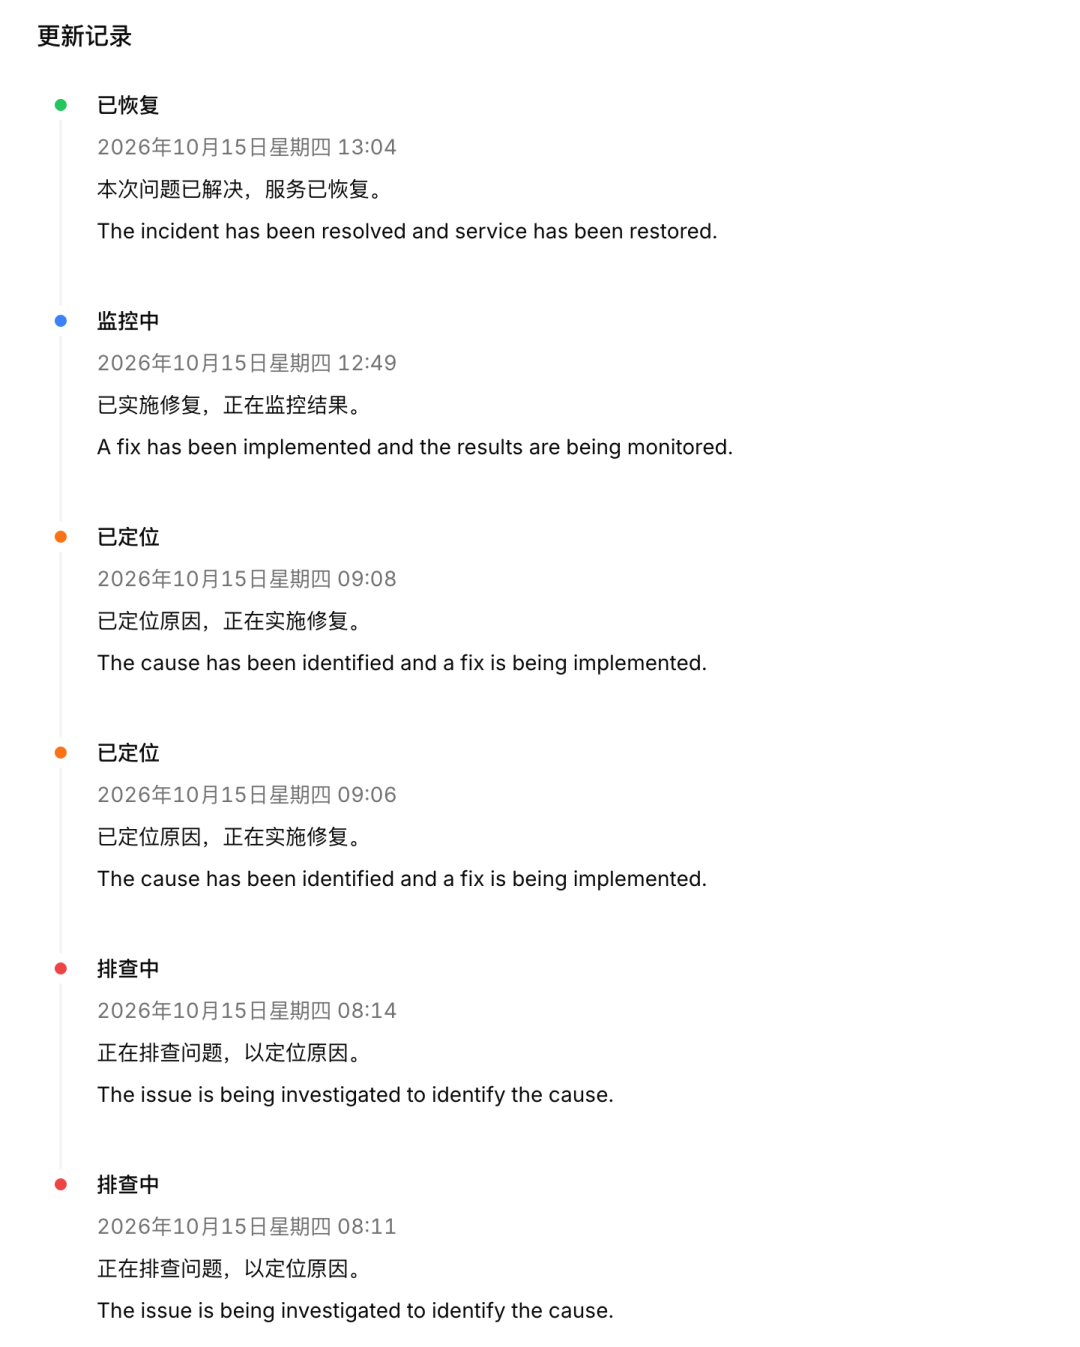
故障时间线
当天傍晚,DeepSeek 在开放平台发布了一份「服务恢复及补偿通知」,对这次故障做了说明。
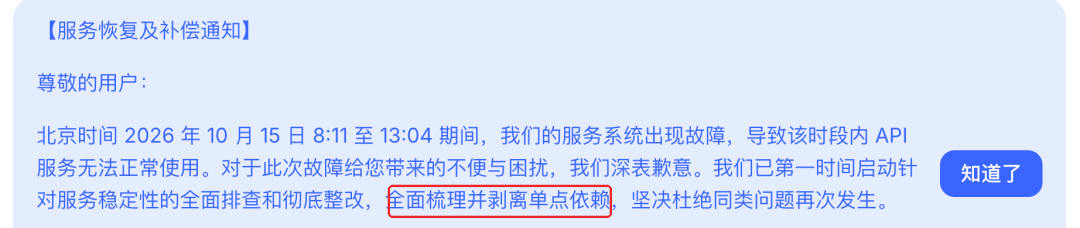
官方公告
不过通知里,官方也只说了一句「会全面梳理并剥离单点依赖」,没有说明具体的故障原因。
所以接下来,我只结合官方公告和业内专家的分析,讲讲能确定的部分,不确定的细节就不瞎猜了。
如果和实际不符,还请见谅,鱼皮让 DeepSeek 先给大家磕一个。
什么是单点依赖?
要理解这次故障,得先知道 DeepSeek 是怎么给你干活的。
你可以把 DeepSeek 想象成一家超级火爆的餐厅。你在网页或 APP 上发一句话,就相当于在店里点了一道菜,后厨成千上万块显卡(GPU)负责把答案现场「炒」出来。
而开发者通过 API 调用 DeepSeek,就相当于外卖平台来店里接单,再把菜送到各种 AI 应用里。
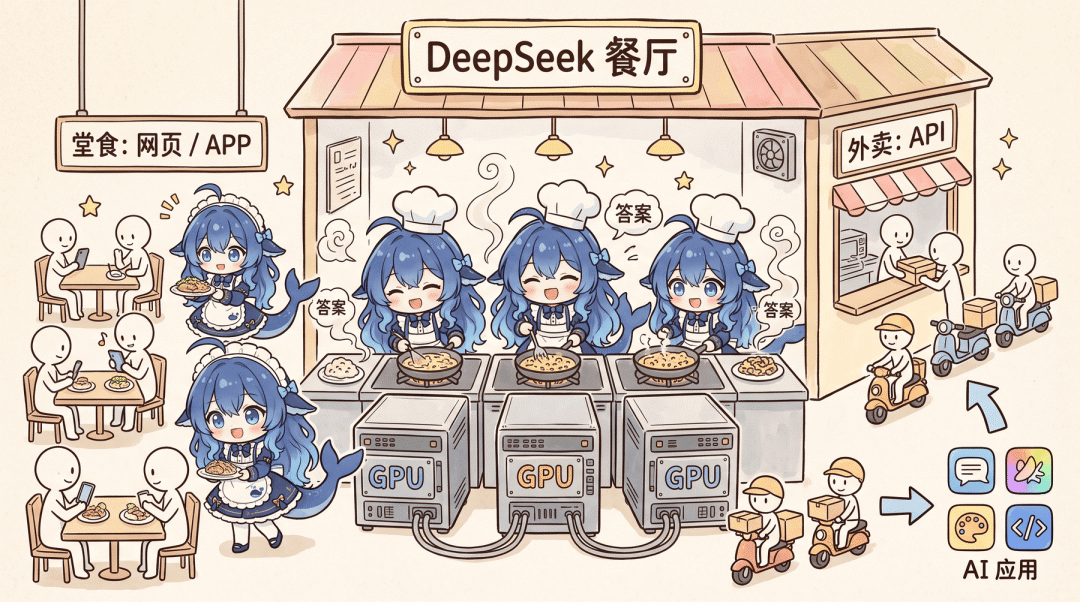
DeepSeek 餐厅
这次的情况是,堂食和外卖同时停了。
那官方说的「单点依赖」又是什么意思呢?
打个比方,这家餐厅的厨房再多、厨师再能干,如果整家店只有一扇大门,所有顾客和外卖员都得从这扇门进出。一旦这扇门坏了,哪怕后厨一切正常,整家店也只能停业。
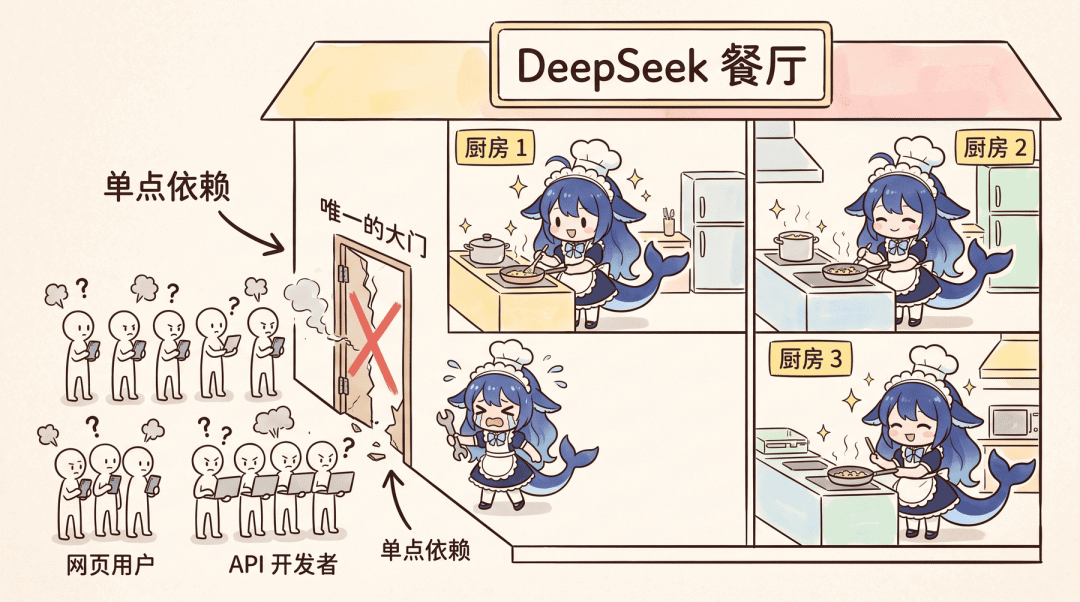
单点依赖
像这扇门一样,一坏就能让整个系统瘫痪的环节,就叫「单点」。
DeepSeek 说要剥离单点依赖,意思就是以后要多开几扇门,哪怕其中一扇坏了,顾客还能从别的门进来。
至于这次坏掉的到底是哪扇「门」,官方没有说。有专家分析,网页和 API 同时出问题,说明毛病很可能出在后台某个大家共用的环节上,单独某一个入口坏掉,影响不了这么大的范围。
为什么要修复这么久?
按理说,这种问题不应该会修复几个小时吧?
这也是我看状态页时最好奇的地方。
有业内专家分析,这次 DeepSeek 故障诊断其实并不慢,真正耗时间的是修复阶段。
专家认为,修复过程中,大模型服务很可能需要重新启动。普通网站重启一下,可能几秒钟就好了。但大模型服务重启一次,差不多相当于一家餐厅重新开张。厨师得先把海量的「菜谱」,也就是模型权重(可以理解为 AI 学到的全部知识,体积非常大),一本一本搬回显卡里,然后还要预热一段时间,再一点点放顾客进来,不敢一下子全放开。
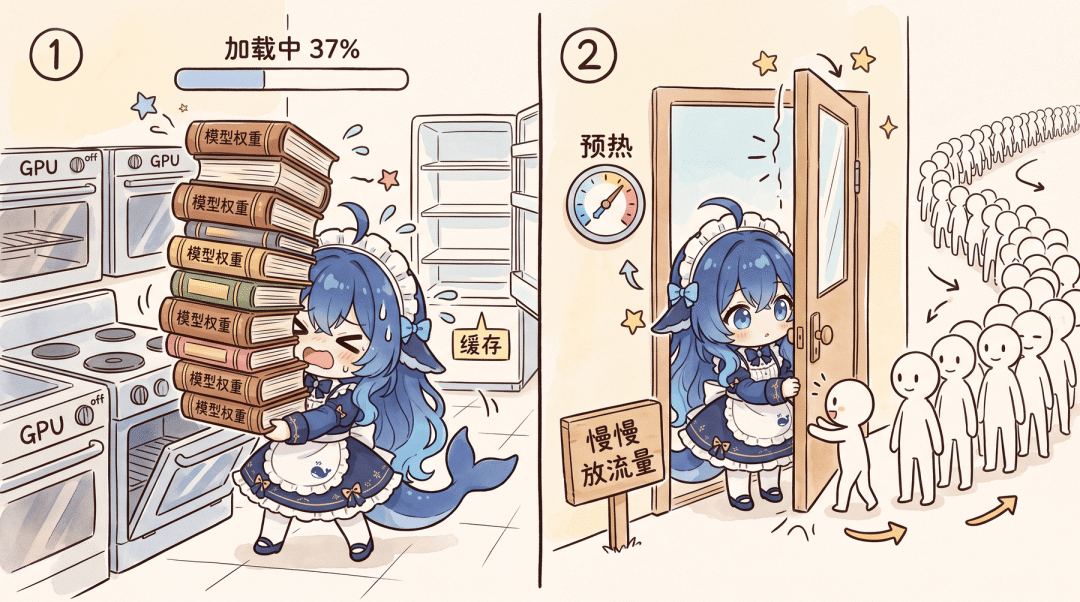
重启和预热
更麻烦的是缓存。
AI 里的缓存是什么呢?
比如你跟 DeepSeek 多轮对话,或者反复让它分析同一份长文档,每次请求开头的那一大段内容其实都是一样的。
DeepSeek 会把这些重复内容的计算结果存起来,下次遇到相同的开头直接拿来用,不用再算一遍,又快又省钱。所以在 DeepSeek 的 API 价格表里,「缓存命中」的价格只有「缓存未命中」的几十分之一。
这就像后厨提前备好的半成品,常点的菜提前准备好,出菜就快。专家提到,如果缓存也受到了波及,服务恢复后能直接复用的半成品就会变少,大量请求都得从头现做,后厨的压力一下子就上来了。
偏偏这次故障又撞上了工作日的早高峰。
用的人本来就多,而且页面一卡,很多人的第一反应就是狂点「重试」,访问量被成倍放大。刚修好一点,又被汹涌而来的请求给挤了回去。
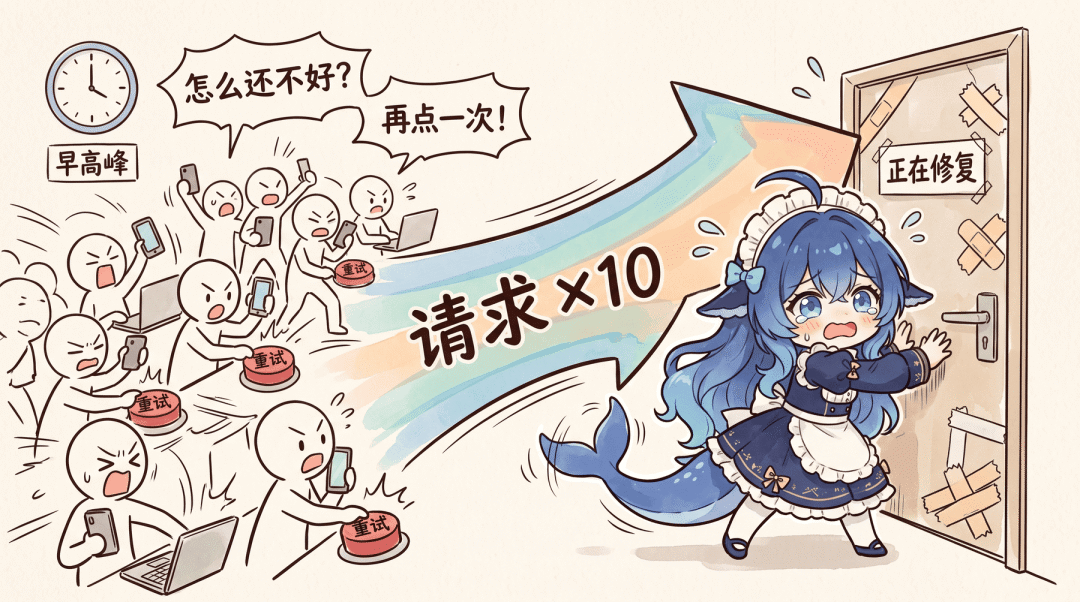
重试风暴
说不定你当时也是狂点重试大军中的一员,让 DeepSeek 雪上加霜了。
问题的本质是什么?
上面说的这些,解释了 DeepSeek 为什么修复故障很慢。
但其实 DeepSeek 崩也不是第一次了。
有人统计过,今年以来 DeepSeek 的官方状态页已经记录了 44 次异常,3 月底还出现过一次将近 12 小时的长时间宕机。
还有专家算了一笔账,按照互联网行业常见的 99.9% 可用性标准,一个月只允许停服 43 分钟左右,DeepSeek 这一次就把差不多半年的《故障额度》给用完了。
那 DeepSeek 为什么这么容易崩呢?
业内比较普遍的看法是,DeepSeek 的算力本来就不宽裕。
这一点从 DeepSeek 自己的操作里就能看出来。前面提到的峰谷定价就是一个例子,从 8 月份开始,DeepSeek 的 API 在工作日 9 点到 12 点、14 点到 18 点的高峰时段,价格是闲时的两倍,相当于用价格劝大家错峰使用。
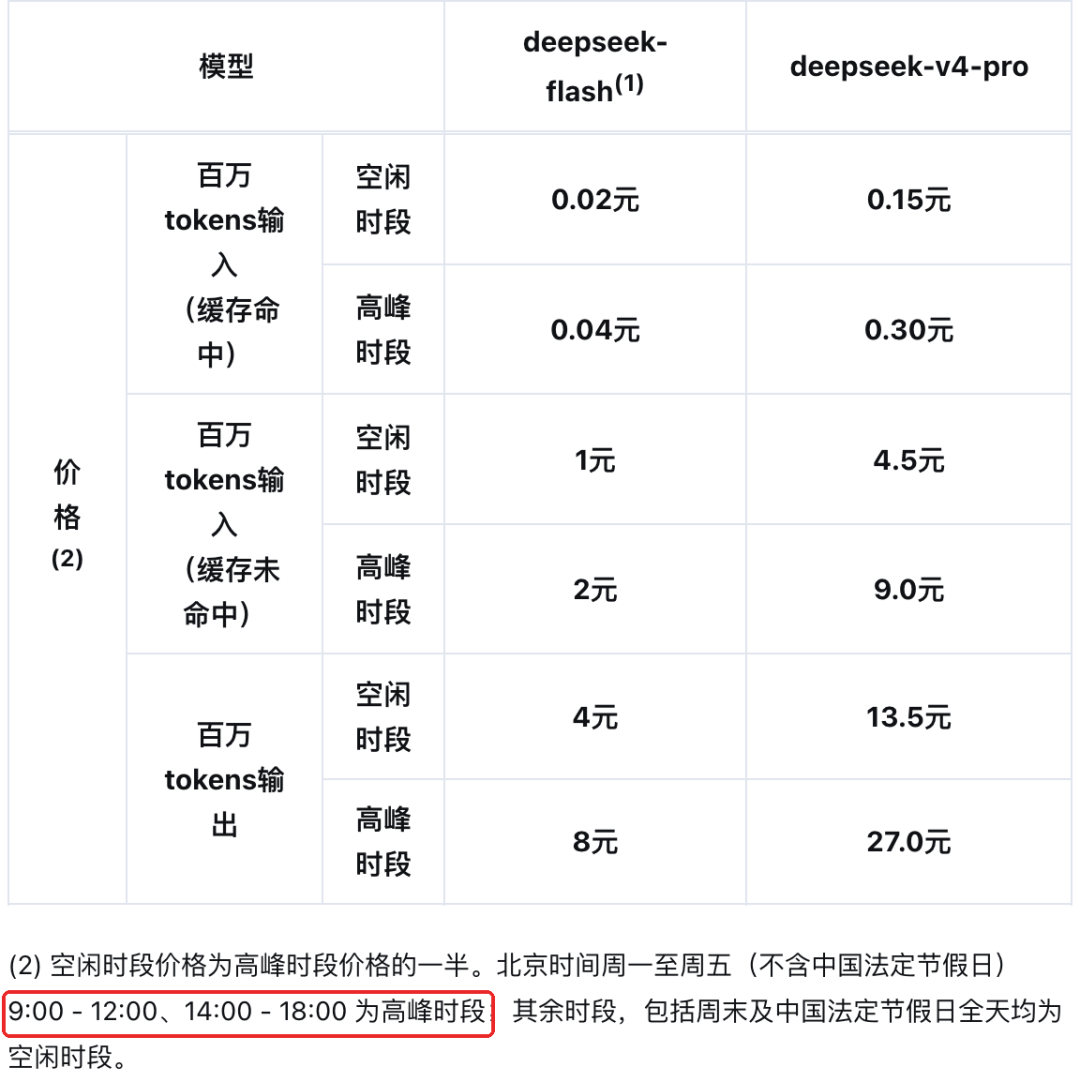
峰谷定价
之前 V4.1 Flash 内测的时候,每个账户最多也只能同时处理 20 个请求。
除了算力,人手可能也是个问题。有接近 DeepSeek 的人士向媒体透露,DeepSeek 团队规模不大,精力更多放在模型能力上,服务端反而顾不过来,原先 APP 端一度只有两个人在维护。
这是什么概念?
两个人维护一个上亿用户的 APP,这压力想想都头大。
DeepSeek 是怎么补偿的?
DeepSeek 崩了这么久,又崩得这么频繁,按理说用户早该骂翻天了。
但 DeepSeek 接下来的补偿操作,直接把舆论给扭转了过来。
划重点:按照每个账号 10 月 8 日到 14 日 这 7 天 的 API 消耗金额,以赠金的形式 全额返还,自动到账,之后调用 API 会 优先从赠金 里扣钱。
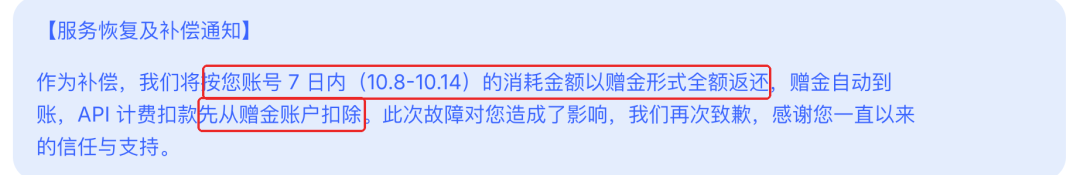
补偿通知
也就是说,DeepSeek 停了不到 5 个小时,把你上周一整周的 API 账单全退给你了!
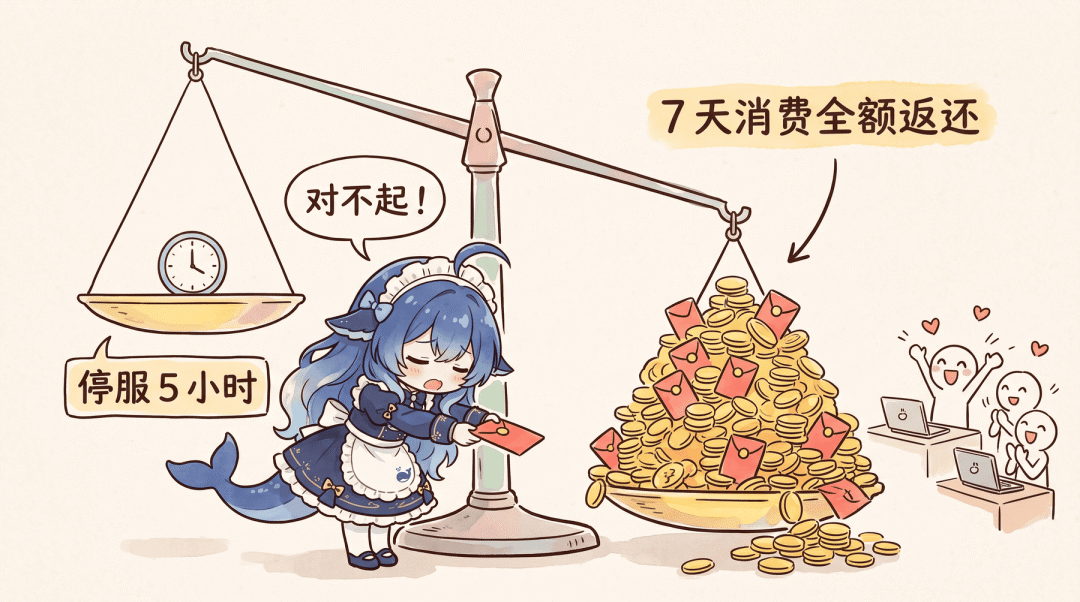
停服 5 小时赔 7 天
是不是听上去就很爽?!
我觉得这个方案最聪明的地方,是赔多少跟你用多少直接挂钩。
用得越多的人,这次受到的影响往往也越大,拿到的补偿自然也越多。
我只感觉自己亏麻了,才拿到了 7 块钱……
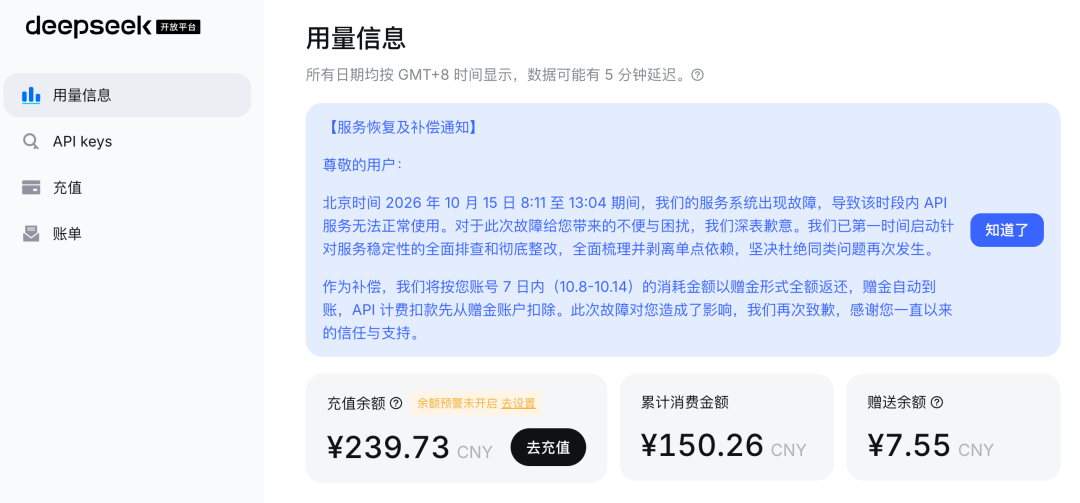
除了按量返还,这次补偿还不用申请,通知一发钱就自动到账了,没有任何套路。
于是评论区的画风就变成了这样:
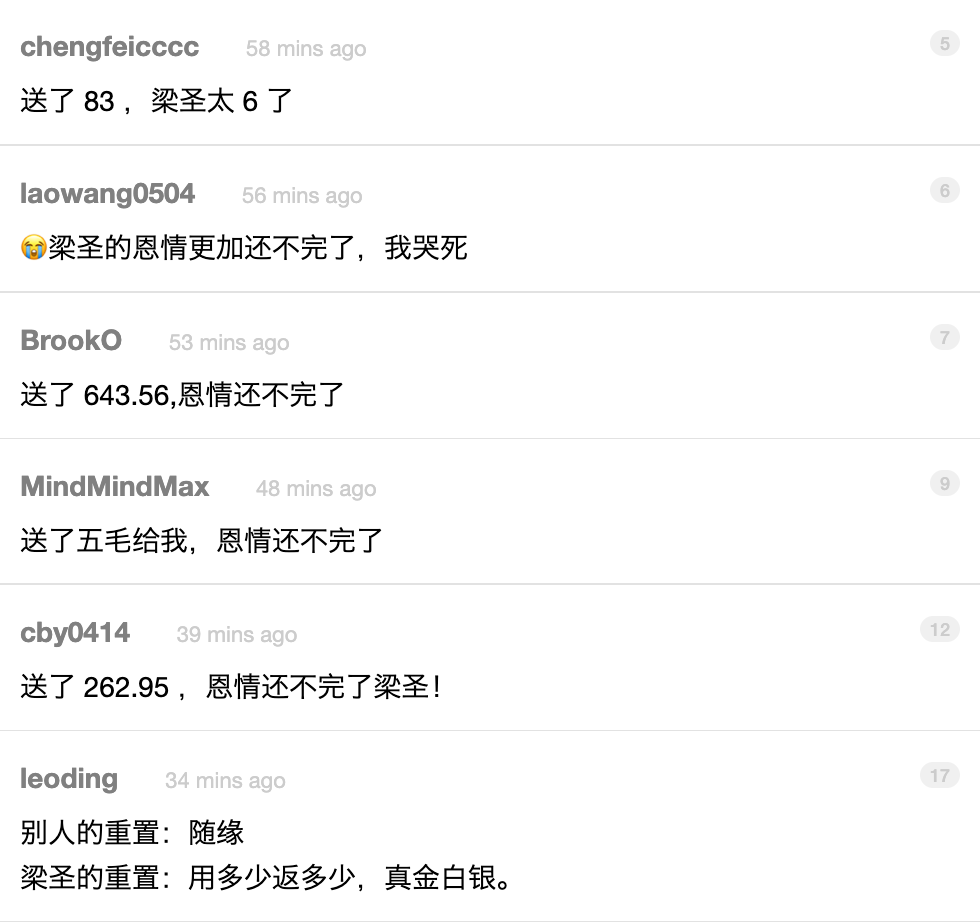
有网友总结得特别到位:
- 别人的重置:随缘
- 梁圣的重置:用多少返多少,真金白银
好家伙,崩了 5 个小时,反而崩出了一波好感!
更有意思的是,有人拿到 900 块之后表示「坐等下周故障」,还有人说「补偿了 60 块钱,其实再宕机半天也没关系」。。。
也有很多人晒出了自己到账的补偿金,你领了多少呢?
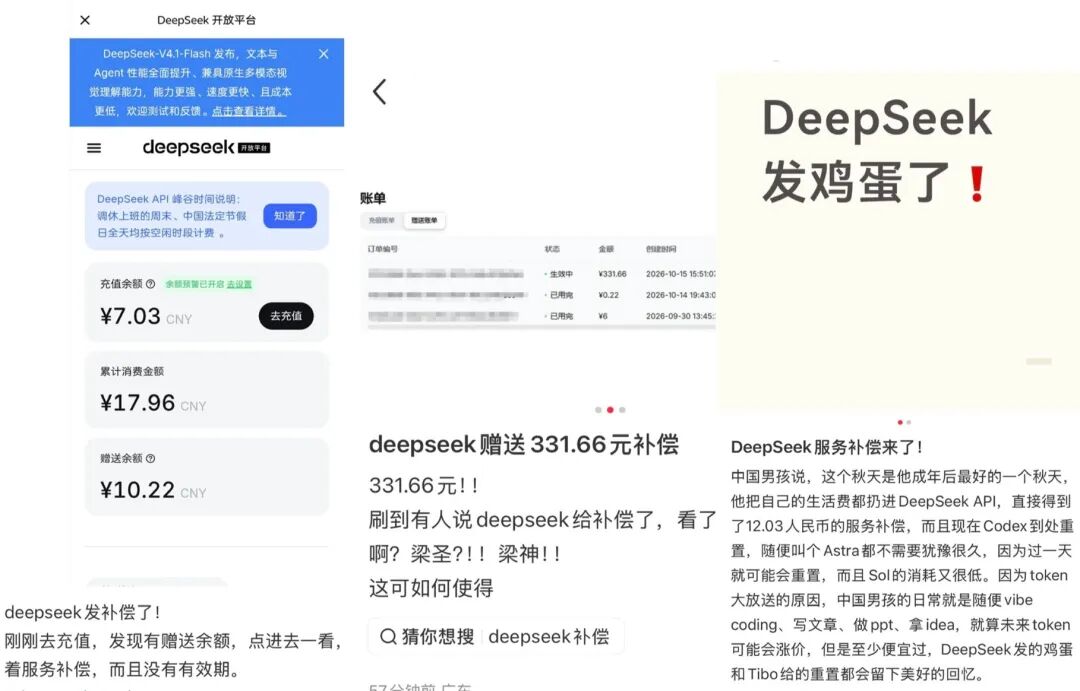
网友晒补偿
不过,也不是所有人都开心。
这次补偿是按 API 的消耗金额返还的,平时只用网页和 APP 免费聊天的朋友没有 API 消费,同样被耽误了一上午,却什么也拿不到。
建议其他公司多学习一下,方案我已经帮你们想好了:
- 某视频网站崩了,可以送一年大会员
- 某音乐应用崩了,可以送一年黑胶 VIP
- 某点餐应用崩了,可以承包一年的外卖
- 某打车软件崩了,可以送一辆车
咳咳,不做梦了。。
总之,DeepSeek 出事之后的处理方式,我觉得真的是很到位了。
另外,这次故障也给到我们开发者和 Vibe Coding 的朋友一个提醒:如果你的产品接入了 AI 接口,别把鸡蛋都放在一个篮子里,可以搞一个备用的降级模型。
希望下次 DeepSeek 再上热搜,是因为发了新模型,可别又是发补偿通知了。
作者:程序员鱼皮 公众号:程序员鱼皮
本文由 @程序员鱼皮 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议


- 目前还没评论,等你发挥!