
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
智能进步的复利:从 RSI 加速到持续学习


RSI 已经从论文走进硅谷一线实验室:coding 进步并未放缓,研究员的重心转向提出假设与验证结果。把 RSI 与持续学习放回同一张地图,看清两者各自的瓶颈、技术路线,以及算力增长如何改变智能生产的成本结构。

01 Key Takeaways
- RSI 范式已经在发生了,模型的自我训练和自我迭代在硅谷 frontier labs 中体感明显。我们对 RSI 的定义是:AI 可以参与到模型训练的每一个环节中。随着 compute 增加,使智能产生同等程度进步所需的 researcher 数量不再同比例增长,而是开始下降。
- 继年初 opus 4.6 带来的推背感之后,我们在硅谷再次感受到 RSI 加速的震动。coding 进步没有放缓,synthetic data 和 infra 优化大大受益于 RSI,研究员的工作不再需要理解代码,更多在于提出假设,理解需求和想办法 validate 模型产生的结果。Lilian Weng 回到 OpenAI 之后也在 RSI 上投入了大量精力。
- RSI 与持续学习是在解决两个不同的问题,甚至可能有了 RSI,持续学习才能真正解决。RSI 让生产智能的过程更加自动化、close the loop;持续学习让 AI 可以自己在交互中学习积累能力,学会利用真实工作零散、常常没有标准答案的经验。
- 实现 continual learning 大概率需要一次范式跳变。我们对持续学习的定义是:一个系统在 interaction experience 中能把新的知识和 entropy,转化为能够泛化到各种任务上的能力提升。
- 两者都受制于好的 verifiable 环境。coding agent 让生成任务和模拟环境越来越容易,但是怎么判断任务的效果,正在成为更关键的约束。一件事情只有 AI 掌握了好的 taste 去验证和证伪,怎么去对于任务设计好的 verify 和 falsify 方法,才算是真正 close the loop。
- 这会同时改变算力需求和产品形态。RSI 会让 AI 的进步完全受 bottleneck by compute 的物理约束;持续学习会训练和推理的分工边界会变模糊,持续进步的 AI 也会比现在的 API 更加有极致的个性化和用户粘性。
- RSI 也会拉大中美两地模型的差距,算力和模型迭代速度两者叠加,frontier labs 的模型进步会更快。RSI 可能是 frontier labs 最终实现护城河的飞轮。
Personalization × Self-evolution Matrix
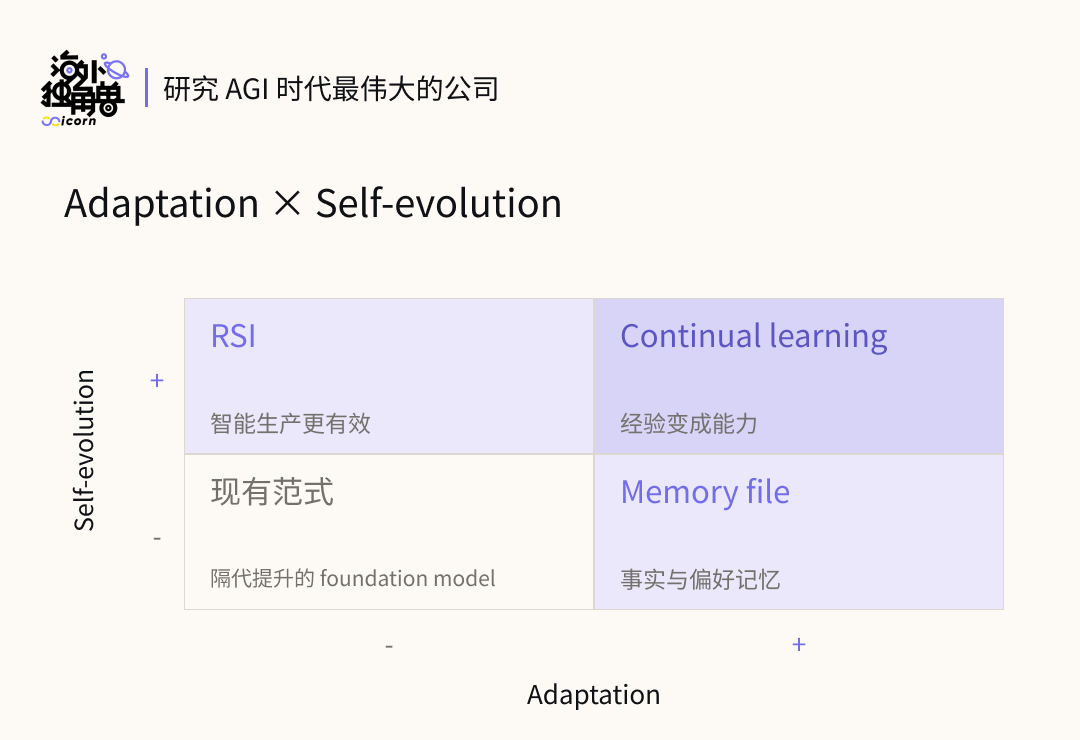
在我们讨论 RSI 和持续学习的时候,有这样两个维度是最核心的,可以用来区分这两个定义的差别:
- Adaptation:AI 能不能围绕特定的任务或环境,来进行个性化的学习。
- Self-evolution :AI 能不能 close the loop,自己训练更好的 AI
在这个思考框架下,传统的 LLM 范式,foundation model 隔代升级、定期 release 被放在了左下角。而现在 的 frontier labs 训练方式正在变得越来越自动化、工业化,也正是在从左下角走向左上角的过程中。
而从个性化的角度思考,现在的 Chatbot/ Personal Agent 都是在用 memory file 的形式,用 markdown 等结构化文件系统存下用户的个性化记忆,在对话相关的地方去回忆,类似一个随身带着笔记本的人。
持续学习则是右上角两个维度的交汇点,同时具有 self-evolve 的持续进步和个性化 adaptation 能力。
公司 Mapping:从矩阵到产业切入点
本文后续的核心内容,主要围绕 RSI 目前的进度与下一步展开,然后后续持续学习需要实现的核心技术路线。因此不会涉及太多对具体公司的判断,但我们确实观察到这两个方向上都出现了很多 Neolab。
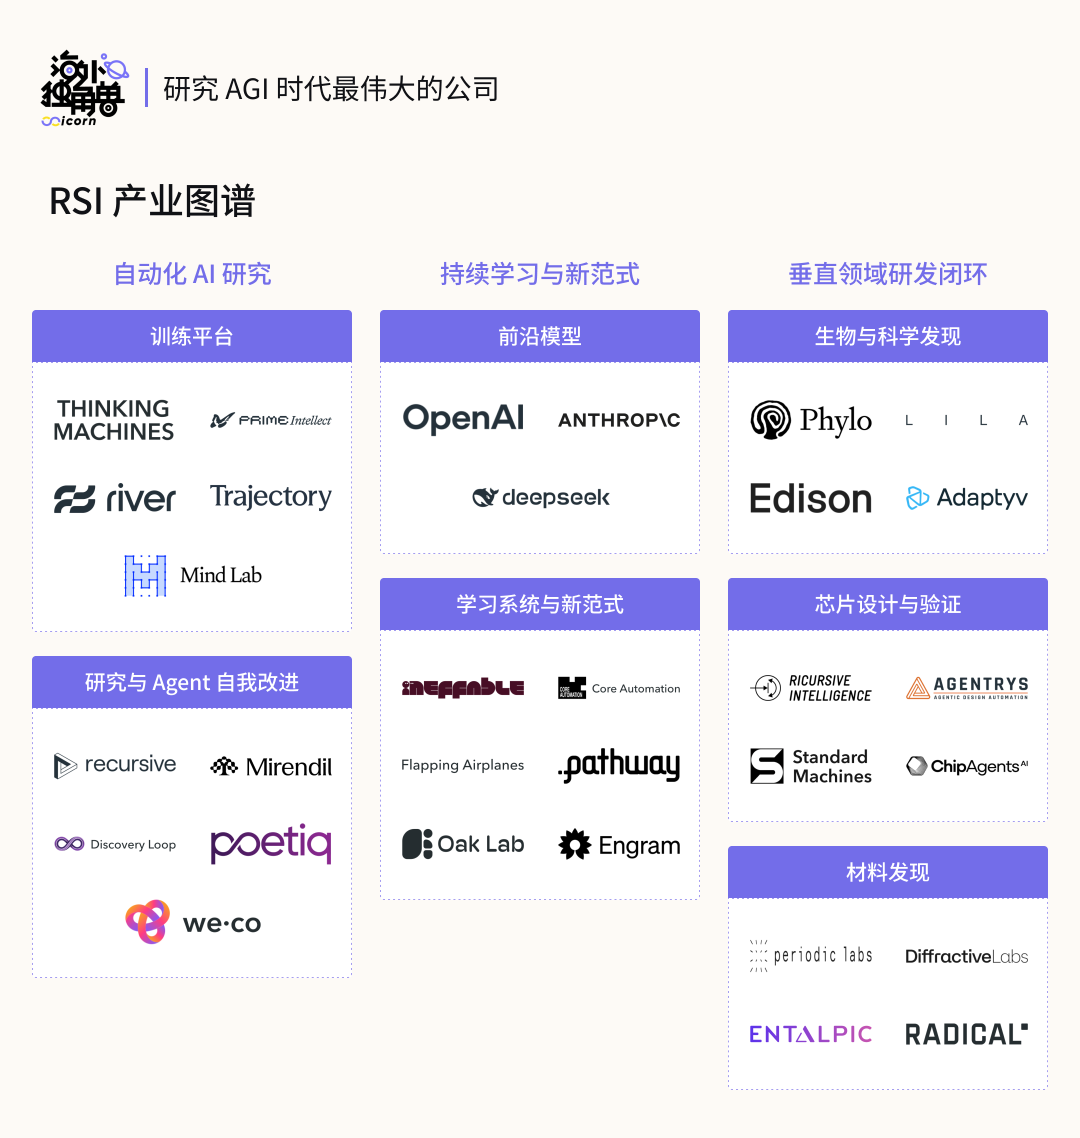
随着该领域涌现出大量的 startup,我们希望先在此分享这些 startup 的分类与 mapping 思路。总的来说,主要分为三大类:
1)RSI:AI 研究自动化
这是 RSI 愿景的直接体现。其中又可以细分为两类:
(a)训练平台:企业可以在其平台上通过 API 或 RL fine-tuning 等方式训练个性化模型。因此这类创业公司的产品将 RSI 搭建成平台,让企业更容易地完成模型训练。代表公司如拥有 Tinker 平台的 Thinking Machine。
(b)偏向 RSI 本身的研究:目标是在 AI 以及其他领域实现 close loop 的闭环任务。代表公司如 Jeff Dean 出来创业做的 Discover Loop。
2)Continual Learning:新范式突破
在这个分类中,我们认为前沿模型公司仍有很大的作为空间。例如 OpenAI 和 Anthropic 内部大概率已经部分实现了 RSI,而持续学习和算法效率的提升可能是他们下一个最关心的问题。
此外,也有很多 visionary 的 researcher 创业在探索学习与新范式方向。我们认为这类探索的赔率更高,但客观来说胜率更低:
探索下一代范式更像是一个 research bet,是在解决一个 science 问题。不确定性会高得多。甚至有可能在现有范式下 frontier lab 用 RSI 就解决了持续学习问题。
3)Domain Loops:在垂直领域内闭环
越接近真实世界,实验通常越贵、越慢,也越难复制。因此,RSI 能否带来复利,最终取决于系统能否从每一轮反馈中学到更多。这里列出的是各垂直领域中相对更 AI-native 的团队:
在 science 领域,主要的代表方向是 science discovery agent 和自动化实验室(automated lab)类的公司。
在 chip design 与材料发现领域,一些团队致力于直接打造终端产品,另一些则是为了在过程中沉淀数据与 RL 环境,以解决现实世界的瓶颈问题。
对于这些细分领域,我们后续也会对每个领域发布研究 mapping 分享给大家。
02 State of RSI 初级 RSI 已经实现:实验自动化
初级 self improvement 更接近模型训练的 automation,从去年年底 coding 能力大幅提升后开始加速,把现有的 pre-training,post-training,RL,全部用 AI 替代。现在在 frontier labs 中,越来越多任务可以由 Agent 完成闭环。一个 researcher,可以同时推进多个问题,把更多精力用在选择方向、设计验证和判断结果上。
RSI 并不需要完全没人参与,更实际的定义是,deliver 单位智能需要的 researcher 数量,不需要随 compute scale。模型的提升 scale compute 和 intelligence,但不 scale people。
这点反应在 OpenAI 在 2026 年 9 月公布的内部数据上:每位活跃实验人员的实验量,在 8 月达到 2025 年均值的约 1.6 倍。考虑到 OpenAI 的员工增长数应该是比算力增长来的快的,researcher 们正在把更复杂、时间跨度更长的任务交给 Agent。
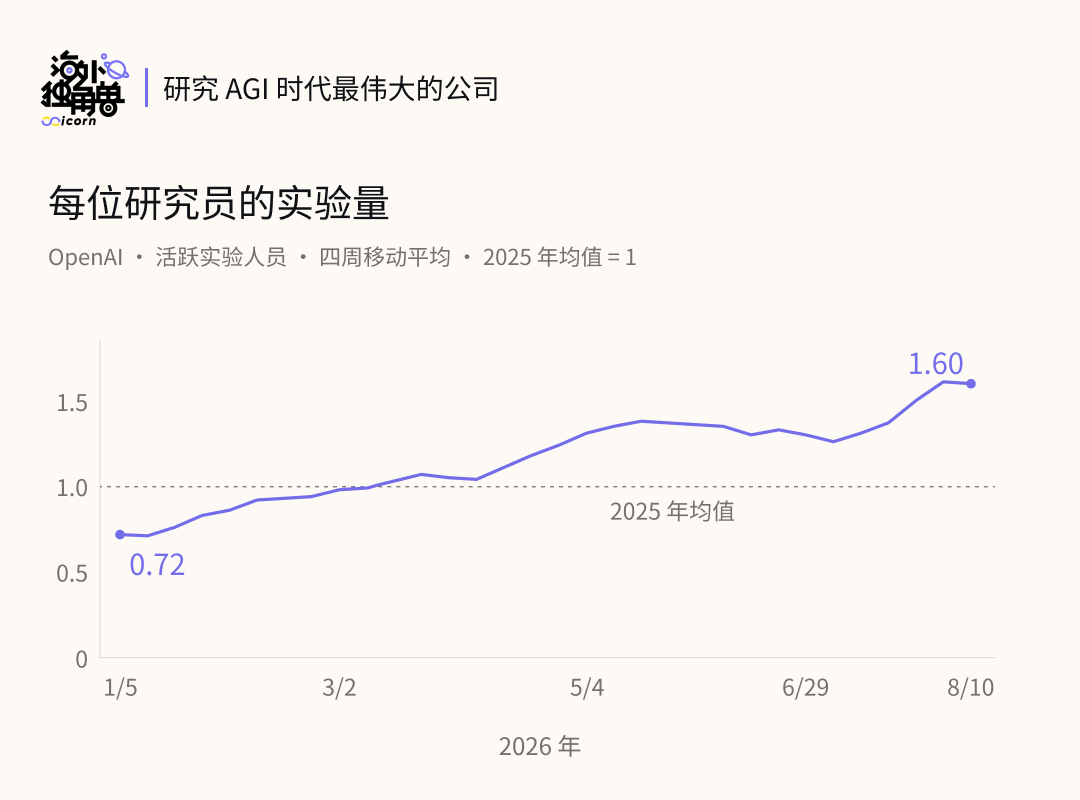
从算力看,这种变化包含两个不同的量:每位研究员能管理多少 GPU 小时,以及每个 GPU 小时能产生多少有效成果。自动化肯定让前面这一项提高了,让更多假设进入实验;但要让后者提高,需要评估和研究方法进一步改善。真正的 RSI,最终要把更大的实验规模转化为更强的研究能力,让模型产生迭代速度明显指数级增加的复利。
Karpathy 的 autoresearch 展示了闭环的具体做法:Agent 修改训练代码,在单 GPU、每次五分钟的训练预算内运行,用固定评估决定保留还是撤销改动,然后进入下一轮。人负责研究指令与边界,Agent 连续执行。五分钟指训练时间,不含启动、编译和 Agent 推理。
AI agent 读取当前训练代码和实验记录 → 训练代码修改 → 固定的计算 budget 下,做实验与评估 → 保留或撤销 → 下一轮实验。
Infra 也因此在变化:训练系统除了方便 researcher 使用,还要让 Agent 能操作、观察和纠错。可调用的训练接口、可复现环境和独立评估,决定一名研究员能同时管理多少条这样的闭环。
研究瓶颈
初级 RSI 实现之后,最稀缺的工作变成了这些:
规模迁移。小模型上的 optimizer、数据配比或架构改动,能否在前沿训练中继续有效?从简单任务到复杂任务的迁移和泛化,是现在 自动化实验最主要的瓶颈。Anthropic 的自动 alignment 研究已经开始自动设计并迭代,但最优方法移到 Claude Sonnet 4 生产训练时,没有取得统计显著改善。便宜实验筛出的候选,仍需要一定程度的 human in the loop。
好的 verifiable environment。需要好的环境和 verifier,来为模型提供反复尝试和学习的任务。科学上,Scalable oversight 要解决的是:当任务多到人无法逐项检查、难到监督者不能直接判断时,怎样仍然给出可靠反馈。工程上,生成 verifier 还要平衡质量与效率。一种实用做法是让 agent 生成正确变体和错误干扰项,检查 verifier 能否区分。
从真实轨迹构建环境:有些开源环境和 benchmark 围绕修复一个 issue 这样的单轮任务构建。真实工作却是连续的任务序列,文件、运行环境和用户目标都在变化。从真实轨迹重建环境,可以让训练更贴近这些工作序列和状态。这里又有三类难点需要解决:
- 文件与运行环境。从轨迹中尽可能恢复文件内容,拼接文件树,再让 agent 补齐和修复缺失部分;同时恢复语言、依赖和构建配置,让环境真正跑起来。
- 任务边界。从模糊的用户 query 中识别任务区间,比如把“继续”这样的请求还原为目标清楚、上下文完整的任务。
- 任务验证。原始回复往往不是最优答案。Verifier 应根据模型行为和真实状态变化判断任务是否完成,避免把复现原回复当成成功。
研究判断中的 taste 与资源分配。哪些问题值得做,哪些实验应该加计算资源,何时该放弃?这些决定缺少现成的短期分数,却决定了实验最终能否留下有价值的发现。Anthropic 对内部研究工作的观察也指出,执行自动化越多,研究方向和 human in the loop 越重要。
RSI 接下来的进展,会来自这些环节一起改善:实验能自主推进,结果能被 scalable verified,再进入下一轮实验和上线,做到真正的 close the loop。但也会有很多与现实世界关系比较大的领域大部分领域可能很难有好的 verifiable environment。
垂直领域的 RSI
除了模型训练和 coding 之外,RSI 很难直接 close the loop。因此我们倾向于一个渐进的顺序:先在 frontier lab 内部形成闭环;再进入目标更明确、反馈更可验证的垂直领域。AI for Science 和 robotics 已经开始在找一些局部闭环,这也能让前面关于 verifiable environment 的讨论变得更具体。
AI for Science:
Anthropic 最近的蛋白设计工作调用了类似 AlphaFold 的专用模型、自动提交实验和分析实验结果,串起来作为一条成熟的工作流。
下一步,就是 Agent 能反过来改进自己的科研工具。Anthropic 让 Claude 优化了 30 多个开源生物分子模型的推理代码和 GPU kernels,再结合更简洁的 prompt、harness 与新版模型。他们提到,做同样水平蛋白设计,使用的 GPU 小时数已经是优化前开源模型的 1/100。
Phylo 发布的 Biomni × TusoAI 也展示了科学模型研发的自动化。Agent 搜索数据和代码,检索文献、改写方法、训练并评估候选。它在一周内测试了 500 个候选,得到结合多源 gene embeddings、回归与 kNN 的基因扰动预测方法。
随着计算环节变便宜,瓶颈会更集中到真实实验反馈的质量与速度。下一步的垂直 RSI,要让系统从有噪声的结果中提炼可信信号,建立新的 assay,并据此改进下一轮的实验选择、工具和模型。这需要科研 taste 和实验自动化的进一步发展。
Robotics:
模型已经不只是接入机器人,也在改进机器人的 policy。Anthropic 的 Project Fetch 第二阶段里,Opus 4.7 完成五项接入与编程任务平均用了 12 分 7 秒,上一轮使用 Claude 辅助的人类团队用了 264 分钟。这个对照显示 coding 能力正在显著压缩机器人研发中的软件工作。
NVIDIA、Stanford 和 UT Austin 的 RoboTTT 则是在优化机器人边做任务边学习的能力:把 fast weights 接入 VLA policy,压缩视觉与动作历史,在执行中吸收刚发生的经验。论文展示了 8K 时间步的 context、单次人类视频示范适应,以及长程装配中的在线纠错,并观察到训练 context 变长时性能持续改善。这让 context length 成为机器人 policy 的一个新 scaling axis。
03 持续学习:定义与关键问题
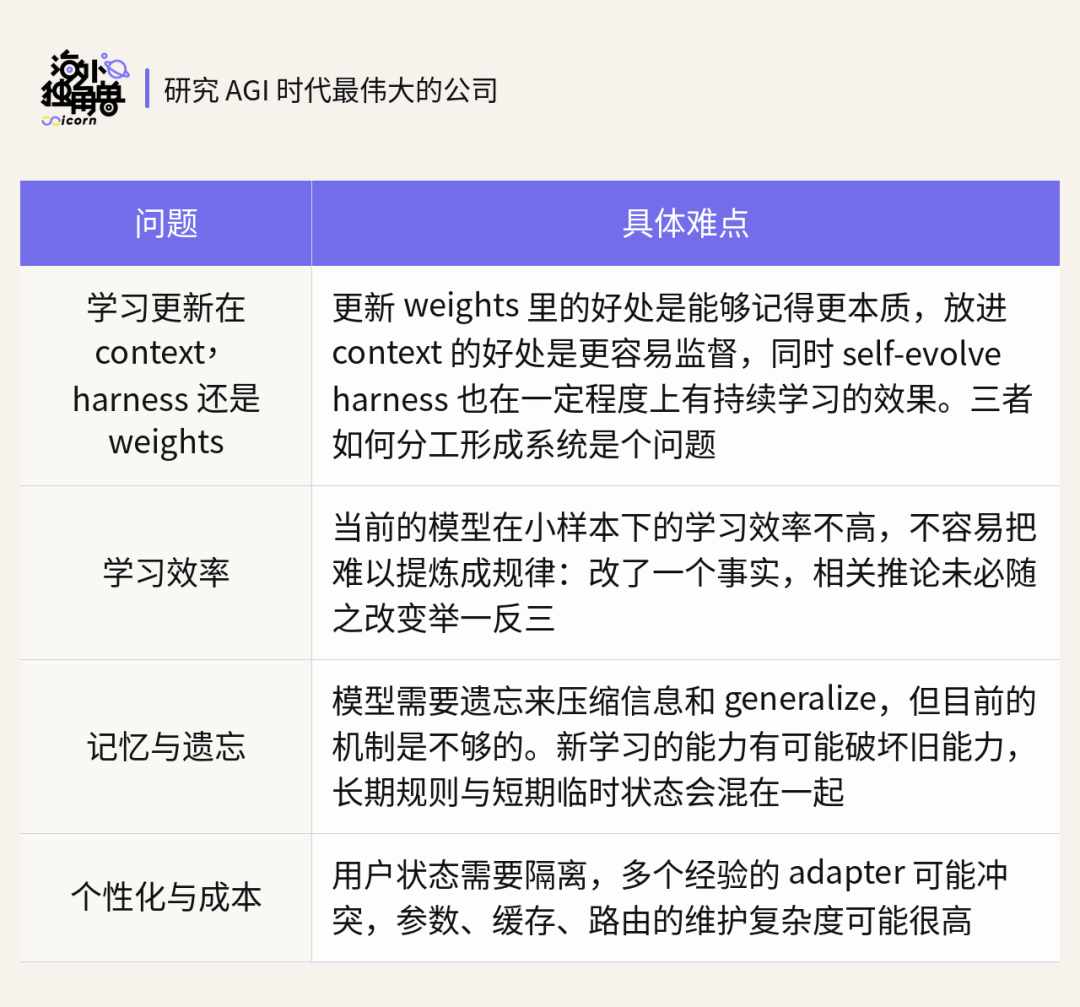
continual learning 的目标更接近学习的本质,要在 experience 中快速转化为 capability 的提升。因此不仅能做 auto research & training,还能做现在大家没在做的东西。比如要解决 data efficiency 不够高,记忆和遗忘机制不够好等问题,就需要更底层的 continual learning。
continual learning 的核心机制分两步:
第一步,怎样获得新的 entropy。在系统和环境中获取新问题,新思路,新 tool。Entropy 可能来自用户和环境,也可能由模型自己产生。
第二步,怎样把 entropy 转换成 learning,把新的数据变成自己能力的一部分。
这个机制的关键是,AI 得到一个新经历,能立刻转化成 knowledge 就是实现了 continual learning。如果需要先把所有经历收集起来,过一段时间再统一训练,就还是已有范式。
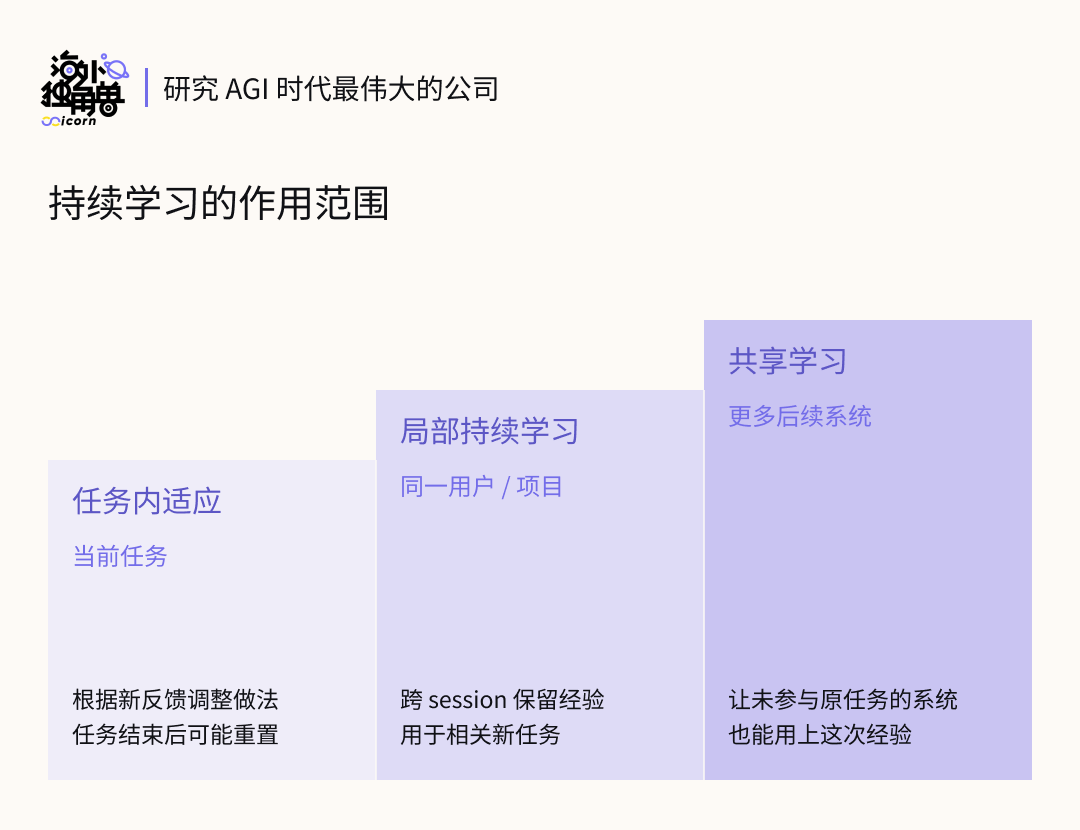
在这个能力下,我们也可以对持续学习的范围进行进一步的分级。其中第一级的实现是现在最重要的目标,让一个任务能够在 long context window 中持续学到信号并且越做越好,这个是当前范式很难实现的。
持续学习范式的核心问题
最大难点:Sample efficiency
软件测试通常可以恢复环境、并行重跑,reward 是很密集,很快得到的。这种环境可以被定义为 grindability,能够切得很碎并且并行的得到 reward 甚至是 process reward,环境能够低成本、并行、可重置地反复尝试。但物理世界工作是没有办法这样 grindable 且 verifiable 的,因此需要在更少的样本点中学习到关键经验。
因此样本效率会是 continual learning 中最关键的难点:环境越难复制,越要从每次真实经验中学到更多。
04 持续学习的技术路线
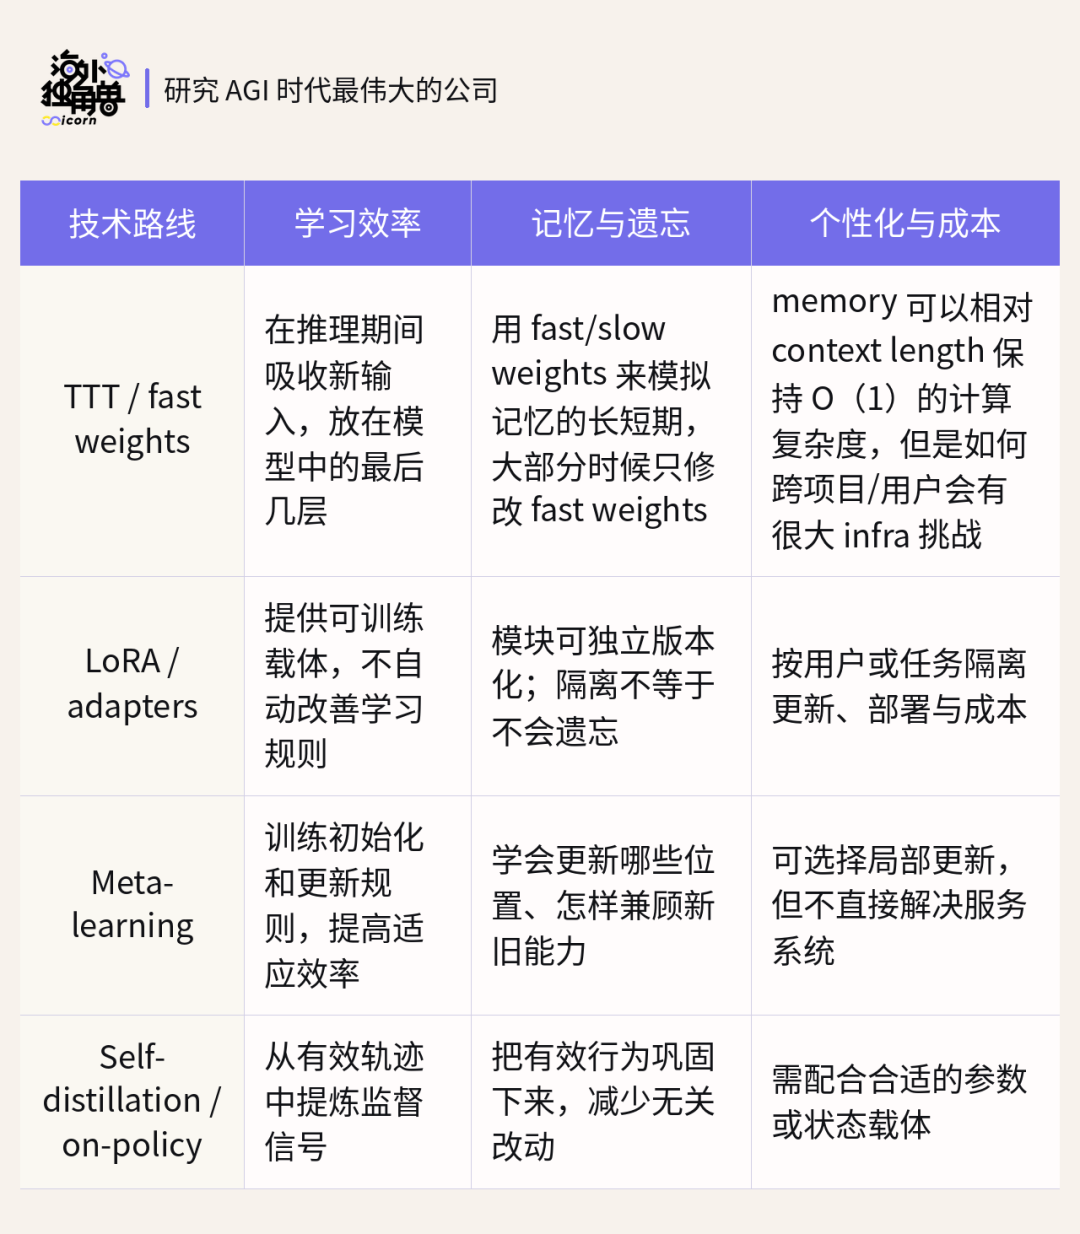
其中 TTT 和 lora 主要解决的是记忆机制和个性化问题,meta-learning 主要解决的是学习机制和 sample efficiency 问题。
TTT / fast weights
Test-time training 这条路线带来了三个重要变化:第一,模型拥有可在线更新的 fast weights;第二,learning 和 inference 可以同时发生;第三,memory 可以相对 context length 保持 O(1)的计算复杂度。
TTT 在模型的最后几层 hidden state 本身设计成可学习的模型,让模型不再是完全的 frozen weights。fast weights 可以压缩很长的任务信息,但系统必须选择哪些内容值得保留。
2025 年底到 2026 年的工作开始尝试把 TTT 接入标准 Transformer,test-time learning 可能是一种新 architecture,也可能慢慢变成现有模型可插拔的 capability。
这一方向有多个工作在沿着不同方向探索:
TTT-E2E 在 sliding-window Transformer 上做 test-time 更新,并在训练时学习适合更新的初始化,让现有架构更善于从长上下文中学习。
In-Place TTT 把现有 MLP 的输出投影矩阵用作 fast weights,在原有 Transformer 内部引入在线更新。
REFINE 用 next-sequence prediction 和序列级奖励训练 fast weights,改善模型对长距离信息的保留。
Falcon 从在线学习的角度设计 fast-weight attention,探索归一化 delta rule 和滑动窗口更新,提高固定大小关联状态的写入效率。
TTT 现在还没有 scale up,接下来要 scale 的关键可能是数据。训练序列需要覆盖不同更新频率,并利用长 trajectory 和后续结果,让模型学会哪些经验值得写入、如何控制干扰与遗忘,以及哪些状态应跨 session 保留。
Adapters/ multi LoRA
LoRA 已经成为 online adaptation 最常见的方法之一,这个思路冻结底座,只训练较小的低秩参数。更广义的模块化更新还包括 adapters、sparse memory layers 等。
Thinking Machines 的 Tinker、Trajectory、River 还有 Fireworks 都已把 LoRA / Multi-LoRA 用于训练或服务。LoRA 可以成为可持久保存的局部状态:用户、项目或领域的经验留在各自的 adapter 中,再按任务选择或组合使用。
这些方法兼容现有 Transformer infra,无需复制或更新全部 weights,也方便分别训练和部署。
模块化路线的核心价值是控制 stability–plasticity tradeoff:把局部 learning 限制在可路由、可删除的 parameter space,降低一次更新破坏整个 base model 的风险。一个可能的 hierarchy 是:fast weights / task-local LoRA 保存短期跨 session 状态,slower adapter 固化稳定 skill,base weights 只吸收跨用户反复验证的通用能力。
这类主要解决个性化与成本,但不会直接带来学习规则,因此很可能未来是和其他方法并存的。模块化路线的核心价值是控制 stability–plasticity tradeoff:把局部 learning 限制在可路由、可删除的 parameter space,降低一次更新破坏整个 base model 的风险。一个可能的 hierarchy 是:
- fast weights / task-local LoRA 保存短期跨 session 状态
- slower adapter 固化稳定 skill
- base weights 只吸收跨用户反复验证的通用能力。
Multi-LoRA 的核心挑战是把可以训练和使用的 adapter 数量 scale up。每个 adapter 的训练和更新必须足够轻量、高效,系统还要做好并发训练、路由和 serving,才能让大量用户与项目拥有持续积累的专有状态。
Meta-learning
SSI 最近 leak 出的消息是在这个方向上有了比较明确的突破。Meta-learning 把模型如何“学会如何学习”也变成训练对象:什么初始化更容易适应和泛化、哪些层应该更新、更新多少,以及什么信息值得留下。它直接瞄准学习效率和记忆管理。
Nested Learning / Hope 把模型看成多个嵌套、不同更新频率的 optimization loop:快模块适应当前 context,慢模块保存更稳定的 knowledge。TTT-E2E 也采用了类似思想,在 pre-training 中 meta-learn 模型,使其在 deployment 时更容易通过 next-token prediction 更新。
2026 年开始有 SCoL 等研究让模型根据当前 context 生成自己的 update instruction,决定哪些 Transformer layers 应该被更新,再用 meta-RL 在连续 experience stream 上训练这个学习策略。
Meta learning 方向其实对应了 TTT 尚未解决的问题:不是所有 fast-weight update 都应该永久保留;系统需要一个 learned gate,决定哪些 experience 值得进入长期记忆也就是 long-term weights。在很早的访谈中 Ilya Sutskever 就把类似能力指向内部 value / steering system:人不需要为每个新任务重新设计 verifier,也能判断尝试是否有价值。
这条路线最有价值的目标,是让系统在陌生任务中也能用少量经验作出合适更新,有不少 researcher 和高价值任务上的科学家都会都发现现在的模型更像是在熟悉分布上学会一套固定方法/ skill。
Self-distillation 和 on-policy learning
最近对 OPSD(on-policy self-distillation)这个方法讨论开始变多,这个是 CL 的学习部分很有潜力的一类算法。这个方法的核心思路是怎么把一个任务 session 中的核心信息,蒸馏回模型中获得能力 improvement。
传统 distillation 会保留一个冻结的 teacher checkpoint,让 student model 模仿 teacher,以减少旧能力流失。这个方法现在还常用在让一个小模型学到大模型的能力和行为,但其实本质是对某种更强能力的学习,因此在持续学习上也会很有用。
continual learning 的关键是新训练信号与模型当前 policy 的距离。on-policy distillation 则试图在不依赖显式 reward function 的情况下,获得类似 online RL 的稳定性。
在 OPSD 方法下,把经历过完整 session 的“veteran”模型蒸馏回 base student。Teacher / student 的 token distribution difference 能提供比终局 reward 更稠密的信号;trajectory-refined distillation 则从 student 自己犯错后的状态继续指导,减少 teacher forcing 的 distribution shift。
模型架构创新是必须的吗?
有 top researcher 认为,continual learning 不一定需要额外的架构创新:一条全新架构从设计到 scale 需要多年,智能增长更可能先来自可长期积累的优化目标与 feedback loop。
Dario 在播客中也做过一些讨论:在 coding 等可外部化领域,现有 Transformer、长 context、RL 与工具系统可能已经足以覆盖大量经济价值,CL 不是必须条件。这从他们做 skills 之类的生态系统也能看出他们的想法。
另一派 researcher 认为,Transformer 并不适合承担真正的 continual learning:
Transformer 的 attention 做 retrieve 本质是 shallow pattern matching,通过关键词匹配找前面类似的问题,把答案 copy 过来,非常浅。
更深的学习应该是,把前面 100 道数学题 compress,提取核心数学逻辑,再用逻辑解决新问题。这是预训练好的原因——通过 compression 提取共用逻辑变成参数。
Sutton 的版本比较根本:当前 LLM 从人类 data 学 imitation,而不是在持续 sensation–action–reward stream 中学习 transition model,现有 gradient descent 也没有保证 good generalization 的机制。
Dwarkesh 的观点处在两者之间:他接受现有模型缺少高吞吐 experience learning,但不认为 imitation learning 与 experience learning 必须二选一。LLM 可以作为强 prior,再通过其他机制 比如 self-distillation 逐渐去逼近 CL 这个目标。
Transformer 之外:RNN、SSM 与混合架构
- RNN:用紧凑状态保存历史。RWKV、xLSTM 等路线的优点是长序列推理时不必保留不断增长的完整历史。缺点是有限 state 会丢失细节,精确回忆大量信息更难。要大规模替代 attention,还需要在复杂任务上证明综合能力,并把能够 scale up 模型有更强的 agentic 能力
- SSM:让状态更新更高效。Mamba 用结构化状态和输入相关的选择机制,控制信息的写入与遗忘,适合高效处理长序列。但压缩记忆与精确检索仍有取舍。专用算子可以提高效率,真正换掉成熟的 Transformer 系统,还需要在大规模训练中证明综合收益。
混合架构:更接近 attention ,保留了的长处。比如 Qwen3-Next 就把 Gated DeltaNet 与 attention 结合,用递归记忆降低成本,同时保留对细节的访问。代价是仍有 attention cache,系统也更复杂。
因此目前更合理的是三种假设由弱到强:
- 现有范式:更长 context、更强的智能下,准备好对持续学习的数据,足以覆盖大部分需求;
- Learning-rule hypothesis:Transformer 还在,但需要 meta-learned fast / slow update、distillation 和 memory gate 等算法上的创新来实现持续学习
- Architecture hypothesis:必须从底层设计可持续更新的模型架构 和 optimization dynamics。
总的来说,RSI 已经在提高智能研发的效率,持续学习则有望让真实使用成为能力增长的来源。这两个飞轮会相互强化:自动化研究帮助我们找到更好的学习方法,更善于学习的模型再加速下一轮研究。
后面的突破,要看模型如何从少量经验中学习到真正的能力提升,以及这是否是当前技术路线可以实现的。这也是我们认为模型真正能长期优势的 flywheel:谁能持续提高经验转化为能力的效率,谁就有让智能的增长斜率保持陡峭。
作者:Cage、Penny
本文由人人都是产品经理作者【海外独角兽】,微信公众号:【海外独角兽】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议


- 目前还没评论,等你发挥!