起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
给 Claude Code 装了个记忆插件,Token 省 10 倍,其他 Harness 也能用


新开会话就失忆,是 Claude Code 最烦人的地方。文章介绍开源插件 claude-mem:五个钩子加一个后台服务如何把干过的活压成摘要、三分钟装完的命令,以及把写记忆的模型换成本地 Ollama 的改法。
用 Claude Code 的朋友,大概都经历过这一幕
昨天陪它修完登录 bug,定好了数据存哪、代码怎么写,今天新开一个会话,它一脸茫然:这个项目是做什么的?
今天介绍的开源插件 claude-mem,专治这个毛病
本文老章就来详解一下:
- 它到底怎么让 Claude Code “记住”的,三张动图讲明白
- 3 分钟装好的命令,以及两个很多人会踩的坑
- Codex、Cursor、OpenCode 等十几款工具也能用
- 装完建议改的 3 个设置,写记忆的模型还能换成 DeepSeek 或本地模型,文末有清单可以直接照做
01 它解决什么问题
一句话:自动把你和 Claude Code 干过的活记下来,压缩成摘要,下次开新会话时自动带上
整个过程你什么都不用做,它在旁边默默记笔记
我做了一个演示,方便大家理解
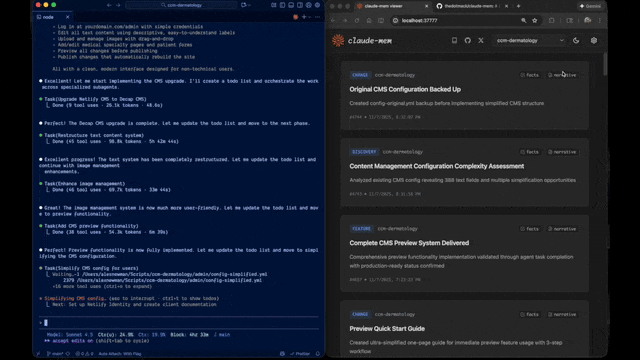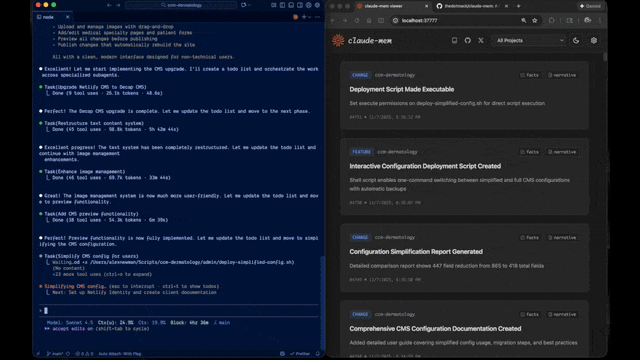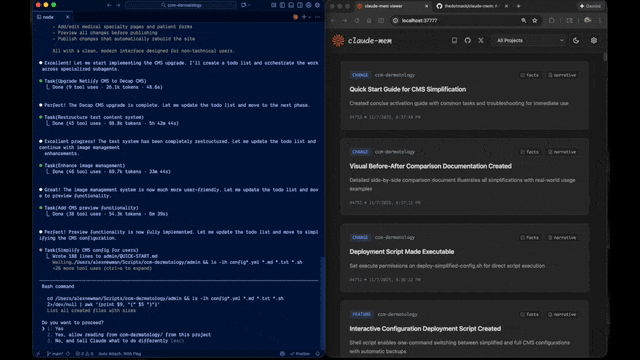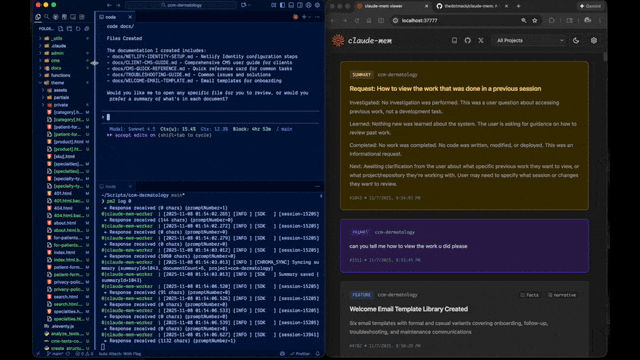
看官方放的演示,记忆是实时写进去的:
02 原理:5 个钩子 + 1 个后台服务
Claude Code 在几个关键时刻会发出信号,插件可以借这些信号插手干活
claude-mem 盯住了 5 个时刻:会话开始、你发出消息、工具调用完、回答停下、会话结束
其中最关键的三个:
- 工具调用完:Claude 每读、写、改一个文件,跑一条命令,claude-mem 都会把工具名、输入、输出交给后台,压缩成一条”观察”,包含类型、标题、事实要点、前因后果和涉及的文件
- 回答停下:Claude 答完一轮,自动生成一份摘要:你要了什么、查了什么、学到什么、做完了什么、下一步干什么
- 会话开始:把最近的观察目录(默认 50 条)和上次摘要塞进新会话
真正干活的是本机上一个 Worker 后台服务,负责收记录、调 AI 压缩、提供搜索,还带一个网页查看器,能实时看着记忆往里写
压缩用的模型默认是 Claude Haiku 4.5,走的是你自己的 Claude 订阅,这一点后面设置部分会细说
记下来的东西存两处:
- SQLite:一个本地数据库文件,存会话、观察和摘要
- Chroma:能按”意思”找内容的数据库,和关键词搜索混着用,找得更准
03 最妙的设计:查记忆分三步走
记忆越攒越多,一股脑全塞给 Claude,既费 token(模型按它计费),又把上下文挤满
claude-mem 的办法很像查资料:先看目录,再看前后,最后才翻正文
- search:返回一份带编号的精简目录,每条约 50~100 token
- timeline:挑中某条,看它前后发生了什么
- get_observations:只把确认要的几条完整取出,每条约 500~1000 token
这三步都是 Claude 自己调用的工具,你不用手动查
按官方说法,先筛再取,大约能省 10 倍 token
节省的原理是“渐进式披露”,说白了就是用多少拿多少,我觉得这是整个项目最聪明的地方,和 Skills 很像
04 怎么装:一条命令
要求 Node.js 20 以上,Bun 和 uv 缺了会自动装
npx claude-mem install
也可以在 Claude Code 里从插件市场装:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
05 装完重启 Claude Code,之前会话的记忆就会自动出现在新会话里
⚠️ 坑一:别用 npm install -g claude-mem,它只装了库本身,钩子没注册,后台服务也没起来,装了等于没装
⚠️ 坑二:安装器最后会弹浏览器让你登录 claude-mem 账号
这是官方的托管服务 claude-mem observer,送 30 天免费试用,期间写记忆不占你的 Claude 额度;试用结束不订阅,就自动退回用你自己的 Anthropic 套餐
不想注册账号,安装时直接指定模型提供方就能跳过:
npx claude-mem install –provider claude
或者先设置环境变量 CLAUDE_MEM_ONLINE_OPTIN=false 再装,在 CI 这类非交互环境里装也不会弹登录
06 不止 Claude Code
名字叫 claude-mem,其实支持的工具一大串,我翻了安装器源码,–ide 参数能选 18 个:
- 钩子或插件深度接入,自动记录:Claude Code、Codex CLI、Cursor、OpenCode、Kimi Code、Antigravity、T3 Code、OMP、Windsurf、DeepSeek Harness、OpenClaw、Hermes Agent
- 通过聊天日志接入:Grok Bot
- 只接 MCP 搜索:Copilot CLI、Goose、Roo Code、Warp
- Pi:目前以手动调取记忆为主,自动记录要看兼容情况
装法都一样,换个参数:
npx claude-mem install –ide opencode
npx claude-mem install –ide t3code
npx claude-mem install –ide dsh –dsh-profile tui
OpenCode 要求 1.3.4 以上;T3 Code 会把 Codex 和 Claude Code 两边都装上;dsh 就是 DeepSeek Harness
还有个很实用的开关:同时用 Claude Code 和 Codex 的话,在设置里加上 “CLAUDE_MEM_SESSION_START_INCLUDE_ALL_SOURCES”: “true”,开新会话时会带上所有工具攒下的记忆,在 Codex 里干的活,切回 Claude Code 也接得上
默认是关的,只带当前工具自己的记忆
07 装完建议改的 3 个设置
① 让记忆用中文写
编辑 ~/.claude-mem/settings.json:
{
“CLAUDE_MEM_MODE”: “code–zh”
}
简体中文模式已经内置,改完重启 Claude Code 就行
② 换个模型写记忆
每条观察、每份摘要都要调一次 AI,默认用 Claude Haiku 4.5,消耗的是你的 Claude 额度
CLAUDE_MEM_PROVIDER 支持 claude、codex、gemini、openrouter、openai-compatible 五种,最后一种能接任何兼容 /chat/completions 的接口,DeepSeek、NVIDIA NIM、Ollama、LM Studio 都有现成预设
用 DeepSeek:
{
“CLAUDE_MEM_PROVIDER”: “openai-compatible”,
“CLAUDE_MEM_OPENAI_COMPAT_PRESET”: “deepseek”,
“CLAUDE_MEM_OPENAI_COMPAT_API_KEY”: “你的 DeepSeek Key”
}
预设默认模型是 deepseek-chat,想换就再加一行 CLAUDE_MEM_OPENAI_COMPAT_MODEL
用本地 Ollama 不需要 Key,把预设改成 ollama,再用 CLAUDE_MEM_OPENAI_COMPAT_MODEL 填上你 ollama list 里的模型名,记忆就完全不出本机了
③ 敏感内容别让它记
用 <private> 标签包起来的内容不会被存下来,密钥、客户数据这类记得包一下
08 总结
最后给一份清单,转给身边用 Claude Code 的朋友,照着做就行:
- npx claude-mem install,装完重启;不想注册账号加 –provider claude
- 别用 npm install -g
- 用的不是 Claude Code,加 –ide 参数,比如 –ide opencode
- 设置里改成 code–zh,记忆用中文
- 嫌费额度,写记忆的模型换成 DeepSeek 或本地 Ollama
- 敏感内容用 <private> 包起来
我准备在自己的写作项目上装着跑一阵,记忆攒多了效果怎么样,回头再跟大家汇报
作者:Ai学习的老章 公众号:Ai学习的老章
本文由 @Ai学习的老章 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议

- 目前还没评论,等你发挥!