
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
1:1 复刻 DeepSeek App,实测,有差距!


把 DeepSeek 开源的 chat-demo 在本地跑起来,登录、联网搜索、深度思考、读文件、语音都能对上,但同一道题的搜网页数量、工具调用链路和定价核对,Demo 与官方 App 还能看出差距。
DeepSeek 前两天开放了全家桶应用 API,联网搜索、深度思考搜索、读文件、读链接、语音,App 里那套能力全部能 API 调用
官方原话:开发者用新 API,甚至可以 1:1 复刻出完整的 DeepSeek App
光说不练没意思,DeepSeek 自己还开源了一个聊天 Demo,我周末把它跑起来实测了几个问题,与官网做对比
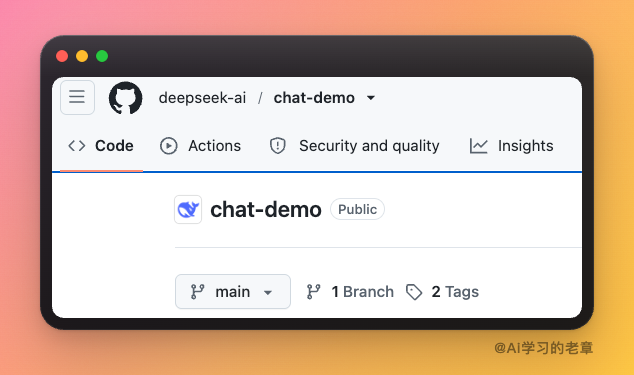
按照 README步骤安装即可,想省事儿可以用它的在线演示版
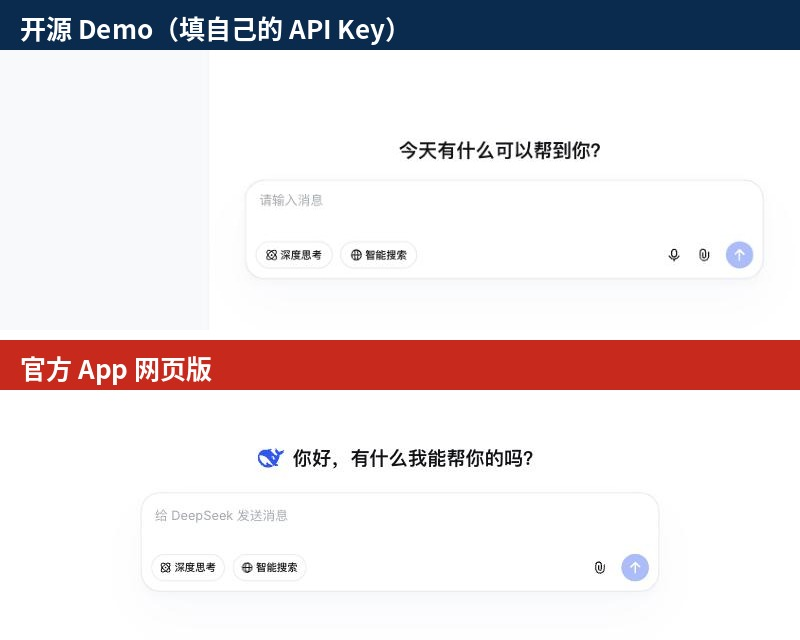
第一次打开会弹出设置页,让你填自己的 API Key,Key 只存在你自己电脑的本地存储里
和官方 App 放在一起看,除了欢迎语和 logo,布局几乎一模一样:
设置里能换主题、换语言、选朗读音色、填位置信息,数据管理里还能导入 DeepSeek 官方导出的历史对话压缩包:
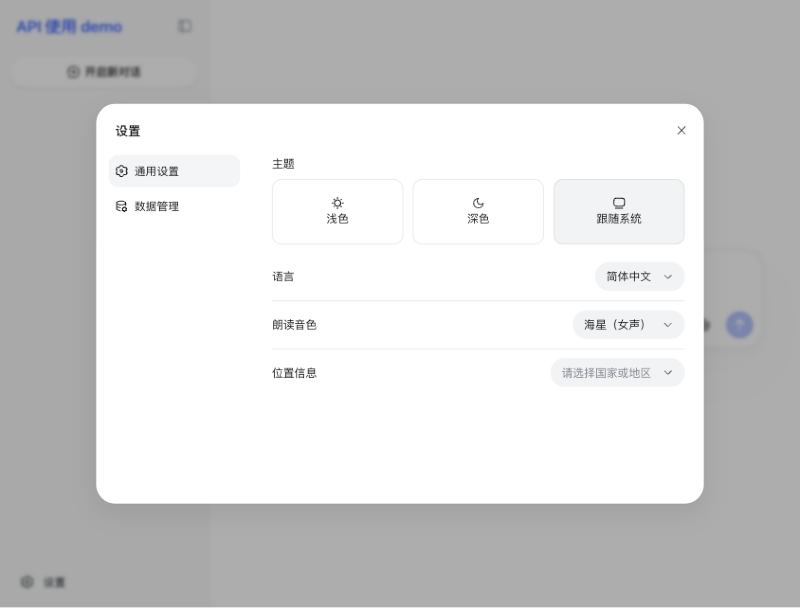
想自己部署也简单,装好 Node.js 22.12+ 和 pnpm 之后执行几个脚本就OK了:
cd chat-demo
pnpm install
pnpm dev
打开 localhost:8090 就能用,pnpm build 之后的 dist/ 丢到任何静态服务器上都行
拆开看:它是怎么「复刻」App 的
我把发出去的请求截了下来,一次对话请求里装了这么几样东西:
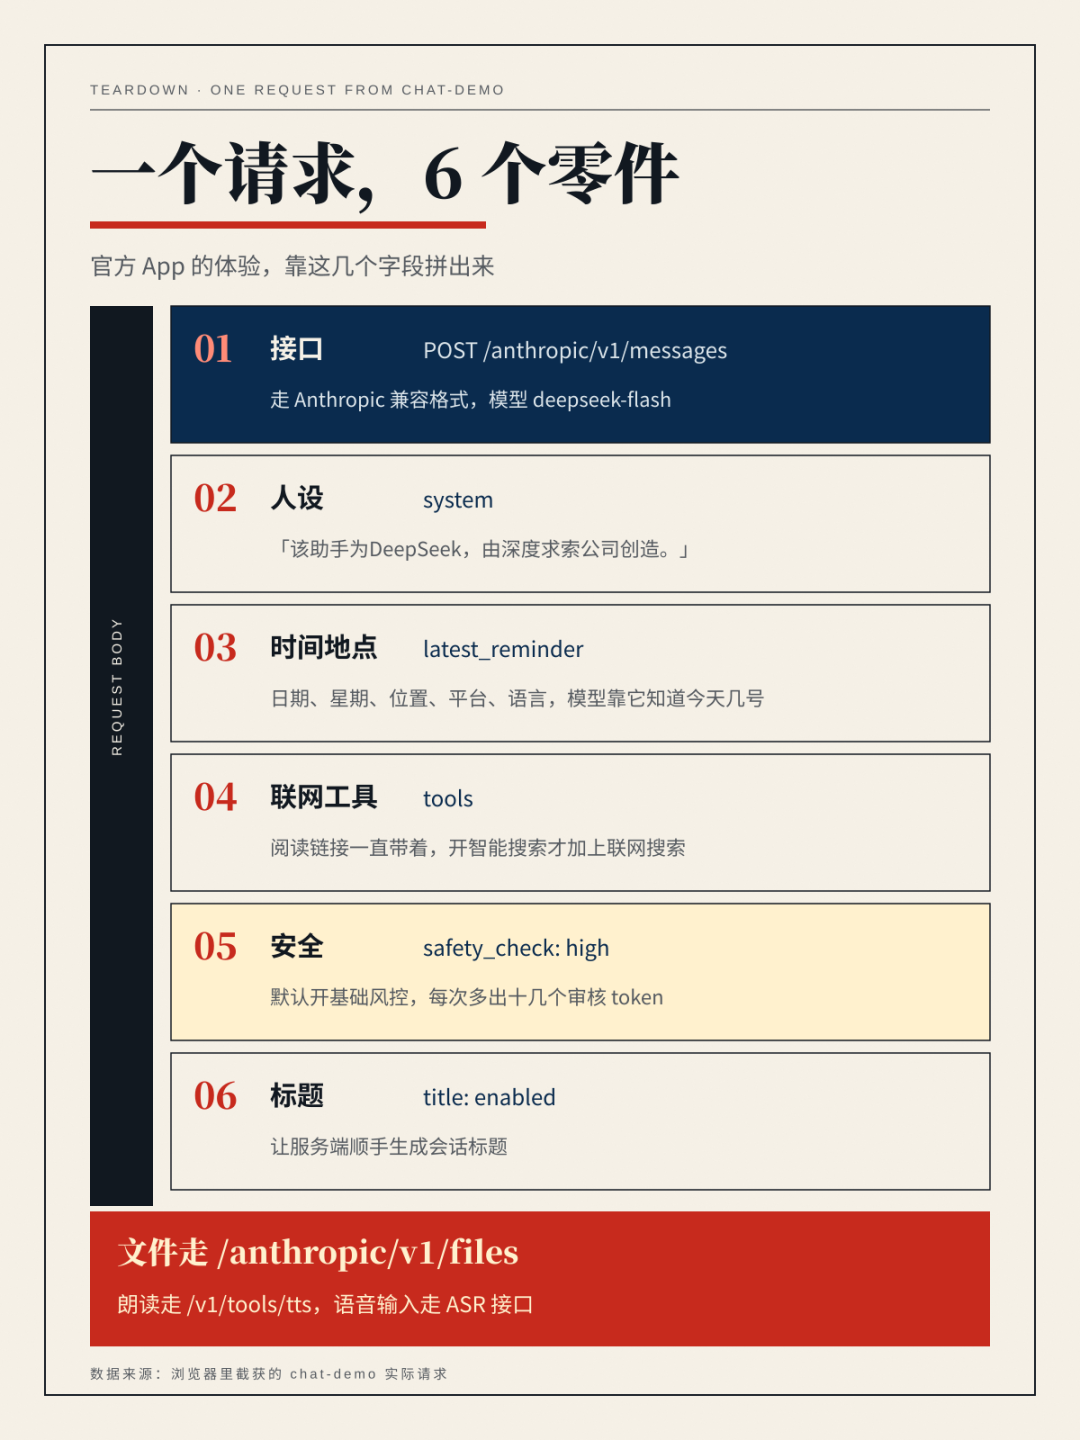
贴一个深度思考搜索时的真实请求体,问题内容我省略了:
{
“model”: “deepseek-flash”,
“system”: “该助手为DeepSeek,由深度求索公司创造。”,
“messages”: [
{“role”: “latest_reminder”, “content”: “2026-11-15,星期日,,Web,中文”},
{“role”: “user”, “content”: “……”}
],
“thinking”: {“type”: “enabled”},
“safety_check”: {“level”: “high”},
“tools”: [
{“type”: “deepseek_read_url”, “name”: “deepseek_read_url”},
{“type”: “deepseek_web_search”, “name”: “deepseek_web_search”}
],
“title”: {“enabled”: true},
“stream”: true
}
几个有意思的点:
- 人设就一句话:「该助手为DeepSeek,由深度求索公司创造」,没有长篇大论的系统提8示词
- latest_reminder 是个新角色:官方叫它「用户元信息标记」,格式是「日期,星期,所在地,平台,语言」,模型就知道今天几号、你在哪,我没填位置,所以中间是空的,官方 App 每一轮都会带这一条
- 安全校验默认开到 high:每次回复多出十几个审核 token,量很小,官方说对外提供服务的开发者必须开这个,Demo 直接替你开好了
- 会话标题让服务端顺手生成:左侧栏那些「三家旗舰API价格对比」之类的标题就是这么来的
说白了,App 的体验 = 模型 + 这几个参数 + 一个前端
想做自己的版本,照着这个请求体改就行
官方还给了一份「复刻说明书」
DeepSeek 文档里新开了一个「构建 Chatbot」专区,等于是把 App 拆成零件逐个讲,想自己动手的建议直接从这里看起
它把 App 的功能和 API 一一对上了:
| App 里的功能 | API 里怎么开 |
|---|---|
| 联网搜索 | 声明 deepseek_web_search,关闭思考 |
| 深度思考搜索 | 声明 deepseek_web_search,开启思考 |
| 阅读链接 | 声明 deepseek_read_url |
| 上传文件 | 先传 Files API,对话里引用 file_id |
| 内容安全 | safety_check
设为 high |
| 日期、所在地、语言 | latest_reminder
消息 |
| 会话标题 | title
设为 enabled |
| 朗读回答 | 语音合成接口 |
| 语音输入 | 语音识别接口 |
三种协议都能用,deepseek-flash 模型:
- Messages:/anthropic/v1/messages(Demo 用的就是这个)
- Responses:/responses
- Chat Completions:/chat/completions
最实用的是这张图,官方把一次回复里的每种内容块,对应到网页端界面的哪个位置都标出来了:思考过程、搜索结果卡片、打开的网页、带引用角标的正文
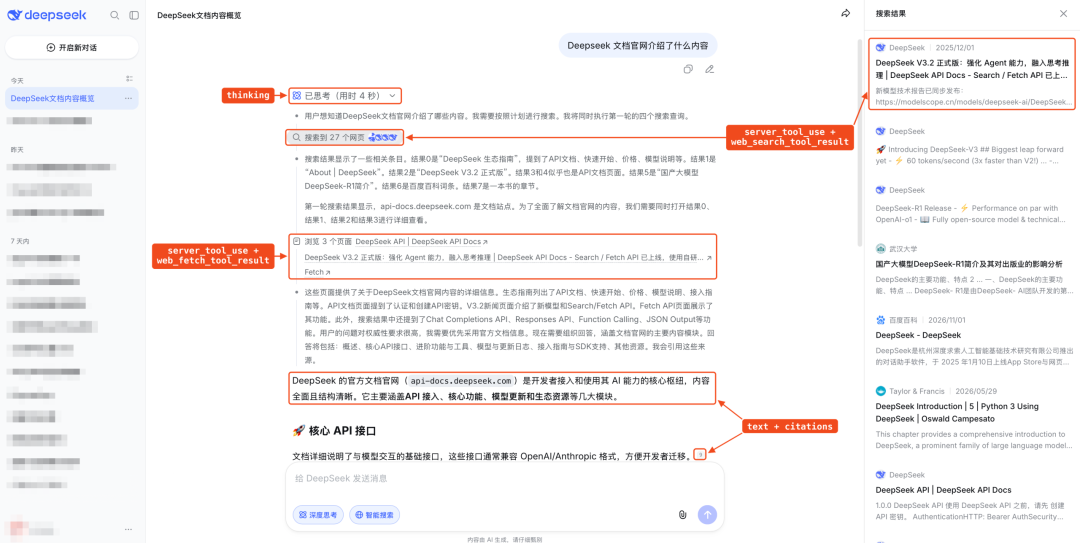
照着它渲染,你的界面就能和官方一模一样
另外三个坑很容易被忽视:
- 开了联网工具、安全校验或会话标题之后,temperature、top_p 这些采样参数会被服务端忽略,传了也白传
- max_tokens 限制的是每一步推理的输出长度,不是整轮回答的总长度
- latest_reminder 后面必须紧跟一条用户消息,否则直接报错;Responses 协议不支持它
实测 1:联网搜索,打平
问题:DeepSeek 最近发布的「全家桶应用 API」开放了哪些能力?联网搜索、网页抓取、文件解析分别怎么收费?
这题答案我提前在官方定价页核对过
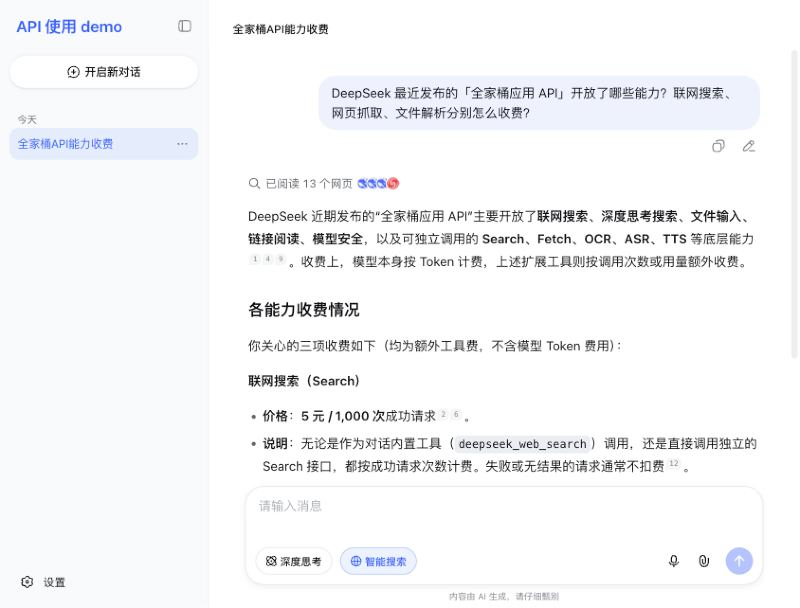
Demo 搜了 13 个网页,官方 App 搜了 14 个,两边给的联网搜索、网页抓取价格都对,都带角标引用
有个小差别:Demo 这次把文件解析说成「没有统一的固定单价,只列出了文字识别 1.5 元/千页」,官方定价页其实写的是文件解析和文字识别同一个价
App 那边答得更干脆
这种细节属于每次生成的随机波动,算打平
实测 2:深度思考搜索,打平,但这次花得多
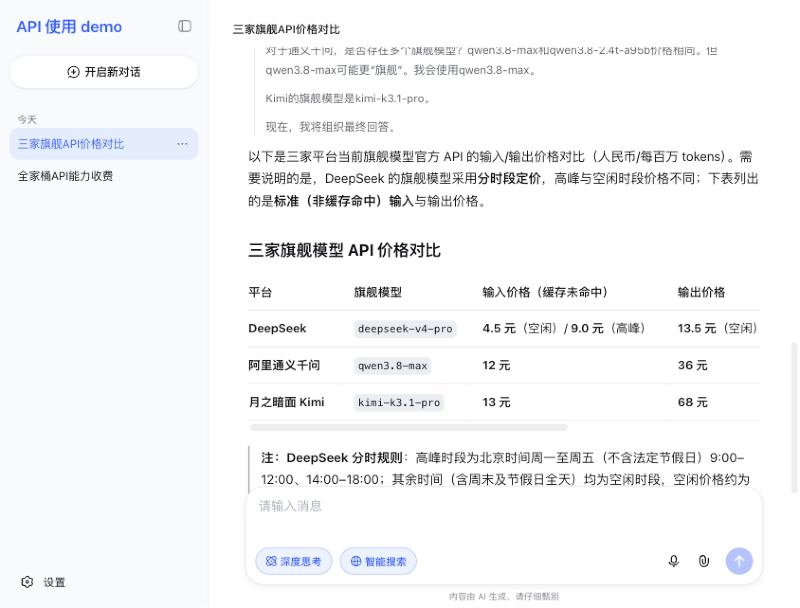
问题:对比 DeepSeek、阿里通义千问、月之暗面 Kimi 三家官方 API 目前旗舰模型的输入和输出价格,列表给出,并附上官方来源链接
这是典型的多步任务:先搜,再打开各家官方定价页核对
Demo 的过程完整展示出来了:先搜到 35 个网页,发现搜索结果里混着自媒体文章,于是去打开 4 个官方页面,又补搜了一轮 23 个网页
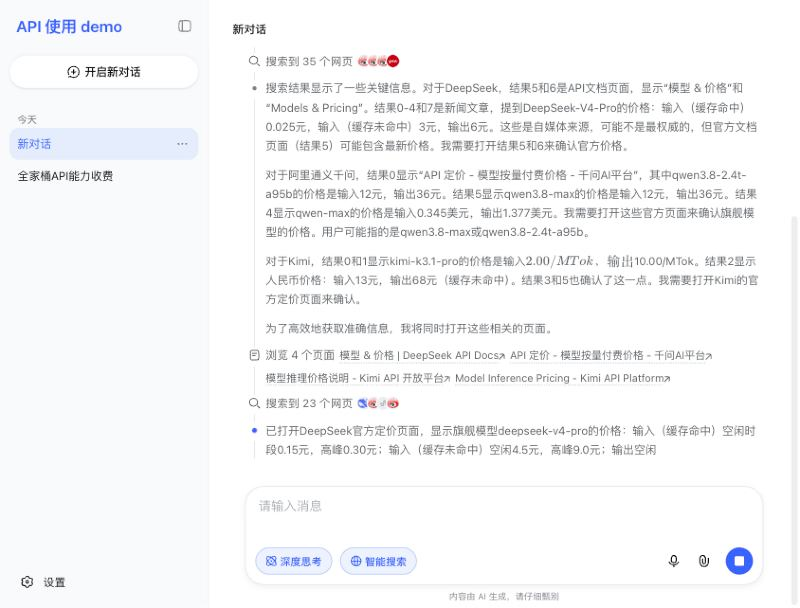
最终 Demo 的表格:
官方 App 的表格:
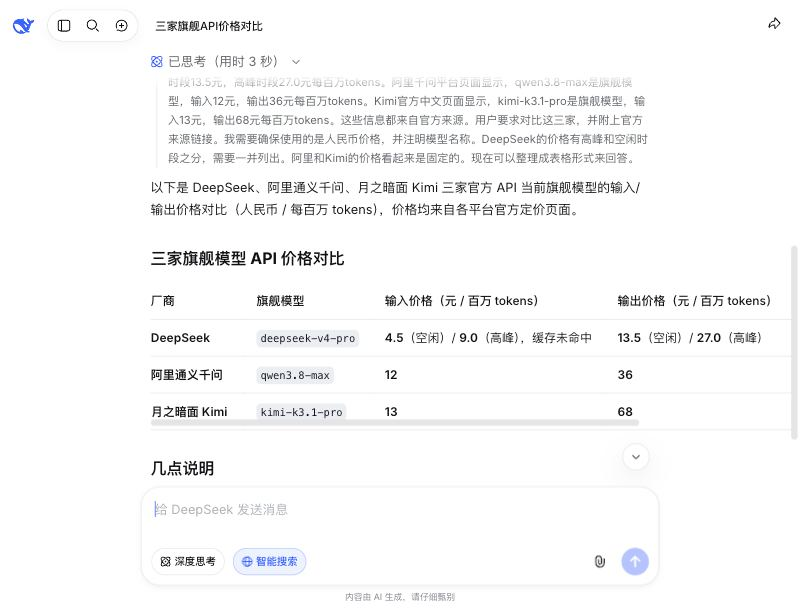
DeepSeek、千问、Kimi 三家的数字两边完全一样,DeepSeek 那一行我对过官方定价页,是对的
细心的朋友可能发现了,上面过程截图里有一行「输入 2.00/MTok」被渲染成了斜体公式,这是 Demo 把美元符号当成了数学公式的定界符,算个小 bug,不影响最终答案
账单方面,Demo 这一题 10.5 秒出完,按计费字段算:
- 搜索:9 次,4.5 分钱(两轮搜索一共发了 9 个关键词)
- 打开网页:4 次,没有单独计费
- Token:输入约 1.4 万、输出 1842(其中思考 975),约 2.2 分钱
- 合计约 6.7 分钱
前一天我直接调 API 跑同一道题,模型只搜了一轮 3 个关键词,合计 2.8 分钱
搜几轮、拆几个关键词是模型自己决定的,同一道题两次跑下来能差一倍多
搜索按关键词个数收钱,这是做联网应用最需要注意的隐藏成本
实测 3:阅读链接,打平
问题:deepseek-a的chat-demo 这个项目是做什么的?怎么部署?用到了 DeepSeek 的哪些接口?
刚好让 Demo 读它自己的仓库
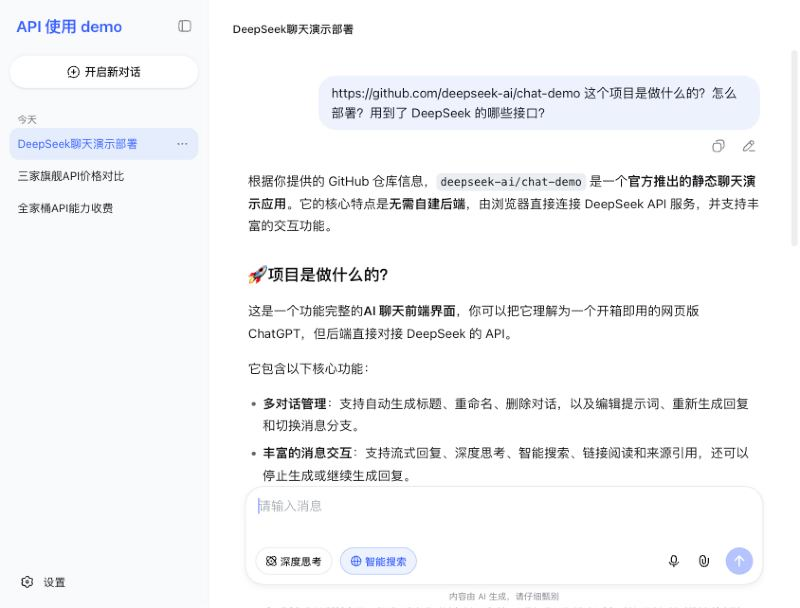
4 秒读完,项目定位、四种部署方式、用到的接口全都对得上 README,和官方 App 的回答几乎逐段一致
这一题花了约 0.9 分钱,其中网页抓取 1 次 0.5 分钱
实测 4:读 PDF,翻车了
测试文件是我自己做的:一页 PDF,里面只有一张柱状图,标题「各月售出杯数」,7 月 41,200 杯、8 月 56,800 杯、9 月 38,900 杯,8 月那根柱子是红色,另外两根是灰色
问题:哪个月卖出的杯数最多,比最少的月份多多少杯?哪根柱子颜色和其他不同?
Demo 的回答:
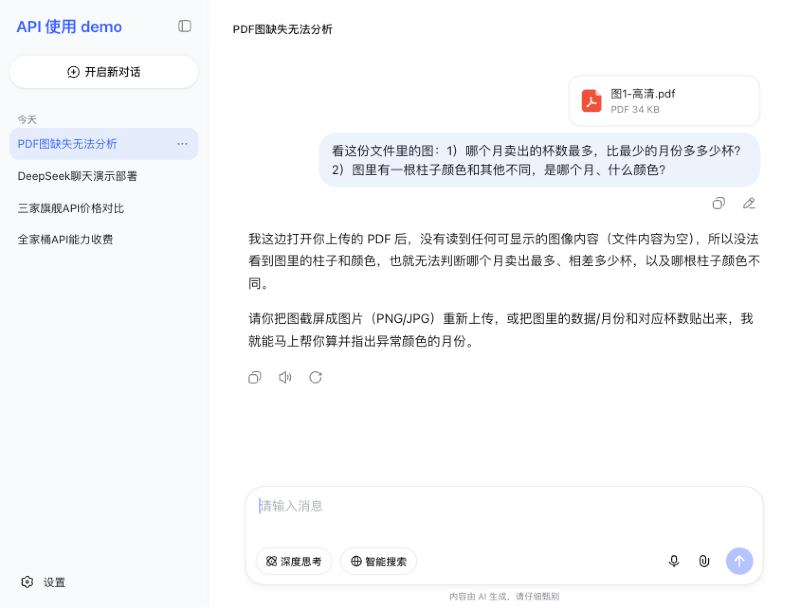
它说文件内容为空,什么都没读到
同一个文件丢给官方 App:
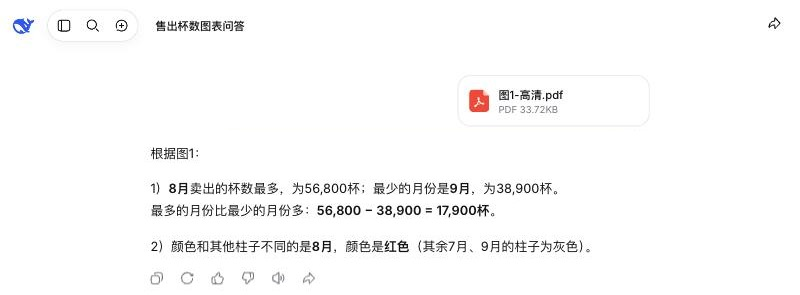
8 月、17,900 杯、红色,全对
这就奇怪了,同一个模型、同一个文件,差在哪?
我把 Demo 的请求翻出来看,它上传文件时用的是图文混排解析(rich_layout_recognition),这个模式本来就会把文档里的图裁出来交给模型,选得没错
问题出在上传的入口
Demo 走的是 Anthropic 兼容的 /anthropic/v1/files,我拿同一个 PDF 分别从两个入口各传了一次:
| 上传入口 | 解析方式 | 模型拿到的输入 | 回答 |
|---|---|---|---|
| /files
(OpenAI 兼容) |
图文混排 | 283 tokens,含图 | 8 月、红色,全对 |
| /anthropic/v1/files
(Demo 用的) |
图文混排 | 66 tokens,只有问题本身 | 说文件是空的 |
Demo 那一侧我前后传了两次,结果都一样
带文字的普通 PDF 走 Anthropic 入口是正常的,我另外测了一份纯文字的报告,能正常回答
所以目前的情况是:纯图片、扫描件这类 PDF,经 Anthropic 兼容入口上传后,图里的内容没进到模型那里
这更像是服务端的问题,Demo 只是刚好踩中了
临时办法也简单,直接把图截出来当图片传,Demo 立刻就能读:
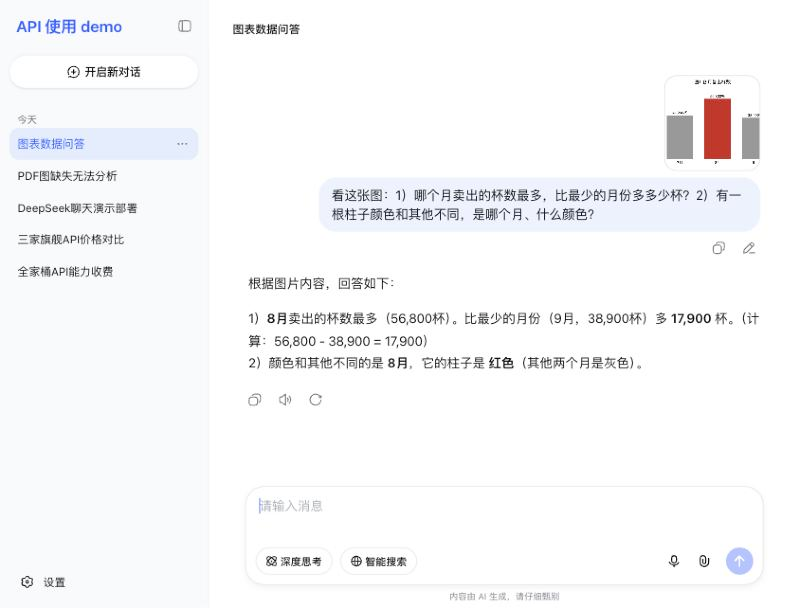
如果你是自己写代码接 API,读扫描件就走 /files 这个入口
顺带提醒一句,前一天我用 API 测过另一种解析方式 text_recognition(只提取文字),同样这张图,它把 56,800 安到了 7 月头上,还编出了「橙色柱子、其他为蓝色」,有图表的文档千万别选它
朗读:能用
回答下面那个小喇叭点一下就开始朗读:
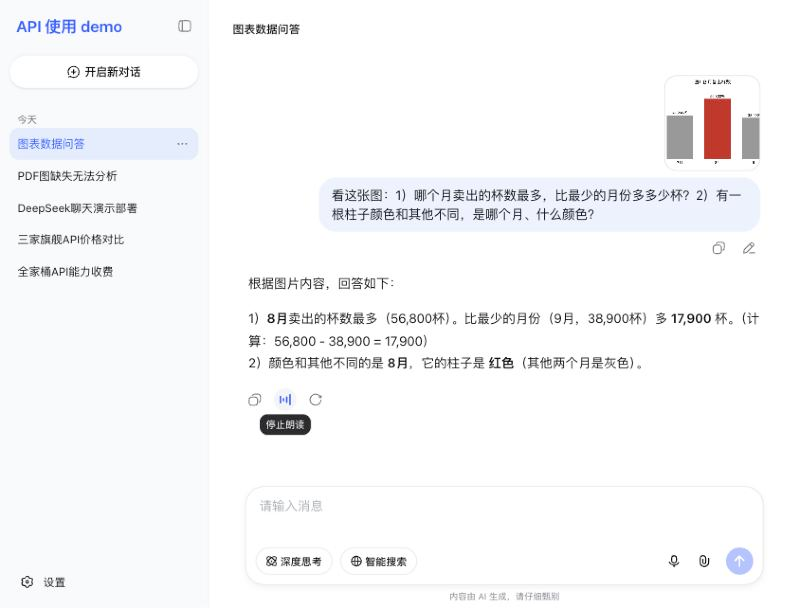
背后调的是独立的语音合成接口 /v1/tools/tts,默认音色是「海星(女声)」,会自动过滤掉 Markdown 符号
这段一百多字的回答,4.4 秒拿到整段音频
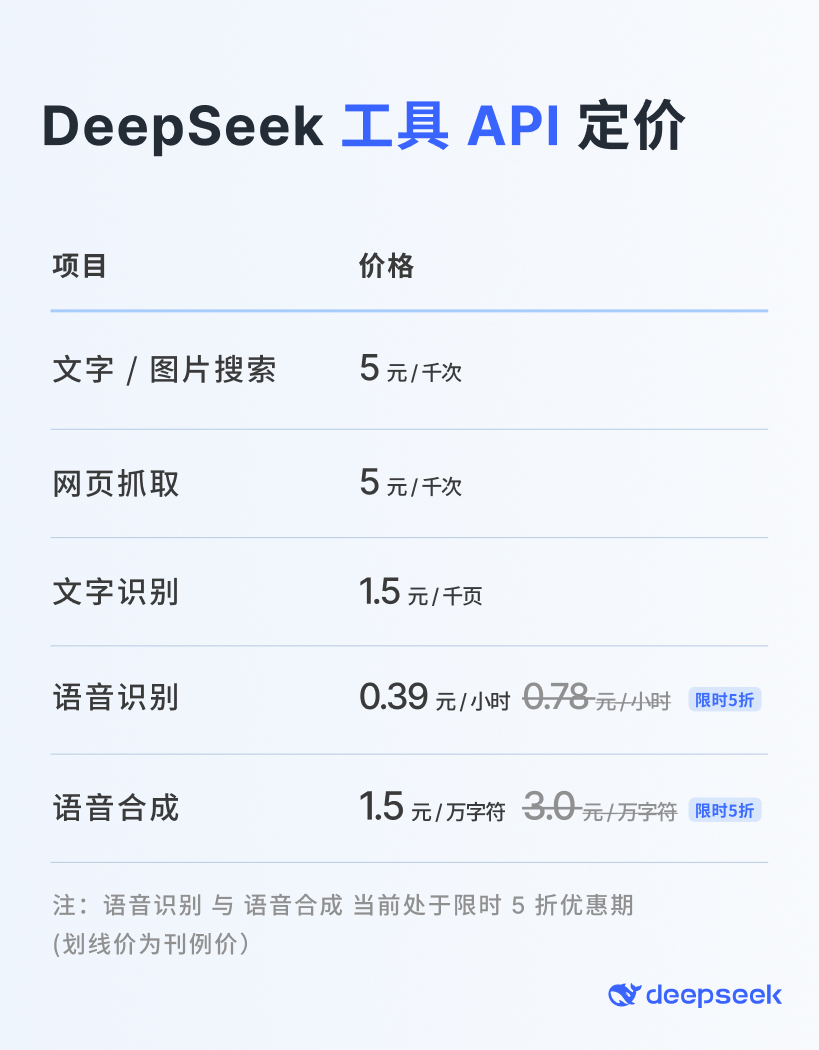
语音合成现在限时 5 折,1.5 元/万字符,这段朗读的成本可以忽略
账单:全部测下来 2 毛 1
官方工具定价:
模型本身 deepseek-flash 的价格(每百万 tokens):输入缓存命中 0.02 元、未命中 1 元,输出 4 元
这是空闲时段价格,工作日 9:00-12:00、14:00-18:00 高峰时段翻倍,周末全天都是空闲价
我这两天的测试,周六直接调 API 测了一轮,周日用 Demo 又测了一轮,中间还为了定位 PDF 的问题多调了十几次
账户余额从 9.99 元到 9.78 元,一共花了 2 毛 1
按单题算个大概:
| 场景 | Demo 单题花费 | 主要花在哪 |
|---|---|---|
| 联网搜索 | 2 到 3 分钱 | 搜索按关键词计费 |
| 深度思考搜索 | 3 到 7 分钱 | 搜几轮由模型决定 |
| 阅读链接 | 约 1 分钱 | 抓取 1 次 0.5 分 |
| 读 PDF | 1 页 0.15 分 + 问答零点几分 | 基本可忽略 |
| 朗读 | 百来字不到 0.1 分 | 基本可忽略 |
一个人自用,每天问 30 个要联网的问题,一个月大概二三十元,看模型搜得勤不勤
官方 App 是免费的,单纯自己聊天没必要换
值得花这个钱的,是想把这套能力接进自己的产品或工作流的人
槽点
- 扫描件 PDF 读不出:上面说的,纯图片 PDF 走 Demo 读成空白,临时办法是把图截出来按图片上传
- 成本不好预估:同一道深度搜索题,这次 9 次搜索,上次 3 次,差了一倍多
- 小 bug:美元符号会被当成公式渲染,数字带 $ 的内容看着别扭
- Key 存在网页本地:自己用没问题,要是部署出去给别人用,Key 会暴露在前端,得自己加一层后端
- 对外服务有合规义务:官方明确要求对外提供服务的开发者开启安全校验,并承担内容审核、大模型登记、AI 标识等义务
谁该用,怎么上手
- 想尝鲜的普通用户:打开在线版,去 DeepSeek 开放平台申请 Key、充点钱,设置里填上就能用,体验和官方 App 基本一样,只是按量付费
- 想做自己 AI 应用的开发者:先看官方文档的「构建 Chatbot」专区,再拿 Demo 当参考实现,请求体照抄,读文件的上传入口换成 /files
- 只想日常聊天的人:继续用官方 App,免费,还没有扫描件的坑
写在最后
测完回头看,这次开放影响最大的,可能是别人家的产品
过去一两年,不少 AI 产品的卖点就是「模型 + 联网搜索 + 文件解析」:AI 搜索、文档问答、拍题讲题、各种套壳助手,它们的护城河,很大一部分是把这些工具接好、调顺
现在这套工程被打包进了几个参数,官方还附送了一个开箱即用的前端,任何开发者很快就能做出接近官方的效果
这类产品要么找到模型厂商给不了的东西,比如私有数据、垂直场景、更好的交互,要么就会被挤压
反过来,受益最大的是本来就有场景、只是缺基础设施的小团队
DeepSeek 这边还提了一个说法:下一个超级 App,可以是只属于你一个人的超级 App
这句我持保留意见
做一个 App 的门槛确实降了,Demo 填个 Key 就能跑
但真正的门槛从来不只在开发:大多数人说不清自己到底想要什么,做出来之后也没人维护,接口会改、账单会涨、依赖会坏,扫描件读不出这种问题也得自己去查
只服务一个人的 App,也意味着只有一个人给它修 bug
而且一旦分享给朋友用,它就不再只属于你,Key 的安全、内容审核、登记和标识这些事也随之而来
所以更现实的版本是:大多数人继续用官方 App,少数有明确、长期、重复需求的人,值得拿这个 Demo 改一个自己的
#DeepSeek #API #开源 #联网搜索 #AI应用开发
作者:Ai学习的老章 公众号:Ai学习的老章
本文由 @Ai学习的老章 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议

- 目前还没评论,等你发挥!