起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
实习生1天消耗1亿Token被约谈:如何衡量Token的ROI

当一位实习生因一天消耗1亿Token却只产出十几行代码被约谈,AI Coding时代的效率焦虑被彻底摆上台面。Token消耗与代码产出之间,究竟该用什么标尺来衡量?当Input而非Output成为成本黑洞,当“每行代码成本”被证明是伪指标,从Token单价到单位任务成本,行业的算账逻辑正在经历一场根本性重构。本文拆解AI Coding的Token ROI迷思,并从个人和团队层面给出可直接落地的优化方法。
先把账算清楚:1亿Token到底是什么概念
先建立一个直观的认知。以国内主流大模型的定价来算,1亿Token大约值多少钱:
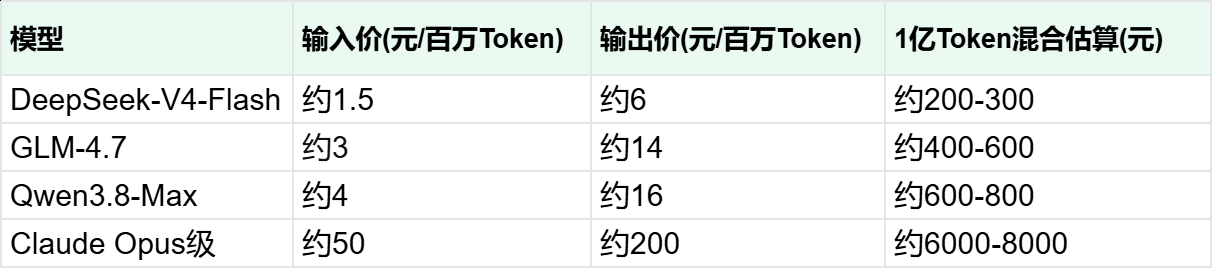
不同模型差距很大。用Flash级模型,1亿Token也就两三百块钱,一个实习生一天的工资应该不止这个数。用顶级模型,一天烧掉大几千,确实有点多。
但钱只是表象。真正的问题是:这些Token花出去了,换回来的是什么?
实习生的帖子里,一天下来”只更新了十几行代码”。如果只看产出行数,1亿Token/15行≈666万Token/行,看着是有点高。但如果这十几行代码改的是一个藏得很深的接口bug,或是新增一个及其底层的能力,那这笔账是不是值得?
这就是AICoding时代最拧巴的地方:我们还在用工业时代的产出指标(行数、功能点),去衡量一个完全不同的生产方式。
Token都花哪去了:Input才是成本黑洞
很多人对Token消耗的想象是:我说一句话,模型生成一段代码,消耗的Token就是生成的那几行。
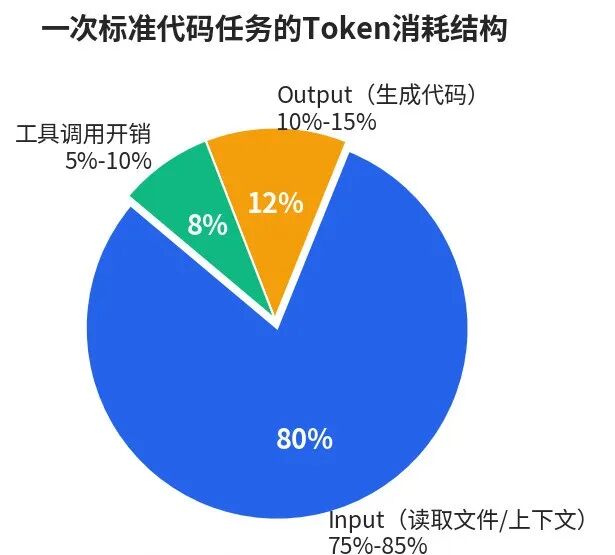
实际情况不是这样。一组实测数据显示,一次标准的代码重构任务中,Token消耗的结构是这样的:
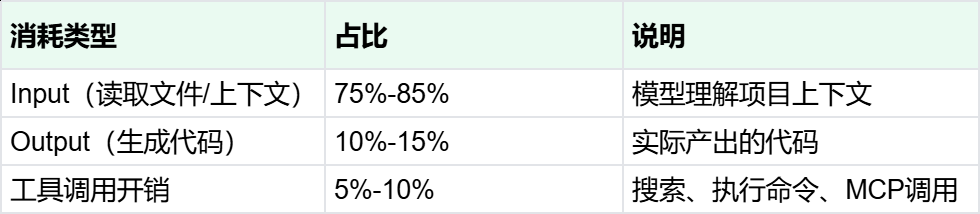
可见,Input Token 才是真正的成本大头。
这就解释了实习生的困境。他让Agent”把相关代码都读一遍”,一个中型项目随便几个文件加起来就是几万行。Agent每一轮对话都要把这些文件内容重新喂给模型,一轮几万Token,十几轮下来就是几十万。如果他还开了新对话,上下文又得从头传一遍,消耗直接翻倍。
更狠的是Agent的循环机制。如果没有上下文裁剪策略,累计Token消耗接近二次增长,10轮轻松突破几十万Token,成本压力极大。
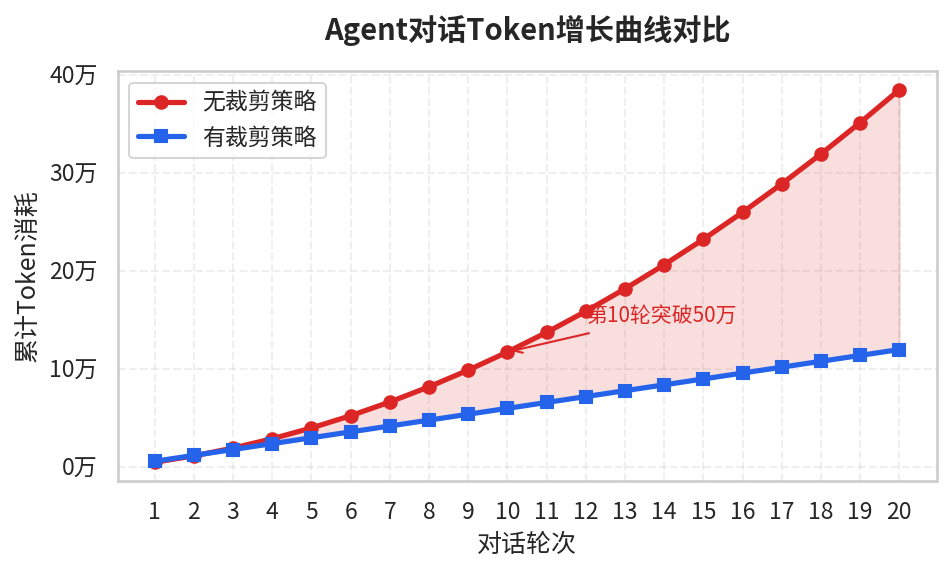
为什么会这样?因为Agent每做一步决策,都需要把之前所有的对话历史、文件内容、执行结果都重新输入给模型。你以为它在”思考下一步”,实际上它每次都在”重新读一遍所有东西再思考”。
理解了这一点,才能理解为什么”改十几行代码”可以烧掉上亿Token——那些Token可能不是花在写代码上,而是花在”读代码、理解上下文、试错、再读一遍”的循环里。
用”每行代码成本”,这是个伪指标
很多团队第一次审计AI Coding成本时,第一反应是算”每生成一行代码花了多少Token”。这个指标看起来直观,实则极具误导性。
原因有三。
第一,代码行数不代表价值。删除500行冗余代码可能比新增50行更有价值,但按行数算,删除是”负产出”。一个关键的bug修复可能只改了一行,但这一行代码背后是几个小时的排查和验证。
第二,AI生成的代码不等于有效代码。模型吐出100行,你最后可能只保留了20行,剩下80行要么逻辑有问题,要么风格不对,要么方向跑偏了。按”生成行数”算效率,等于把垃圾也计成了产出。
第三,探索性工作的价值无法用行数衡量。实习生刚入职,让Agent把整个模块的代码读一遍、画出调用关系、解释核心逻辑——这个过程可能一行代码都没改,但价值巨大。
每完成一个有效任务花了多少钱
2026年以来,行业的评估口径正在从”Token单价”转向”单位任务成本”(Cost Per Task)。
SWE-bench是目前最权威的代码Agent基准测试之一,它给Agent一个真实的GitHub issue,看它能不能独立修复。下面是不同Agent在SWE-bench上的表现对比:
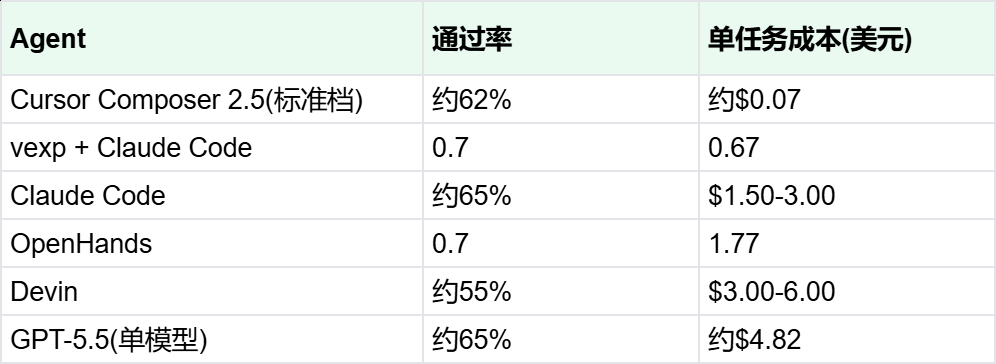
注意看,GPT-5.5和Cursor Composer的通过率只差几个百分点,但单任务成本差了将近70倍。
这就是”任务成本”视角的威力。你用的模型再强,如果它每次完成任务都要反复试错、来回读文件、消耗大量Token,那它的性价比可能还不如一个能力稍弱但更”懂分寸”的Agent。
GitHub官方的博客也验证了这个观察:他们曾经尝试缩短工具返回的内容来省Token,结果模型因为信息不够又重新执行命令、重新打开文件,最后总消耗反而更高了。局部省Token,全局反而更费。
所以衡量AICoding效率,正确的公式不是”Token / 代码行数”,而是:
单位有效任务成本 = AI总投入 ÷ 通过验收的任务数量
这个公式里,”通过验收”是关键。没通过测试的代码、被推翻重来的方案、方向跑偏的探索,都不能计入分母。
放到实习生的场景里,正确的算账方式是:改这个接口花了1亿Token(假设折合400元),但如果让一个熟手工程师来做,他需要先读代码、理解逻辑、改接口、跑测试,可能要花半天时间。一个工程师半天的人力成本是多少?远不止300块。
这么算,实习生非但没浪费钱,反而可能是赚的。
但这个结论有个前提:那1亿Token真的都花在了”理解代码和排查问题”上,而不是花在了无意义的循环和重复上。这就引出了下一个问题:怎么判断Token花得值不值?
个人层面:四个实操方法,把Token花在刀刃上
光有理念不够,得有可落地的方法。下面是四个可以直接上手的Token优化手段,每一个都经过实测验证。
方法一:上下文瘦身——别让Agent读整个项目
这是最容易被忽视、但收益最大的一项。
很多人用Agent的习惯是:把整个项目目录扔给它,说”帮我改一下登录接口”。Agent为了搞清楚登录接口在哪、依赖什么、怎么调用,会挨个读文件。一个中等规模的项目,光读文件就能烧掉几万甚至几十万Token。
正确的做法是主动缩小上下文范围:
- 告诉Agent具体的文件路径,而不是让它自己找
- 如果已经知道相关的几个核心文件,直接列出来
- 用.continueignore或类似的配置文件,排除node_modules、构建产物、日志文件等无关目录
- 长文件只给关键片段,不要整篇喂
同样的任务,精准指定文件范围和让Agent自己探索,Token消耗可以大福降低,因为Agent本来也只会用到那几个核心文件的信息。
方法二:任务切分——大任务拆成小任务,每一个独立闭环
Agent有个毛病:任务越复杂,它越容易在中间迷失方向,然后反复试错,Token像流水一样花出去。
一个1000行代码的重构任务,如果一次性丢给Agent,它可能会改到一半发现方向不对,推倒重来,消耗的Token可能是预期的两三倍。
正确的做法是把大任务拆成独立的小任务,每个任务自己验证自己的结果:
// 别这么干
“把整个支付模块重构一下,改用新的配置系统”
// 应该这么干
“第一步:先读取payment/config.ts,分析当前配置结构,列出来哪些字段需要迁移”
“第二步:基于第一步的分析,写一个迁移函数,把旧配置转成新格式”
“第三步:写单元测试验证迁移函数的正确性”
“第四步:替换payment/service.ts中的旧配置引用”
每一步都是一个独立的小任务,做完就验证,过了再走下一步。这样做的好处是:每一步的上下文都很小,Token消耗低;而且一旦某一步出问题,不会污染后续的步骤,不会出现”越改越乱、最后全部重来”的情况。
有团队做过对比,同样复杂度的重构任务,切分后总Token消耗降低了约40%,同时完成质量还有提升。因为小任务的失败率远低于大任务。
方法三:模型分层——简单的活不用上旗舰模型
逻辑很简单:不是所有任务都需要用最强的模型。
- 代码补全、格式化、简单的函数生成——用Flash级模型,便宜几十倍
- 中等复杂度的bug修复、常规功能开发——用中档模型
- 复杂的架构设计、跨模块重构、疑难问题排查——再上旗舰模型
AIBench 2026的测试数据很说明问题:Claude Fable 5在测试中拿了满分(30/30),单任务成本$7.97;DeepSeek V4 Flash通过率80%(24/30),单任务成本只要$0.053——差了150倍。
80分的能力,1/150的价格。对于日常开发中80%的普通任务,这已经完全够用了。
方法四:缓存与复用——同样的代码别让模型读第二遍
很多人没意识到,一般情况下,Agent每次开新对话,之前读过的文件、理解过的上下文,全部清零,下一次又得重新读一遍,重新理解问题、重新走一遍之前的弯路。
正确的做法是:如果必须开新对话,把上一轮已经确认的结论和关键代码片段直接贴过去,别让它重新推导;对于项目级的共享知识(架构图、核心模块说明、常见问题),提前整理成文档放进知识库,Agent需要时直接检索,不用从源码里反向推导
如果团队规模更大、Agent使用更频繁,可以考虑使用专门的记忆数据库。阿里云RDS ContextDB和腾讯云Agent Memory这类产品,本质上就是把”上下文管理”这件事从每个开发者的手工操作,变成了数据库级别的基础设施——Agent读过的代码、做过的决策、踩过的坑,被蒸馏成长期记忆存下来,下次遇到类似问题直接召回,可以变成项目级、组织级的知识资产,方便整个团队共享。之前我有篇文章也介绍了如何将上下文怎么变成团队知识资产,腾讯云的官方数据显示,长任务场景下引入记忆服务后Token消耗最高能降60%以上。
团队层面:怎么建一套Token ROI的衡量体系
个人层面的技巧解决的是”怎么花得更省”,团队层面需要解决的是”怎么知道花得值不值”。
很多公司现在的状态是:给每个人开通了AI工具,月底一看账单吓一跳,然后一刀切开始限额。这是懒政。因为并没有去分析输出的内容,Token到底花在了哪里。
一个合理的衡量体系应该包含三层指标:
第一层:消耗指标——钱花在哪了
这是最基础的数据,必须先搞清楚:
- 人均/团队Token消耗(按输入输出分开统计)
- Token消耗的任务分布:写代码占多少、读代码占多少、调试占多少、其他占多少
- 模型使用分布:各档位模型的使用比例
这层指标的意义是”发现异常”——比如某个人一天消耗了别人一周的量,或者某个团队90%的Token都花在了输入上但产出很少,这时候就该介入了。
第二层:效率指标——花的钱换来了什么
这一层是核心,也是大多数团队缺失的:
- 任务完成率:交给AI的任务,有多少是一次通过的,有多少需要返工
- 单任务平均成本:不同类型任务(bug修复、新功能、重构、代码审查)的平均Token消耗
- 人力替代比:完成同样的任务,用AI vs 纯人工,时间差多少
注意,这里的”任务”不是指”生成了多少行代码”,而是指通过了测试和评审、可以合并到主干的完整工作单元。
一个简单的落地方法:在团队的任务管理工具里加一个字段”是否使用AI辅助”和”AI参与度估算”,月底拉数据对比。不用追求精确,有个大概的量级就够指导决策了。
第三层:价值指标——最终创造了多少价值
这一层最难量化,但也最重要:
- 交付速度提升了多少(需求交付周期、bug修复时长)
- 代码质量变化(缺陷率、返工率、线上事故数)
- 工程师的时间花在了哪里(是从写代码解放出来去做更有价值的设计和架构,还是省下来的时间又被别的事情吃掉了)
这层指标需要长期跟踪,短期可能看不出明显变化。但如果一个团队用了半年AI,交付速度没提、质量没升、产出物没增加、工程师也没觉得更轻松,那不管Token花多花少,都是很失败的。
但是大部分公司面对AI首先是焦虑,急于应用和改造自己的系统或者产品,好给投资人一个交代,AI投入产出效率还不是重点。
最后的话
很多公司确实都在开展各种AI培训,培训AI是什么,有哪些工具,应用哪些场景,如何AI Coding,怎么赋能产品等等。但是关于个人如何高效使用AI,组织如何高效管理和运营AI,建立合理的衡量标准,这可能是当前AI落地遇到的新问题。
传统组织架构向AI原生组织架构的转型是必然趋势。
本文由 @会说话的小文 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自作者提供

- 目前还没评论,等你发挥!