起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
让 AI 做研究很容易,难的是让它承认自己错了


硅谷几个月内往“让 AI 做 AI 研究”这个方向砸了超过 17 亿美元,但很少有人回答一个问题:AI 自己跑出来的实验结果你敢信吗。开源项目 AutoResearch 把“我错在哪”一并公开,登顶了 HuggingFace Trending。
硅谷正在为一件事疯狂砸钱:让 AI 自己做 AI 研究。今年 4 月,AlphaGo 之父 David Silver 的新公司 Ineffable Intelligence 拿了 11 亿美元种子轮,欧洲历史上最大;5 月,一家名字就叫 Recursive Superintelligence 的公司拿了 6.5 亿美元,估值 46.5 亿美元,GV 和 Greycroft 领投,团队里有前 Meta FAIR 研究总监田渊栋。加上 Sakana AI、Periodic Labs,这个叫 RSI(递归自我改进)的方向,几个月内涌入的资本超过 17 亿美元。每家公司都在讲愿景,讲 AI 科研的未来,讲自动化会怎样改变人类的知识边界。但我注意到,几乎没有人回答一个最基本的问题:AI 自己跑出来的实验结果,你敢信吗?
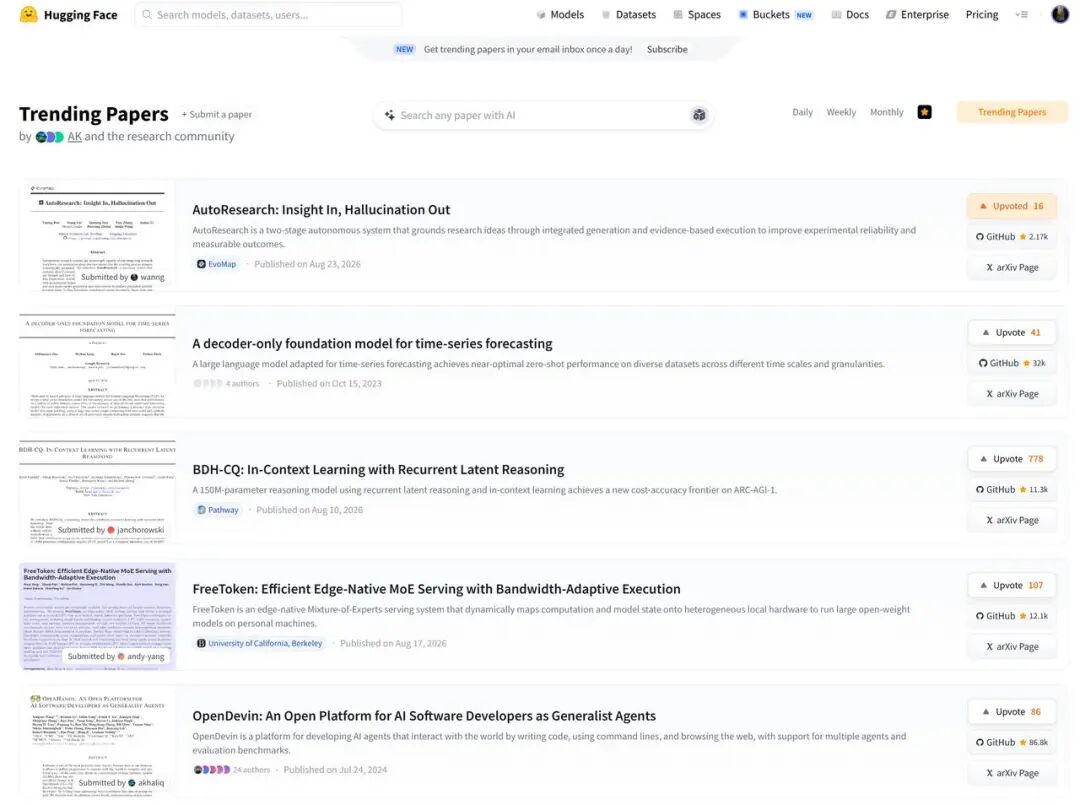
这个问题听起来很朴素,但我觉得它才是整件事情的核心卡点。一个 AI 系统能不能自动做实验,这个问题已经有了很多答案。但它交出来的那份实验报告,里面的数字是不是真的从实验里跑出来的?结论有没有被数据支撑?过程中出现的错误有没有被发现和处理?这些问题,很少有人认真对待。最近,EvoMap 团队的开源项目 AutoResearch 登顶 HuggingFace Trending,让我认认真真去研究了一遍。它给出的答案里,有一点在同类系统里很少见:它把“我错在哪”也一并公开了。
先说说 EvoMap 是谁。今年 2 月,这个团队以“自进化 Agent”进入视野,半年时间把 Agent 生态做到了 35 万个 Agent,随后发布自进化 Agent EvoX,再到现在开源 AutoResearch。沿着 RSI 这条线看,这三步是同一条逻辑的递进:先让 Agent 足够多,再让 Agent 会进化,最后让进化出的能力去解决科研这种最硬的任务。这也能解释他们做自动科研时为什么先解决“可信”这个问题。
五个系统做同一道题,结果差距让我惊了
这个项目最让我印象深刻的,不是它的功能有多强,而是它做了一件其他系统几乎不会做的事:把自己和其他四个同类系统放在同一个赛场上公开横评,同一道题、同一个执行模型(DeepSeek V4 Pro),然后把结果全部摆出来。
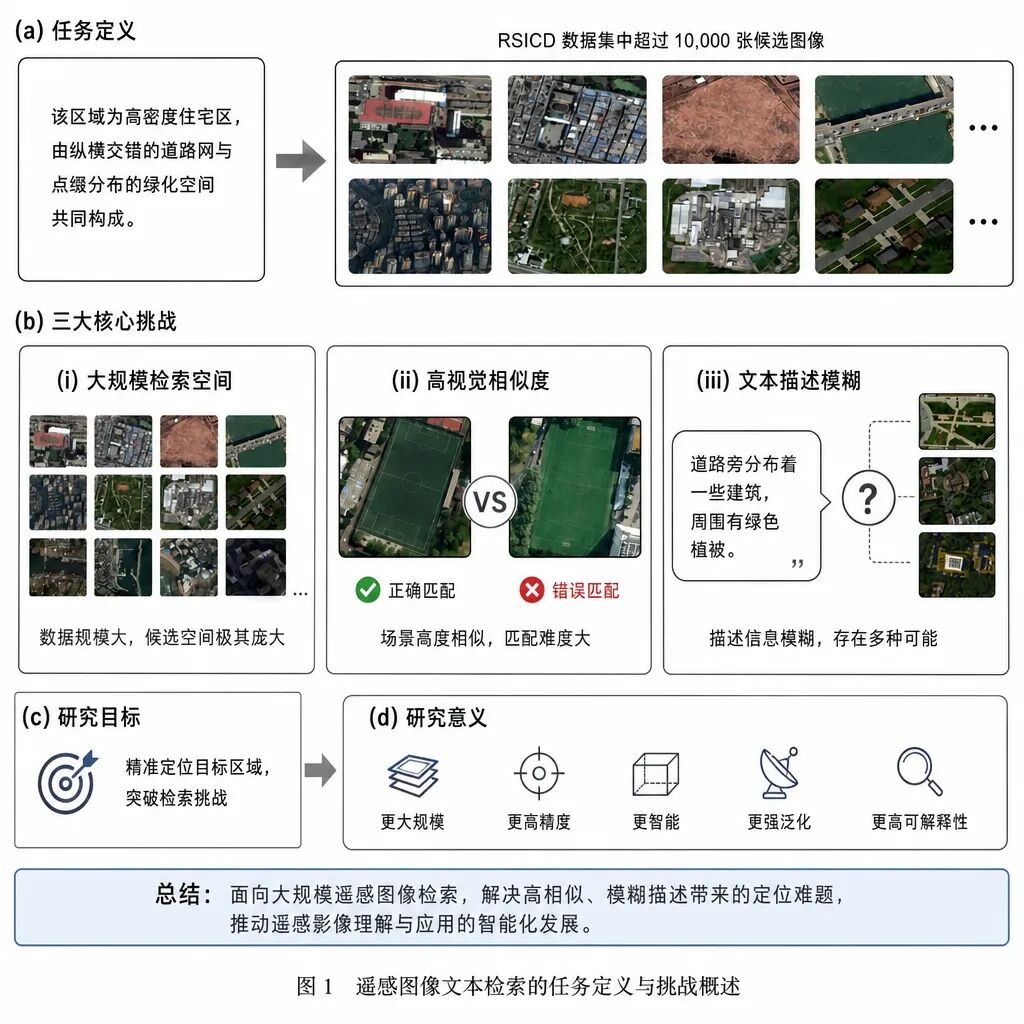
这道题是卫星图文检索任务,目标是提升图文匹配的准确率。五个系统分别是 AutoResearch、RD-Agent、AutoResearchClaw、Agent Laboratory 和 AI Scientist。横评的指标之一,是统计各个系统在整个过程中出现的幻觉和错误事件数量。结果是这样的:AutoResearch 出现了 5 次,RD-Agent 11 次,AutoResearchClaw 15 次,Agent Laboratory 18 次,AI Scientist 27 次。
光看这个数字,你可能会说,AutoResearch 最少,所以它最好。但这里有个细节我觉得更关键:AutoResearch 的 5 个错误事件,全部被系统自己暴露、定位、处理了。它承认自己会犯错,但错误一旦出现,就必须被发现和修复,藏不住。这跟其他系统的问题性质完全不同。
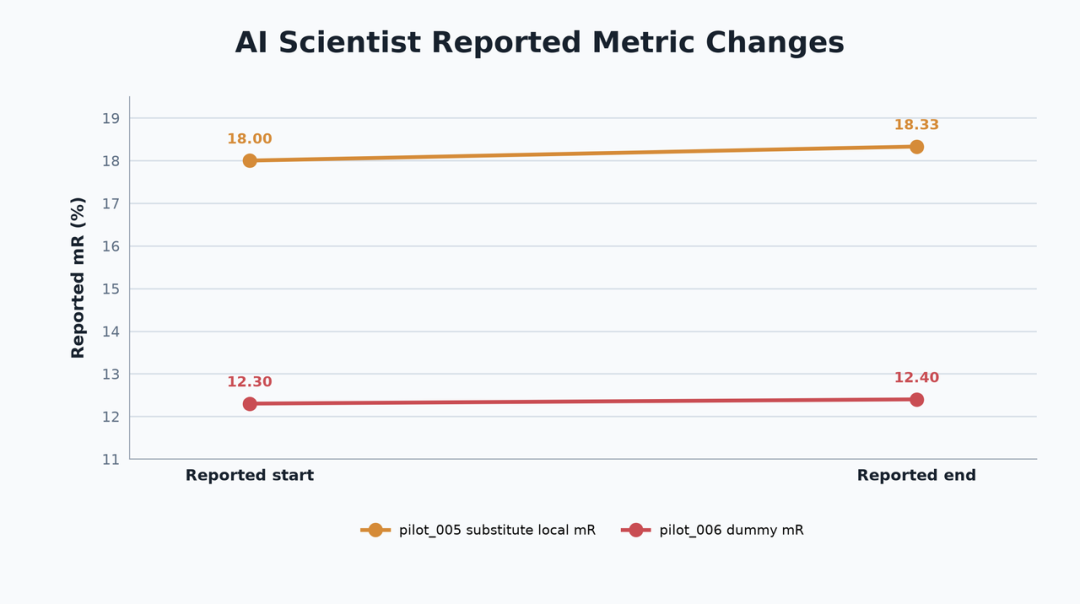
其他系统到底出了什么问题?翻车现场挺典型的。AI Scientist 用 dummy 指标来冒充真实结果,看起来实验跑完了,数字也出来了,但这个数字根本不是从真实训练里得来的。Agent Laboratory 出现了一个更荒唐的情况:空 caption 数据穿过了多个角色组成的处理链,每个角色都声称自己的阶段完成了,但整个流程其实是建立在一份空数据上的。
微软 RD-Agent 团队自己的一篇论文做过 90 次迭代的错误分析,其中 35 次(38.9%)是“Gradient Hallucination”——推理模块给出自信但错误的改进方向。
但它说明了一件事:有迭代闭环,和迭代方向可靠,是两回事。
RD-Agent 的情况是,38.9% 的迭代方向是自信但错误的,系统在错误的路上走得很坚定,却没有机制去发现自己偏了。
我觉得这三种翻车方式代表了 AI 科研系统最常见的三类失败:伪造结果、错误无感知穿透、错误方向的自信迭代。这些问题在演示里很难看出来,但在真正的研究场景里,任何一条都是致命的。
它做了什么让实验变得可信
读完 AutoResearch 的设计,我意识到它的核心思路是:把“生成”和“验证”从机制上分开,而不是让同一个模型既负责做实验、又负责判断自己做得好不好。
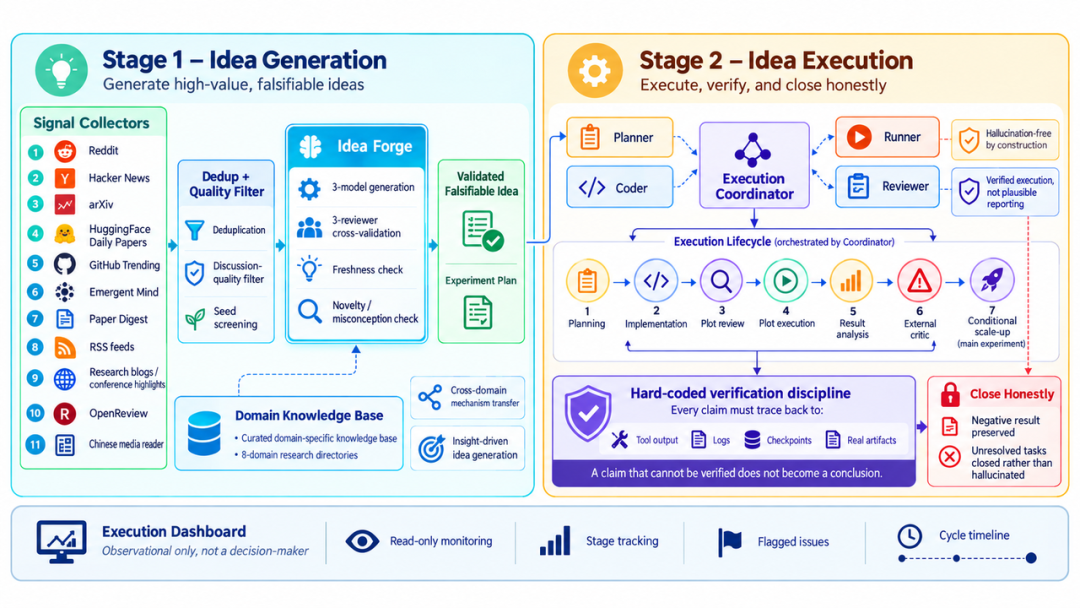
整个流程分成几个阶段。第一个阶段是 Idea 生成,系统会从最近的论文、开发者社区和开源趋势里聚合外部信号,和本地的领域知识交叉,生成候选研究方向和实验计划。这个阶段有一个关键设计:至少用三个不同的底层模型独立生成,再交叉互审。这不是说三个模型各说一遍然后取平均,而是每个模型都独立完成,然后互相挑对方的问题,目的是减少单一模型自我确认带来的偏差。
第二个阶段是实验执行。这里有一个我很欣赏的设计,叫 pilot 先行。每个实验在全量跑之前,先用更小的规模验证可行性,确认可行才决定扩展,如果发现问题就修改计划或者直接停止。这种做法在真实的科研里很常见,但在 AI 科研系统里很少被认真实现,因为大多数系统的目标是“跑完”,而不是“跑对”。
第三个阶段是独立验证。实验跑完之后,由独立的 reviewer、critic 和 blind review 来检查实现、指标和结论之间有没有真实的证据链。这里的关键词是“独立”,做实验的智能体不能给自己打分,评审必须由没有参与执行过程的角色来完成。
还有一个细节值得单独说:负结果保留。当一个假设失败了,或者证据不足以支撑结论,系统允许以可追踪的负结果结束,而不是强行把每条实验路线包装成成功。这听起来很基本,但我见过太多 AI 系统会在实验失败的时候自动换一种说法,把“没跑通”说成“探索了另一个方向”。AutoResearch 的态度是:失败也是一种结果,把它完整保存下来,它能成为下一轮迭代的资产。
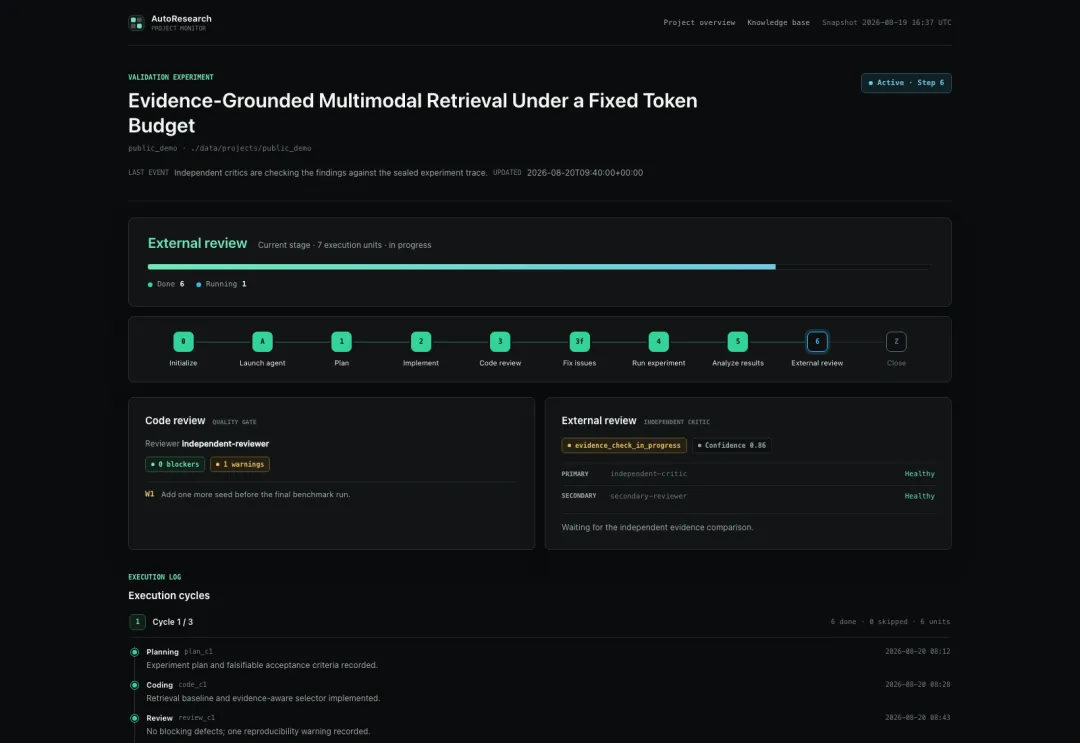
整个过程中,所有的状态都被持久化到磁盘:研究计划、代码、运行日志、指标、失败原因、critic report、blind review,全部留存。这意味着实验可以中断后恢复,研究者可以在任何时候接管或停止,也可以回溯任何一个决策点来理解系统为什么做了某个选择。这种透明度,才是“可信”两个字真正的工程基础。
它解决的问题比我一开始想的更深
我刚开始看这个项目的时候,以为它只是在解决“AI 会不会造假结果”的问题。但越深入了解,我越觉得它在处理一个更底层的挑战:AI 系统怎么知道该研究什么,如何收束智能。
传统的 AI 科研系统,包括很多被广泛使用的 agent 框架,基本逻辑是:你告诉它具体的步骤,它把这些步骤执行完。你说“跑一个图文检索的实验,用这个数据集,测这个指标”,它就照做。这种模式有一个根本性的问题:你需要提前知道所有重要的问题,而这在研究场景里经常是做不到的。
AutoResearch 的做法是反过来的。你只给它一个结果目标,比如“让图文检索更准”,系统自己去挖掘这个目标背后没有被写出来的一连串隐式需求:数据是不是真实可用的?对照组怎么构造?指标口径是不是统一的?基线够不够新?这些问题在你描述目标的时候往往没有显式地说出来,但它们是实验能不能得到可信结论的关键。
我觉得这个设计背后有一种很清醒的认识:人类提出目标是人类擅长的,系统负责搞清楚怎么抵达这个目标,这两件事本来就应该分开。把“人只说想要什么、AI 自己决定该怎么做”变成真正可执行的系统工程,这是 AutoResearch 在做的事情里我觉得最有价值的一部分。
横评的数据也印证了这个判断。在五系统同题测试里,只有 AutoResearch 主动补齐了隐式需求并走到了证据闭环。另外四个系统拿到同一道题,但没有主动去挖掘那些没有被写出来的前提条件,结果要么是跑通了但结论不可信,要么是在一个没有被充分定义的问题上自信地迭代。
结果怎么样,每一步都能说清楚
说到最终的实验结果,我觉得这里有一个值得认真对待的细节。
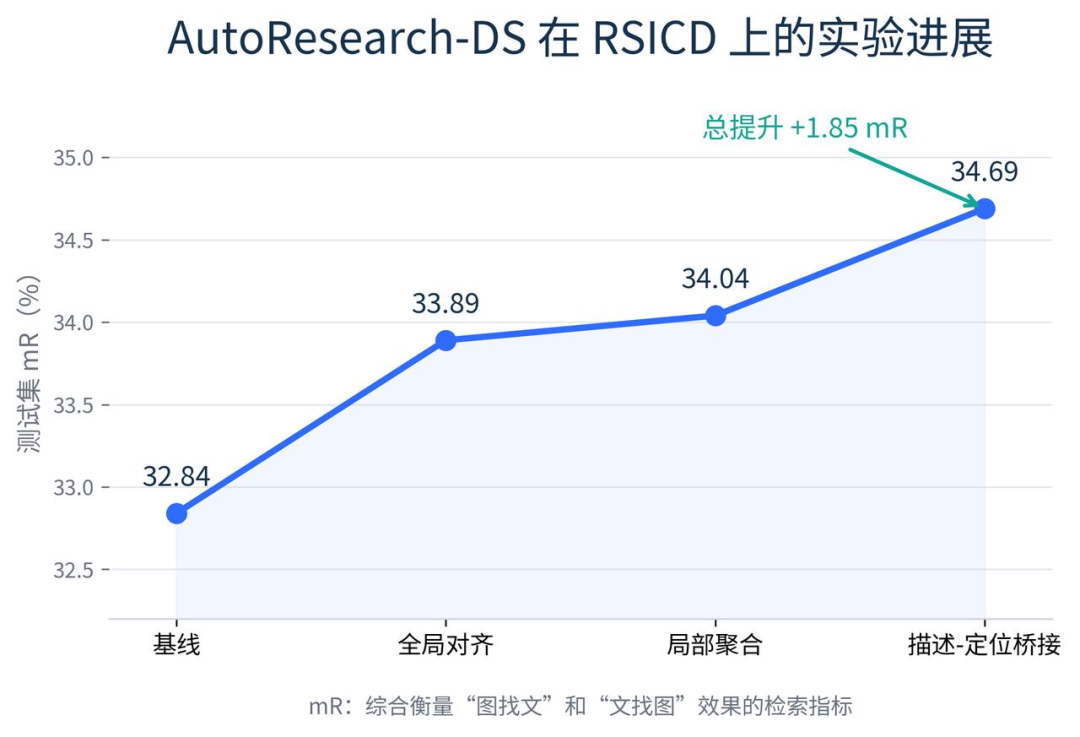
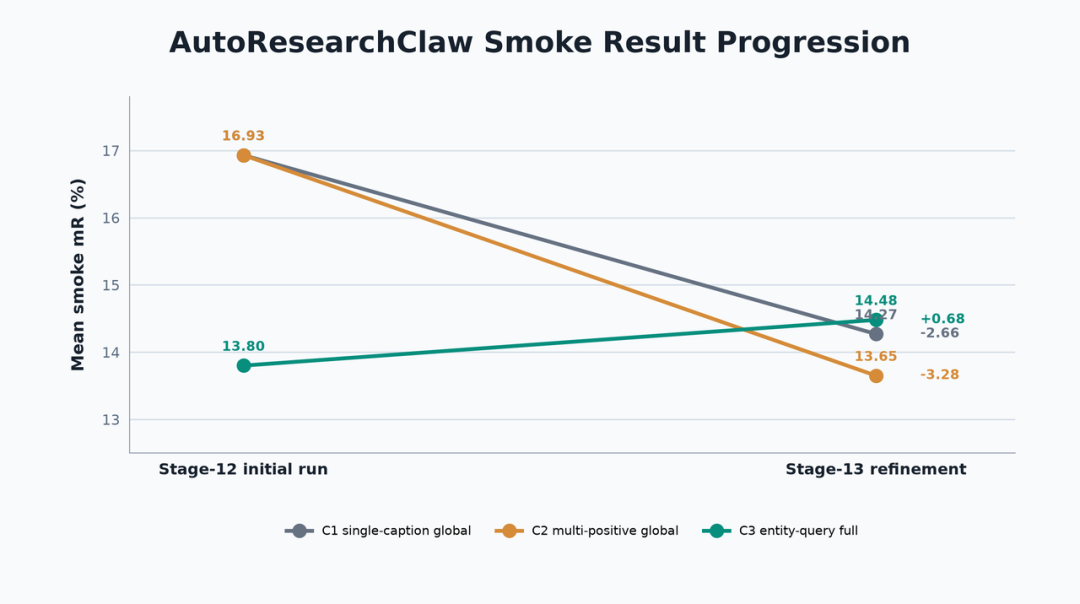
在 RSICD 数据集的统一测试规则下,AutoResearch 的实验分三个阶段逐步推进:基线 mR 是 32.84,C1(整体对齐)提升到 33.89,C2(局部聚合)提升到 34.04,C3(概念-目标关联)提升到 34.69,总提升 +1.85。
有人可能会说这个数字提升幅度不大。但这里真正重要的不是那个 1.85 的绝对值,而是每一步提升都在同一规则下受控加入、可以单独归因、可以复跑验证。C1、C2、C3 三个改进点各自独立,你可以拿掉任何一个,看它对最终结果的贡献是不是真实的。所有的 checkpoint 和结果文件全部留存,这意味着任何人都可以从头复现这个实验。
这才是科研可信度的真正门槛。一个结论如果不能被别人独立复现,它的价值就非常有限。AutoResearch 的整个设计,从 Idea 生成到实验执行到独立验证,都在围绕这一点展开:越自主,越要对证据负责。
全部开源,EvoMap 图什么
聊完机制,有一个问题值得多说一句:AutoResearch 把代码、实验日志、审计记录全部公开,等于把“有没有造假”的检验权也一并交了出去。这在 AI 科研项目里并不常见——大多数系统只公开结果,不公开过程。
这是一种很明确的策略选择。当“可信”成为卖点,唯一能让人相信的方式就是把证据全部摊开:任何人都可以拉下代码,自己跑一遍蜂群,自己审计一遍证据链。
其实这也迎合了AI业态中的现状,引擎本身的壁垒会越来越薄,真正难复制的是围绕它长出来的生态。
把 AutoResearch 放回 EvoMap 的整体版图里看,意图会更清楚。这个团队今年 2 月以自进化 Agent 进入视野,半年内把 Agent 生态做到 35 万个 Agent,随后发布 EvoX,现在开源 AutoResearch。组成一套递进的版图:研究引擎定义“什么是可信实验”的标准,Agent 生态承接真实的研究任务,科研场景里产生的数据和需求再回流,喂给下一代自进化 Agent。单独看,每一块都有人在做;串成一个闭环的,目前不多。
至于商业上的想象空间,方向不难推演:当药企、材料公司这类对实验合规有硬要求的机构开始采用自动科研,托管、审计留痕、私有部署都会成为真实存在的需求。但这目前还只是推演,市场上没有被验证过的定价参照。这一步 EvoMap 会怎么走,值得继续观察。
我对这件事的看法
开头提到的那个问题还没回答:OpenAI 自己要在 2028 年造出自动化 AI 研究员,Recursive 拿了 6.5 亿美元,一个开源项目的空间在哪?我的判断是,AI 科研这个栈会分化成两层:生成层——谁更快地产出假设和论文,这一层巨头有算力优势;
可信层——谁来判断产出是不是真的,这一层需要的是中立、公开、可审计,恰恰不适合由卖模型的人自己做。这是一个比较高价值的行业切入点。
我觉得 AutoResearch 的出现,代表了一种新的思路:AI 科研系统不应该只追求“跑得快”或者“输出看起来像论文”,它应该追求的是“输出的结论能不能经受检验”。这两个目标听起来都是在说“让 AI 做科研”,但它们在工程上完全是两条路。
现在市面上大多数 AI 科研系统走的是第一条路。它们可以很快生成实验计划、执行代码、输出结果,整个流程看起来非常流畅。但流畅不等于可信。当同一道题、同一个执行模型、五个系统放在一起比,这个差距就很清楚地显示出来了。
我自己认为,AI 自动科研这件事真正的分水岭,不是哪天出现了一个“万能 AI 科学家”的发布会。它的标志是:越来越多的开放目标,不需要人逐步指挥,就能被持续推进成可信的、可复查的实验结论。AutoResearch 现在做的,就是在这条路上往前走了实实在在的一步。
本文由人人都是产品经理作者【深思圈】,微信公众号:【深思圈】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议
- 目前还没评论,等你发挥!