起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
12 个 AI 场景放在一起,为什么还不能直接叫“工作系统”?


北京法仪大模型应用覆盖12个司法行政场景,贯通立案、办案、结案全流程,辅助效率提升超100%。但多Agent协作下,案件当前状态如何维护、业务授权如何动态放行、平台化复用边界在哪,成为产品设计的新难题。本文从业务对象、上下文、授权与复用四个维度,拆解政务AI从能力清单走向系统接续的关键挑战。
12 个业务场景、共同底座、身份授权,再加上多家企业一起参与,这套政务 AI 已经不缺“能力清单”了。往下看,问题开始变成这些能力能不能接得起来。
比如,前一个环节已经确认的事实,到了后一个环节还能不能直接用;业务状态发生变化后,Agent 原来的权限和可执行动作是不是还成立。多个 Agent 都能干活之后,系统怎么保证它们面对的是同一件事、同一个当前状态。
北京“法仪大模型应用”提供了一个很适合观察这个问题的案例。9 月 8 日正式发布时,官方公布了 12 个司法行政场景、一年以上生产环境调优、功能输出精准度超过 90%、累计办理业务 20 万次等数据。
其中,“法仪·行政复议 2.0 版”已经贯通立案、办案、结案,辅助效率提升超过 100%。整套方案由北京市司法局依托司法部人工智能研究与应用重点实验室,联合 8 家企业研发。
这套产品并不是一次性铺开 12 个场景。2025 年 3 月,北京市司法局从 27 个需求场景中确定 15 个纳入建设范围;4 月形成方案,6 月启动验证建设,最终形成此次公开的 12 个场景化成果。
同期公开的建设总结还明确提到,在政务大模型项目“成本有限、不能失败、强调绩效”的条件下,选择了智能体技术路线,并为后续形成“数字法治超级智能体”打基础。
场景、Agent、公共能力都在增加,产品设计随之多出一个更难的问题:系统最后要围绕什么对象组织,才能让这些能力接续起来?
官方把“法仪大模型应用”定义为“全国首个数字法治人工智能应用服务整体解决方案”。
这里需要先把“整体”拆开看。方案层面的整体,说明业务场景、基础能力、安全认证和多家企业已经被组织进同一套交付方案。
整体交付了一套解决方案,是否也意味着系统内部已经围绕同一件业务,共用一份当前事实和业务状态?
本文就从这个问题往下拆:业务对象、当前状态、业务授权,以及平台化复用。
先看产品边界:12 个场景已经进入哪些业务
先把公开能力摆出来,再讨论产品结构。
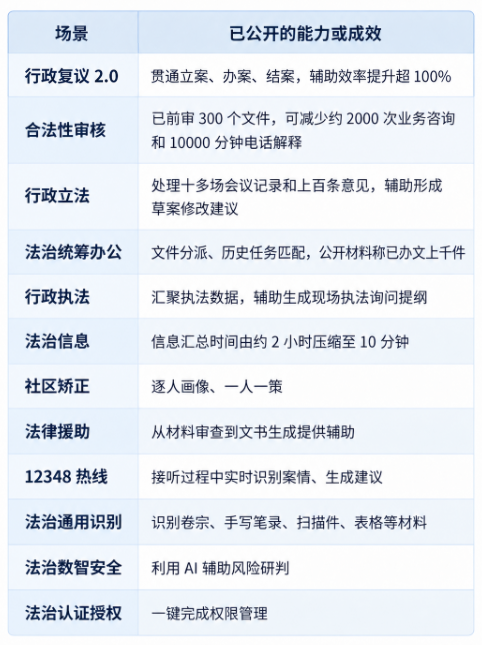
以上都是发布方或相关官方公开材料披露的场景能力与成效,并非独立第三方测评结果。
从这 12 个场景看,AI 已经不只停在问答和内容生成,而是进入了案件办理、审核、执法、热线、矫正和授权等业务环节。
2025 年 9 月,北京公开的重点还是行政复议垂直大模型,当时已经进入北京市司法局及全部 16 个区司法局的办案平台;到今年,行政复议升级到 2.0,AI 应用也从一个垂直场景扩展到 12 个司法行政场景。
公共底座解决了能力复用,业务状态仍是另一层
央广网 9 月 14 日报道提到,“法仪大模型应用”整体涵盖三个基础底座和 12 个司法行政业务场景。
公开报道没有逐一列出三个基础底座分别是什么,因此这里不自行补全。
能够确认的是,同一篇报道把“法仪·法治通用识别”明确称为整套大模型的核心底座。大量纸质卷宗、手写笔录、扫描件、票据和表格,需要先经过这一层处理,上面的案情解析、要素提取、文书生成和风险研判才能继续工作。
央广网披露的实际处理链也很具体:
文字识别 → 关键信息提取 → 结构化整理 → 智能校验 → 风险标识 → 人工复核 → 归档入库
测试时还专门用了红章遮挡、纸张歪斜、手写字迹、扫描模糊、表格票据和照片反光等真实办案材料。
这里可以确认一件事:不同场景之间已经存在可复用的公共能力,原始材料能够经过共同处理,转成上层 AI 可以继续使用的业务数据。
但这里需要区分两件事。
这份材料是什么? ≠ 这件案子现在是什么情况?
前一个问题,通用识别和结构化可以解决很多。
后一个问题还会继续涉及案件当前处于哪个阶段、哪些事实已经确认、哪些材料刚刚发生变化、哪个结果已经被退回、哪个判断仍然有效。
这是另外一层状态。
共用材料处理能力,不等于共用案件当前状态
多厂商协作之后,谁来维护“当前状态”
服贸会“数字友好解决方案展”还公开了 8 家机构的展示方向。
面壁智能展示行政复议垂直大模型 2.0,京西智谷展示法治文视通智能体,中科大脑展示法治 AI 政务方案,中国移动展示政务 AI 智能办公,中电十五所展示社区矫正 AI 大模型,北大软件展示司法行政数字化方案,北京数字认证展示法治可信授权方案,安信天行展示司法数智安全方案。
这只能说明展区公开的能力和方案分工,不能反推成完整的项目承建责任表。
多场景、多系统、多家参与单位已经是公开事实。
对产品设计来说,接下来要回答的是:一件业务跨这些能力继续往前走时,谁保存它此刻的状态?
行政复议里的事实发生变化,其他相关 Agent 什么时候知道?两个系统同时保存了不同版本的业务事实,后面的智能体该依据哪一份?
这类问题传统大型业务系统本来就有。Agent 开始主动读取状态、生成结果甚至连续执行以后,对“当前事实”的要求只会更高。
产品对象不是三个任务,而是同一个案件
行政复议已经贯通立案、办案、结案,很适合拿来观察。立案要处理申请人、被申请人、材料和案件要素;办案继续处理事实、证据、争议焦点和法律依据;到了结案,还会形成文书和处理结果。前后三个环节处理的始终是同一个案件,这已经不只是模型调用的问题,而是产品里“这件事”到底怎么持续存在的问题。
放到具体业务里,问题会很快冒出来。立案阶段由 AI 提取、人工确认过的事实,到了办案阶段还算不算有效?申请人后来补交了材料,之前基于旧材料形成的分析怎么处理?AI 生成的一份意见,到底只是待审核的候选结果,还是已经经过人员确认、可以继续进入下一环节?
在本文的分析框架里,我把持续存在的案件称为工作对象(Work),把围绕案件当前仍然有效的事实、材料和状态称为上下文(Context)。这两个词只是本文用来观察公开信息的架构术语,并不是北京市司法局对“法仪大模型应用”的官方定义。
说到底,这一段讨论的已经不是模型“会不会做”,而是系统能不能把一件案件的当前状态持续维护下去。
几个 Agent 是不是在处理同一件“现在的事”?
权限设计之后,还要补上业务放行
认证授权是这 12 个场景中的一个。官方发布材料写的是“一键完成权限管理”,北京市司法局另一篇介绍把它称作“AI 身份管家”。参与联合开发的北京数字认证披露得更具体:它承担安全认证与可信身份底座建设,为 AI 智能体签发独立数字身份凭证,让智能体“持证上岗”,并提出“身份可证明、能力可约束、行为可归因、权限可即时吊销”。同一材料还提到,可以“一条指令驱动所有应用及智能体完成身份授权处置”。
这部分属于承建方公开信息,不能当成北京市司法局对整体系统架构的官方定义。但至少可以确认,智能体的身份、授权和行为追溯已经被当成正式工程问题来处理。
再往业务里走一步,权限还不是全部。一个 Agent 身份合法,也有文书生成权限,只能说明它“是谁、能调用什么”。同样一个 Agent、同样的接口,一个案件刚被退回补充材料,另一个案件已经完成审核,允许执行的动作不会一样。系统权限没有变化,业务状态已经变了。
传统软件里,这类判断往往由工作人员结合案件状态临场完成。Agent 开始连续执行以后,如果这些业务判断仍然只存在人脑里,系统就得频繁停下来等人确认。到了这一步,需要明确的不只是“有没有权限”,而是当前这件事、当前这个状态、当前这一次动作,到底能不能放行。
平台化复用:哪些能力能复制,哪些必须本地化
全国法治 AaaS 服务平台,把另一个产品问题摆到了台面上:哪些能力可以跨地区复用。这个问题已经不是设想。北京市司法局公开材料提到,2025 年服贸会之后,行政复议垂直大模型已经在北京市以外的司法行政机关落地;此外,还有 14 个省市司法厅局赴京考察,20 个地区邀请模型承建单位上门对接,12 个司法局接洽试用。
到了这一步,讨论的重点就不只是“北京怎么建”,而是哪些东西可以带到别的地方继续用。OCR、多模态识别、模型服务、安全认证以及部分 Agent 能力,比较容易做成公共能力;但案件状态、地方知识、组织体系、人员权限和具体业务规则,各地不会完全一样。
AaaS 最后能复用到哪一层,会直接影响它的产品形态。只提供模型和 Agent 调用能力,是一层;如果以后连身份、权限、上下文组织、运行控制和审计治理也逐渐形成公共能力,平台承担的事情就会更多。现有公开资料还没有把这一层完整展开,先留着观察更合适。
多 Agent 之后,产品要开始回答“工作怎么接起来”
从 2025 年 3 月开始,北京先从 27 个需求场景中确定 15 个进入建设范围;到 2025 年服贸会,行政复议垂直大模型先落下来;今年发布时,已经形成行政复议 2.0 和 12 个业务场景,同时出现了共同基础能力、多企业协作、智能体技术路线、可信授权和全国 AaaS。
场景是一步步筛选、验证出来的。接下来更难的,是这些已经建起来的能力怎么接在一起。前一个环节形成的事实,后一个环节还能不能继续用;Agent 生成的结果什么时候只是候选,什么时候开始算数;业务状态变了以后,原来的授权还成不成立;不同系统之间,到底谁维护那份当前业务事实。这些问题,比再增加几个模型或 Agent 更接近产品本身。
截至 2026 年 9 月中旬,公开资料还不足以证明“法仪大模型应用”已经建立统一的工作对象、业务状态和运行机制。这里说的是公开信息尚未披露到这一层,并不是判断这些能力不存在。按目前能看到的材料,把它理解为一套已经深入真实业务的多场景智能体应用体系,会更稳妥。
后面是不是一套工作系统,不妨就看一件事:一项真实工作进来以后,前后环节能不能接得住,事实、权限和责任能不能一直对得上。 到这一步,讨论的重点自然也就不只是“大模型”了。
来源说明
- 北京市科学技术委员会、中关村科技园区管理委员会,2026 年 9 月 9 日,《全国首个数字法治人工智能整体解决方案发布》
- 北京市司法局,2026 年 9 月,《全国首个数字法治人工智能应用服务整体解决方案——“法仪大模型应用”将亮相服贸会》
- 央广网,2026 年 9 月 14 日,《全国首个数字法治 AI 应用亮相服贸会 北京门头沟基层实践支撑“法仪大模型应用”落地》
- 2026 服贸会“数字友好解决方案展”公开信息
- 北京市人民政府门户网站,2025 年 9 月 11 日,《全国首个行政复议垂直大模型 9 月 12 日将在服贸会发布》
- 北京数字认证关于参与“法仪大模型应用”联合开发的公开材料(承建方披露)
其中,北京数字认证关于智能体数字身份、“持证上岗”“四重可信”和“一条指令驱动授权处置”等内容均按承建方公开披露使用,不作为北京市司法局对整体架构的官方定义。
本文使用的 Work、Context、业务授权、业务效力和责任边界等概念,是作者分析公开信息所使用的产品架构框架,同样不属于北京市司法局对“法仪大模型应用”的官方架构定义。
作者:邓松高 公众号:AI Native 架构笔记
本文由 @AI原生架构笔记 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议


- 目前还没评论,等你发挥!