起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
GPT 是思考模型,Jev 是行动模型


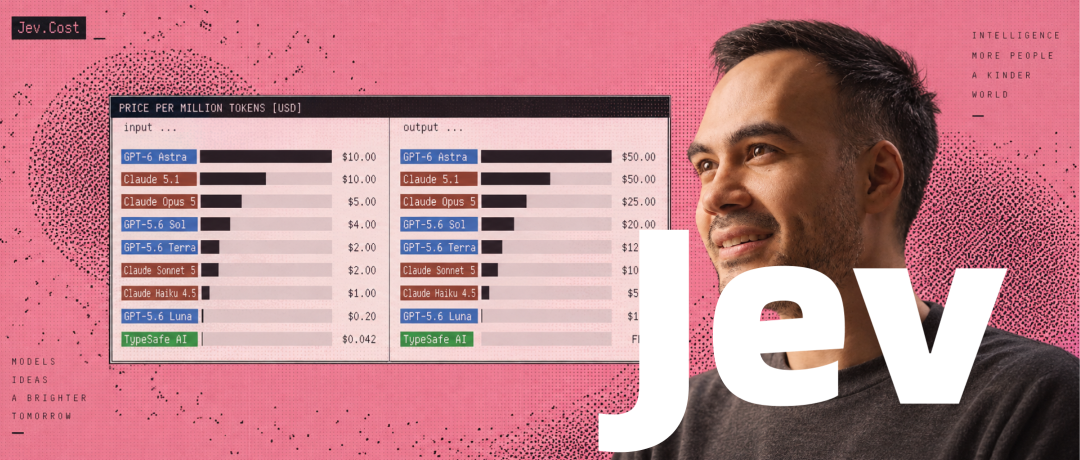
Jev 由 OpenAI 前研究员 Diogo 创办的 TypeSafe 研发,它不是写作式的大语言模型,而是直接做决策的行动模型:输出只有是或否加置信度,速度快、价格低,把人类判断力的壁垒挖掉一块。
两个月前,Claude Fable 5 发布时,我和朋友聊,AI 的生产力已经没有悬念了,人类大多数的工作,在大模型的持续进步,和 Harness 工程理念的发展下,AI 足以胜任绝大部分,未来人类与 AI 的关系,不是“人类使用 AI ”的工具关系,而是人类和 AI 协同分工的配合关系。
在分工合作中,人类的价值体现在「判断力」。深度用 AI 的人应该会有同感,AI 输出一大篇信息,人类选择性的使用其中一部分;AI 提出某种方案,人类会告诉 AI,太复杂了,实际情况是怎样,用某种轻量化方法就 OK 了;AI 一直陷在一个走不通的僵局里,人类会跳出来建议它换另一种角度。
这些都是体现出人类的判断力:选什么、用什么、对不对。
直到最近新发布的 Jev 模型的出现,人类判断力的壁垒,也被挖掉一块。
Jev 由 Open AI 前研究员 Diogo 创办的 TypeSafe 公司研发,根据时间线推断,Diogo 主导了 GPT3.5 前后的模型。写 Jev 的文章很多,我不再过多展开它的背景。我想从应用和机会的角度,聊聊我所理解的 Jev。
Jev 火的最关键原因,不是因为它便宜,而是因为它和现在市面上最常见的大模型不一样。GPT、Claude、DeepSeek 这些都是大语言模型,核心逻辑是写作文,通过上一个字,预测下一个字的概率,做词语接龙。所以不管什么任务,都需要思考很长一段话,然后再用一篇小作文,把答案回复出来。
Jev 不一样,它根本不会聊天,也不会生成一大段内容,而是只做一件事:判断。任意自然语言输入,以标准的结果输出。
举个例子:
医疗场景,输入症状,让模型迅速找出最合适的医生。
如果是大语言模型,实际执行过程可能是:
用户让我找最合适的医生,我先来看看症状……这是典型的感冒,但我还需要判断下是什么感冒…等等,好像不是感冒,我需要重新看下症状……接下来我来检索一下医生库,A 医生擅长…,B 医生擅长……好的,最后选择 F 医生…我再确认一遍……
但如果是 Jev,就能够在备选医生中,迅速给出一个明确的答案,并按照固定的格式输出。
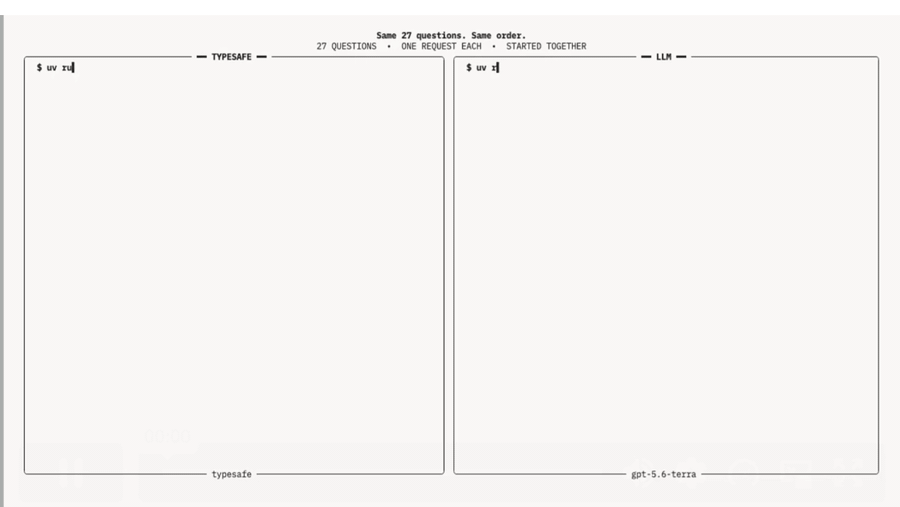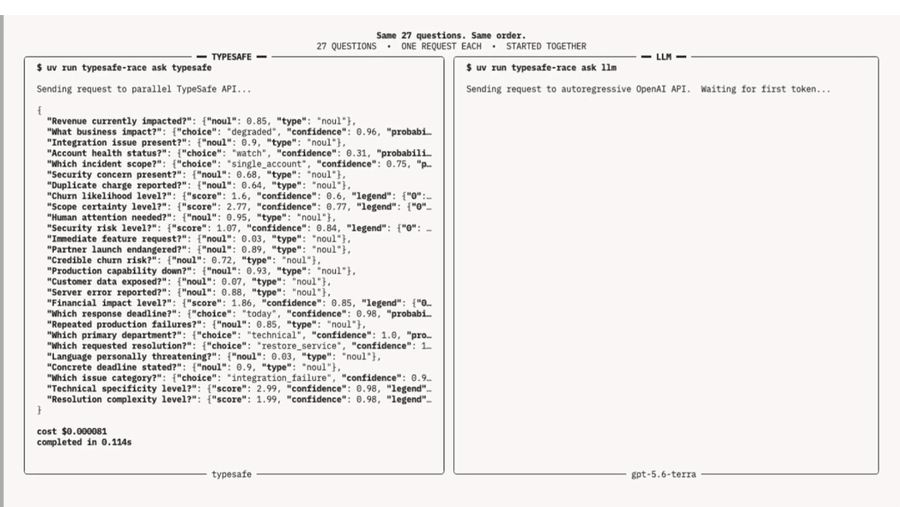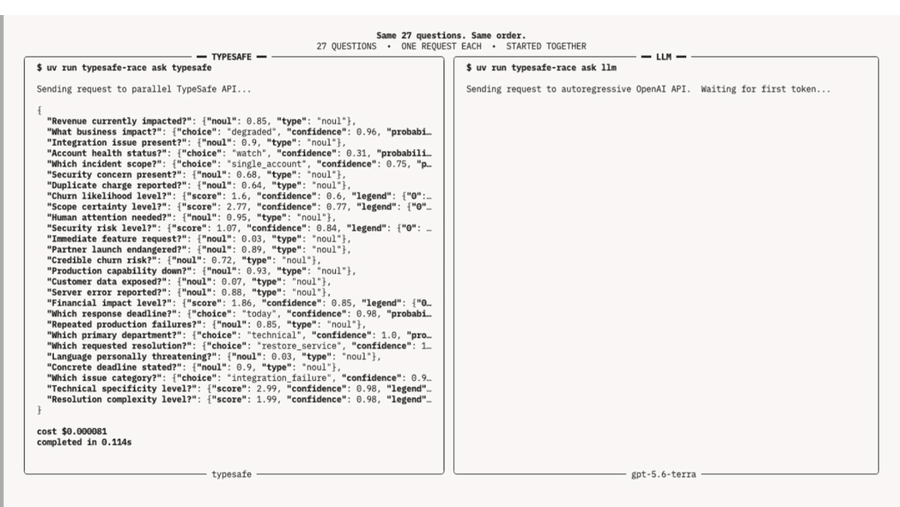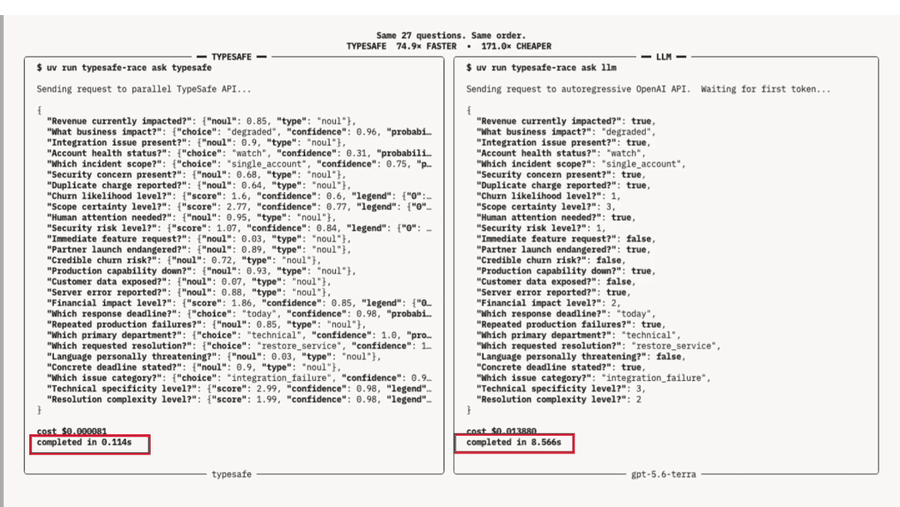
快、直接瞄准结论的判断。下图是官方提供的和 GPT 模型运行过程的对比,感受一下,时间差非常明显:Jev 耗时 0.114 秒,后者为 8.566 秒,而且也更加便宜。
判断决策是广义的
这个快速判断的能力,对于 AI 来说,其实非常稀缺。
先看「判断」。这个世界上,大部分动作都是在做判断。
举个打游戏的例子,什么时候开枪、瞄准哪个敌人、现在该不该放大招,这些都是判断。只要提前把可判断的内容定义好,Jev 就能够根据现实情形,迅速作出决策。
人类白领的工作内容,很大程度上,就是在做判断,拍板项目是否立项,确定某一个功能要不要让步,时刻都在判断。
不仅如此,再举个更深度的例子,在现实物理世界的动作中,也是判断。就以“叠毛衣”这个非常抽象的行动来举例子:
- 先折哪个袖子
- 用什么方式折
- 扣子开了要不要系上
- 左边袖子叠好了,下一步叠什么
这些其实都是决策,我们生活中的大多数动作,都是无数细碎的判断组成:走路先迈左脚还是右脚,这个路口要不要拐弯,都是在不停地做判断,只不过有一些判断已经内化于大脑中,不太容易意识到。
再看「快」。
大语言模型虽然有输出不可控的问题,但是工程约束做好了,也能做判断。Jev 的另一个核心,是快,能迅速作出决策,0.1 秒的响应速度,不比人脑的反应速度差。
所以,「判断」和「快」,这两者加起来,一个答案呼之欲出,就是“行动”。
所以我说,GPT 是思考模型,Jev 是行动模型。GPT 通过深思熟虑做逻辑思考,而 Jev 通过迅速判断作出行动。
事实上,社区里也是这么干的,我看到一些很有意思的应用场景,
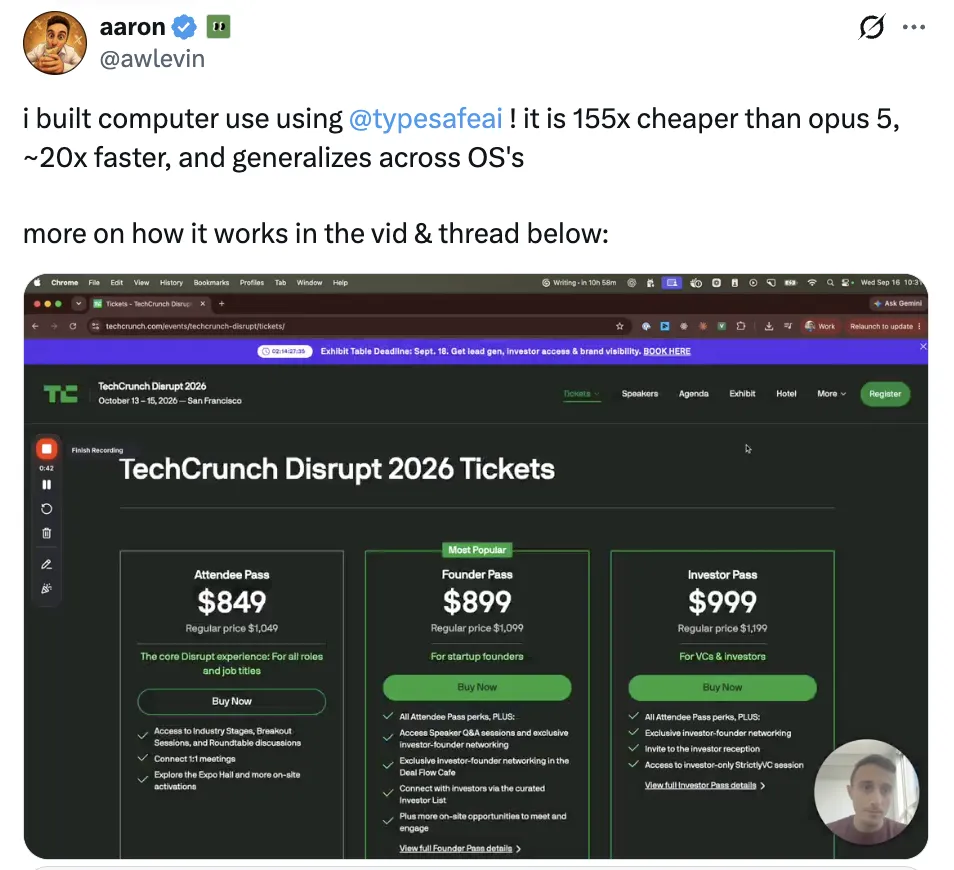
更高效的操控电脑处理,使用 Jev 进行 Computer Use,对比 Claude Opus5,Jev 做单次决策速度快了 14-40 倍,价格只有 1/155。
还可以直接打游戏。
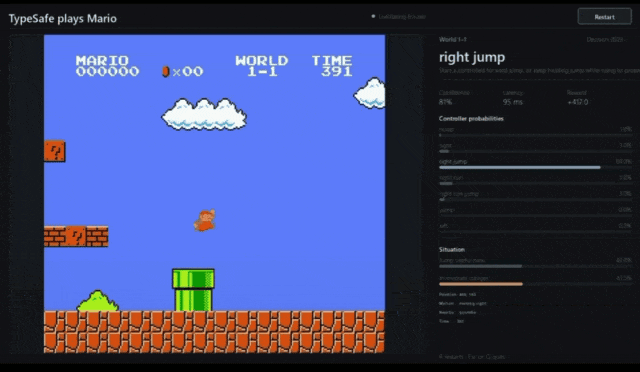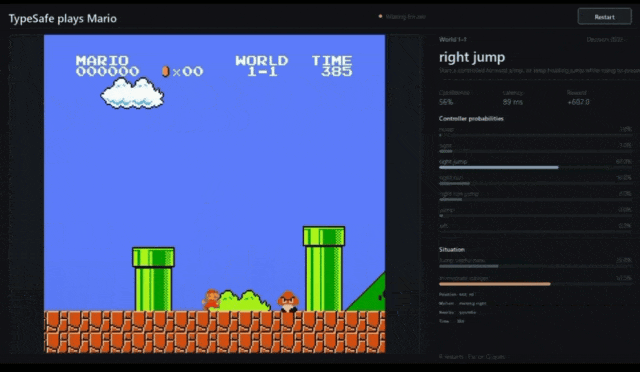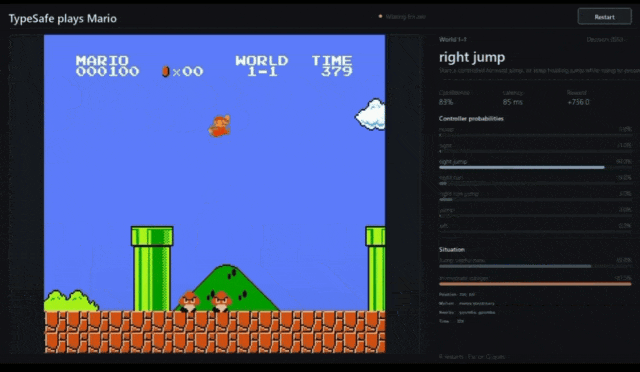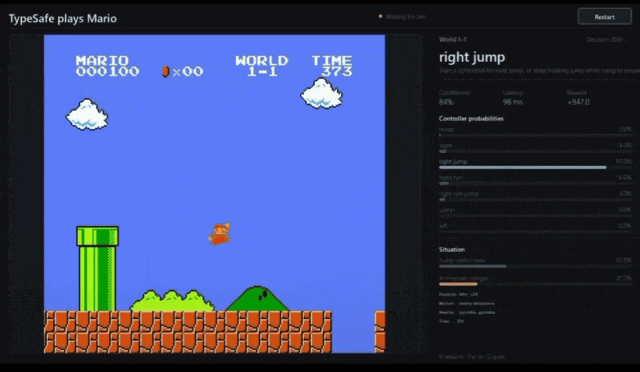
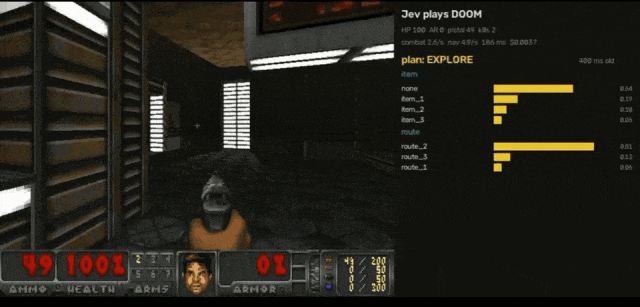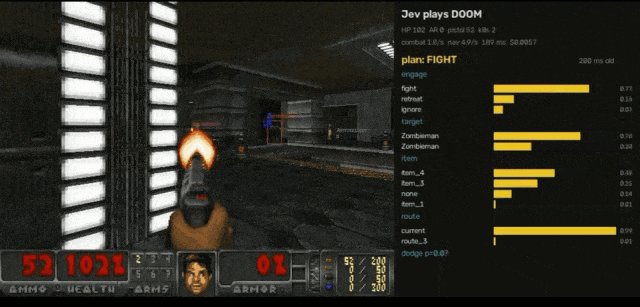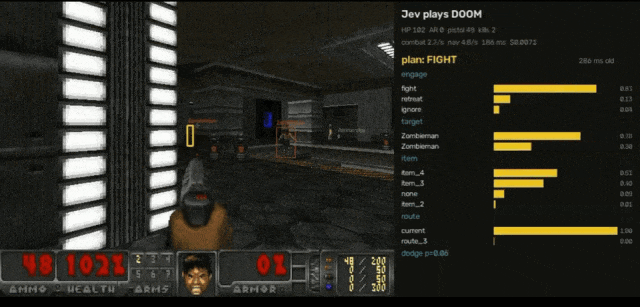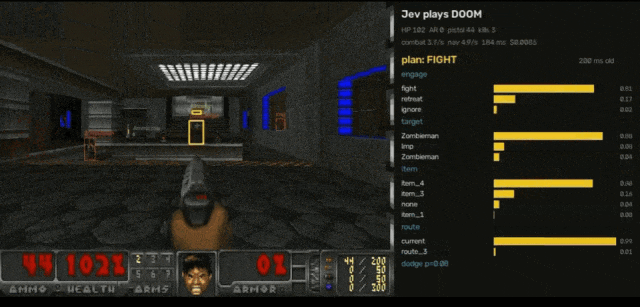
但 Jev 真正的价值不在于此,电脑操作只是 AI 最容易验证的方向。我们在前面举过例子,走路、叠毛衣、洗碗,这些本质上也是连续的决策判断。
Jev 更大的潜力,在具身智能。
能自然语言输入的 if else
Jev 还有一个关键特性,就是它让智能有了代码层面的确定性。
在软件编程中,那些看起来很复杂的逻辑判断,实际上只在做一件事:if else 。
如果用户身份命中 A 条件,就展示 X 页面,否则展示 Y 页面;
如果用户 30 天没有点过外卖,就下发一张 50 元券,否则下发 10 元券。
这些逻辑判断,形成了软件代码运行的逻辑,也构建了现在无比繁荣的互联网生态。
但一旦场景变成复杂的、涉及意图的判断,代码层面的 if else 就不好写了。
“30 天没有点过外卖”这是客观的,代码从订单表里一查就知道。
但是“用户找到客服发了几个奇怪表情包”,如果是人工,一眼就能分辨出用户生气还是开心,但是代码怎么判断?代码是没有办法理解语义的。
所以在软件时代,软件是有边界的,有一些做不了就是做不了。
后来有了大语言模型,这个意图判断好像可以做了,用户发一段话,AI 大模型通过理解,识别用户的情绪到底是什么,然后在提示词中,要求 AI 模型按照固定的 JSON 结构输出情绪分类,后面的系统根据数据的标准化结构,选定对应的处理动作。这就是 Agent 架构中的“意图理解”和“行为分类”。
这种处理方式,能跑通,但很难受,主要是三个问题:
- 慢。前面说过,大模型得想半天,用户得在聊天框看着那个思考图标一直闪,很久才能得到答案,这就使得一些需要快速响应的场景,比如内容推荐,没办法应用大模型的理解优势。
- 贵。意图理解环节,模型最终只是输出了一个“愤怒”的情绪分类,但是为了得出这个结果,可能已经写了一篇 2千字小作文,对于按 Token 付费的大模型来说,成本巨大。
- 不稳定。大模型的输出结果,要想和后续的代码程序接上,就必须要求大模型按照固定的格式输出,比如 JSON 格式,后面代码才能解析成功,但是大语言模型是个聊天机器人,只能在 Prompt 要求按照某种格式。这会带来一个问题,Prompt 里的约束是软约束,模型幻觉、上下文过长等情况下,输出就是不稳定,漏掉一个 JSON 片段很常见,后面代码层直接就识别不出来了。
Jev 很好的解决了这个问题,兼具大模型的理解能力,又有 if else 代码的确定性结构。
在输入端,Jev 可以输入任何自然语言的内容,能够和大语言模型一样,进行思考理解,看得懂非客观的东西。但是在输出时,Jev 只会输出固定的结构:是/否,以及置信度。
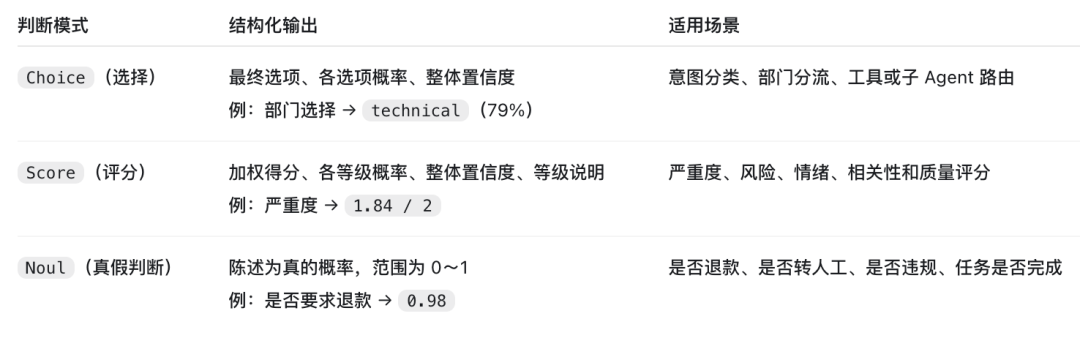
这对于代码衔接可太友好了,输出的结果是确定性的,但是判断能力远超代码,这意味着能够处理的问题更加多元。
更何况 Jev 还巨便宜,输入 $0.042,输出免费。
比如我前一阵子做的 根据小红书文案自动从图库中挑选合适图片的工具,以前通过大模型进行理解匹配,现在直接可以换成 Jev,逐条判断“是/否合格”,或者直接选择置信度最高的结果。
理论上来说,现在代码库里面,所有的意图判断、所有的 if else,都能用 Jev 重做一遍,极大的提升智能水平,极大的扩展场景边界。
让「智能」,有了代码层面的「确定性」。
可能性是 Jev 的最大价值
对于 Jev 的爆火,我看到有一些负面的声音。
有人用 2 小时,通过 Qwen 基座,通过微调做出了类似的能力,认为 Jev 本身没啥门槛;还有人并不看好,认为此刻 Jev 的能力,GPT 或者 Claude 在后训练上稍微一调,就能覆盖掉,没什么壁垒。
但我想说的是,这次 Jev 被广泛传播,不是因为模型能力有多强,而是给已经麻木的 AI 界带来了一些别出心裁的想法。
还是那句话,想到这个方向,价值万金。
就好像年初的 OpenClaw 一样,现在已经没什么人再养龙虾了,但是 OpenClaw 掀起的 Agent 范式,拉动 AI 执行能力进了一个大台阶。
Diogo 在 Jev 发布前的一场访谈中说:“面向人的 AI 被训练为取悦和辅助人,而模型能够为程序提供可靠决策,才有可能真正实现自动化。”朝着这个愿景,Jev 确实在解决通用语言大模型未能解决的事情。
官方也讲得很明确,Jev 最精准的产品定位是:
一个能够理解自然语言的“模糊 if 语句”或“前沿智能函数调用”。
Jev 的核心价值不在开放式能力,而在主动放弃文本生成后获得的工程性质,它不是 Agent 的主力模型,而就是用在系统里需要 if else 的那些地方。
我觉得能想到这个方向,本身就是人类思想的又一个高光时刻,这个来自《思考 快与慢》的产品哲学,正在让 AI 开启一个从思考到行动的新篇章。
本文由人人都是产品经理作者【亨亨】,微信公众号:【产品变量】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自作者提供

- 目前还没评论,等你发挥!