起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
大模型决策模型和知识图谱融合探索分享


我一直有一个感触:我把客户背景、预算和历史沟通记录一股脑塞进去,想要一个准话,它却先分析行业前景、再列优劣势,最后只回一句「综合来看,建议您根据实际情况权衡决定」。企业日常决策要的是结论,而不是把权衡过程再讲一遍。
最近我使用agent我一直有一个感触。
我把客户背景、预算、历史沟通记录一股脑塞进去,等它给我个准话。
它倒好,吭哧吭哧写了八百多字。
先分析了客户的行业前景,再列了我们的优势和劣势,又分了短期中期长期,最后来了一句,综合来看,建议您根据实际情况权衡决定。
我盯着屏幕看了半分钟。
???
我问你要的就是那个「权衡」之后的结论啊兄弟。
你给我把权衡的过程写了一遍,然后让我自己权衡?
这感觉特别像什么。像你手底下带了个下属,你问他这个单子跟不跟,他特别诚恳地跟你说,领导,这事儿吧,好处有三点,第一第二第三,坏处也有三点,第一第二第三,您看呢。
你听完就想把他工牌收了。
合着我养你是干嘛的。
说真的,这种感觉最近越来越强烈。不是说大模型变笨了,是我突然意识到一个问题。
我们用大模型的方式,可能从根上就有点拧巴。
它太爱详尽了。
我不是说详尽不好。详尽的报告、详尽的分析,该要的时候必须要。但大部分时候,尤其是企业里那种日常决策,你根本不需要它把前因后果全给你推演一遍。你需要的是一个结论。
就这么简单。
但大模型不会给你结论。它的逻辑是,你给我上下文,我基于上下文给你一个最「合理」的输出。这个「合理」的潜台词是,它会把正反两面都照顾到,会留有余地,会说一方面另一方面。
听起来很客观对吧。
但站在使用者的角度,这等于没说。
决策成本反而变高了。因为本来你想省脑子,结果现在你得自己从那八百字里再提炼出一个结论。
等于活儿没少干,还多了一道阅读理解。
我最近就在琢磨这个事儿。
我想,能不能换个思路。
人脑其实不是这么干活的。你想想你自己,你早上起来刷牙,你会跟自己说,刷牙有两种方式,电动牙刷和手动牙刷,电动的优点是效率高缺点是贵,手动的优点是便宜缺点是费时间,您看用哪个?
不会。你拿起牙刷就刷了。
为什么?因为这个流程已经被你内化了。它不再占用你的思考资源,它变成了某种自动执行的东西。
卡尼曼在《思考,快与慢》里把这个讲得很透。人脑有两套系统,System 1和System 2。System 2是那个慢慢推理的你,做数学题、写报告、想战略的时候用它,慢,但是准。System 1是那个快速反应的你,开车开了十年看到前车刹车灯脚自己就搭上去了,见到一个人听他说三句话就知道这人靠不靠谱,快,而且根本不用想。
我们现在的大模型,其实就是个System 2。
它每次都在「想」。每次对话它都把上下文重新读一遍,从头开始推理。你问它十遍同一个问题,它给你十段差不多长度的分析,每一段都像第一次见到这个问题。
这在写文章、做开放式讨论的时候是优点。
但在企业里,大部分日常决策,根本不需要System 2。
你去看一个干了十年的销售总监,他看到一个新客户的名字,翻两页沟通记录,心里其实立刻就有判断了。这单能不能成,值不值得跟,要投入多少资源。他不是不思考,是他的思考已经被压缩成了某种直觉。
这个直觉从哪来?
从经验来。从他见过的几百个客户、踩过的几十个坑、喝过的几百顿酒里来。这些东西不是以长篇大论的形式存在他脑子里的,是结构化的。哪家公司什么风格,什么行业毛利大概多少,什么信号出现就要警惕。
我就想,我们能不能给AI也搞一套这个。
把大模型外面包一层,让它从一个只会System 2的书生,变成一个有经验的老员工。
01 核心思路:分类存储记忆
具体怎么做呢。
我最近的想法是,把记忆分成两类。
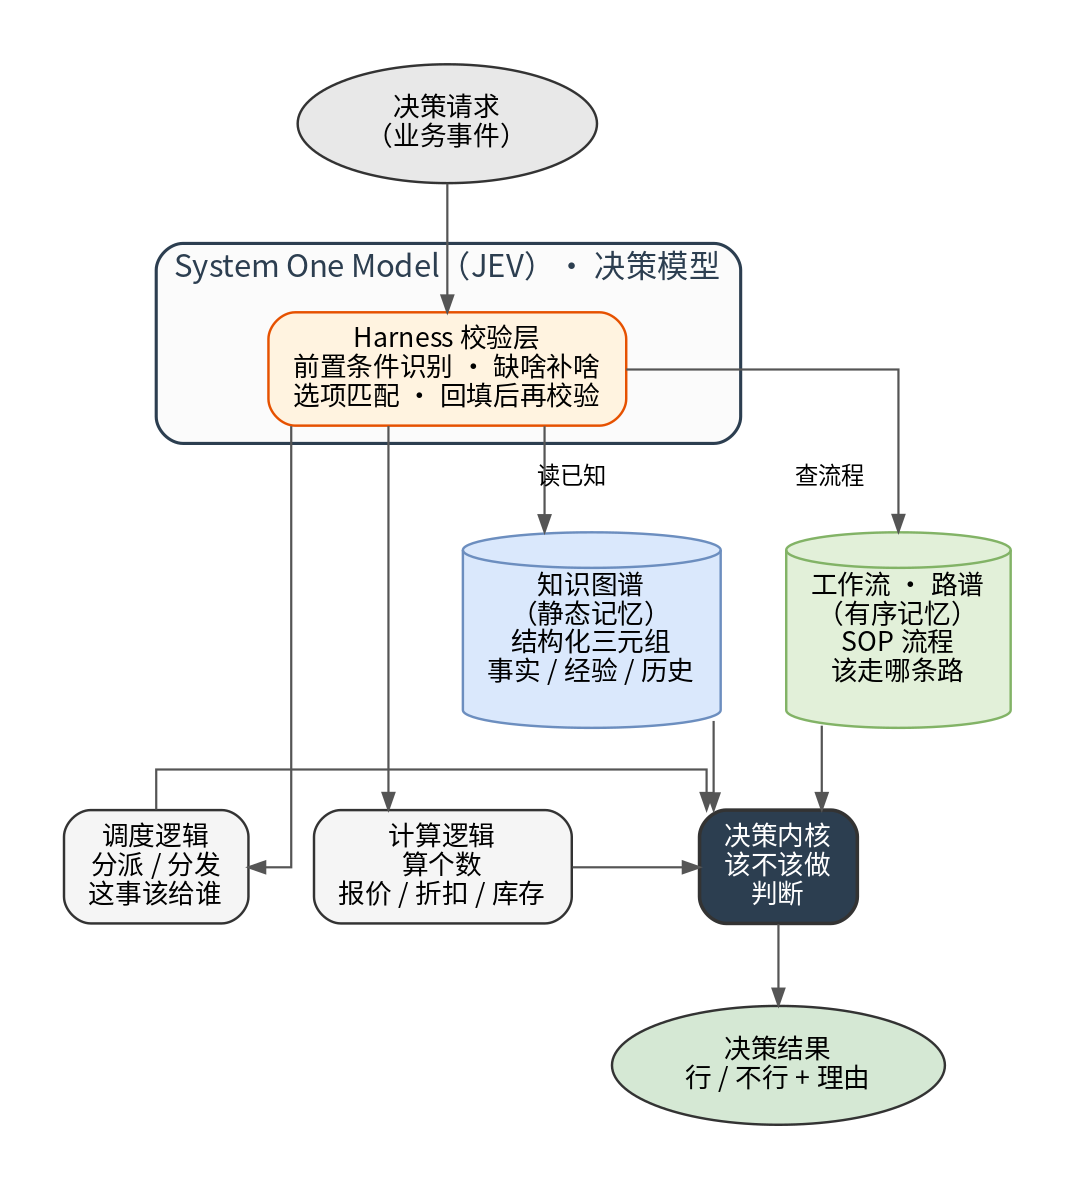
静态存知识:知识图谱
一类是静态的、存知识的。就是知识图谱。
这东西听起来玄,其实你就理解成一张巨大的关系网。张三是哪个公司的,这个公司跟我们有过什么合作,上次合作出了什么问题,这个行业的平均毛利是多少,这条产品线的成本结构是什么。所有这些事实,不是一段一段的自然语言,而是一条条结构化的数据。
更具体一点,是三元组。
主谓宾。客户A历史欠款三次,产品B毛利率两成,审批节点C需要财务总监。
就这种。
所有的记忆都被压成这种格式。它不美观,读起来不像人话,但机器好处理。你想查任何一条,直接查,不用让大模型从一整篇文档里「理解」出来。
动态存流程:工作流SOP
另一类是动态的、存流程的。就是工作流、SOP。
我自己管它叫有序记忆。就是这个事第一步干嘛,第二步谁审批,第三步出了异常往哪转。
这部分不是知识,是路谱。你知道了「客户要退款」这个事件之后,接下来该走哪条路,每一步该找谁。
知识图谱像什么呢,像你脑子里存的那些经验和事实。你一问它,它能立刻调出来。
工作流像什么呢,像你已经做过一百遍的那些动作。你不用想,手就自己动了。
这俩合起来,才是一个老员工真正的装备。
02 与大模型的协同逻辑
那这两层怎么跟大模型协同呢。
我拆了一下,企业里所有的流程,核心逻辑其实就三块。
- 调度:就是分派。这事儿该给谁,这个单子该路由到哪个销售,这个工单该派给哪个工程师。说到底是个分发逻辑。
- 决策:就是判断。这事儿该不该做,这个客户能不能放款,这个价格批不批。说到底就是个是非题或者选择题。
- 计算:就是算个数。报价多少,折扣多少,库存够不够。这个简单,调个公式就行。
你仔细想想,企业里八成的日常流程,其实就是前两块。调度和决策。
真正需要复杂计算和开放式推理的,是少数。
那我们现在用大模型干嘛了?我们让它干所有事。写代码、做分析、写文案、审批报销、判断客户价值。一个System 2被拉去干System 1的活儿,能不拧巴吗。
所以我在设想的那个东西,我管它叫System One Model,或者叫JEV。你别被这几个字母唬住,它其实就是一个决策模型。
它不负责写代码。不负责开放式创作。不负责陪你聊哲学。
它就负责一件事,根据已经有的结构化知识和既定流程,快速给出判断。
03 具体判断流程
那它怎么判断呢。
这里就有个关键问题。它做一个判断,是需要前提的。
比如你问它,这个客户该不该给账期。它脑子里要有几个必要条件。这个客户的信用记录怎么样,历史上有没有拖过款,这次订单金额多大,我们的资金周转紧不紧。
这些条件,不是每次都要大模型去「理解」。它应该有一个机制,去把这些必要条件找齐。
怎么找?
我琢磨了一下,分两种情况。
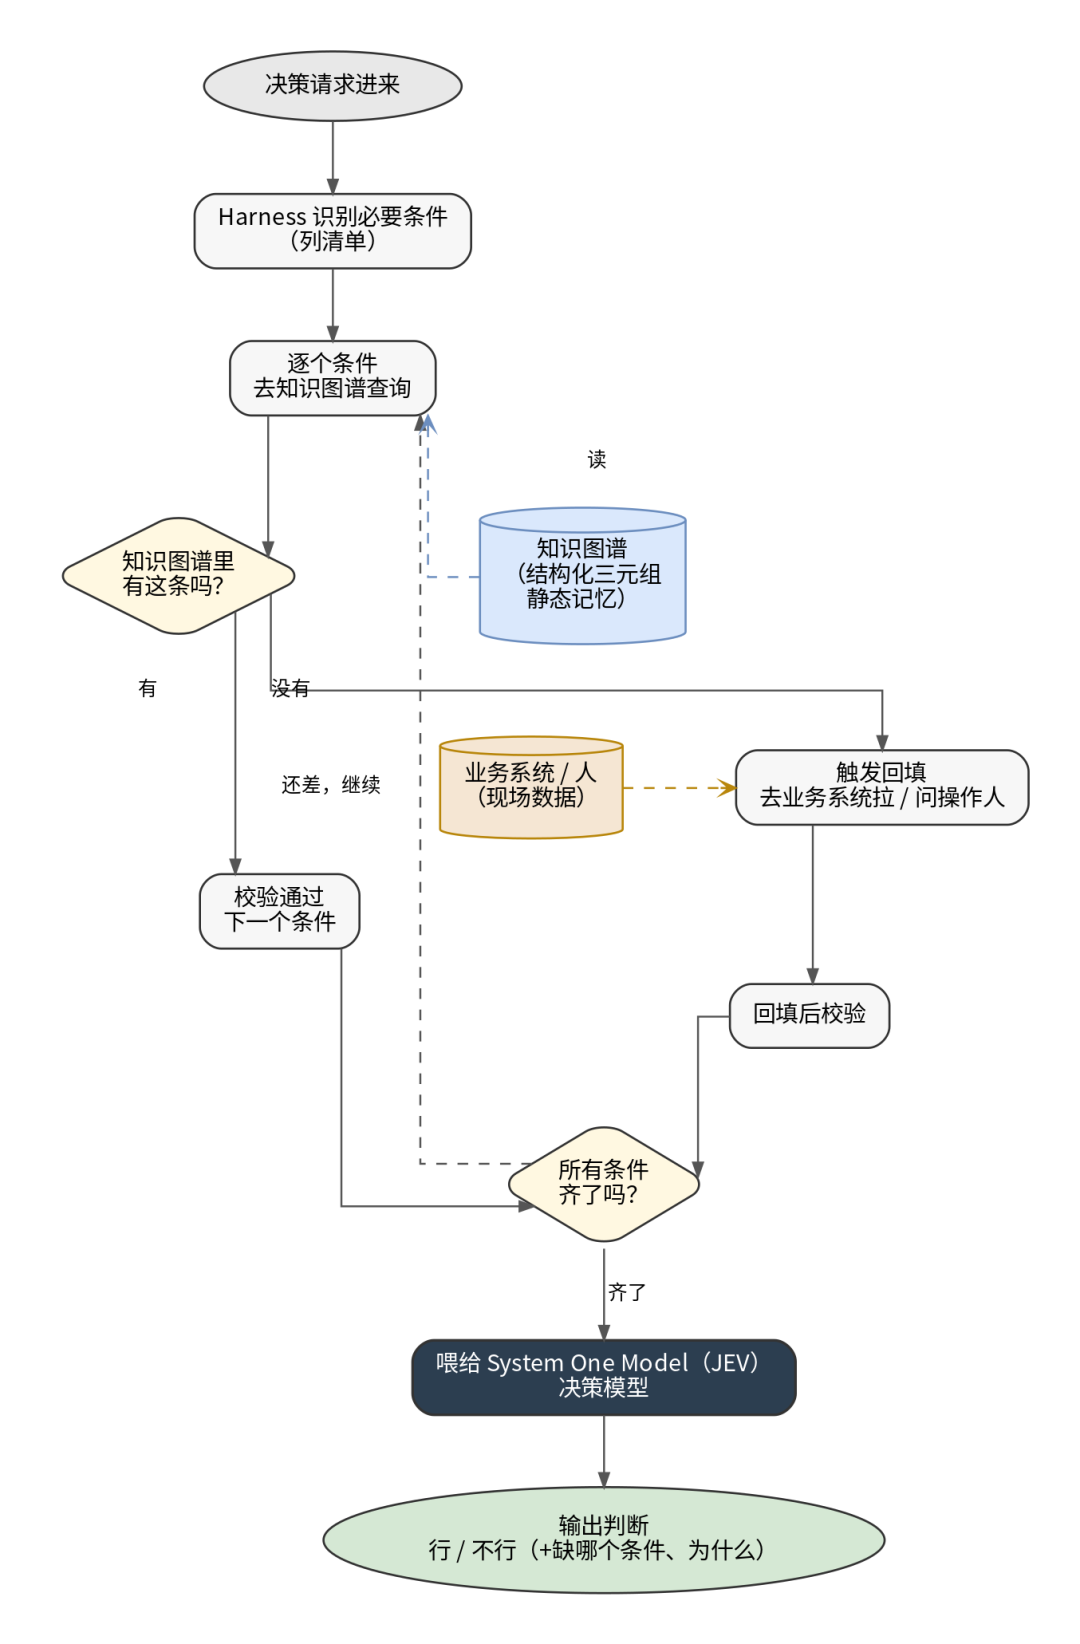
一种是本来就在知识图谱里的。比如这个客户历史上跟我们合作过,欠过几次款,这些数据本来就是结构化的。那直接读出来就行。
另一种是现场才知道的。比如这次订单金额,是今天才谈的,知识图谱里没有。那怎么办?这时候就需要回填。
回填这个词可能有点技术,我解释一下。就是系统发现自己缺一个必要条件,它会主动去问。问谁呢,问操作这个流程的人。或者从订单系统里拉。或者从CRM里查。
谁来做这个识别和校验?
我打算放在Agent的Harness里。Harness你就理解成Agent外面那层脚手架,它不是那个聪明的大脑,它是那个手脚和眼睛。它负责判断现在缺什么,去哪拿,拿回来校验一下对不对,然后喂给决策模型。
整个流程就顺了。
决策模型接到一个请求。Harness先看这个决策需要哪些必要条件。列个清单。然后一项一项去知识图谱里查。查到了,过。查不到,就触发回填,去系统里拉或者问人。所有条件齐了,校验一遍,再把这些结构化的条件喂给决策模型。决策模型基于这些结构化的数据,啪一下给你个判断。
该不该做。该给谁。能不能批。
没有八百字分析,没有「建议您综合权衡」。
就一个字,行,或者不行。不行的话,缺哪个条件,为什么不行。
你想想这个体验。
它快。因为没有每次重新推理。它准。因为数据是结构化的,不会编。它最关键的是,它不会幻觉。
说到幻觉这个事儿,我得多扯两句。
大模型的幻觉是怎么来的?根子上是它在编。它上下文里没有这个信息,但你问了,它不好意思说不知道,它就给你生成一个看起来最像那么回事的。这个「看起来像」就是幻觉的根源。
但三元组不会编。
三元组要么在知识图谱里,有就是有,没有就是没有。Harness发现缺条件,它会告诉你「我缺一个客户信用记录」,而不是给你瞎编一个「根据历史经验,该客户信用良好」。
这一下就把幻觉这个事儿从根上摁住了。
因为它的叙事主体已经被固定成了三元组格式。主谓宾,加上一些基础属性。你甚至可以用本体论那套东西,把类型关联、关系关联都定义死。比如客户这个类型下面必须有行业、规模、信用等级这些字段,缺一个就校验不通过。
这种严格的结构,大模型那种自由发挥的毛病,根本使不上劲。
04 对常见质疑的回应
我知道听到这肯定有人会说,你这东西太死了,不够灵活,企业里哪有那么多标准流程。
这话对。
我非常理解这种质疑。
因为你不是在做一个开放世界的Agent,你是在做一个企业内部的决策系统。开放世界的事情确实复杂,你没法用三元组穷尽。但企业内部的事,恰恰是大部分都被流程化了的。
报销要审批,合同要走流程,客户要分级,订单要路由,库存要预警。这些事哪一件是需要创造性的?哪一件是需要每次都重新推理八百字的?
没有。
它们需要的是稳定、快速、不出错。
一个干了五年的老员工,处理这些事的时候根本不动脑。他看到一个报销单,扫一眼金额、发票、审批人,手就动了。他不是在思考,他是在调用经验。
我们要做的,就是把这个老员工脑子里的东西,结构化地搬进系统里。
我甚至都不打算让这个System One Model去碰那些复杂的活儿。编程、写文案、做战略分析,这些该用大模型用大模型,一点不耽误。
我就把它用在行业上、企业级的那些决策路径上。
你把范围缩到这,复杂度立刻就可控了。
05 对企业AI落地的思考
说真的,我最近越琢磨越觉得,这条路可能比再把大模型训练得大一点要实在。
我们这两年被通用人工智能那个叙事宠坏了。总觉得一个模型应该干所有事,应该像人一样什么都懂,应该越聪明越好。
但你回到企业现场去看看。
老板真正头疼的不是我们的AI不够聪明。是我们的流程跑不起来。是新来的员工要培训三个月才能上手。是那个干了十年的销售总监明天要离职,他脑子里那些客户关系和判断经验跟着他一起走。
这些问题,你靠一个更大的大模型解决不了。
你得把那些经验从人脑子里挖出来,变成结构化的、不会离职的、能复用的东西。
你想想看,这其实就是SOP干的事。
只不过工业时代的SOP写在纸上,存在文件夹里,新人要一页一页翻。现在我们可以把它变成知识图谱,变成工作流,变成一个可以自动跑的决策系统。
德鲁克说过一句话,大概意思是,管理的本质是把知识变成流程。我记不太清原文了,但那个意思是对的。
知识这个东西,存在某个人脑子里,它就只是个人能力。你把它变成流程、变成SOP、变成一套所有人都能调用的系统,它才变成组织能力。
我最近在折腾的事儿,其实就是想用AI时代的工具,把这个过程再往前推一步。
以前的SOP是死的,是人按图索骥去走。
现在的这个系统是活的,它自己会调度,自己会判断,自己会发现缺什么数据然后去补。
你不用教员工遇到A情况该走B流程。系统自己就把他引到B流程上去了。
他只需要在关键节点做那个人该做的判断就行。
这才是我理解的,流程化、SOP化的AI智能化。
不是让AI替代人做决策。是把那些不需要动脑的、重复的、有标准答案的决策,交给那个不会累、不会离职、不会状态不好的System One Model。
人呢,去干那些真正需要创造力、需要同理心、需要拍板的事。
说到这我又想到开头那个Agent。
它下次再跟我说「建议您综合权衡决定」,我大概就知道该怎么办了。
不是它不够聪明。
是它站错了位置。
它本来应该是那个拍板的老员工,结果被我放在了一个事事都要长篇大论的实习生位置上。
让System 2去干System 1的活儿,它只能越干越拧巴。
把位置调过来。让该快的快起来,让该慢的慢下来。
这个事儿,可能才是企业AI落地真正该花力气的地方。
不是追最新的模型。不是堆最多的Token。
是把自己家那本老黄历,认认真真地,变成结构化的东西。
本文由人人都是产品经理作者【产品老高】,微信公众号:【产品老高】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!