
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
OpenAI再次解散机器人团队:GPT-6太强,决定All in通用模型


英伟达一场仿真测试里,GPT-6 Astra 一天都没练过,只靠摄像头画面、机器人状态和一根控制线,就把机械臂任务成功率做到 74.8%,真机苦练的专用策略最高才 51%。同一周,OpenAI 向《财富》确认撤销独立机器人团队。
机器人行业过去有一条很清晰的分工:通用模型负责理解指令,机器人模型负责把视觉、状态和动作对应起来,底层控制器再保证机械臂不会撞上东西。现在这条边界正在变薄。
一项英伟达 10 月公布的仿真测试中,GPT-6 Astra 直接生成机器人动作的成功率达到 66.3%;接入带历史记忆的智能体系统后,成功率升到 74.8%,页面列出的最强专用策略参照为 51.0%。与此同时,OpenAI 向《财富》确认,公司希望把机器人研发和通用模型研究进一步整合,撤销独立机器人团队,将相关人员转入核心研究和应用部门。
这些信息不等于“通用模型已经取代机器人模型”,更不能证明 GPT-6 已经解决了真实世界控制问题。它们真正说明的是:机器人研发的重心,正在从单独训练一个动作模型,转向让通用模型负责理解、规划和纠错,再由专门的控制系统把计划变成安全动作。
机器人任务为什么开始被通用模型接管
给机器人“拿起红色杯子”这个指令,表面上只有几个字,实际上需要完成一串判断:找到杯子,理解“红色”对应哪个物体,估计位置和姿态,判断夹爪是否能接触,生成动作,观察执行结果,再决定是否调整。
过去,这些环节往往由专用模型、规则和状态机分别承担。通用模型的优势在于,它已经从语言、图像、代码和视频中学到大量关于物体、空间关系和任务步骤的知识。机器人研究者真正要解决的问题,变成了如何把这些抽象知识接到身体动作上。
这也是 Astra 机器人实验采用的基本闭环:研究人员提供任务指令、机器人规格、当前图像和状态,模型通过控制接口输出机械臂末端的位置、朝向或关节目标,控制系统将其转换为运动;动作执行后,新图像和结果重新回到模型,模型再决定下一步。
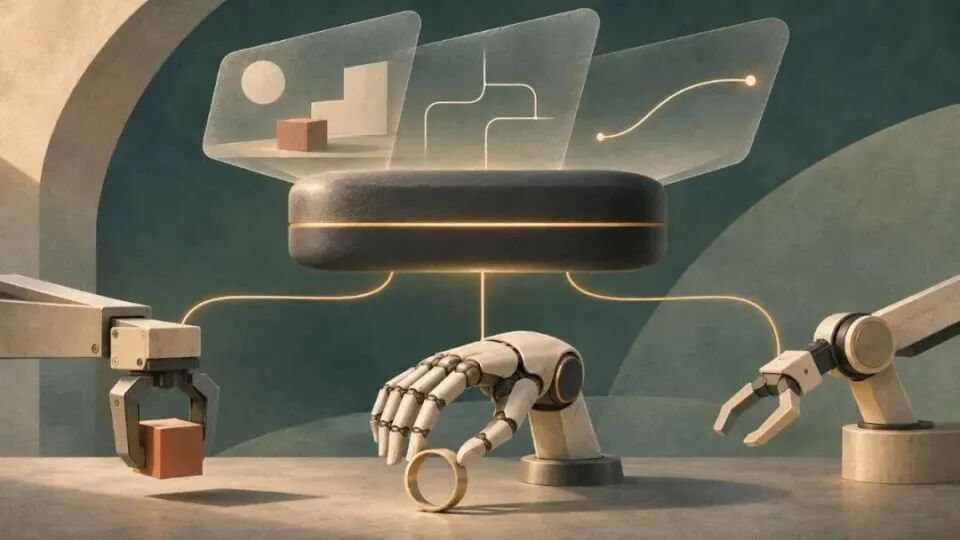
这套架构的变化在于,模型不再只输出一个静态动作,而是参与“观察 – 决策 – 执行 – 反馈”的循环。它可以处理更开放的任务,也能在执行失败后重新规划,但同时带来了新的工程风险:模型输出的不确定性,不能直接穿透到电机层。
66.3% 到 74.8%,提升来自哪里
RoboLab-120 包含 120 项抓取和放置任务。报道给出的结果是,Astra 直接生成动作时成功率为 66.3%;使用持续保留计划、动作和反馈历史的 Codex 智能体后,成功率达到 74.8%,高于页面列出的 51.0% 专用策略参照。
这个对比至少说明了两件事。
第一,记忆和任务编排可能比单次提示更重要。模型如果只看到当前画面,很难知道前一步已经尝试过什么、失败原因是什么、下一步应该改变哪个变量。会话历史把任务变成连续过程,允许 Agent 复用计划、动作和反馈。
第二,Agent 层和动作模型层要分开评估。74.8% 并不意味着模型本身的运动控制精度提升了 8.5 个百分点,它还包含了历史管理、重试策略和任务编排的贡献。开发者做实验时,应至少拆出以下指标:
| 层级 | 应观察的指标 | 失败时要定位什么 |
|---|---|---|
| 感知 | 物体识别、姿态估计、状态读取 | 图像质量、遮挡、坐标误差 |
| 推理 | 任务分解、动作选择、纠错判断 | 上下文、提示、历史记录 |
| 控制 | 轨迹平滑、碰撞率、到位误差 | 控制器、约束、延迟 |
| 任务 | 一次完成率、重试次数、耗时 | 编排策略、终止条件 |
如果只看任务成功率,团队很容易把感知、推理和控制的问题混在一起,最后只能继续堆模型参数。
通用模型仍然需要专门的控制系统
模型可以输出末端位置和关节目标,但它不应该直接负责所有低级控制。真正的机器人系统仍需要一个确定性的安全层,至少包含三类能力:
- 约束检查:验证动作是否超过关节范围、速度、加速度和力矩限制。
- 碰撞与可达性检查:确认轨迹不会撞击环境,也确实能够到达目标姿态。
- 紧急停止与回退:当传感器异常、延迟过高或模型连续失败时,切断动作并回到安全状态。
这层系统的任务不是“替模型做决定”,而是把模型的开放式输出限制在可执行空间。一个更合理的接口,不是让模型直接发送电机电流,而是让模型提交带约束的动作意图:目标位置、允许的速度、执行时限和失败后的回退策略。控制器负责把意图编译成轨迹,并在执行过程中拒绝危险动作。
从机械手解魔方到重新整合机器人研究
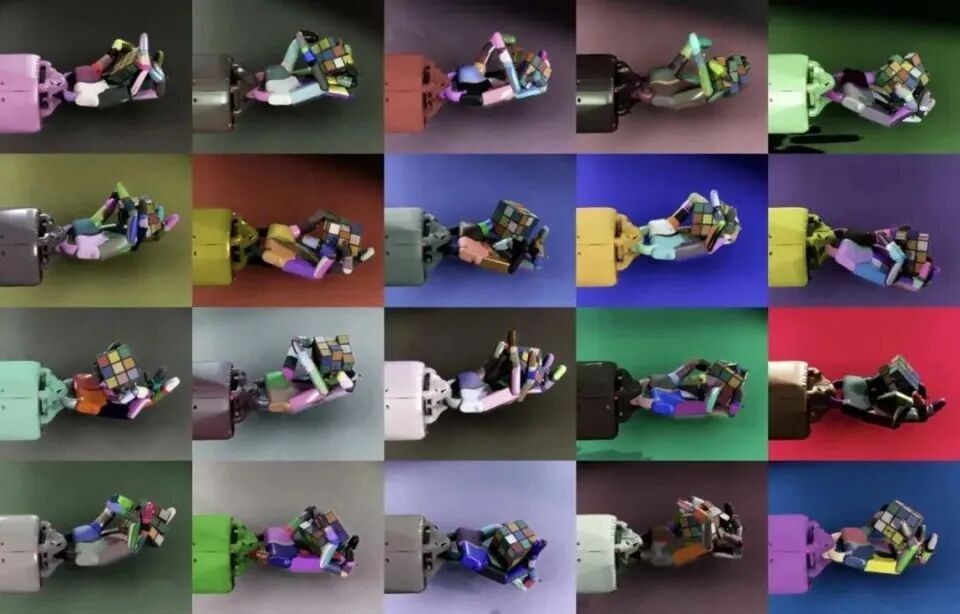
OpenAI 早期曾展示过机械手解魔方的研究:团队在仿真环境中通过强化学习训练神经网络,再把能力迁移到真实机械手;为了缩小仿真和现实的差异,训练过程会随机改变魔方尺寸、质量、手指摩擦等参数。
这个方向很快遇到数据瓶颈。语言模型可以从互联网文本中获得海量预训练数据,机器人却需要观察、接触、动作和结果一一对应的真实交互记录。采集这类数据要依赖硬件、操作者、现场维护和大量失败尝试,规模远低于文本和图像数据。
后来机器人研究重新借助通用模型的知识。视觉 – 语言 – 动作模型把语言和视觉理解接到机器人轨迹上,让系统能够理解新物体和新指令,但仍需要机器人数据建立观察与动作的对应关系。OpenAI 在 2024 年重建机器人团队并与 Figure 合作,也说明专用硬件和数据仍然重要。
如今公司再次把机器人人员并入核心研究和应用部门,更像是组织层面的重新分工:通用模型负责提供可迁移的理解和规划能力,机器人团队负责数据、接口、控制和真实世界验证。独立团队被撤销,不代表机器人问题消失,而是说明机器人能力被视为通用模型的一种落地形态。
八种平台实验,暴露了真实世界的差距
商汤科技与合作团队把同一个 Astra 接到单臂、双臂、移动机器人和人形机器人等 8 种平台上。跨平台测试的价值在于,它可以观察模型是否真的理解任务目标,而不是只记住某一台设备的动作模板。
报道给出的插花案例很典型:单臂机器人夹住花茎后,腕部摄像头看不到花瓶口,动作因此失败;双臂配置中,模型让空闲机械臂移动到合适位置,让另一台摄像头看清瓶口,随后完成插入。这不是简单的“识别更准”,而是模型理解了视野限制,并把另一个机械臂当作获得信息的工具。
但柔性物体、精密接触和连续受力任务仍然困难。抓取刚性物体和堆叠相对容易,布料、线缆、液体、插接和需要细腻力控的任务,会把传感器延迟、摩擦模型和控制误差全部放大。通用模型能给出更好的候选策略,不代表它可以跳过真实硬件验证。
给开发者的工程启示:把 Agent 设计成控制回路的一部分
如果你正在做机器人 Agent,最值得先搭的不是一个更大的提示词,而是一条可回放的执行链:
- 保存每次观察到的图像、机器人状态和任务上下文;
- 记录模型输出的动作意图,以及控制器实际执行的轨迹;
- 把失败原因区分为感知错误、规划错误、控制错误和硬件错误;
- 为每个动作设置超时、撤销和安全回退;
- 在仿真中做大规模回归,再把通过的策略迁移到真实设备。
这样的系统才能回答“为什么这次失败”。没有事件日志和分层指标,团队只会得到一个模糊的成功率,无法判断是模型更聪明了,还是测试任务更简单了。
OpenAI 的组织调整可能预示着机器人不再被视为一条完全独立的模型赛道,而是通用模型走进物理世界后的一个应用层。国内开发者若希望通过 API 接入 GPT、Claude 等模型,可以了解 [Code80]https://code.ai80.vip/home 这类渠道;但机器人系统的关键成本仍在数据采集、仿真验证、硬件安全和控制回路,模型接入只是起点。
常见问题
OpenAI 解散独立机器人团队,是否意味着机器人模型不需要了?
不是。组织整合说明通用模型将承担更多理解和规划工作,但机器人数据、硬件接口、控制器和真实世界验证仍需要专门工程能力。
74.8% 的成功率是否代表通用模型已经超过专用机器人模型?
只能说明在报道引用的 RoboLab-120 仿真基准和配置下,带历史的 Agent 系统取得了更高成绩。它不能直接外推到所有机器人平台、真实硬件和生产环境。
为什么要保存会话历史?
机器人任务通常需要多步执行。历史记录能让系统知道已经尝试过什么、反馈是什么以及下一步应该调整什么,减少重复动作和无效重试。
模型可以直接控制电机吗?
不建议。模型应该提交经过结构化约束的动作意图,由确定性的控制器负责轨迹、碰撞、关节范围、紧急停止和回退。
仿真测试通过后可以直接上真实机器人吗?
不可以。仿真和现实存在视觉、摩擦、延迟、传感器噪声和硬件误差差异。上线前必须经过分级限速、人工监督、真实设备回归和可撤销验证。
国内团队如何接入通用模型做机器人实验?
可以通过 Code80 等 API 渠道降低模型接入摩擦,但应把机器人状态、控制接口和安全策略留在自己的运行时中,避免把硬件权限直接暴露给模型。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!