起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
从 270 分钟到 18 分钟:B 端产品经理如何主导一个 AI 达人撮合系统


人工撮合达人效率低、依赖经验,如何用AI实现智能匹配?本文深度拆解一个AI撮合项目,从需求解析、多路召回、粗排到Cross-Encoder精排,完整呈现五步链路。产品经理如何翻译业务、约束AI、兜底降级、度量效果?答案都在这里。
一、业务痛点:人工撮合为什么撑不住
商家侧的诉求很朴素——”我预算 2 万,想找搞笑风格的美妆达人,别给我竞品合作过的”。但人工撮合模式下,这句话要流转好几手:
- 运营接到需求,先在达人库里按品类粗筛,再凭记忆和经验二次筛选;
- 跨部门对齐预算、档期、黑名单,沟通成本高;
- 筛出来的达人是否真的合适,高度依赖运营个人判断,主观且不可复用。
核心问题不是“找不到达人”,而是“找到合适的达人太慢、太依赖人、且没法沉淀方法论”。 达人池是十万级的,靠人脑记不住、靠 Excel 翻不动,必须让系统来选。
二、核心成果先亮出来
灰度期间覆盖 120 家商家、430 单投放、680 万GMV(单笔均价约 1.58 万,符合内容营销投放客单价),四个核心指标的变化:
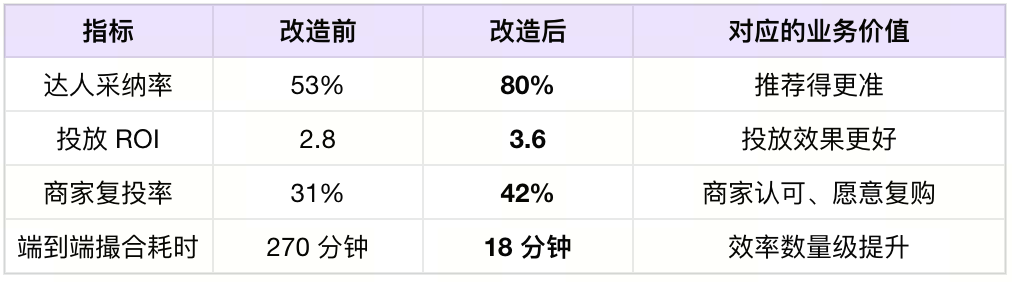
此外,运营人工干预时长下降 79%,可检索达人池扩大 44%,多路召回覆盖率从 62% 拉到 87%,履约率从 91% 提到 96%,作弊达人占比从 4.2% 压到 0.8%。
数据先放这里,后面会逐项说明口径——做 AI 项目的产品经理,最忌讳数据是“拍”出来的,每个数都要能说清楚怎么算的。
三、整体链路:五步走完整业务闭环
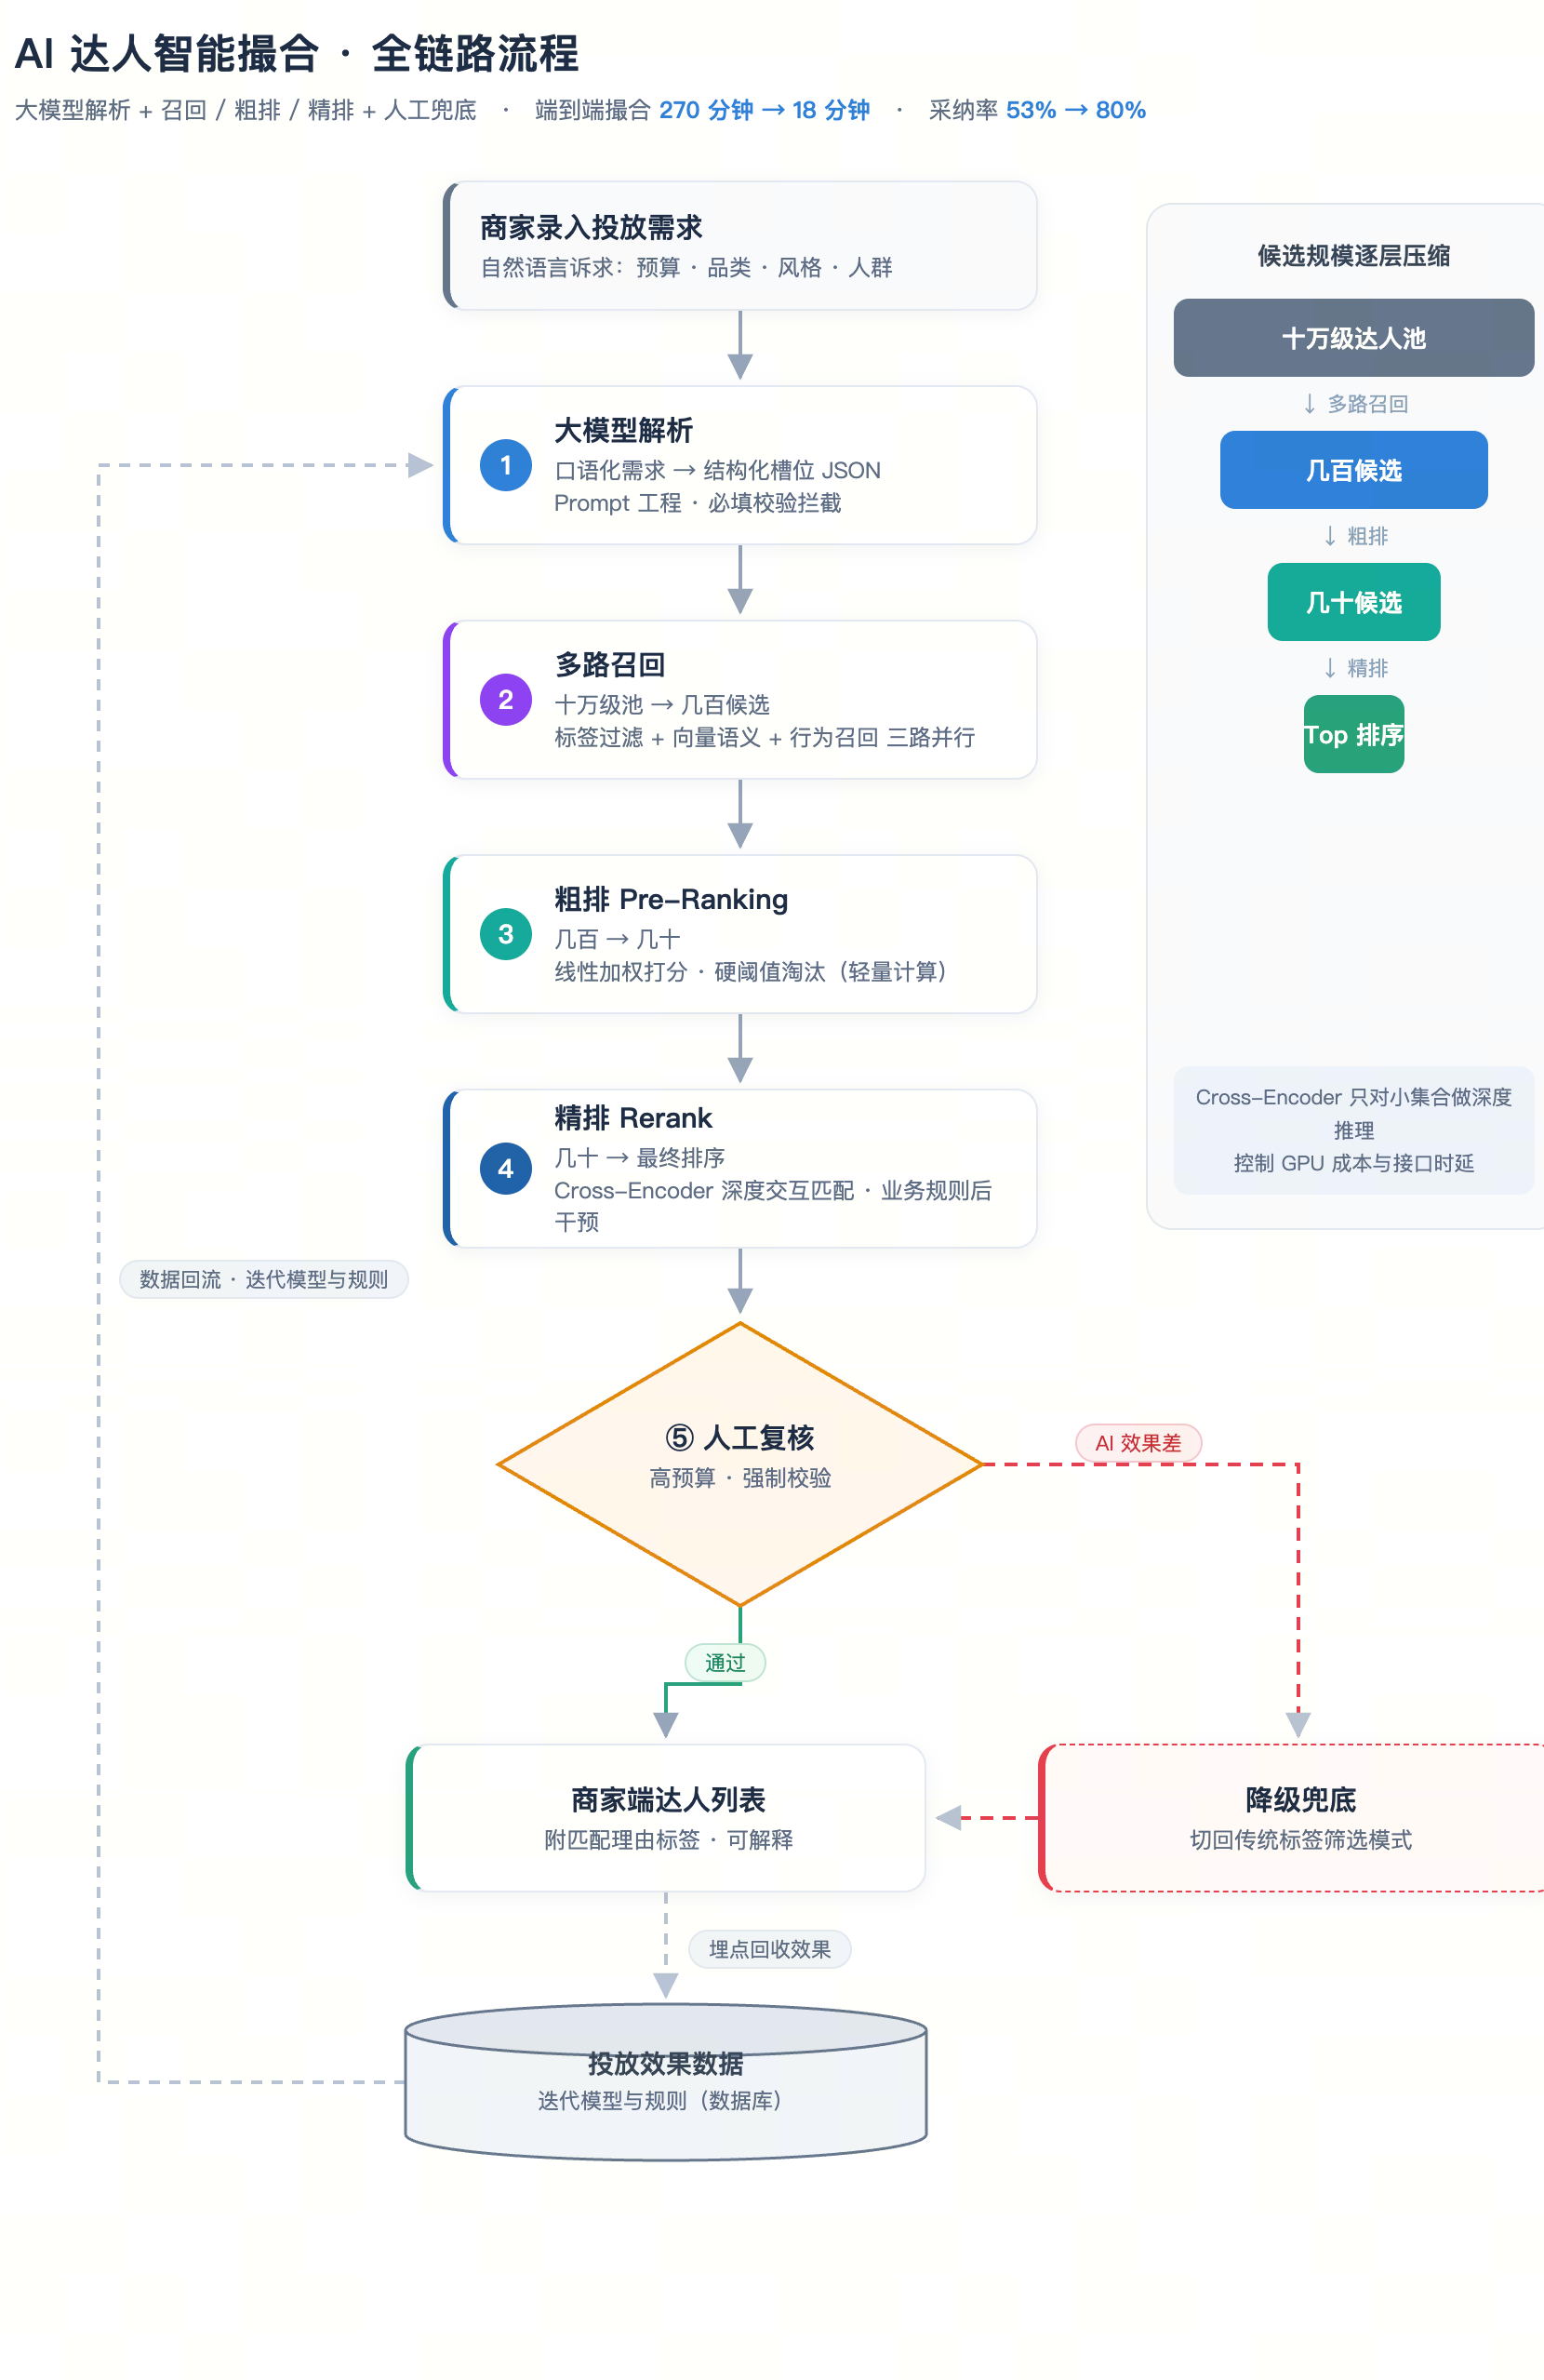
整个 AI 撮合链路分五步,核心是”召回-粗排-精排”这个搜索引擎的经典三层架构,套在达人匹配这个业务场景上:
为什么是这个架构? 关键在于成本分层。达人池十万级,Cross-Encoder 这种深度模型每跑一条都要做完整 Transformer 推理,GPU 开销与时延都扛不住全量跑。所以必须先用便宜的检索把规模压下来,再用贵的深度模型做小集合精排——这是工业界推荐系统的通用范式。
下面逐步拆解。
四、五步链路逐个拆
步骤 1:商家录入需求 → 大模型解析成结构化槽位
商家输入的是口语化诉求:”预算 2 万,找搞笑风格美妆达人,不要竞品合作过的”。直接拿这句话去检索数据库是没法的,必须先转成机器能消费的结构化字段。
大模型在这里干什么:通过 Prompt 工程,把口语化需求解析成标准化 JSON。约定的输出槽位包括:budget_max(预算上限)、category(达人垂类数组)、style(内容风格数组)、ban_competitor(是否排除竞品合作达人)等。
产品在这里做什么:
- 设计前端输入表单:一部分结构化下拉(品类、预算区间),一部分开放文本框给商家写个性化要求;
- 定义输出槽位的字段规范,约定大模型必须输出这套 JSON;
- 设计校验:预算、品类等必填项拦截,防止无效请求流到下游。
这一步的关键认知:大模型不负责“选达人”,只负责“把人说的话翻译成机器能用的参数”。 很多 AI 项目翻车,就是因为让大模型干了不该干的活(直接在百万库里挑达人),既不可控又贵。
步骤 2:多路召回 —— 从十万池捞几百候选
三路召回并行执行,结果合并去重,输出几百个达人 ID:
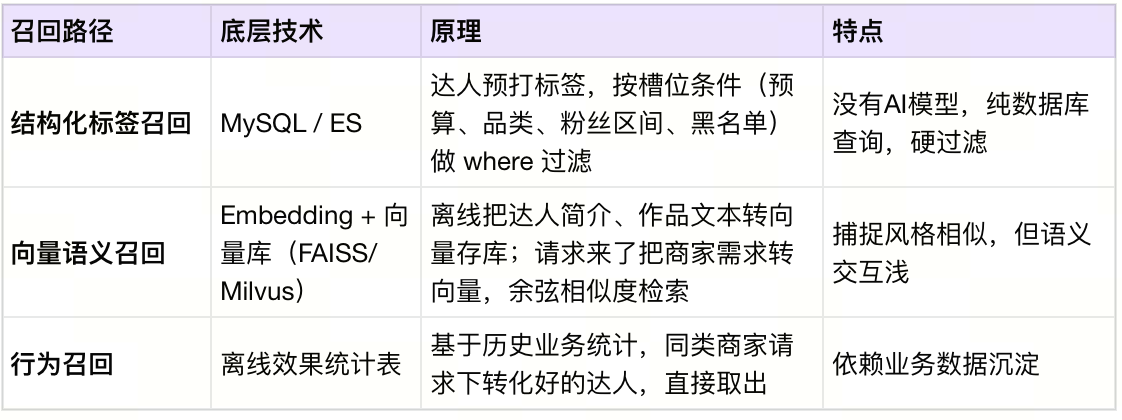
这里有个关键的技术细节:向量召回用的是双塔 Embedding 结构——query(商家需求)和 item(达人)各自编码成向量,在向量空间算距离,两者文本之间没有交互,只能捕捉浅层风格相似。速度快,但匹配深度不够。这正是为什么后面还需要 Cross-Encoder 精排。
产品在这里做什么:
- 设计整套达人标签体系:基础属性标签、业务风险标签、内容风格标签、历史投放效果标签,定义每个标签的业务含义和数据来源;
- 确定多路召回的业务规则:哪些条件强过滤直接剔除,哪些只是参考;配置各路召回返回的候选数量上限;
- 定义黑名单、竞品规避、高风险达人拦截逻辑;
- 设计运营开关:业务可以动态调整各路召回权重,比如活动期优先“预算匹配”还是优先“内容风格匹配”,不用改代码。
步骤 3:粗排 —— 几百候选压缩到几十(快速初筛)
对召回出来的几百个达人做一轮快速打分过滤,淘汰明显不适合的。
关键点:粗排不用大模型,不用 Cross-Encoder,是轻量计算。 一般是线性加权打分(规则模型或简单 LR):
打分维度包括:预算匹配度、达人历史接单履约率、作弊风险分、粉丝质量。打分后按硬性阈值过滤(履约率低于阈值直接 drop),保留 Top-N 送精排。
为什么要有粗排:Cross-Encoder 推理开销大,把召回返回的几百个全送进去,QPS 上来会把服务打挂。粗排先砍一波数量,把候选压到几十,平衡效果和性能。
产品在这里做什么:定义各特征权重、淘汰阈值,做运营配置后台,允许业务根据活动节奏调整门槛。
步骤 4:精排 —— Cross-Encoder 做深度商业匹配
把粗排剩下的几十位达人,和商家完整投放需求做深度匹配,输出最终排序。
技术流程:
- 对每一个达人构造输入样本:[CLS] 商家投放需求文本 [SEP] 达人简介+作品样本文本 [SEP]
- 送入 Cross-Encoder,Transformer 完整做双向注意力,同时看见商家全部诉求和达人全部文本,做深度交互计算;
- 模型输出 0-1 之间的匹配分数;
- 几十个人全跑完推理,按分数降序排序。
和向量召回最大的技术区别:双塔 Embedding 是 query、item 分开编码、互不可见;Cross-Encoder 把两边文本拼接输入,做深度语义交互,能捕捉复杂商业匹配关系。精度高,但每条都要跑完整 Transformer 推理,开销大——所以只能处理小集合,这就是分层架构存在的根本原因。
模型分数出来之后,还有一层业务后干预(规则层):强制屏蔽竞品达人、强制插队头部/垂类达人、AI 效果差时降级切回标签筛选。模型给分,规则兜底。
产品在这里做什么:
- 确定喂给模型的业务特征集合(哪些达人信息、哪些商家业务信息);
- 定义业务强约束规则,在模型打分后做二次干预;
- 设计兜底策略:模型置信度差时,切回传统标签筛选逻辑,不走 Cross-Encoder。
步骤 5:结果输出 + 人工复核兜底
页面展示排序后的达人列表,带匹配理由标签,同时提供人工复核入口。
产品在这里做什么:
- 设计前端结果页面:展示达人信息、匹配理由标签;
- 设计人工复核流程开关:高预算投放强制人工过一遍 AI 输出,防止 AI 出现商业上不合理的推荐;
- 埋点指标体系设计:过程指标(召回覆盖率、耗时)、业务核心指标(达人接单率、ROI、复投率);
- 拿到数据反馈,定位业务问题,反向迭代标签、规则、输入表单,形成业务闭环。
五、产品经理在 AI 项目里的真实卡位
讲完链路,回到那个核心问题:AI 项目里,产品经理到底做什么?是不是就是写PRD?
不止。
在这个项目里,产品经理的工作可以归成四块:
- 翻译——把业务人的模糊诉求变成结构化输入给到 AI(需求解析的槽位设计、Prompt 配合);
- 约束——设计标签、业务规则,用来约束 AI,防止输出幻觉、不符合商业逻辑的结果(黑名单、竞品规避、风险拦截);
- 兜底——设计降级策略,AI 不行的时候系统还能用(切回标签筛选、人工复核开关);
- 度量——设计指标,判断 AI 到底有没有给业务带来价值,拿数据持续迭代。
模型调优是算法同学负责,产品负责的是“全部业务约束和业务价值”。 一句话总结:把业务诉求翻译成算法可以消费的输入,同时约束 AI 输出,避免 AI 给出商业上不可用的结果。
六、几个常被追问的问题
Q1:向量召回已经做相似度了,为什么还要 Cross-Encoder 精排?
向量召回用双塔 Embedding,query 和 item 各自编码、在向量空间算距离,两者文本之间没有交互,只能捕捉浅层风格相似(比如”搞笑风格”对得上)。但”这个达人到底适不适合接这条商业广告”是更复杂的商业判断,需要把商家全部诉求和达人全部文本拼在一起做深度语义交互——这正是 Cross-Encoder 的强项。两者解决的是不同深度的问题,缺一不可。
Q2:为什么不能直接拿召回的几百个跑 Cross-Encoder?
Cross-Encoder 每条样本都要跑完整 Transformer 推理,GPU 算力与时延开销高。几百条并发推理会让接口 RT 飙升,服务性能扛不住;所以粗排先用轻量过滤把候选集压到几十,再让贵的深度模型上场。这是效果和性能的工程平衡,不是技术洁癖。
Q3:大模型在这里会不会乱推荐达人?
不会。大模型只做需求解析,不直接在百万达人库挑达人。真正选达人走的是”召回-粗排-精排”链路,叠加产品设计的业务硬规则做拦截,高预算场景再加人工复核兜底。把大模型用在它擅长的”语言理解”环节,把”选品”这种需要可控、可解释的环节交给工程化链路——这是这套设计能上线的根本。
七、写在最后:透明披露比好看的数据更重要
这个项目做完,最大的体会是:AI 项目的数据,宁可主动说局限,也不要藏着掖着。270 分钟→18 分钟,270 分钟是端到端时间(含需求对齐、人工筛、跨部门沟通),不是纯筛选时间;
ROI 2.8→3.6 是灰度对照组 vs 实验组的同品类投放平均 ROI,数据来自效果回收模块的后链路归因,不是自己拍的;
120 家商家、430 单投放做 AB 对照有统计意义,但全量推还需要更长周期验证。
AI 还在快速演进,达人撮合这个场景也在变。但有一件事不会变:产品经理的价值,在于把模糊的业务诉求翻译成清晰的系统约束,并保证这套系统在商业上是可用的、可控的、可迭代的。 这才是产品经理在 AI 时代不可替代的部分。
本文由 @Totoro畅 原创发布于人人都是产品经理,未经许可,禁止转载
题图来自 Unsplash,基于 CC0 协议


- 目前还没评论,等你发挥!