起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
招 Agent 工程师,为什么张口就是 LangChain?


招聘 Agent 工程师,JD 第一行常写「熟悉 LangChain」。这个 2022 年 10 月才开源的项目,四年间从工具库长成 Agent 工程体系,它究竟解决了什么问题,又凭什么成了行业默认门槛?
最近很多同学反映,找一个Agent工程师的工作,都要求要会langchain,好像不会langchain就不会开发Agent一样!今天我们就来捋一捋langchain这个开源框架。
LangChain 最早在 2022 年 10 月开源,这个时间点正好赶上大模型应用爆发的前夜。
那个时候 ChatGPT 甚至还没有正式发布,但开发者已经开始通过 API 调用 GPT-3 等大模型,开始尝试开发各种 AI 应用。
LangChain 最开始做的事情,其实并没有今天这么复杂。
它最早主要解决的问题:
怎么把开发大模型应用时反复出现的工作抽离出来,做成可以复用的组件。
比如:
- 调用不同的大模型
- 管理 Prompt
- 连接外部数据
- 调用工具
- 把多个步骤串成一条执行链路
开发者不需要每做一个应用,都把这些基础能力重新写一遍,而是可以直接使用 LangChain 提供的组件进行组合。
这也是早期 LangChain 非常核心的思想:
把 LLM 应用开发,从每次重写,变成组合已有组件。
随着大模型能力不断增强,应用形态也开始发生变化,最开始,大家主要用大模型做:问答、文本生成、RAG,大模型开始具备更强的工具调用和推理能力,应用也逐渐从调用一次模型得到结果,变成:
让模型自己判断下一步做什么、调用什么工具,并循环执行任务。
也就是我们今天熟悉的 Agent。
LangChain 也顺着这条路线在不断演进。尤其是在 1.0 版本之后,它的定位已经明显从早期的大模型应用开发框架,逐渐转向了一套围绕 Agent 开发构建的完整技术栈。现在再说 LangChain,其实已经不能只理解成一个 Python 框架,而更像是一整套 Agent 开发体系。其中又进一步拆成了几个不同层次的组件:
负责比较上层的 Agent 开发抽象,开发者可以通过它快速接入模型、Tools、Middleware,并构建一个可以运行的 Agent。
LangGraph
更偏底层的 Agent Runtime 和流程编排,它主要解决 Agent 在真正执行过程中遇到的问题,例如:
- 状态管理
- 长流程执行
- 持久化
- 人工介入
- 多步骤工作流
- Agent 中断与恢复
Deep Agents
是在 LangGraph 和 LangChain 之上的更高层封装,它进一步提供了:
- 任务规划
- 文件系统
- 上下文管理
- 子 Agent
- 长时间任务执行
这些能力,更适合开发复杂、长时间运行、具有较强自主性的 Agent。
LangSmith
则负责 Agent 进入工程和生产阶段之后的问题。
例如:
- Trace
- 评测
- 调试
- 部署
- 生产监控
也就是说,我们不仅可以把 Agent 做出来,还可以继续观察它每一步到底做了什么、哪里出了问题,以及修改之后效果到底有没有变好。
所以我们回过头看 LangChain 这几年的发展,它其实经历了一条非常清晰的路线:
LLM 应用工具库->Chain / RAG 开发框架->Agent 开发框架->完整的 Agent 工程体系
接下来,我们先从langchain开始,看看用它来开发一个 Agent。
Agent 是什么
在正式写代码之前,我们先把一个问题捋清楚:
Agent 到底是什么?开发一个 Agent,又需要哪些东西?
我们先看看现在市面上比较常见的一些 Agent,比如 Codex、WorkBuddy、豆包等。这些产品虽然不太一样,但都有一个比较明显的共同点:
你给它一个任务,它会自己想办法把任务做完。
比如让它:
- 查资料
- 写一份文档
- 开发一个功能
- 修改一个 Bug
- 调用外部工具完成某个操作
它不会只是回答你一句话,而是会根据当前任务,判断下一步应该做什么。如果需要执行工具,就调用对应的工具,工具执行完之后,它还会继续根据返回结果判断下一步,直到把任务完成,最后再把结果交给我们。
那么,这套东西底层到底是怎么工作的?我们先不不要把事情搞得太复杂。如果只做一个最简单的 Agent,其实可以先把它拆成两个最核心的部分:
Agent = Model + Tools
其中:
Model 负责理解任务、判断下一步做什么。
Tools 负责真正执行具体操作,比如搜索网页、读取文件、查询数据库、执行代码。
这两个部分组合起来之后,就有了一个最基本的 Agent。
下面我们先画一个最简单的 Model + Tools 工作流程图。
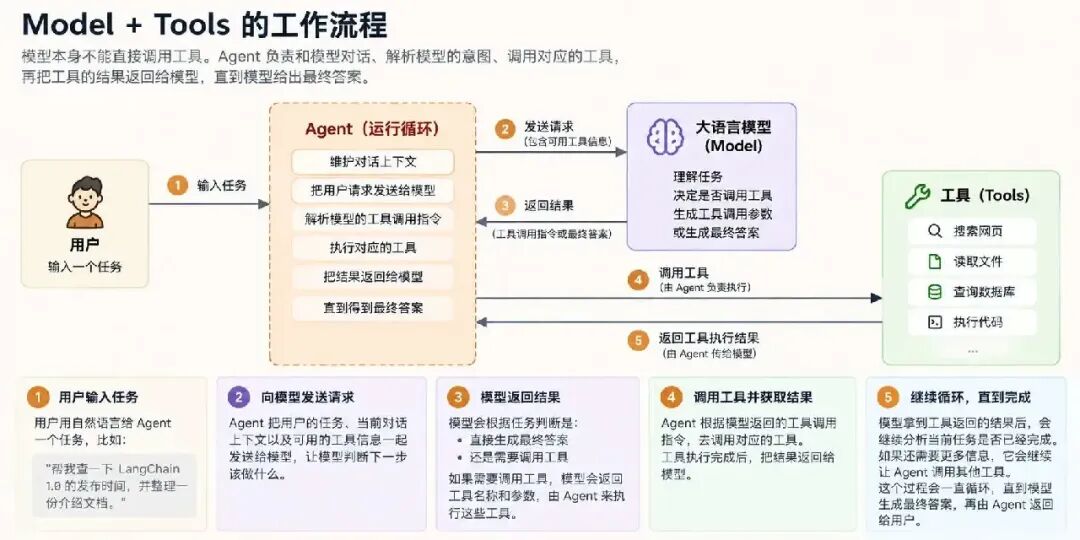
从这张图可以看到,模型本身并不会直接去执行工具。
它主要负责理解任务、判断下一步要做什么,以及生成工具调用指令。
真正负责执行工具的是 Agent 的运行循环。它会读取模型返回的工具调用请求,执行对应的工具,再把工具执行结果重新交给模型。
模型拿到结果之后,会继续判断下一步。
如果任务还没有完成,就继续调用工具,如果已经完成,就生成最终答案。
所以,一个最基本的 Agent,其实就是在不断重复:
模型判断 → Agent 执行工具 → 工具返回结果 → 模型继续判断
直到整个任务完成。
了解这个之后,下面我们看看如何使用langchain来实现这个过程。
LangChain 开发一个 Agent
上面我们已经知道,一个最简单的 Agent,核心其实就是 Model + Tools。
有了模型负责判断,有了工具负责执行,再通过 Agent 的运行循环把它们串起来,一个最基本的 Agent 就可以工作了。
接下来我们就从代码开始,一步一步把这个过程实现出来。
LangChain 目前主要提供 Python 和 TypeScript 两套开发库,这里我们选择使用 Python 来开发。
既然使用 Python,就需要先准备好本地的 Python 开发环境,同时还要处理虚拟环境和项目依赖。这里我们选择使用 uv 来进行管理。
uv 是 Astral 开发的一套 Python 项目管理工具,它把 Python 版本、虚拟环境、依赖安装和依赖锁定这些事情统一到了一起,使用起来会比传统方式简单很多。后面的示例项目,也都会使用 uv 来管理。
安装 uv
如果使用的是 macOS 或 Linux,可以执行:
curl -LsSf https://astral.sh/uv/install.sh | sh
Windows PowerShell 可以执行:
powershell -ExecutionPolicy ByPass -c “irm https://astral.sh/uv/install.ps1 | iex”
安装完成之后,可以通过下面的命令确认是否安装成功:
uv –version
接下来创建一个新的项目:
uv init langchain-agent-demo
进入项目目录:
cd langchain-agent-demo
到这里,一个最基本的 Python 项目就准备好了。
在正式开发之前 我们先给 项目增加langchain的依赖包
uv add langchain
初始化模型
这里我们选择deepseek模型来做测试,我们先添加deepseek的依赖
uv add langchain-deepseek
如果需要使用其他模型和组件,也可以去官方查看说明
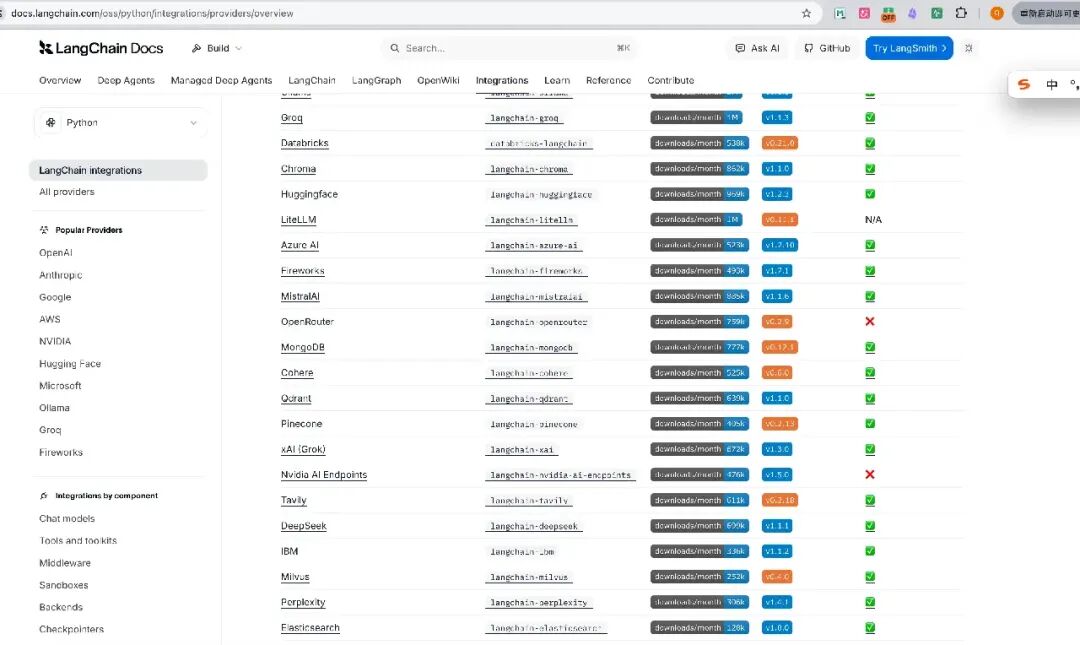
然后我们在当前的main.py 文件中添加一个方法 来初始化一个deepseek的模型
import json
from langchain.chat_models import init_chat_model
def init_model():
model = init_chat_model(“deepseek-flash”)
result=model.invoke(“Hello, how are you?”)
# print(responses)
# 我们把这个结果打印出来,显示成json结构化的样子,方便查看,ensure_ascii=False 表示中文可以正常显示,不转义
print(json.dumps(result.model_dump(), indent=2,ensure_ascii=False))
if __name__ == “__main__”:
init_model()
调用模型就是这么简单,就一个方法 init_chat_model 就可以获取指定模型的服务,这里有一个隐藏的点,就是需要再环境变量中 配置DEEPSEEK_API_KEY这个密钥,密钥需要去官网获取,不同的模型这个环境变量不一样,具体可以去langchain的官网查询,配置好了之后,langchain会自动加载这个密钥去访问deepseek的服务,我们运行一下看看
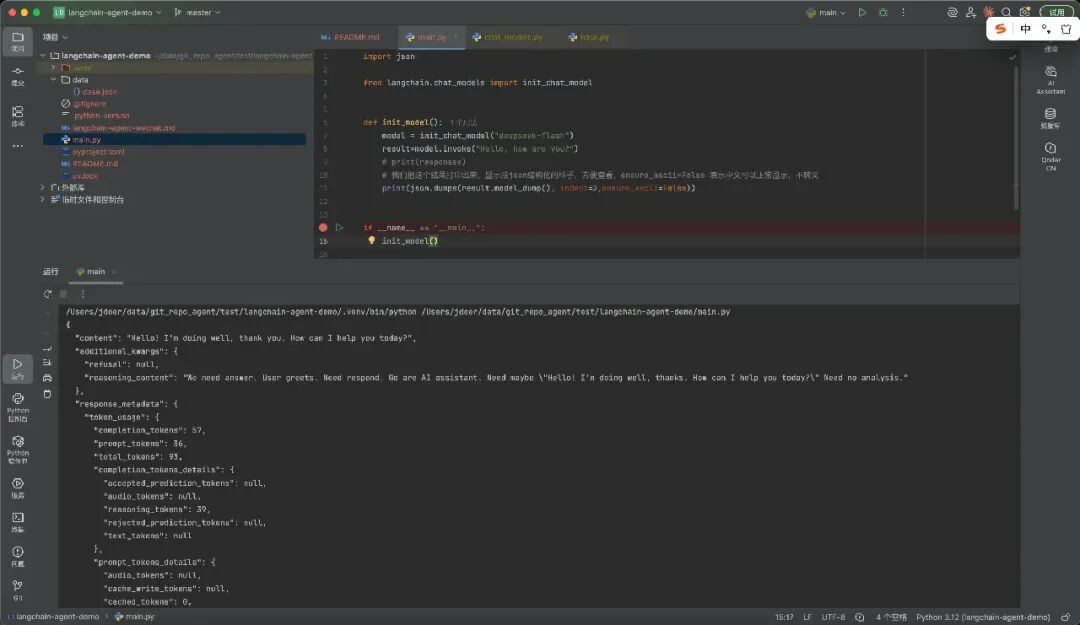
模型调用成功,这里我们的模型就配置好了,下面我们来看如何处理工具
工具定义和运行
我们先抛开 LangChain 这个框架来看,Agent 是如何使用工具的。这里可以分成三个部分:
- 工具的定义:告诉模型有哪些工具,每个工具能做什么,需要哪些参数。
- 工具的使用:模型根据当前任务,判断是否需要工具、使用哪一个工具,并生成调用参数。
- 工具的执行:程序根据模型返回的调用请求,执行对应的函数,再把结果交回模型。
1. 工具的定义
工具在程序里面,本质上可以是一个函数,用来封装一些具体操作,比如读写文件、调用外部 API,或者查询业务系统的数据。
定义一个函数时,我们会写函数名称、输入的参数、具体的执行逻辑,以及返回值。
但从 Agent 的运行流程来看,在执行之前,模型需要先知道有哪些工具可用,才能判断要不要用、用哪一个。
那么,怎么把我们定义好的工具给到大模型?目前,很多主流模型都支持工具调用。以 DeepSeek 的 Chat Completions API 为例,请求中提供了一个 tools 参数,用来传递可用工具的定义,具体格式可以查看官方的api。
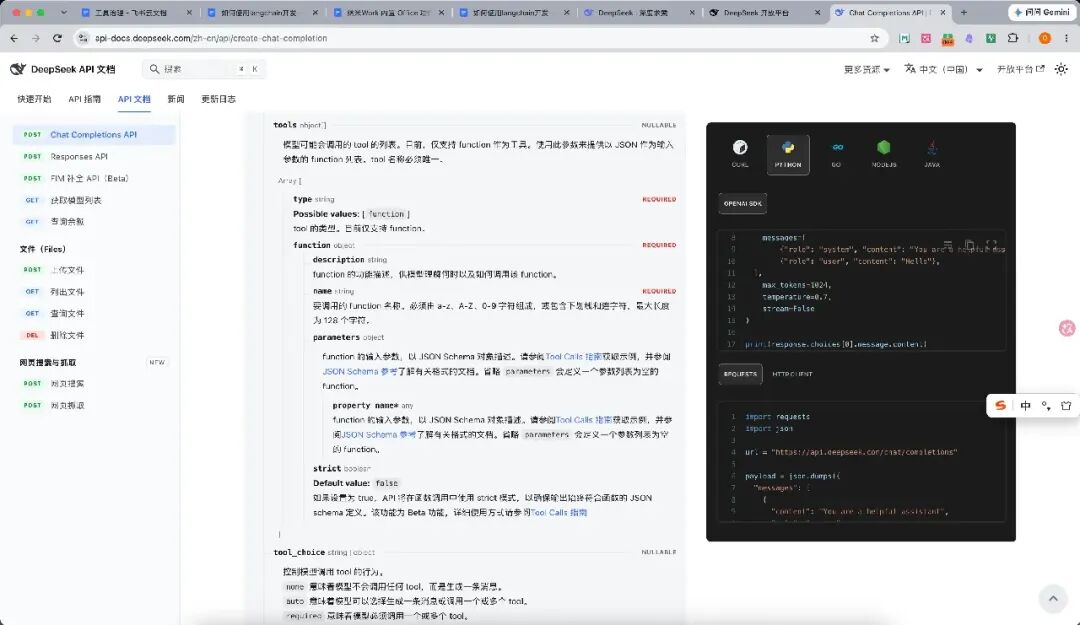
比如,我们定义一个查询城市天气的工具,就可以按照下面的格式构建 tools 参数:
tools = [
{
“type”: “function”,
“function”: {
“name”: “getWeather”,
“description”: “获取城市天气”,
“parameters”: {
“type”: “object”,
“properties”: {
“city”: {
“type”: “string”,
“description”: “城市名称”
}
},
“required”: [“city”]
}
}
}
]
这段定义里,name 是工具名称,description 告诉模型这个工具能做什么,parameters 则用 JSON Schema 描述它需要的输入参数。
这里的 city 是一个字符串,表示城市名称,required 表示调用时必须提供这个参数。
有了这些信息,模型才能知道,如果需要查询某个城市的天气,可以选择 getWeather,并把城市名称放到 city 参数里。
如果每增加一个工具,都要手动写一遍这样的定义,工具多起来之后,维护就会比较麻烦。
LangChain 对工具定义做了封装,最简单的方式,就是在函数上加一个 @tool 装饰器:
from langchain.tools import tool
@tool
def getWeather(city: str) -> str:
“””获取指定城市的天气。”””
# 先用模拟数据演示,实际使用时在这里调用天气 API
return f”{city}:晴,25℃(模拟数据)”
LangChain 会根据函数名称生成工具名称,根据文档字符串,也就是三引号中的说明,生成工具描述,再根据参数的类型注解生成输入参数的结构。
这种方式属于自动推断。实际开发中,我们通常希望能够更加精确地控制工具的名称、描述以及参数定义。
@tool 同样支持显式定义这些信息,其中参数结构可以通过 Pydantic 来定义。
我们把上面的代码修改一下:
from langchain.tools import tool
from pydantic import BaseModel, Field
# 定义工具输入参数
class WeatherInput(BaseModel):
city: str = Field(
description=”需要查询天气的城市名称,例如北京、上海”
)
# 定义工具
@tool(
“get_weather”,
description=”查询指定城市的天气信息”,
args_schema=WeatherInput
)
def getWeather(city: str) -> str:
# 模拟天气数据
returnf”{city}:晴,25℃(模拟数据)”
这里我们显式定义了工具的三个核心信息:
- name:工具名称,这里是 get_weather,通过 @tool 的第一个位置参数指定。
- description:工具描述,告诉模型这个工具能够完成什么任务。
- args_schema:工具的输入参数结构,这里使用 Pydantic 的 BaseModel 定义,并通过 Field 补充每个参数的描述和校验规则。
LangChain 会根据 WeatherInput 生成对应的 JSON Schema,其中包含参数名称、类型、描述以及是否必填等信息。
相比前面的自动推断,这种方式能够更精确地控制提供给模型的工具定义。尤其是工具参数比较多,或者需要进行参数校验时,使用 Pydantic 会更加方便。
无论采用哪种方式,添加 @tool 之后,原来的 Python 函数就会被包装成一个 LangChain 工具对象。
这个对象既保留了函数的执行逻辑,也包含提供给模型的工具定义。后续我们只需要把工具注册到 Agent 中,模型就可以根据工具的名称、描述和参数结构,判断什么时候需要使用它,以及应该传入什么参数。
2. 工具的使用
下面继续用前面配置好的 DeepSeek 模型来演示。下面几个 Python 代码块可以放到工具定义的后面,按顺序放在同一个文件中运行。
import json
from langchain.chat_models import init_chat_model
model = init_chat_model(“deepseek-flash”)
model_with_tools = model.bind_tools([getWeather])
messages = [{“role”: “user”, “content”: “帮我查一下杭州的天气”}]
response = model_with_tools.invoke(messages)
print(json.dumps(response.tool_calls, indent=2, ensure_ascii=False))
这里的 bind_tools 会把工具定义绑定到模型调用上,调用模型时再由模型集成层转换成厂商要求的请求格式。我们就不用手动构建前面那段 tools 参数了。
如果模型选择使用查询天气这个工具,LangChain 会把返回的调用请求整理到 response.tool_calls 中,结构类似这样:
[
{
“name”: “getWeather”,
“args”: {
“city”: “杭州”
},
“id”: “call_example”,
“type”: “tool_call”
}
]
这里的name 表示要执行哪个工具,args 是模型生成的参数,id 用来把这次调用和后续返回的工具结果对应起来。注意,这里展示的是 LangChain 整理后的格式。DeepSeek 原始接口中,工具名称在 function.name 中,参数在 function.arguments 中,并且参数是一段 JSON 字符串。LangChain 把它们统一成了这里的 name 和 args,方便程序处理。
3. 工具的执行
接下来,就需要程序根据返回的工具名称找到对应工具,再把模型生成的参数传进去。
在 LangChain 中,可以通过工具对象的 invoke 方法执行工具。执行完成后,再把结果作为工具消息放回对话中,再次调用模型,让它根据结果继续处理。
接着前面的代码,我们把这个过程写成一个简单的循环:
from langchain.messages import ToolMessage
tools_by_name = {getWeather.name: getWeather}
messages.append(response)
while response.tool_calls:
for tool_call in response.tool_calls:
selected_tool = tools_by_name[tool_call[“name”]]
tool_result = selected_tool.invoke(tool_call[“args”])
messages.append(
ToolMessage(
content=tool_result,
tool_call_id=tool_call[“id”],
)
)
response = model_with_tools.invoke(messages)
messages.append(response)
print(response.content)
这里先把模型返回的消息放进 messages,保留它发起了哪些工具调用。然后遍历 tool_calls,找到对应工具,执行并获取结果。
ToolMessage 用来把执行结果交回模型,其中的 tool_call_id 要与调用请求中的 id 对应。这样,即使模型一次请求多个工具,也能知道每条结果属于哪次调用。
模型拿到工具结果后,如果还需要调用工具,就继续循环,如果没有再返回工具调用请求,就退出循环,打印它的回答。
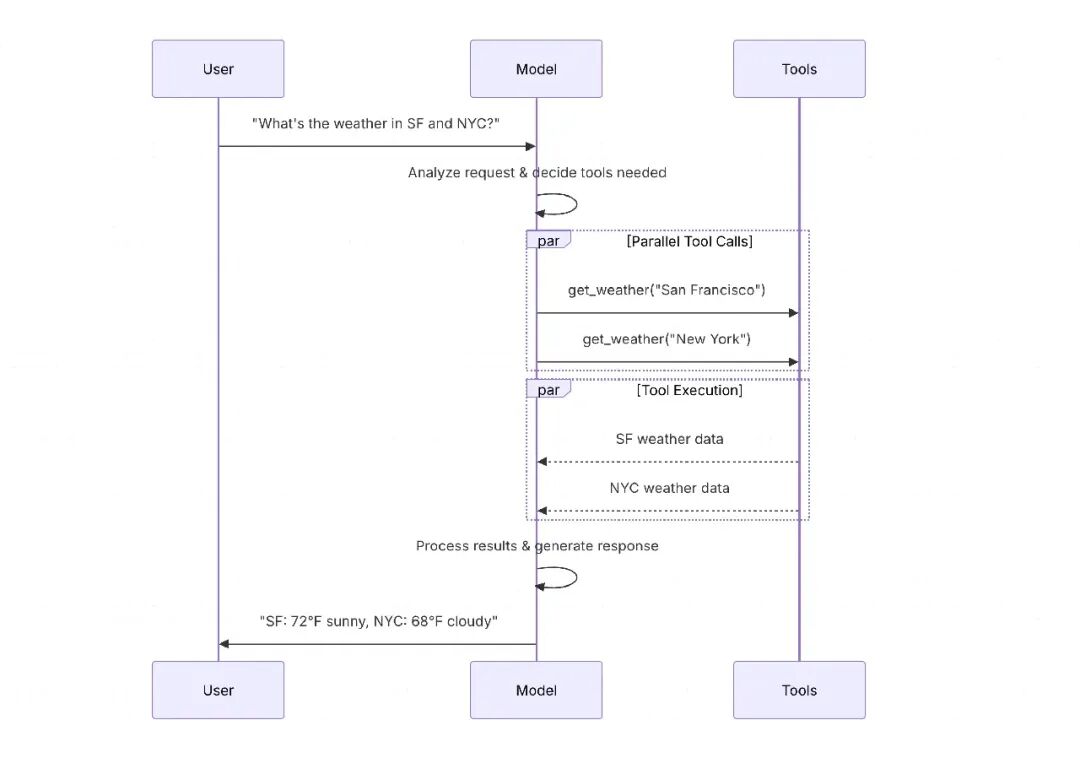
在这个例子中,工具只会返回我们写好的模拟天气,用来演示整个过程。要获取真实天气,需要把函数里面的实现替换成天气 API 调用,到这里,我们就把前面讲的流程接起来了:
定义工具 → 模型选择工具并生成参数 → 程序执行工具 → 结果返回模型 → 模型继续判断。
如果自己实现 Agent,就需要维护工具列表、消息记录,以及模型和工具之间的这个循环。LangChain 里面有一个create_agent 方法,已经把这部分基础流程封装好了,接下来我们就用它来创建 Agent。
创建 Agent
上一节,我们自己写了工具调用循环,先调用模型,读取 tool_calls,执行工具,再把结果交回模型。如果模型还需要工具,就继续循环处理。
LangChain 提供了 create_agent 方法,可以把模型和工具组织起来,替我们处理这个循环。下面我们就看看,怎么用它创建一个 Agent,再把任务交给 Agent 执行。
为了测试 create_agent,我们先准备一组模拟售后数据。假设用户买了一副耳机,发现左耳没有声音,想问下:“我能申请退货吗?”
这里为了方便演示,我们把订单信息、退款申请状态和退货规则放在 data/case.json 这个模拟的数据文件中,作为工具查询的数据源,再用上一节介绍的 @tool 定义四个工具,分别负责查询订单、查询申请状态、获取规则和计算申请时间窗口。这些工具的代码放在 main.py 中。
有了这些准备,就可以给 Agent 一个问题,观察它能否通过调用工具获取信息,再根据返回结果给出回答。这样就能看到 create_agent 如何把模型和工具之间的执行过程串起来。
下面是这次测试需要的模拟数据和工具定义。先创建 data/case.json
{
“case_id”: “CASE-001”,
“user_id”: “USER-001”,
“order_id”: “ORDER-1001”,
“as_of_date”: “2026-10-15”,
“request”: “耳机左耳没有声音,我能申请退货吗?请给出依据。”,
“order”: {
“product”: “无线耳机”,
“paid_at”: “2026-10-05”,
“received_at”: “2026-10-08”,
“price_yuan”: 299,
“status”: “已签收”
},
“refund_application”: {
“status”: “未提交”,
“submitted_at”: null
},
“rules”: [
{
“id”: “RULE-7D”,
“text”: “签收后七日内,用户反馈商品存在质量问题时,可提交退货退款申请;商品问题及最终处理须经人工审核。”
}
]
}
然后把下面的数据加载和工具定义放到 main.py 中,
import json
from datetime import date, timedelta
from pathlib import Path
from langchain.tools import tool
# 加载案例数据(模拟后端数据源)
CASE_FILE = Path(__file__).parent / “data” / “case.json”
CASE_DATA = json.loads(CASE_FILE.read_text(encoding=”utf-8″))
@tool
def get_order_info(order_id: str) -> str:
“””根据订单号查询订单基本信息,包括商品名称、付款日期、签收日期、价格和订单状态。”””
if order_id != CASE_DATA.get(“order_id”):
return json.dumps({“error”: f”未找到订单 {order_id}”}, ensure_ascii=False)
return json.dumps(CASE_DATA[“order”], ensure_ascii=False)
@tool
def get_refund_application_status(case_id: str) -> str:
“””查询指定售后案例的退款申请状态(是否已提交、提交时间)。”””
if case_id != CASE_DATA[“case_id”]:
return json.dumps({“error”: f”未找到售后案例 {case_id}”}, ensure_ascii=False)
app = CASE_DATA[“refund_application”]
return json.dumps(
{“case_id”: case_id, **app},
ensure_ascii=False,
)
@tool
def get_return_rules() -> str:
“””获取平台退货退款相关规则条款,用于判断用户诉求是否符合政策依据。”””
return json.dumps(CASE_DATA.get(“rules”, []), ensure_ascii=False)
@tool
def check_return_window(case_id: str) -> str:
“””按模拟规则校验七日申请窗口:已提交时使用申请日期,未提交时使用模拟处理日期。”””
if case_id != CASE_DATA[“case_id”]:
return json.dumps({“error”: f”未找到售后案例 {case_id}”}, ensure_ascii=False)
received_at = date.fromisoformat(CASE_DATA[“order”][“received_at”])
deadline = received_at + timedelta(days=7)
app = CASE_DATA[“refund_application”]
# 未提交时按模拟处理日期评估,已提交时按记录中的申请日期评估
evaluation_date = date.fromisoformat(
app[“submitted_at”] if app[“status”] != “未提交”else CASE_DATA[“as_of_date”]
)
return json.dumps(
{
“case_id”: case_id,
“as_of_date”: CASE_DATA[“as_of_date”],
“received_at”: received_at.isoformat(),
“seven_day_deadline”: deadline.isoformat(),
“evaluation_date”: evaluation_date.isoformat(),
“evaluation_basis”: “申请日期”if app[“status”] != “未提交”else”模拟处理日期”,
“within_seven_days”: received_at <= evaluation_date <= deadline,
},
ensure_ascii=False,
)
把模型和工具交给 create_agent
模拟数据和工具准备好之后,就可以开始创建 Agent 了。先把上面定义的四个工具放进一个列表,方便一起传给 create_agent
RETURN_TOOLS = [
get_order_info,
get_refund_application_status,
get_return_rules,
check_return_window,
]
工具列表有了,模型继续使用前面配置好的 DeepSeek,再加上一个任务说明的提示词,就可以调用 create_agent:
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
agent = create_agent(
model=init_chat_model(“deepseek-flash”),
tools=RETURN_TOOLS,
system_prompt=(
“你是一个售后助手。你需要回答用户的问题”
),
)
这里主要传入三个参数:
- model:负责理解任务、选择工具和生成回答,这里继续使用 DeepSeek。
- tools:Agent 可以调用的工具集合,运行时按模型返回的工具名称找到对应实现。
- system_prompt:说明助手的任务和回答要求,模型会结合它、用户消息和工具结果判断下一步。
create_agent 把这些配置组织成一个可运行的 Agent。
和上一节相比,我们不需要再手动调用 bind_tools以及手动创建一个 agent_loop,把工具传给 create_agent 后,框架会在调用模型时带上可用工具的定义,并组织后续的工具执行流程。
通过 invoke 发起任务
Agent 创建好之后,还没有开始处理用户的问题。接下来,从刚才准备的模拟数据中取出用户诉求和查询需要的编号,组成一条消息,通过 agent.invoke 交给它执行:
user_message = (
f”售后案例:{CASE_DATA[‘case_id’]},订单:{CASE_DATA[‘order_id’]}。\n”
f”本次模拟处理日期:{CASE_DATA[‘as_of_date’]}。\n”
f”用户诉求:{CASE_DATA[‘request’]}”
)
result = agent.invoke({“messages”: [{“role”: “user”, “content”: user_message}]})
print(result[“messages”][-1].content)
messages 是消息列表。这里把用户问题和查询需要的编号放进一条用户消息中,作为这次运行的输入。
调用一次 agent.invoke,内部可能发生多次模型调用和工具执行。
比如模型请求查询订单,LangChain 就会找到对应工具,传入模型生成的参数,再把执行结果作为工具消息交回模型。如果模型继续请求工具,就继续执行。在这里的基础流程中,模型不再请求工具时,本轮运行结束,invoke 返回结果。
对照上一节的代码,遍历 tool_calls、查找并执行工具、构建 ToolMessage、维护消息列表,再调用模型,这些原本需要我们手写的步骤,现在都由 create_agent 创建的执行流程处理。
查看运行结果
invoke 执行完成后,我们就可以通过返回的 result 查看这次运行的结果。其中,result[“messages”] 保存了运行过程中的消息记录。
print(result[“messages”][-1].content) 打印的是最后一条消息的内容,通常就是给用户的最终回答。如果想看模型调用了什么工具、工具返回了什么,也可以接着打印完整消息记录:
for message in result[“messages”]:
message.pretty_print()
如果本次运行使用了工具,就能在记录中看到用户消息、模型发起的工具调用、工具执行结果,以及模型最后的回答。具体工具顺序和调用轮数由模型决定。
把前面的代码按顺序放进 main.py,配置好 DEEPSEEK_API_KEY 后,在项目目录运行:
uv run main.py
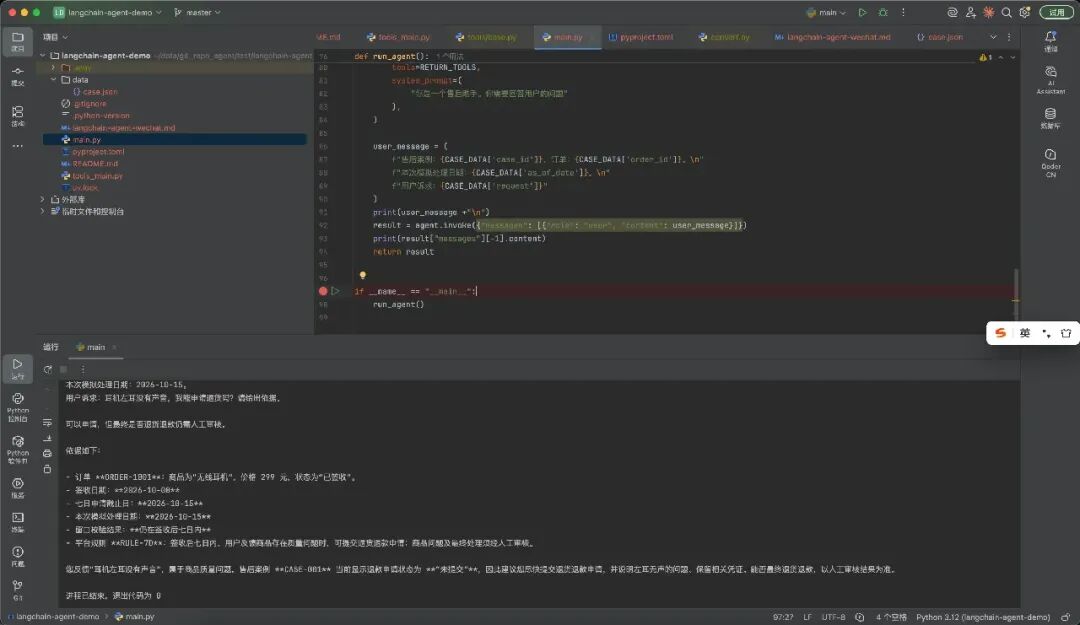
有了 LangChain,我们指定模型、传入封装好的业务工具和系统提示词,就可以通过 create_agent 创建一个简单的 Agent。原来需要手写的 agent_loop,由框架负责处理,开发时也就能把更多精力放在具体的业务逻辑上。
到这里,我们已经用 LangChain 搭建了一个简单的 Agent。后续我们在继续介绍 LangChain 的进阶用法。
本文由人人都是产品经理作者【叶小钗】,微信公众号:【叶小钗】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于 CC0 协议。

- 目前还没评论,等你发挥!