起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
企业该买模型还是养上下文?


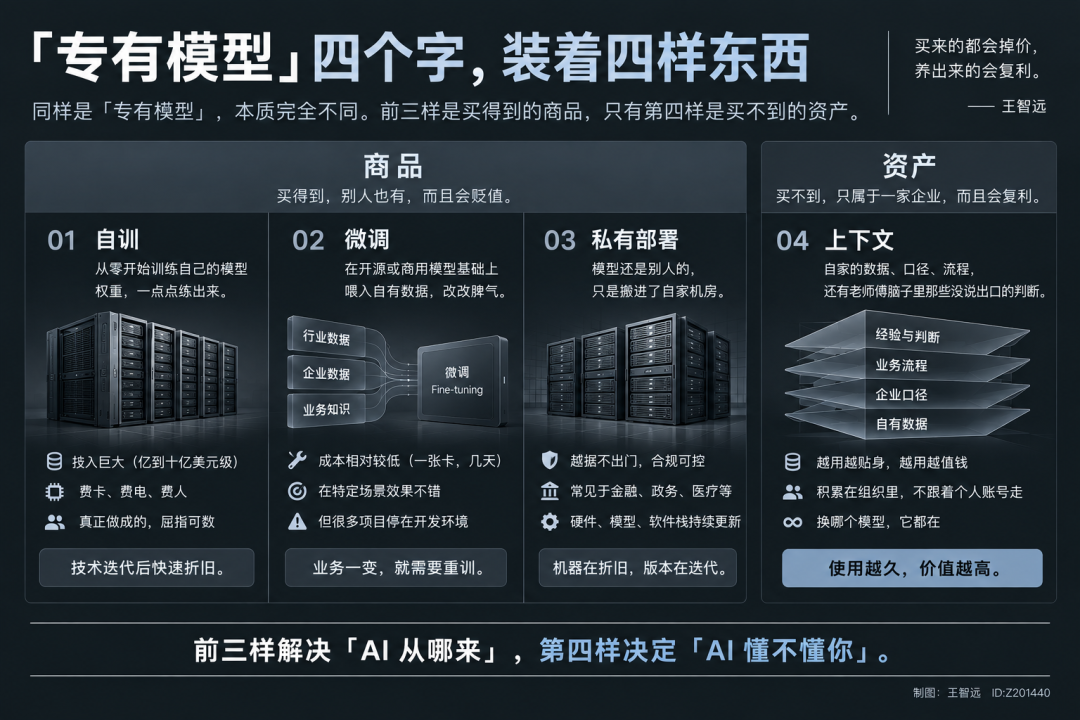
过去半年,不少老板都被同一个问题问过,咱们要不要搞一个自己的大模型。「专有模型」四个字实际装着四样东西:自训、微调、私有部署和上下文。前三件是买得到、会贬值的商品,第四件才是买不到、会复利的资产,文章用三笔账给出了不同企业的选择清单。
过去半年,不少老板都被同一个问题问过,咱们要不要搞一个自己的大模型?
问的人很认真,被问的人心里有点慌,钱不少花,方向看不清。
这个词从哪一年开始流行的,已经记不清了,反正到了今天,方案里、标书里、发布会的舞台上,到处都能听见「专有模型」四个字,听得越多,心里越没底。
这四个字,现在被用成了一个筐,什么都往里装;倒出来看,四样。
第一件,自己训。
从零开始,把模型的权重一点点练出来,费卡、费电、费人。这几年动过念头的企业不少,理由也都好听,数据自主,不受制于人。
这条路的入场券,是一亿到十亿美元的学费,外加一支几百人的团队,真干成的,一只手数得过来。
第二件,微调。
拿一个开源模型,喂上自家的数据,改改脾气。一张卡,几天功夫,就能有一个像模像样的「自家模型」;改完的模型,说起自家行话来,比通用模型顺耳得多。
客服问答、合同审查、文档处理,这几年属它被提得最多,也最容易被当成「自建」。
第三件,私有部署。
模型还是人家的,只是搬进了自家机房,数据不出门。一台一体机往机房里一摆,验收单上写的,也是「专有」。
银行内网问答,跑的往往不是最聪明的模型,属于最不出门的那个。这个需求是实的,数据不出门,这本身就值钱。
第四件,上下文。
自家数据、自家的口径、自家规矩,还有老师傅脑子里那些没说出口的判断,同样是「降本」,这家企业和那家企业,背后的算法不一样,它不写在合同里,也没法验收,但它决定 AI 是干活,还是捣乱。
嗯,四样东西,归归堆。
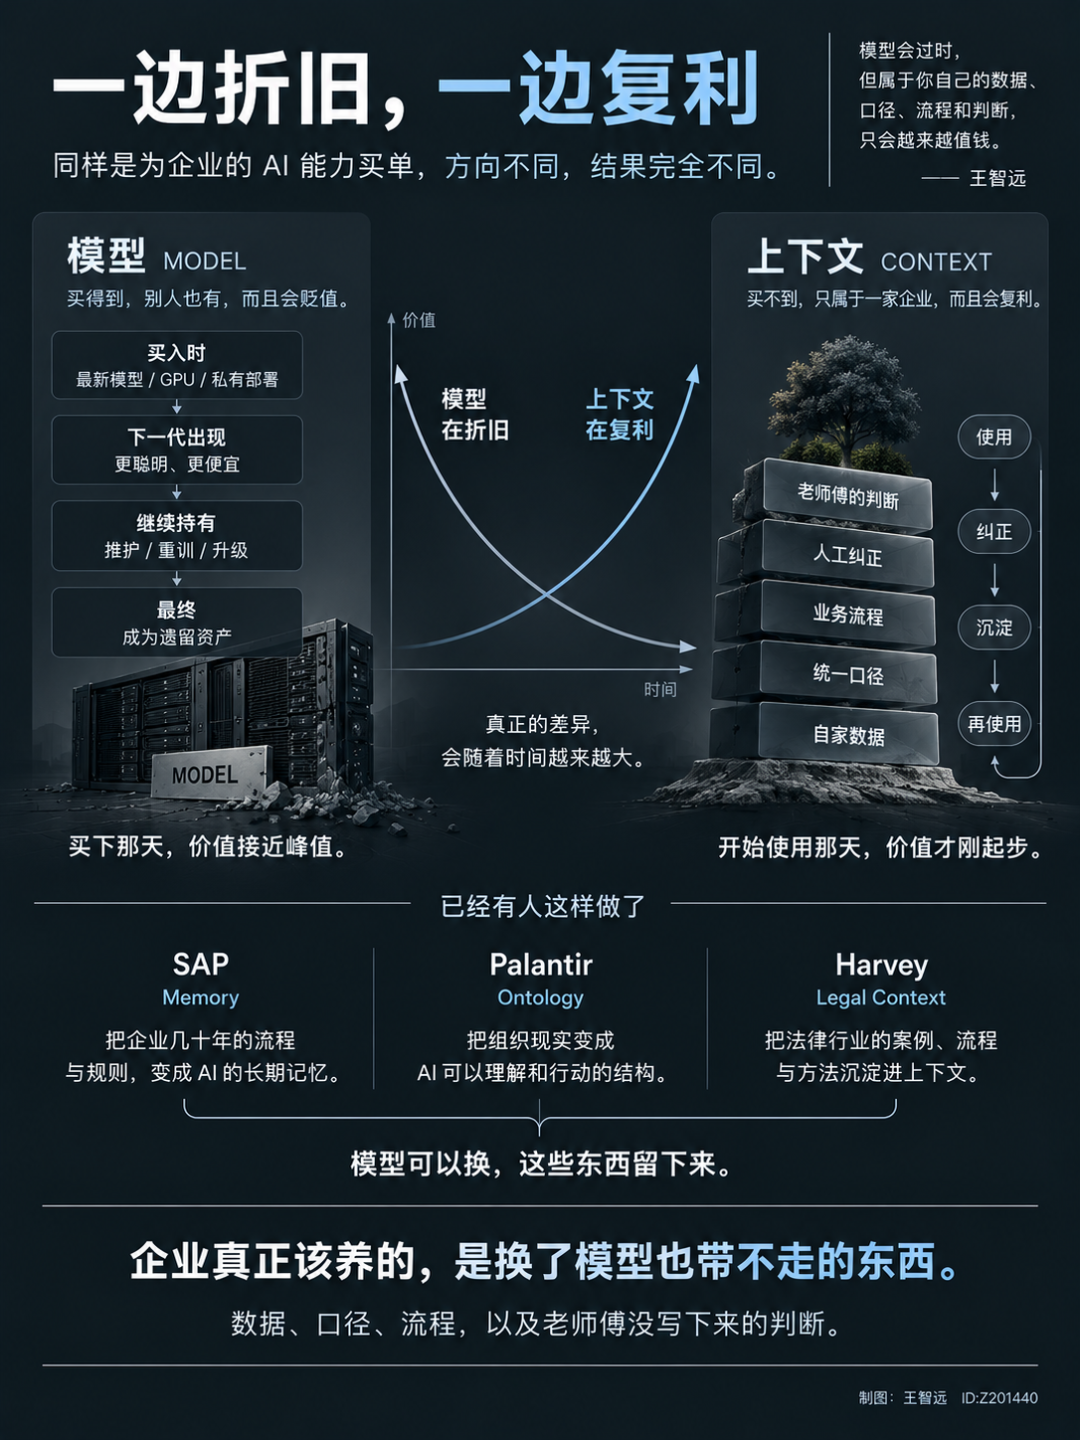
前三件是商品,买得到,别人也有,而且会贬值,三年之后的大模型,一定比今天更聪明、更便宜,今天买的那个,到时候,只剩折旧。商品的价值,买的那一刻就封顶了。
第四件是资产,买不到,只属于一家企业,而且会复利,数据攒了三年,别人三年也追不上。资产的价值,从买的那一刻才开始,资产越用越贴身,喂它多少,它记多少,换哪个模型,它都在。
商品是落地就掉价的车,资产是越耕越肥的地,而且商品过期是悄无声息的,签完三年合同,第二年它就已经旧了,企业买商品不亏,亏的是把商品当资产买。
麻烦还多一层,这三件商品,长得越来越像资产。预算表上有它,方案封面有它,验收报告里也有它,不拆开看,根本分不出来。
这就怪了,既然只有第四件是资产,为什么推销的人,张口闭口全是「专有模型」四个字?
因为混着卖,最好卖,好处在于,三件商品都能报出资产的价。
你去问供应商,这份方案里哪件是买断的?哪件是租的?哪件明年要续费?很少有人答得利索,答得太清,单子就难签了。
华为盘古,官方文案里写着,搭载行业知识库,无需企业从零微调,企业买到手的,是华为的行业版,矿山版、政务版、金融版,一个版本卖给所有人。
再看那些横评,五款企业 AI 平台大盘点,大模型一体机怎么选,不少是厂商自己发的。
更生气的是行业模型市场,恒生金融模型、讯飞医疗模型、拓尔思政务模型,名字都带行业,产权都在厂商手里,听着像定做,其实一版通卖。
「行业专有」,行业是真的,专有没有,这个词最大的用处,是让企业觉得,不搞一个,就落后了。
你看,三件商品、一件资产,账单咱们得分开来算。先算哪个呢?索性就拿重的开刀吧。
……
彭博,全世界最有资格做金融专有模型的公司。四十年的数据,垄断的终端,华尔街的屏幕上跑的都是它。
2023 年,它真干了,从零训了一个 500 亿参数的模型。130 万 GPU 小时什么概念?五百多张顶级显卡,不眠不休转 53 天。当时的说法是,数据护城河能打败大模型。
三年过去,答案来了,彭博全球终端产品的负责人亲口讲,那个模型,是个研究模型,实际上没在任何产品里用过。
现在它的终端里跑什么?
商业模型加开源模型的混合,喂着彭博自己的数据。通用模型在金融多轮问答基准上反超,76 对 43。
最要命的地方在哪,它训完那天,参数就冻住了。对面那些通用模型,几个月换一代。一个站着不动的模型,追一个跑着的模型,只会越追越远。
其实,手里攥着全世界最好的料,也未必打得过一直在跑步的对手。
好,第一笔账,明面上的,看得见。剩下两笔,账面上好看,暗地里更闷。
微调那笔,最会伪装。一张卡,几天功夫,就能改出一个专属模型,又便宜又体面。
很多企业走进这条路,图的就是一个「自己的」,改完的模型说起自家行话,确实顺耳,可顺耳的代价,后面才付。
拉到生产里看,VentureBeat 今年 6 月的一份调研,73% 的项目,要么死在半路,要么没敢上。最大的一个坑,叫沙盒坟场,45% 的企业卡在这里,钱花了,模型还在开发环境里下不来。
做成的那 27%,条件也苛刻,任务要稳定,量要够大,评测要跟得上,缺一样都白搭。
还有个隐蔽的坑,模型是个静态快照,喂饱它的那天最聪明,往后业务一变,它就成了遗留资产,不重训跑不动,重训,又是一轮钱。
部署那笔最闷,信通院今年的报告,82% 的企业倾向私有部署,理由正当,数据不出门。国有六大行,自建算力占 96%,可规模大,不代表账划算。
看看各地的智算中心,信通院白皮书里的数是 58.3%,西部有的地方,实际不到三成;中部有个省,规划 1200P 的算力,当地需求不到 200P。
机器立在机房里,电费在走,折旧在走,业务没来。这些钱是沉下去的,机器还没跑满,新一代芯片又出来了。
更深的一层账在这,花大价钱买的「专有」,买到的往往是位置,不是权力,机房是自家的,权重是别人的,生态也是别人的。
前阵子韩国出了个事,政府搞主权 AI 项目,硬性要求从零自研,不许依赖外部预训练组件,NAVER 的模型里用了阿里的视觉编码器,没过关,被淘汰了。
可半年后,韩国最大的主权 AI 工厂,主角还是 NAVER,出钱的,是卖芯片的英伟达。
原来主权这个词,得拆三层看,最上面是模型,权重是不是自己训的,韩国人查的就是这里,NAVER 没过关;往下是机房,算力在不在自己国土上,这层 NAVER 拿了满分。
再往下还有一层,芯片是谁家的?软件栈是谁家的?生态是谁的?没人查,查了,大家都不及格。
而企业买到的「专有」,大多停在中间那层,机房是自家的,机房外,全是别人的;买的时候没人提醒,等企业回过神,合同签完了,验收单也交了。
三笔账摆完,有人会觉得眼熟,这账不是新账。
2023 年,行业里就有人喊过,别急着自己从头训,重复造轮子,是对资源的极大浪费。
喊完三年,专有、主权、自主可控,这些词越喊越响,喊话的人还在喊,掏钱的人还在掏,中间隔着的,只是一层新词。
三年里,模型能力翻了好几个跟头,这笔账的结构,一页没改过。
账面上丢钱,真正在流的是时间,钱能再融时间不能,三笔账算完,能下单的都会贬值,唯一会涨的那件不在货架上。
……
账这么难看,为什么还在买?归根到底,这不是一道算术题。
出钱的是公司,拍板的是个人。买错了,是公司的损失;不买,是个人担着落后的责任。调查里,四分之三的 CIO 后悔过自己的 AI 采购,可当初,字都是他们签的。
一句被改过来说的老话,没有人因为买大模型被开除,但有人因为没买被追问。
将近三成的 CIO,还被要求解释过一段自己也看不懂的 AI 输出,七成的人担心,到期证明不了价值,预算和位子都要受影响。买,成了交差;不买,成了背锅。
冲着慌买回来的东西,最后剩下的,还是慌。
想跳出这个局,得把账本合上,换一张清单,思考一下,哪些该买?哪些该建?
先说三件商品的规矩:
自训,门槛在几十亿的预算和一支几百人的队伍,没到那个规模,连想都别想;微调,条件三条,任务稳定,数据够厚,评测跟得上,缺一样都别开工,不然,等于往坟场里送钱。
部署,数据敏感就认它,政务图安全,金融求快,医疗要准,制造等不起,各家侧重不同,顺序都一样,先保证数据不出门,再谈聪明。
还有一条通用的纪律,养不起维护团队的,一律别碰。模型这东西,买得起只是一半,养得起才是全部。市面上最贵的一句话,叫开源免费。
那件会长的东西,长什么样?看两个把这事做对的。
一个是 SAP,做 ERP 做了五十年,今年它讲得最重的一句话,是记忆。
它把客户几十年攒下的流程、规矩、审批记录,全收进一个叫 Company Memory 的地方,让 AI 干活之前,先读一遍这家的家规。
它还有一个机制,每一次人工纠正,都会教给下一轮。
另一个是 Palantir,有人当面问它的 CEO,模型呢?他甩了一句,在模型这件事上,我们完全无关,它给客户搭模型上面那一层,用他的原话,那个应用层,就是我们的本体。
卖记忆的,卖本体的,都是千亿美元级的生意,客户名单上写满银行、药厂、军队,一个比一个难伺候。没有一家,碰过自训。
还有一类新玩家,不卖记忆也不卖本体,卖行当。
做法律 AI 的 Harvey,客户名单覆盖了大半个顶级律所圈,它也没训自己的基础模型,赢在把法律这行的话术、案例、流程,全吃成了自己的上下文。
所以,轮到自己,清单并不长。
数据有硬门槛的,金融、政务、医疗,先补部署,把合规的坑填上,这一件,优先级最高。
大多数企业,模型直接买最好的,一分钱别省在模型上,省下来的钱和精力,全花进上下文,把数据整干净,把口径定死,把流程里那些说不清的规矩写下来,这三件事,没有一件能外包。
只有极少数,数据厚、场景稳、团队有,可以试试微调,当项目做,别当战略做。
第四件里,最深、也最值钱的那部分,藏在老师傅脑子里。同样报价,为什么给这家让三个点,给那家一分不让,这些从来没人写下来过。
把它们一点点掏出来,写下来,喂进去,这才是建上下文;这件事没有供应商能替你做,因为谁脑子里有什么,只有自家清楚。
大企业建本体,中小企业借本体,借也不用另找地方,现用的那些软件里,早就躺着半个本体,把它接上,起点就有了。
还有一笔账要顺带算清,算力能按月租,模型能按用量买,手里的那点预算,花在数据和流程上,回报比买机器高。
这些事没有发布会,没有剪彩,长得很慢,但长得结实。晚一天开始,它就晚一天复利;绕了一圈,「专有模型」四个字,贵的从来是「专有」那两个字,模型会过时,专有不会。
好了,我们来总结一下,就三句话。
专有模型四个字,装着四样东西,三样商品,一样资产,这是第一句;第二句,三样商品的账,一本比一本难看,越像资产的、,跌得越狠。
最后一句,真资产在自家数据、口径,和老师傅没写下来的判断里。买不来,养得起;下次再有人聊起专有模型,别急着问价钱,先问一句,说的是哪一件?
数据来源:
[1].本文部分参考来自包括彭博、SAP、Palantir、英伟达等公司的官方发布与高管访谈,中国信通院、VentureBeat、Dataiku 等机构调研
本文由人人都是产品经理作者【王智远】,微信公众号:【王智远】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议


- 目前还没评论,等你发挥!