起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
详情页秒变16 秒宣传片,Flova做电商设计夯爆了!


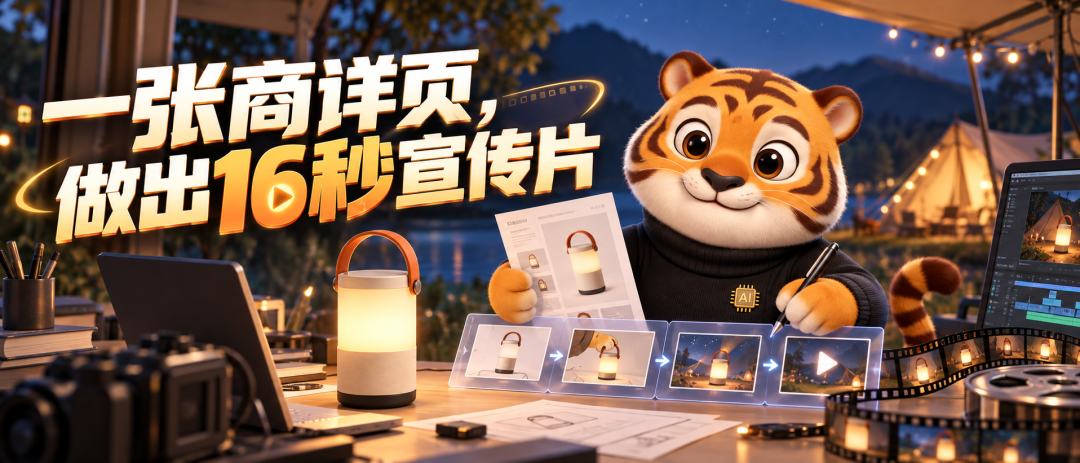
作者把一张写好商品参数与卖点的详情页交给豆包工作,再经已连接的 Flova AI 依次产出参考视觉、四镜分镜、配乐与时间线,最后导出 1920×1080、30fps 的 MP4。这条链路把原本分散的确认节点串成可检查、可修改的工作流。
9 月 8 日,Adobe 把视频与音效生成直接放进 Premiere 时间线,并让 AI Assistant 承接多步骤工作流。它释放出一个很明确的信号:AI 视频工具开始争夺的,不只是“生成一次”,而是让创作者尽量留在同一条工作流里完成作品。
Flova 给我的直观感受,正好对应这种变化。
这次我没有从一句空泛的“帮我做个视频”开始,而是把一张已经写好商品参数和卖点的详情页交给豆包工作,再通过已连接的 Flova AI,把它一路变成参考视觉、四镜分镜、声音、时间线和最终 MP4。
看完整个过程后,我最明确的判断是:Flova 值得关注的地方,不只是它能生成视频,而是它把创作中原本分散的确认节点,串成了一条可检查、可修改、也能交付的完整链路。
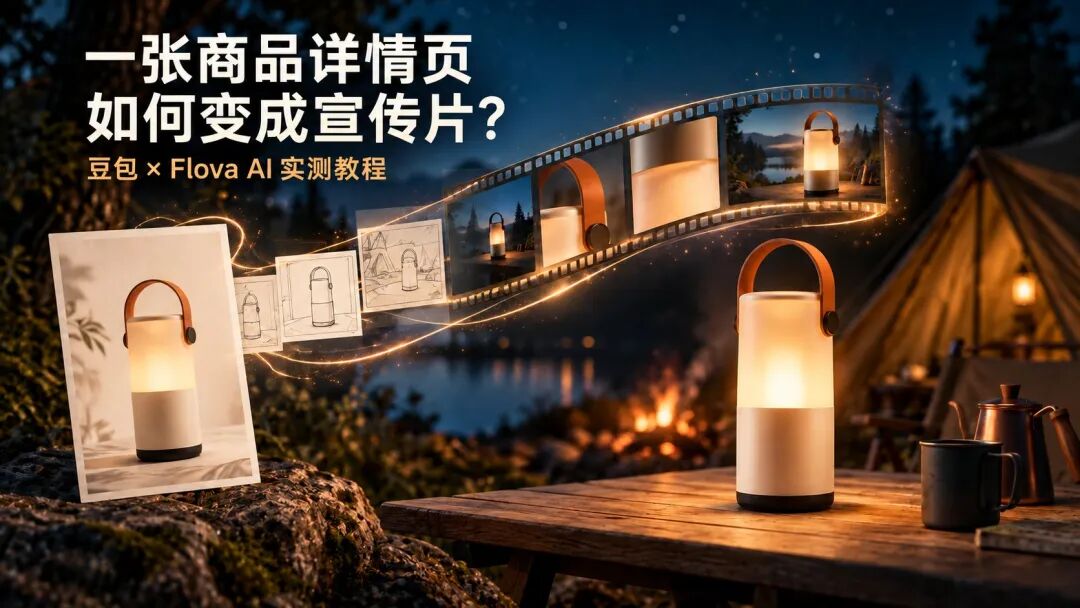
先看成片:一张详情页,最终交付了什么
这次使用的是商品“微光 L1 氛围灯”。详情页给出的核心信息很简单:暖白圆柱机身、焦橙色提手、黑色底座,以及无级调光、便携提手和长效续航三个卖点。场景被设定为温暖、写实的露营夜景。
全片由四段镜头组成:第一镜建立露营氛围,第二镜用手指调光突出无级调光,第三镜通过提起灯体表现便携,第四镜让灯在帐篷内持续亮起并拉远收尾。
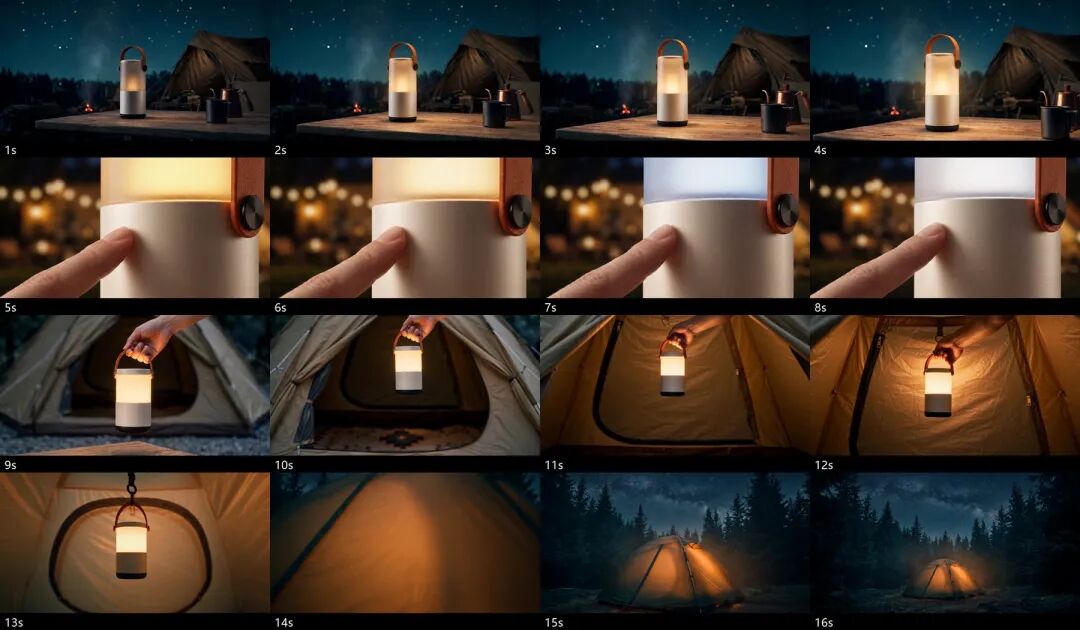
把 16 秒拆成逐秒画面后,可以清楚看到四段镜头的任务并不重复:环境、调光、提手和续航各承担一个卖点。更重要的是,暖白机身、焦橙提手、黑色底座和圆柱造型在主要镜头中保持了基本一致。
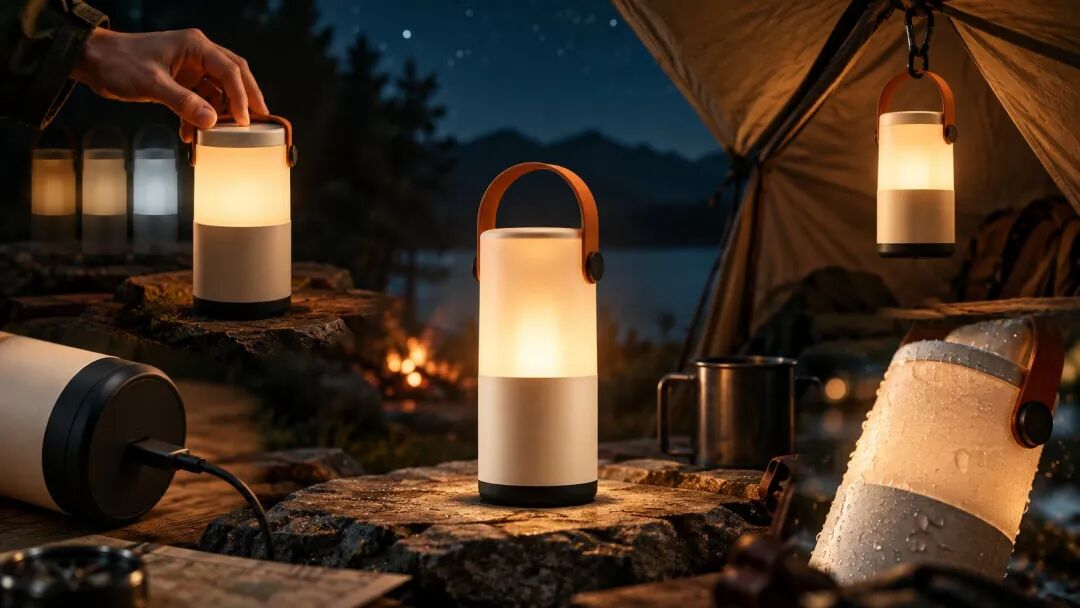
导出文件为 1920×1080、30 fps,使用 H.264 视频和 AAC 立体声音轨。完整解码顺利通过,没有检测到持续黑屏或一秒以上的静音。对一个商品短片任务来说,这才是我真正关心的“完成”:不是看到几张漂亮图,而是拿到能够正常播放的成片文件。
直接复用已经存在的商品资料
很多商品视频最消耗精力的环节,不是生成,而是搬运。商品信息已经在详情页里写过一次,换到另一个工具后,却还要重新上传图片、摘录参数、解释卖点,确认过的信息很容易在这个过程中丢失。
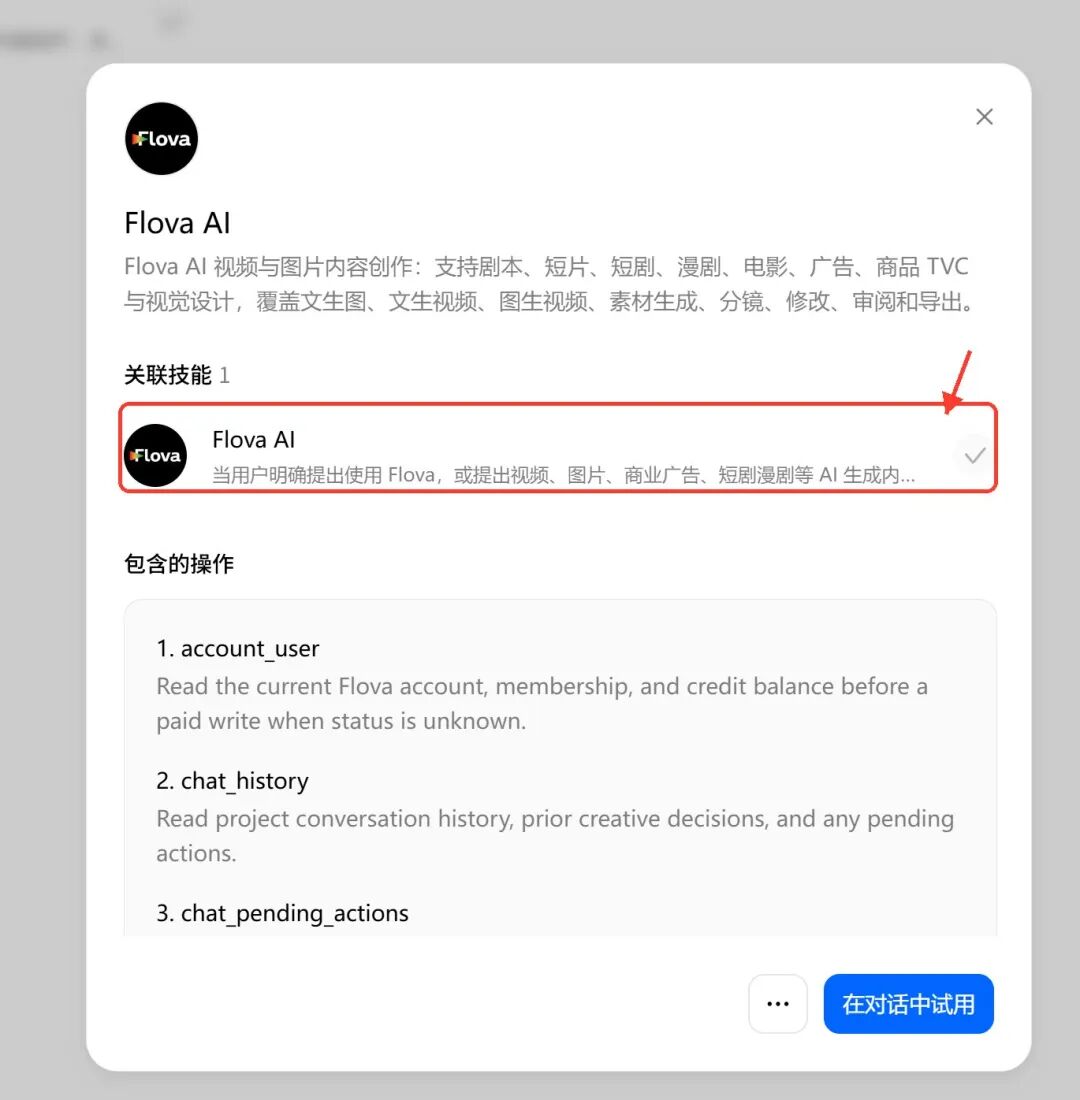
开始前,先在豆包工作的技能与连接器页面确认 Flova AI 已关联。连接状态确认后,项目、素材和后续生成才能在同一条对话链路里继续推进。
直接用一张自制详情页作为完整商品资料。页面里的商品描述直接成为视频卖点和创作依据,页面里的主商品图则成为 Flova 项目中的外观参考。
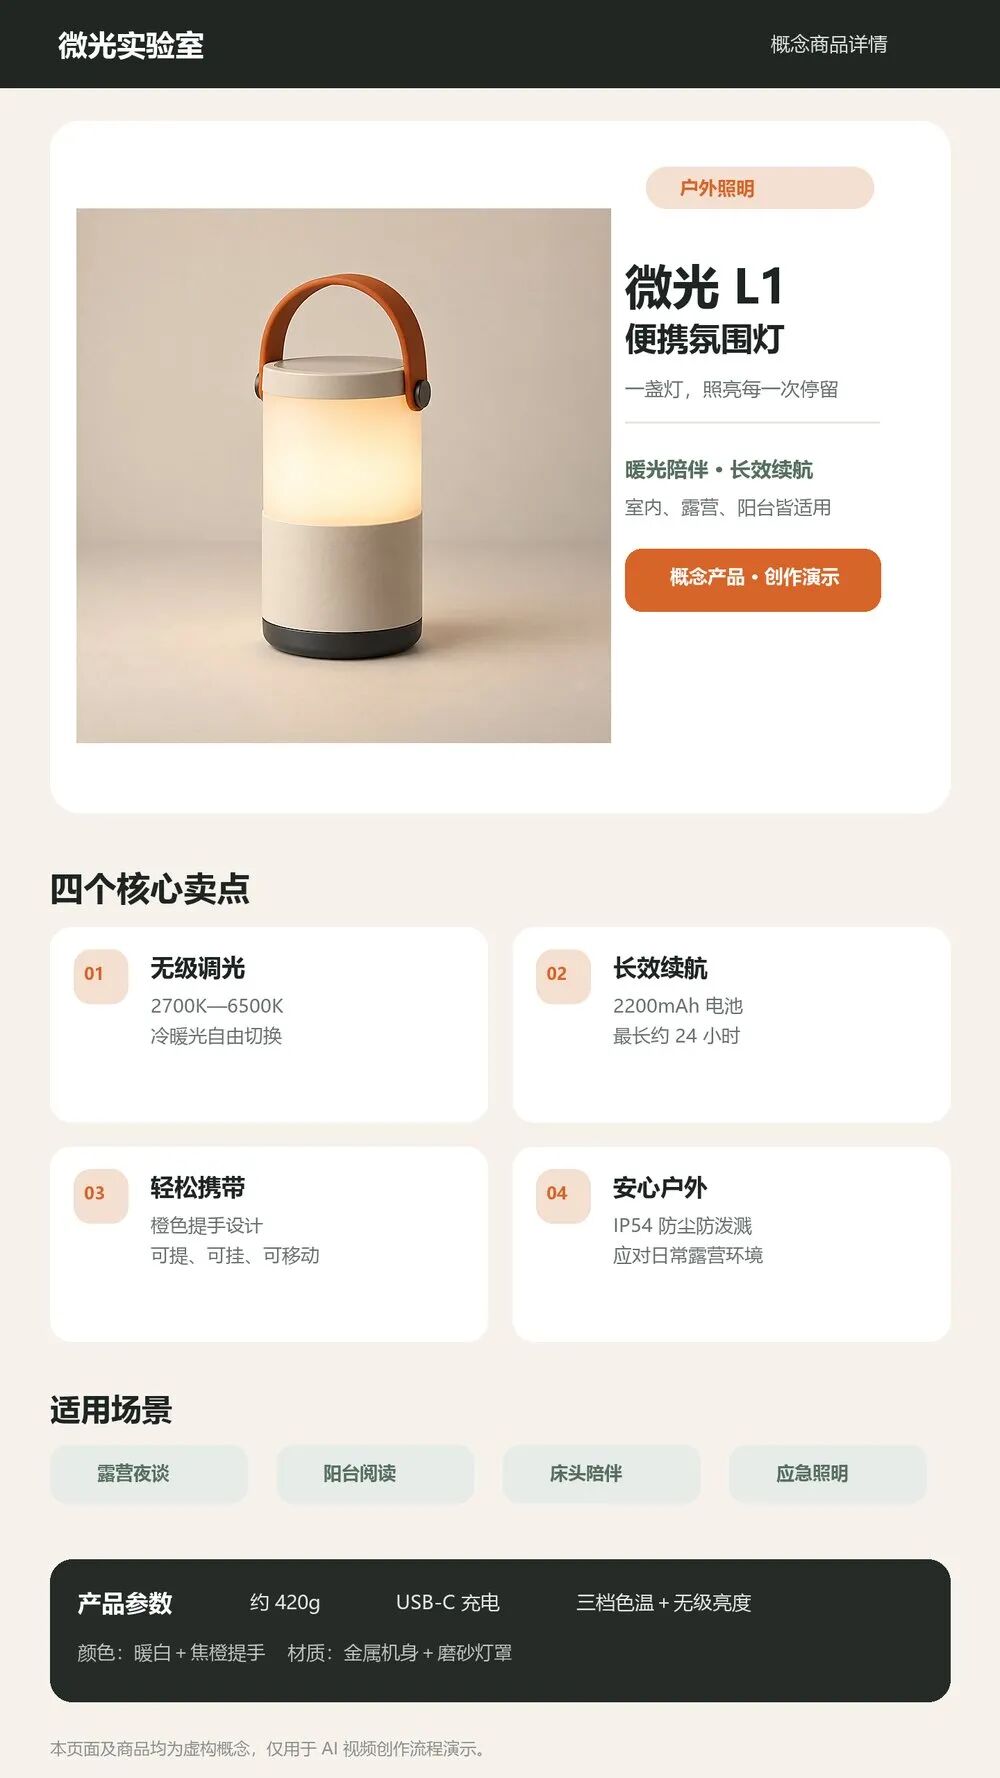
为了让整个案例可以直接复现,我把任务规格压缩成一份明确输入。
提示词
请使用已连接的 Flova AI,根据附件中的虚构商品详情页,制作一支 15 秒、横版 16:9 的商品宣传短片。先识别附件里的商品主图、参数和卖点,再推荐并自动选择合适的 Flova Skill;把附件中的主商品图作为产品参考图上传到 Flova 项目。视频采用写实电影感和温暖露营夜景,安排 3—4 个镜头,核心突出无级调光、橙色便携提手和长效续航。商品的暖白机身、焦橙提手、黑色底座和圆柱造型必须始终与参考图一致。先生成参考视觉和分镜向我展示,确认后再继续生成成片。不要人物台词,不要虚构品牌背书,可使用自然环境音和轻柔配乐。该商品为虚构概念,仅用于创作演示。
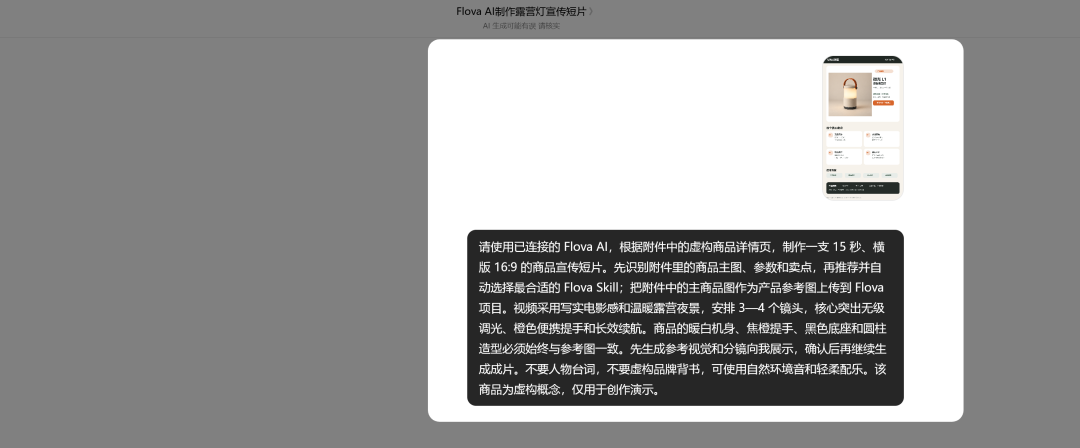
这段提示词里,我刻意没有只写审美词,而是同时锁定了成品规格、卖点、产品外观、镜头数量、确认顺序和声音要求。信息越明确,Flova 后续给出的视觉方向就越稳定;而先看参考图和分镜,再进入正式生成,也能避免在错误方向上连续消耗。
先校准视觉,再决定是否值得进入生成
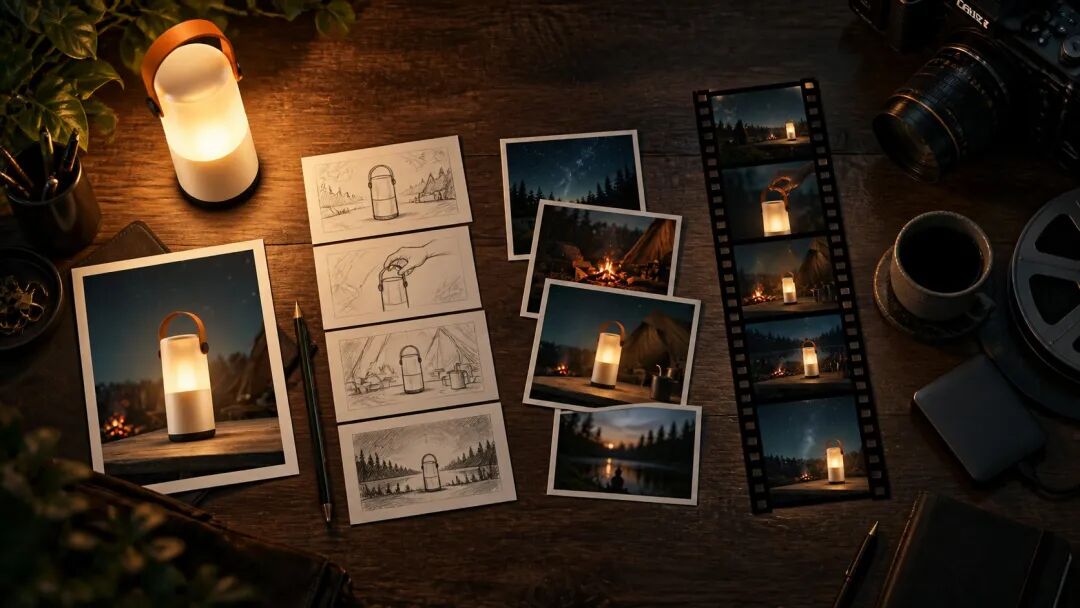
Flova 先给出了整体视觉参考和四镜方案。这个阶段最重要的不是判断“好不好看”,而是检查商品有没有在创作过程中变成另一件东西。需要检查的有四个:暖白机身、焦橙提手、黑色底座、圆柱造型。
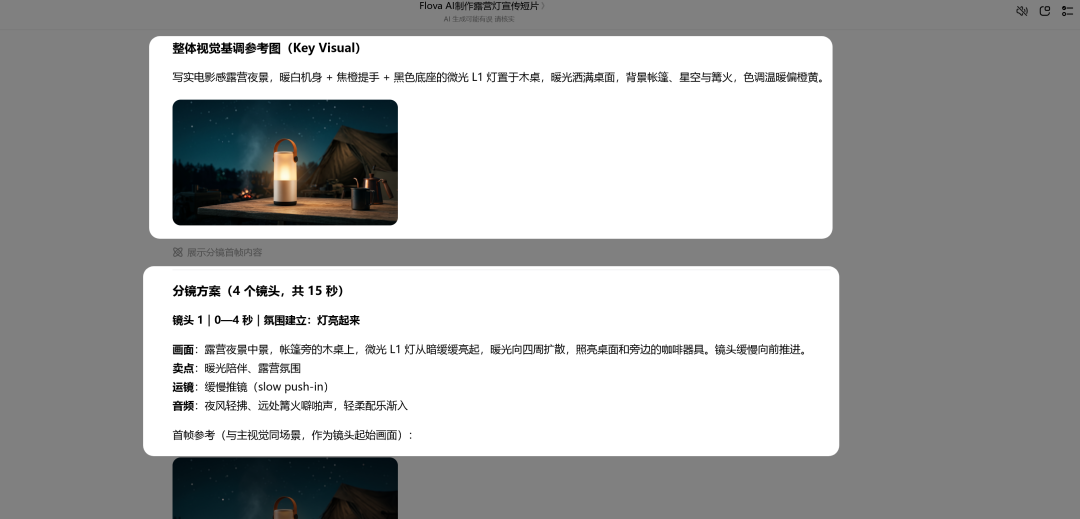
四个镜头的职责也被提前写清:0—4 秒建立露营氛围,4—8 秒表现无级调光,8—12 秒表现提手便携,12—15 秒用帐篷内持续亮灯完成续航收尾。镜头任务一旦明确,后面评估结果时就不必只靠“感觉”。
我保留了前三镜,只修改第四镜:不再拍帐篷远景,而是让微光 L1 在帐篷入口或帐篷内清晰可见,仍能辨认暖白机身、焦橙提手和黑色底座,再缓慢拉远结束。
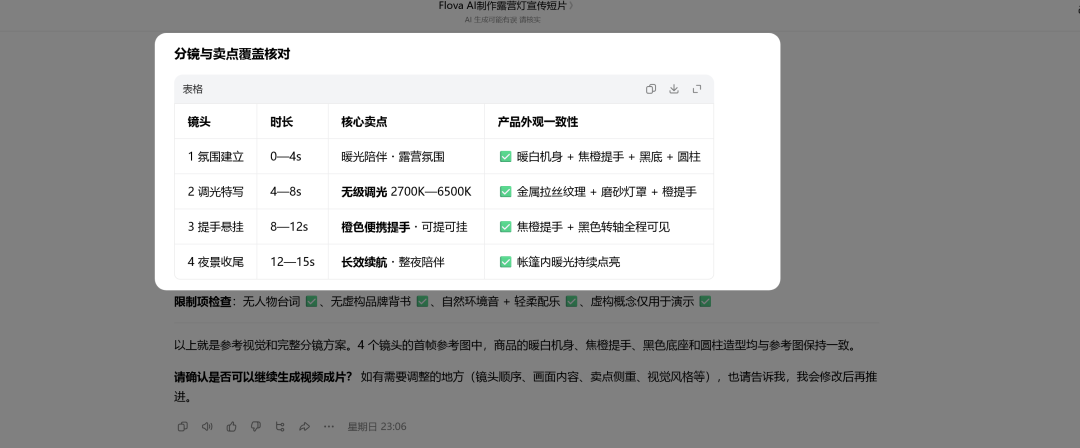
这一步让我比较满意。生成式视频最怕的是把“不满意”变成整支片子推倒重来,而 Flova 在成片之前保留了逐镜确认和修改的空间。对设计师和产品经理来说,这种控制点比单纯多生成几版更重要,因为它让反馈能够落到具体镜头,而不是一句模糊的“再高级一点”。
四段素材还不是成片,声音和时间线必须接上
分镜确认后,Flova 生成了四段视频镜头,每段约 4 秒。随后又生成轻柔配乐,以及篝火、夜风和虫鸣等环境音,并把它们与四段镜头放进同一条时间线。
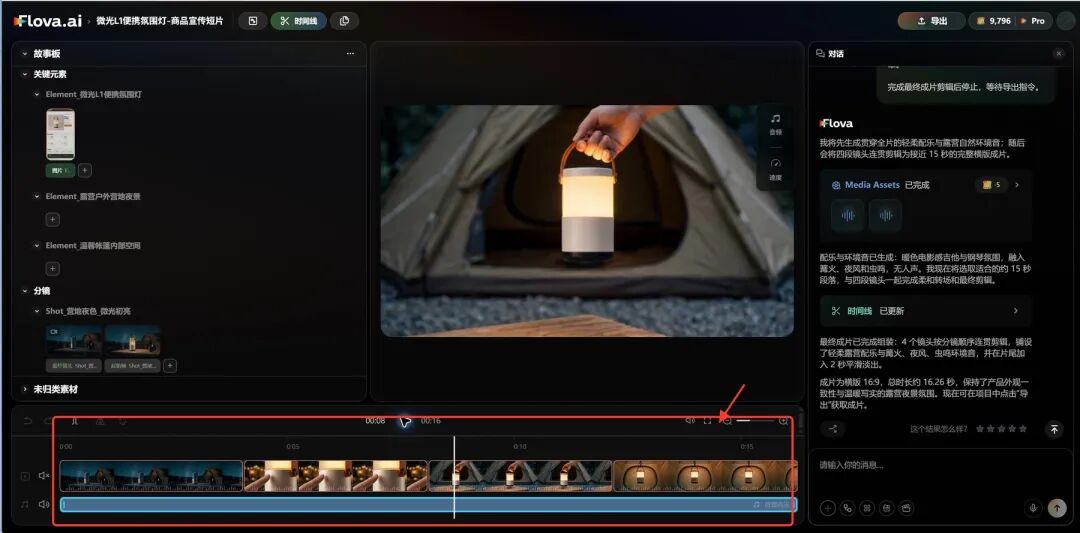
播放时时间线游标会从第一镜经过调光特写、提手移动,再进入帐篷内收尾。素材、声音和时间线集中在一个工作区,少了在多个工具之间导出、命名、重新导入和对齐的来回操作。
生成结束后,从项目右上角打开导出菜单,选择视频导出,再对本地 MP4 做时长、分辨率、比例、音频和完整播放检查。
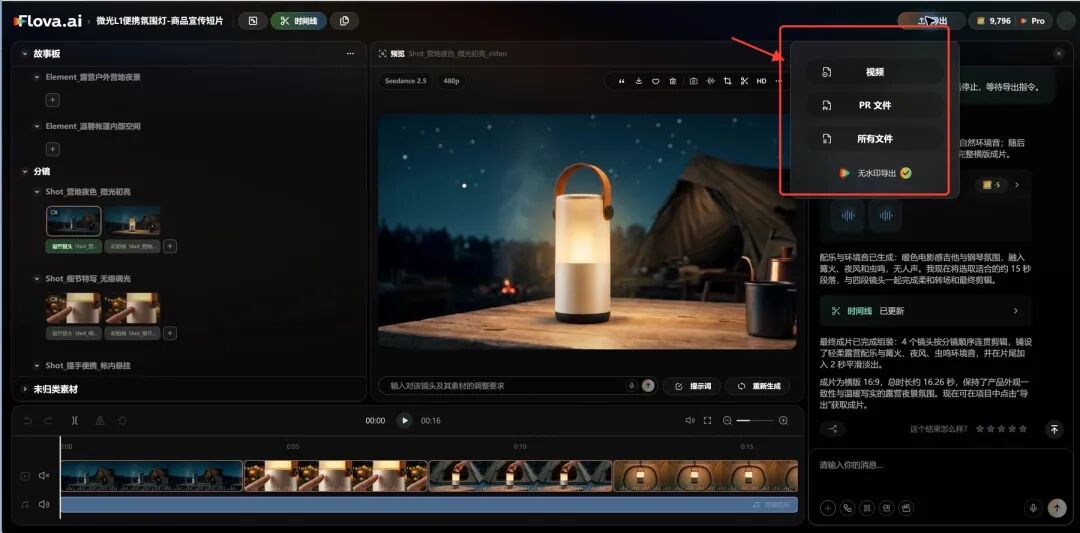
如果节奏不理想,优先调整各镜时长和镜头顺序;如果声音抢画面,单独降低配乐或替换环境音;如果只有某一镜外观失真,就回到该镜的参考图和提示词修正。把问题定位到具体环节,远比重新生成整支视频更可控。
我为什么更愿意把 Flova 看成工作流而不是模型
落到个人使用层面,最大的变化是注意力不用反复重启。商品信息只需要整理清楚一次,后面每个阶段都围绕同一组资料推进;参考图、分镜、镜头、声音和导出又分别留有检查点。速度固然重要,但“我知道现在该检查什么、出错后该回到哪里”更容易建立持续使用的信心。
再往团队协作看,输入资料、视觉方向、分镜决策和最终输出都留在同一个项目脉络里。负责产品的人可以确认卖点,负责设计的人可以检查外观和氛围,负责内容的人可以判断节奏与声音。交接不再只剩一句“成片看着不对”,而是能够指向具体镜头和具体阶段。
从产品形态看,AI 视频工具的竞争也在发生变化:单个模型回答的是“这一段能不能生成”,完整工作流回答的是“一个真实任务能不能从输入走到交付”。Flova 这次让我看到的,正是后者——它不只提供镜头,而是在豆包工作的入口之上,把商品资料、参考资产、分镜修改、视频、声音、时间线和导出串成闭环。
如果你正在做电商内容、产品视觉、品牌短片或 AI 创作,我建议第一次不要给自己安排太复杂的任务。选一张主图清楚、卖点明确的商品详情页,写清 15 秒、16:9、三个卖点和一种场景风格,先让 Flova 生成参考视觉与分镜。
确认产品没有跑样、每个镜头都有独立任务后,再继续生成视频和声音。这样最容易看清 Flova 真正替你承担了哪些工作,也最容易判断这条工作流是否适合自己的内容生产。
在豆包工作的技能与连接器页面关联 Flova AI 后,就可以从这一张详情页开始。
本文由人人都是产品经理作者【AI高手杜小虎】,微信公众号:【AI高手杜小虎】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供


- 目前还没评论,等你发挥!