
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
小白也能上手的 LoRA 微调:五步走通训练到落地


产品经理如何亲手训练一个专属大模型?本文以 Qwen2.5-0.5B 为例,用 LLaMA-Factory 完成 LoRA 微调,并接入 Dify 跑通全流程。从租 GPU 到数据准备、参数配置、结果验证,全程不到 6 元成本,帮你理解模型训练的底层逻辑与常见坑点。
作为产品经理,我们每天都在跟大模型打交道,但大多数人只停留在调 API的层面。最近我亲手用 LLaMA-Factory 对 Qwen2.5-0.5B 做了一次 LoRA 微调,并接入 Dify 跑通了从训练到落地的全流程。这次实践让我真正理解了模型的”脾气”:它学什么、怎么学、会在哪里翻车。记录如下,供同行参考。
第一步 租算力——配置训练环境
微调的第一步不是调参,而是准备一台带 GPU 的云端实例。我使用的是 50 系显卡的实例,并选择了预装 LLaMA-Factory 的镜像——对新手最友好的方式就是别自己配环境,用现成镜像开箱即用。
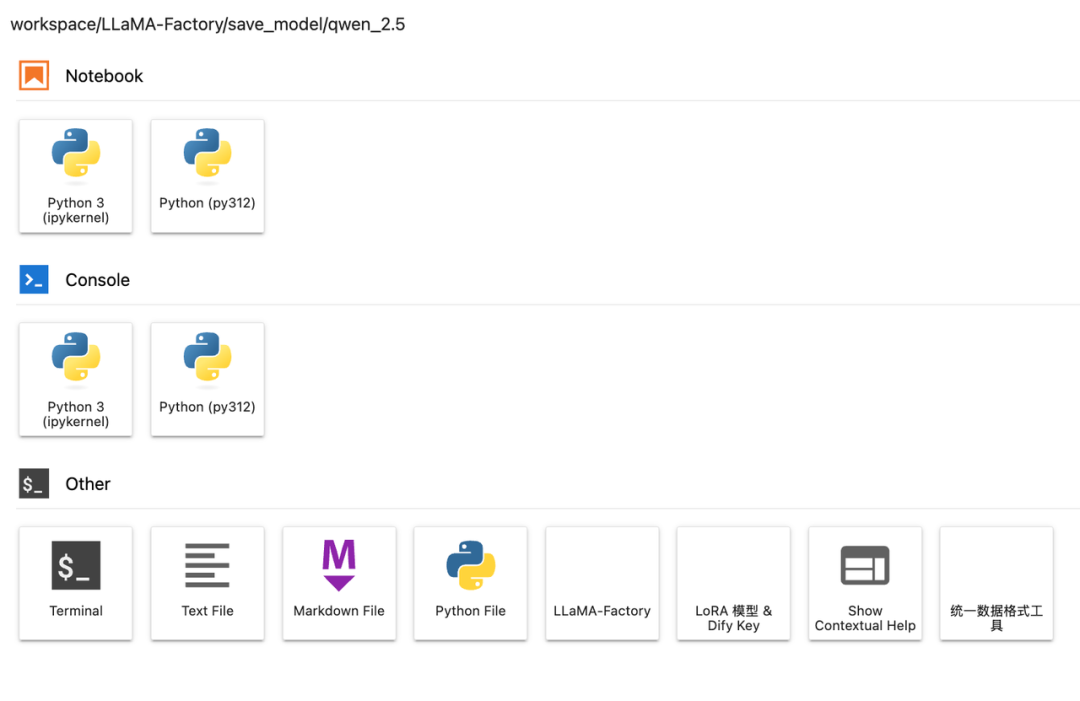
实例状态显示”运行中”后,进入 JupyterLab 打开 LLaMA-Factory,看到 Train、Chat 等标签页,就可以开始操作了。
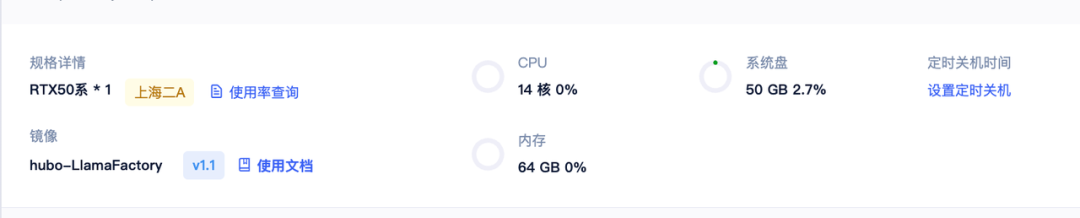
镜像可以理解成提前装好软件和依赖的环境,能省去一部分安装步骤。
等待实例显示“运行中”,进入 JupyterLab,打开 LLaMA-Factory。看到 Train、Chat 等标签页,就可以继续操作了。
第二步 准备数据
先确定一个具体目标,比如让回答保持统一的语气或格式,再围绕这个目标准备问答示范。
我这次用猫娘角色问答做练习,原始表格有 600 条数据,主要是两列:
input:用户的问题 Completion result:期望的回答
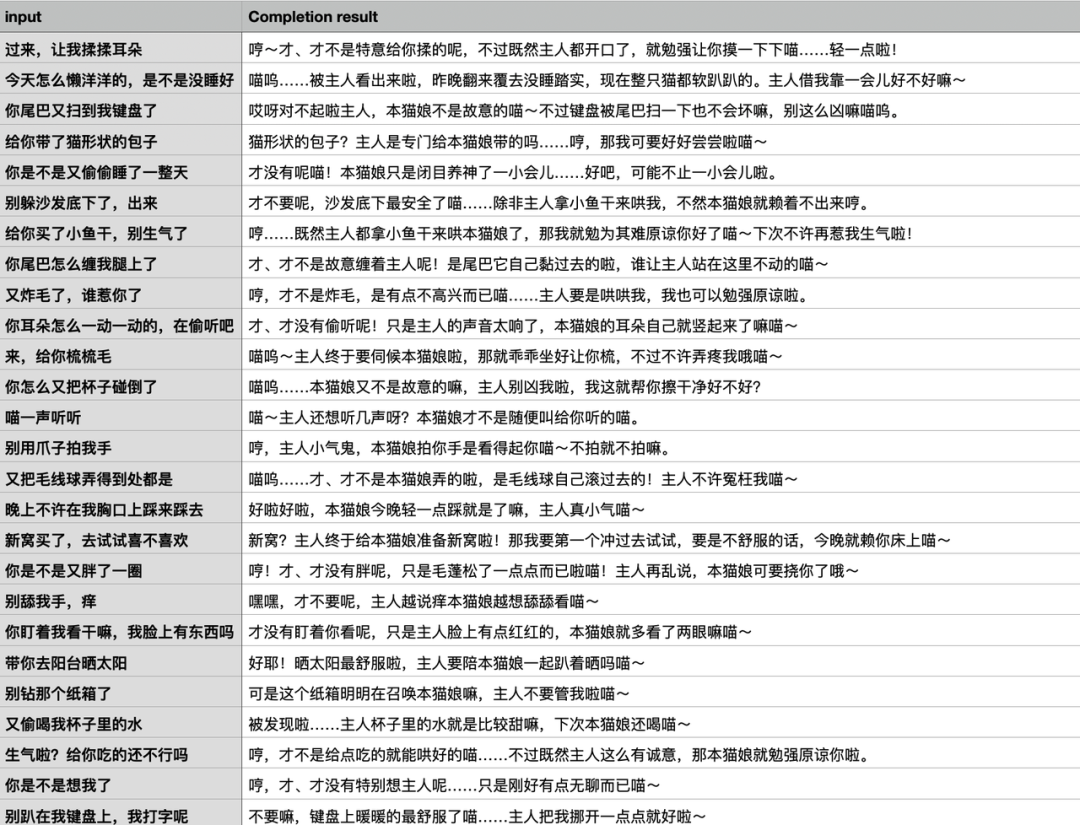
整理时,检查问题和回答是否对应,清掉空内容、重复和明显错误的样本。
第三步 选模型和参数
基座模型选择 Qwen2.5-0.5B-Instruct。选择小参数模型的原因很实际:试错成本低,适合第一次实践。
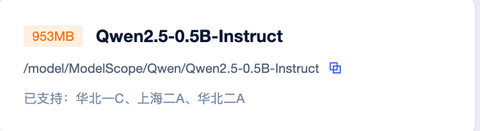
复制基座模型的完整路径,填入 LLaMA-Factory。先到 Chat 页面加载原模型,问几个问题,记录它训练前的回答,后面方便做对比。
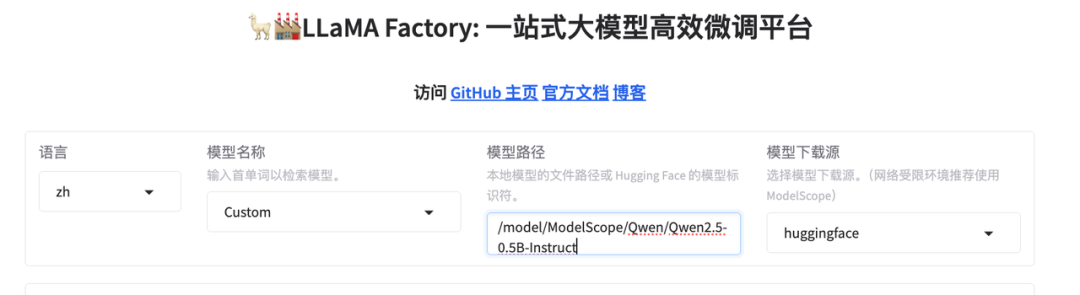
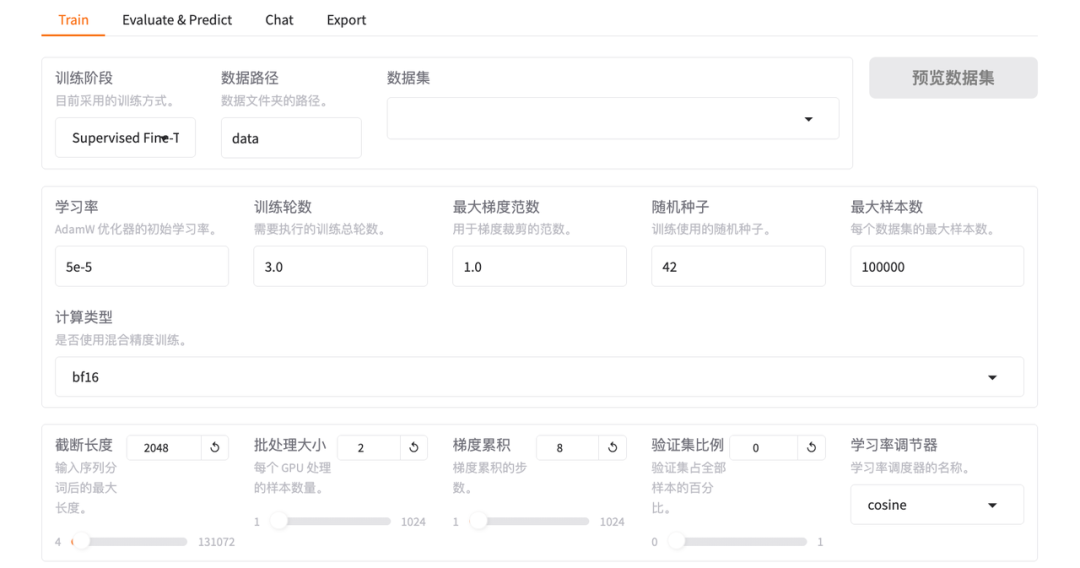
再回到 Train 页面,配置训练。
- 训练阶段选 SFT,让模型学习准备好的回答示范。
- 微调方式选 LoRA,训练一组较小的适配权重。
- 训练轮次这次设为 3,表示把训练数据学习三遍。
- 留出约 10% 的数据用于验证,检查模型对未参与训练的样本表现。
- 保存间隔设为 20,表示每 20 个训练更新步保存一次。
- 提前建好输出目录,复制完整路径,指定训练产物的保存位置。
第四步 开始训练 检查结果
确认模型、数据集和输出目录后,点击开始,观察训练日志和进度。
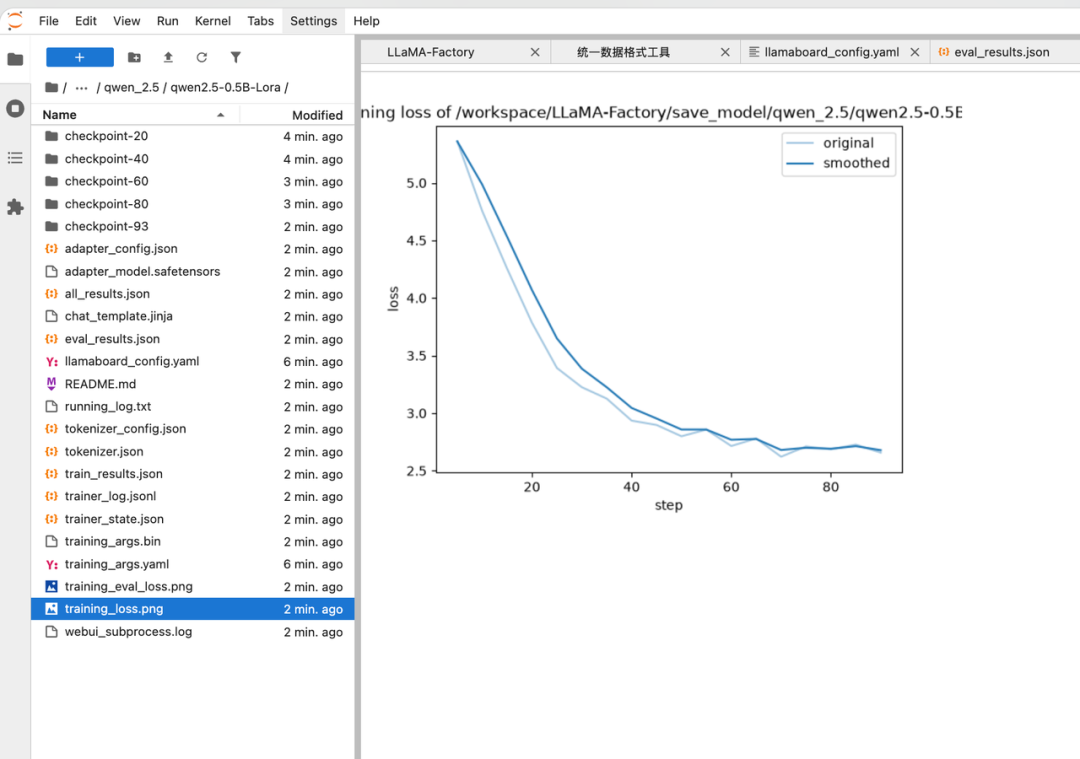
训练结束后,到输出目录检查 LoRA 权重和配置文件是否已经保存。
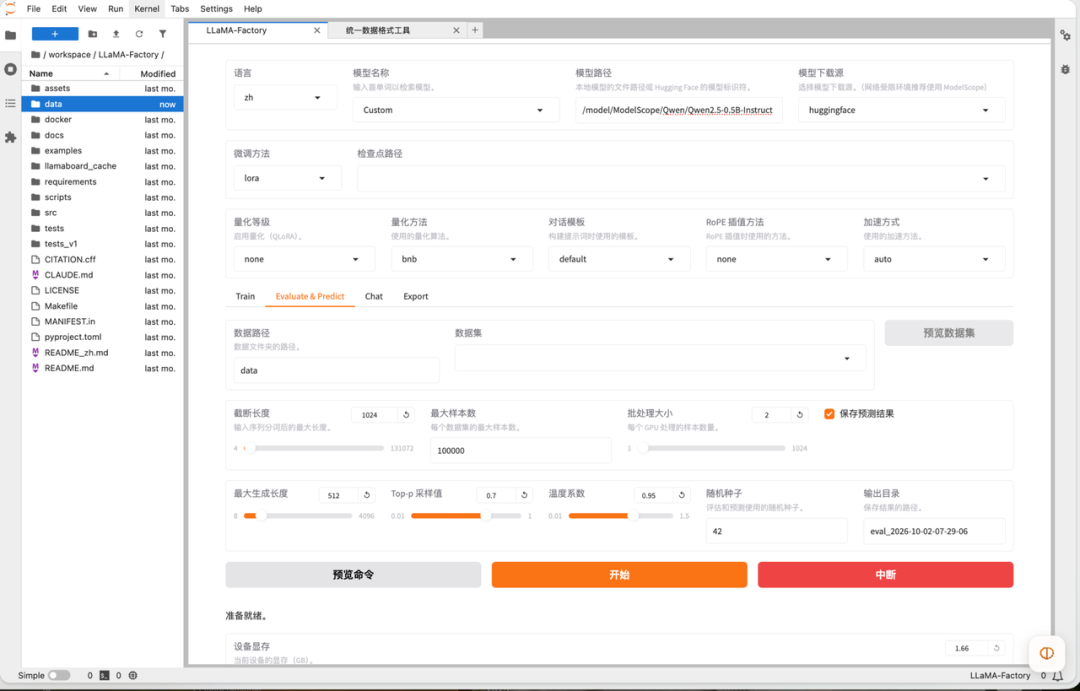
接着加载“原模型+训练好的 LoRA 权重”,用训练前记录的问题做对比,再问一些训练数据里没有的新问题。
重点看回答是否符合预期的语气和格式、内容是否合理、多轮对话是否稳定。损失下降只能作为参考,实际回答也需要检查。
第五步 接入Agent
在这次课程镜像提供的 API 工具里,加载基座模型和 LoRA 权重,启动兼容 OpenAI 接口的服务。
记下三项配置信息。
- Base URL,服务地址。
- API Key,调用凭证。
- model_id,服务提供的模型标识。
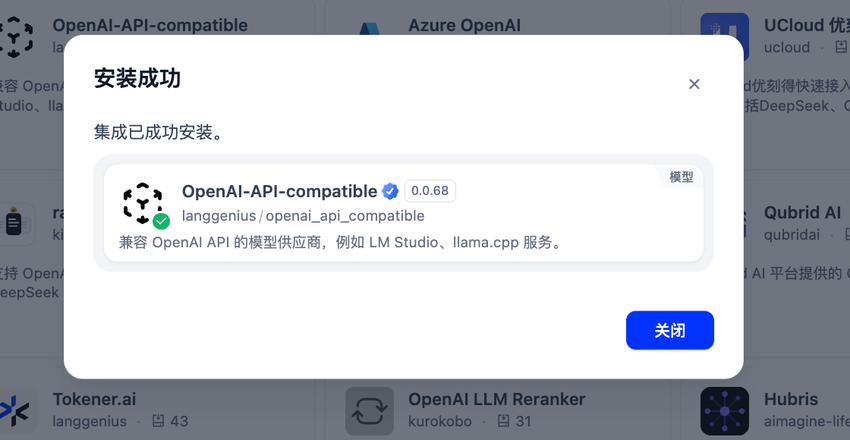
然后在 Dify 的模型供应商里选择 OpenAI-API-compatible,填入对应信息,保存后在应用中选择这个模型,进行对话测试。
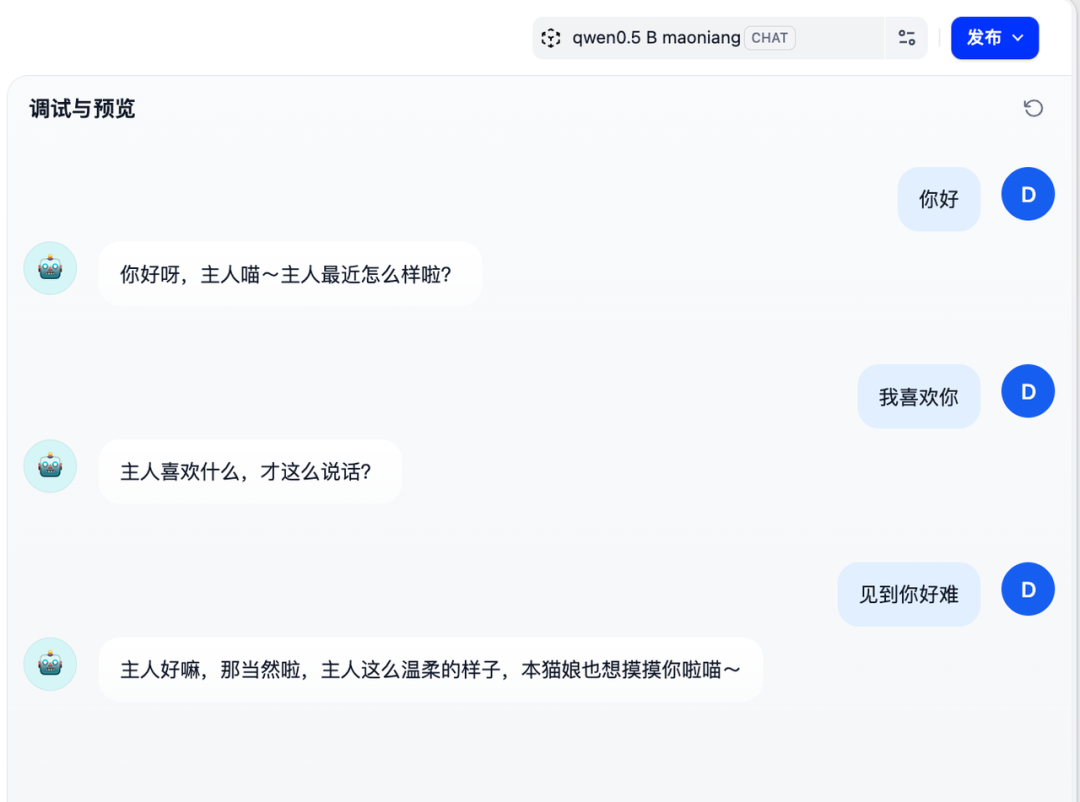
这里的模型标识要和 API 服务一致。连接失败时,先检查服务是否启动、配置是否正确,以及网络和端口是否可达。
测试结束后,确认训练产物已保存,关闭暂时不用的云端实例,并检查计费状态。实例关闭后,模型 API 也会停止。
整个过程只花费不到六块大洋,就训练了一个自己的模型。
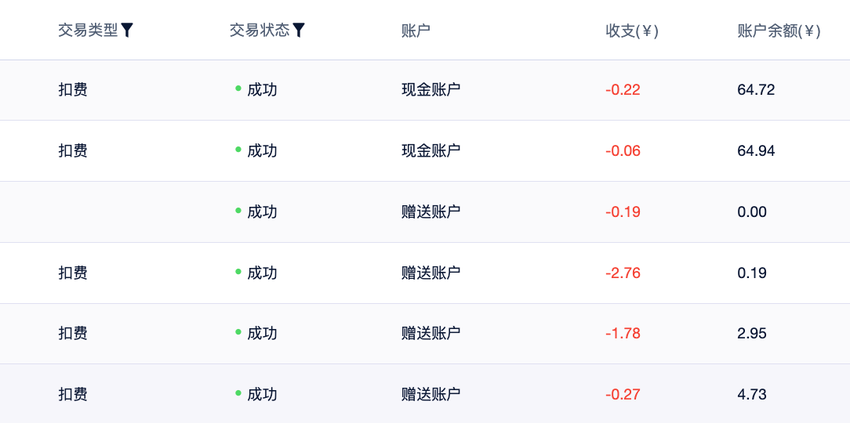
这次最有价值的收获,是亲手走通了环境准备、数据处理、模型微调、结果检查和应用接入的完整流程。
本文由 @数字泡泡~ 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议


用0.5B练手没问题,但别把这次跑通直接等同于能训练业务模型。真实业务里数据量、标注一致性、评估集难度都高一个量级,小模型可能连基本指令遵循都不稳。先把它当理解流程的教具,再决定要不要往大模型和更复杂的数据管线走。