起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
刚刚,程序员通宵找Bug的历史要结束了,Claude只用几周,把整个软件测试行业改写了


Anthropic 把 Claude 推到传统测试够不到的底层:先把开源软件编译到 RISC-V 汇编层,再生成可由 Rocq 检查器验证的形式化证明,涉及 123 个开源软件、239 个程序入口,证明代码超过 1.8 亿行。
软件测试一直在和一个无法回避的事实较量:测试用例只能覆盖有限路径,模糊测试只能不断尝试输入,人工审查也不可能穷尽所有状态。即便代码已经被大规模集群轰炸过,仍可能存在只有特定输入、特定内存状态和特定调用顺序才会触发的漏洞。
Anthropic 最近披露的一项形式化验证研究,把 Claude 用到了传统测试更难覆盖的底层:将开源软件编译到 RISC-V 汇编层,再生成可由 Rocq 检查器验证的形式化证明。研究描述涉及 123 个主流开源软件和 239 个程序入口,生成的证明代码超过 1.8 亿行。
这不是“AI 说代码安全,所以代码安全”。真正有价值的部分是把模型生成的推理交给独立的数学检查器验证;真正需要谨慎的部分是,证明永远只对明确的模型、前置条件和属性负责。
暴力测试为什么总会漏掉路径
人工测试、随机测试和模糊测试的基本流程都类似:准备输入,执行程序,观察崩溃、超时、异常输出或资源消耗,再根据结果生成下一批输入。
这种方法非常实用,但它属于“探索实际跑到的路径”。输入空间、状态组合和时序一旦扩大,测试预算就不可能覆盖全部可能性。
研究中给出的例子很典型:某个解压模块的越界写入,需要接近 20MB 的文件,并且内部包含一种非常特殊的排布;某个图像解码器的越界读取,则需要约 64MB 的畸形文件和超过 2GB 的实时内存消耗。测试工具默认只发送 1MB 以内输入时,这些漏洞自然很难被碰到。
形式化验证采取的是不同路线:不是问“我试过的输入有没有触发问题”,而是问“在给定前提下,是否存在任何一条路径违反属性”。这会把测试从经验抽样推进到对程序性质的证明。
Claude 怎样把代码变成可检查的证明
研究中描述的链路可以概括为:
开源代码
-> 编译为底层 RISC-V 汇编
-> Claude 生成形式化证明
-> Rocq 等独立证明检查器验证
-> 通过则接受,不通过则返回修改
模型负责生成复杂的证明候选,检查器负责判断证明是否符合形式化规则。人类不需要逐行阅读 1.8 亿行证明代码,但需要确认验证模型、前置条件、编译过程和证明属性本身是可信的。
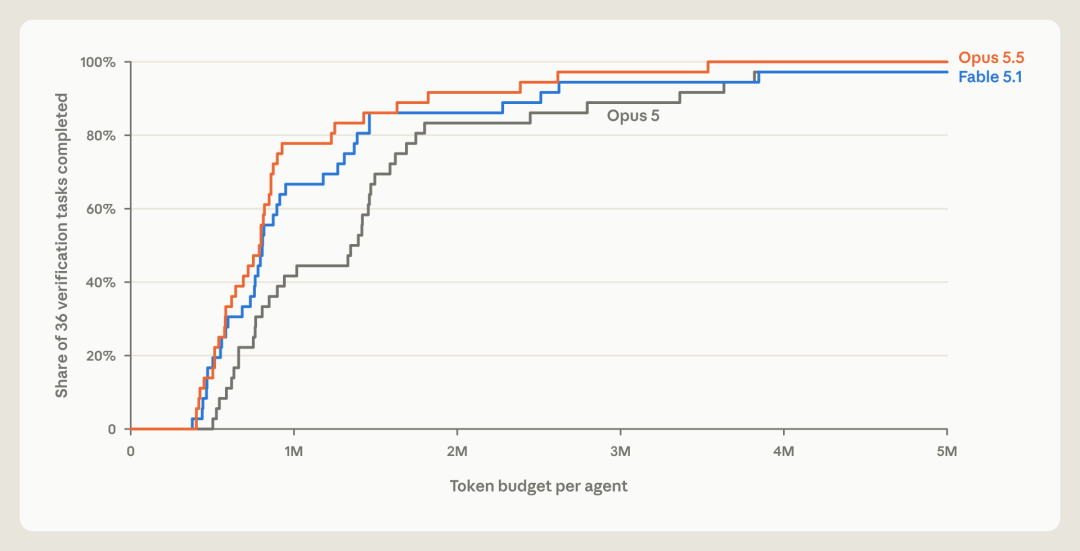
这正是形式化方法和普通大模型生成的区别。模型可能写出错误的证明,但独立检查器不会因为文本看起来合理就放行;它只接受满足形式规则的证明项。
“无需人工逐行复核”不等于“无需人工负责”
形式化证明可以把大量机械检查交给机器,但人类的责任并没有消失,只是从逐行检查转移到了边界设计:
- 证明覆盖的是哪些函数、输入范围和状态?
- 编译器、汇编语义、硬件模型是否与真实部署一致?
- 是否把某些危险行为排除在前置条件之外?
- 调用者传入违规参数时,证明是否仍然成立?
- 死代码、未建模的外部系统和硬件异常是否会绕过结论?
如果一个证明只说明“小于 64MB 的输入不会导致某类内存错误”,它并不自动说明大于 64MB 的输入也安全;如果证明依赖调用者始终满足某个约束,那么调用者违反约束时,证明不会替你兜底。
机器码级验证的几个案例
在 cpp-httplib 的验证中,研究人员用机器码推理析构函数递归是否会耗尽系统栈,并进一步检查底层数据结构的行为。
Linux 内核的 zlib 压缩模块则涉及 x86 汇编和 RFC 1950 规范。研究流程尝试建立 x86 指令集的形式化定义,单步执行内核并启动 Ubuntu,再对实现和规范之间的关系进行检查。
另一个实验用 Rust 实现 Python 解释器,并用 Verus 工具验证其与 CPython 规范的符合程度;随后使用 170 多万个随机生成的 Python 程序进行行为对照,报告的一致度达到 99.95%。
这些案例体现了两种互补方式:形式化证明负责验证特定性质,随机程序负责发现实现与参考规范之间的行为差异。两者都需要明确的规范和可靠的检查器,不能只把模型生成的代码当作最终证据。
传统软件测试不会消失,而是职责发生变化
形式化验证擅长证明定义明确的属性,例如内存安全、算术关系、状态不变量和某种协议约束;模糊测试擅长在复杂真实环境中寻找意外行为;集成测试负责确认组件组合后的系统行为;人工测试则负责体验、业务规则和未形式化的产品要求。
可以把它们组合成一条流水线:
| 层次 | 主要问题 | 适合的方法 |
|---|---|---|
| 规范 | 什么必须成立 | 形式化规格与不变量 |
| 底层实现 | 是否违反内存、算术或状态属性 | 形式化证明与证明检查 |
| 组件边界 | 输入输出组合是否正确 | 单元测试、属性测试 |
| 真实环境 | 随机、异常和资源压力下是否稳定 | 模糊测试、压力测试 |
| 产品行为 | 是否符合业务和用户预期 | 集成测试、人工验收 |
形式化方法不是把测试删掉,而是让测试不必承担它无法承担的全部证明责任。
为什么证明系统能降低大模型幻觉风险
“模型写出的代码可能是错的”是大模型工程的核心问题之一。形式化验证并没有让模型突然不犯错,而是把错误暴露在一个更严格的反馈回路中:模型提出证明,检查器判定;失败就修正,成功才进入下一步。
这类似编译器和类型系统对代码生成的约束,只是检查范围更深入。模型负责搜索,形式系统负责验收。只要检查器实现正确,模型无法靠语言表达、上下文暗示或看似合理的解释绕过失败。
但“检查器亮绿灯”仍然要结合模型边界理解。数学验证不负责证明规格本身正确,也不负责覆盖未建模硬件扰动、外部资源、调用者违规参数和死代码。安全结论必须注明适用范围、假设和未覆盖部分。
证明复用,可能改变底层软件的成本结构
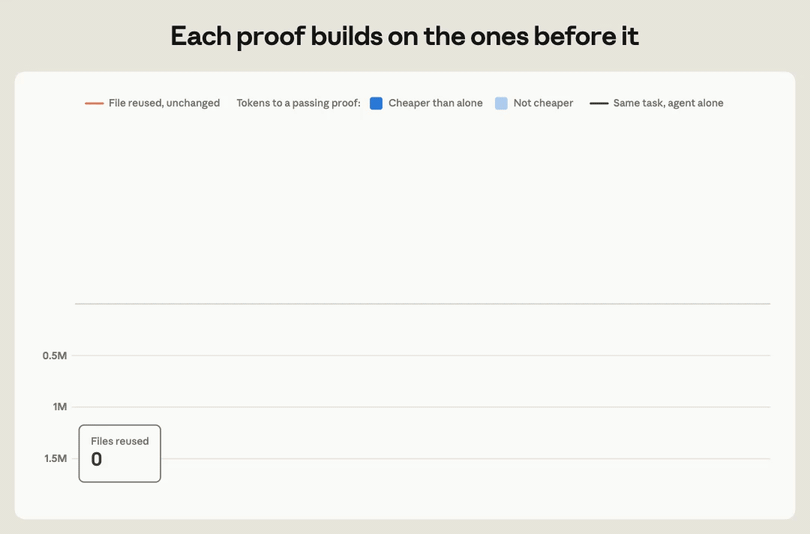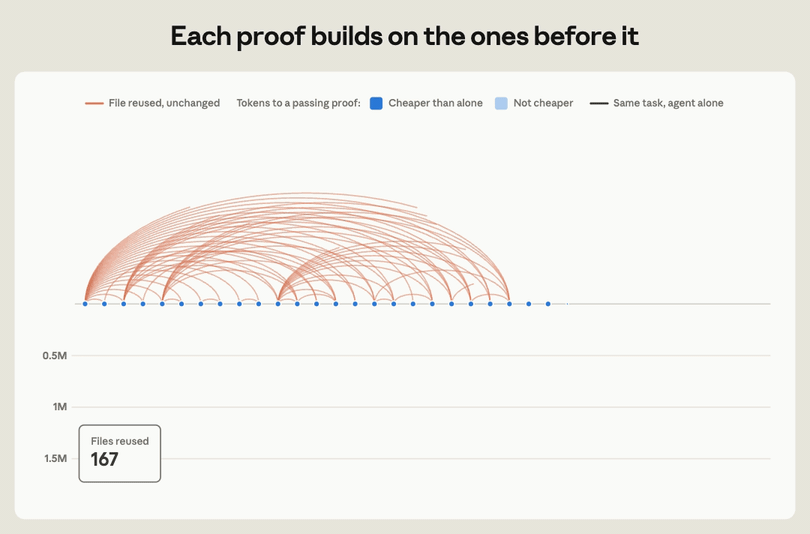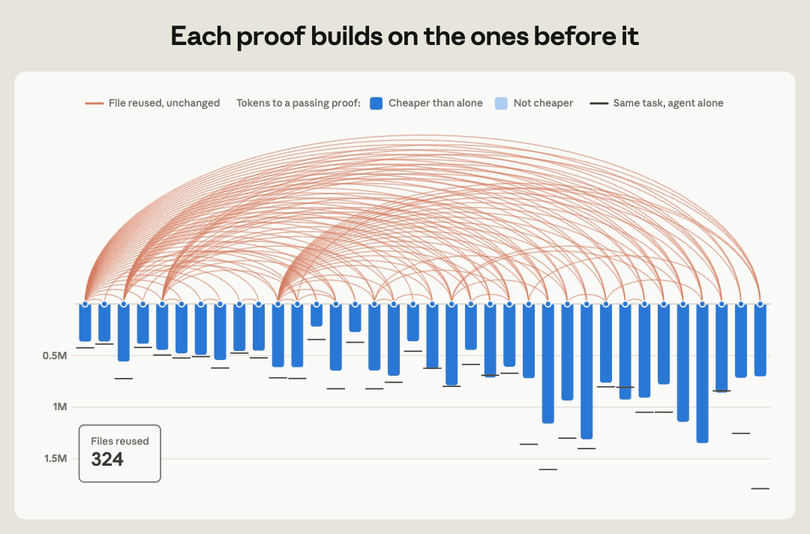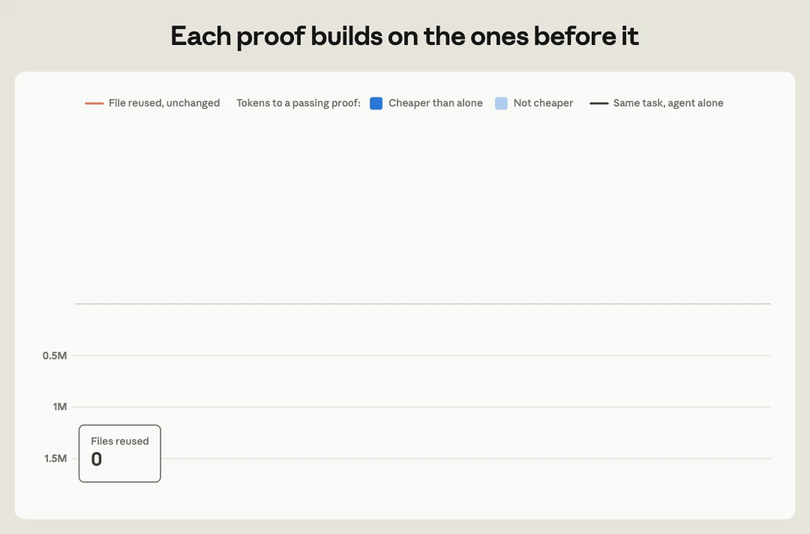
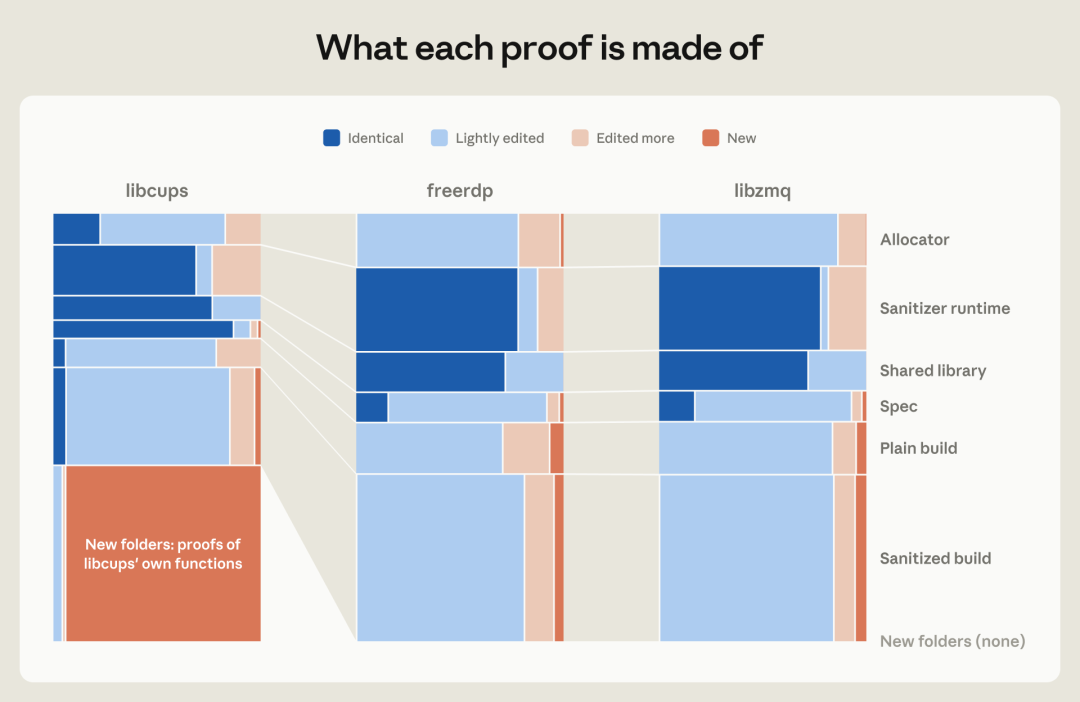
形式化证明最昂贵的部分,往往是为通用底层模块建立完整模型。一旦 C 运行时初始化、内存分配、消毒器逻辑或某个基础库被证明,并且证明可以在新项目中复用,后续任务就不必从零开始。
研究描述了一个递归收益:Agent 把已经完成的证明和逻辑积木放进共享工作区,后续任务直接复用。通用模块几乎不需要重复生成证明,任务成本因此进一步下降。
这和 Lean 等数学库的积累逻辑相似:基础定理越丰富,后续证明越容易组合。但软件世界的复用必须格外关注版本、编译选项、平台差异和前置条件。证明可以复用,不代表换一个编译器、硬件或配置后仍然自动成立。
AI 编程时代,测试团队的工作会怎样变化
未来测试工程师可能减少一部分重复用例编写,但会增加以下职责:
- 将业务要求转化为可验证属性和明确前置条件;
- 维护形式化模型、证明检查器和编译链;
- 设计模糊测试与形式化验证的交叉覆盖;
- 审核模型没有覆盖的边界,包括外部系统和调用者行为;
- 建立证据链,确保每个安全结论能回到证明、日志和测试产物。
开发者若要在自己的项目中引入类似工作流,可以先从高价值、边界明确的模块开始:解析器、序列化组件、内存安全关键路径、权限判断和加密协议。不要一开始就试图证明整个业务系统,先建立可复现的规格、检查器和失败反馈闭环。
国内团队如果需要把 Claude Code 等 AI 编程工具接入兼容 API,可通过 Code80 配置 endpoint;形式化证明、测试结果和发布审批仍应保存在自己的工程体系中。
常见问题
形式化验证是否意味着代码绝对安全?
不意味着。它只能证明明确模型、输入范围和属性下的结论。硬件异常、外部系统、未建模状态、调用者误用和错误规格仍可能造成风险。
形式化证明能替代模糊测试吗?
不能。形式化证明和模糊测试解决的问题不同。前者验证定义明确的性质,后者探索真实运行环境中的意外行为,二者应组合使用。
为什么还需要人类专家?
专家需要定义规格和前置条件、确认模型边界、审核证明链与部署环境是否一致,并判断业务要求是否已经被形式化表达。
1.8 亿行证明代码需要人工逐行阅读吗?
通常不需要逐行阅读。独立证明检查器负责验证形式正确性,但人类仍要审查证明的目标、假设、工具链、版本和覆盖范围。
如何从一个项目开始实践?
选择一个边界清晰、错误代价高的底层模块,先定义属性和输入范围,再让模型生成证明候选,交给独立检查器验证,并把失败案例纳入后续评测。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自作者提供

- 目前还没评论,等你发挥!