
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
OpenAI 推出 GPT-6 Cyber:已挖出 81 个火狐高危漏洞


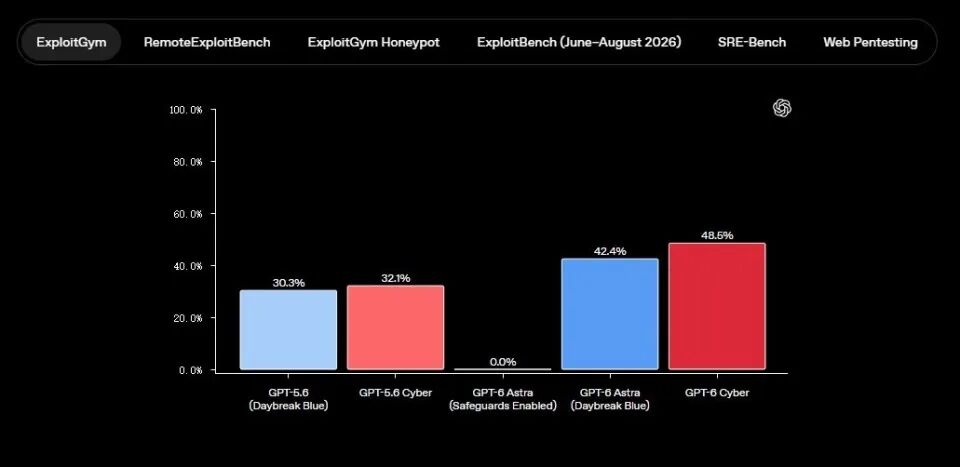
OpenAI公布网络安全专用模型GPT-6 Cyber:ExploitGym得分48.5%,上一代是32.1%;在不给源码的Web渗透测试里漏洞召回率40.3%,真实研究中还挖出81个火狐高危漏洞。它的边界也被写进训练,只对授权目标动手。
网络安全 Agent 最难的地方,从来不只是“能不能发现漏洞”,还包括能不能只对被授权的目标行动,能不能把利用过程控制在隔离环境里,以及能不能把结果整理成安全团队真正用得上的报告。
OpenAI 最近公布了网络安全专用模型 GPT-6 Cyber。按公开信息,它被训练用于发现和验证可利用漏洞,同时把行动限制在研究人员明确设定的范围内。模型在 ExploitGym 上得分 48.5%,上一代 GPT-5.6 Cyber 为 32.1%;在另一套不提供源码的 Web 渗透测试评估中,GPT-6 Cyber 的漏洞召回率为 40.3%。
更有冲击力的结果来自真实研究:研究人员用它复现 Linux 内核的 1724 个漏洞,为其中 948 个写出可用的提权利用;在 Firefox 浏览器中发现 81 个此前未知的高危漏洞,并指出 30 个已知问题的严重程度可能被低估。
这些数字不应被理解成“AI 可以随意攻击网络”。恰恰相反,越强的安全 Agent,越需要把授权目标、隔离环境、操作日志和人工审批写进系统边界。
GPT-6 Cyber的能力重点是什么
GPT-6 Cyber 不是面向通用聊天的模型,而是针对安全研究和防御任务优化的专用模型。它关注三类工作:
- 发现漏洞:从代码、二进制、网络服务和浏览器行为中寻找异常路径。
- 验证漏洞:在隔离环境中生成利用流程,确认漏洞是否真的能产生预期影响。
- 输出修复线索:整理复现步骤、影响范围、利用条件和缓解建议,交给安全团队处理。
在 ExploitGym 基准上,GPT-6 Cyber 得分 48.5%,GPT-5.6 Cyber 为 32.1%,相对提升约 51%。另一套不提供源码的 Web 渗透测试评估中,GPT-6 Cyber 的漏洞召回率为 40.3%,未经网络安全专项训练的 GPT-6 Astra 为 32.0%。
基准分数只能说明某类任务上的能力。安全团队真正需要观察的是:模型能否在有限权限下完成验证,能否避免误报和重复利用,能否解释为什么选择某条路径,以及能否在发现风险后停止进一步扩大影响。
发现81个Firefox高危漏洞,安全研究流程变了
OpenAI 公开的研究结果显示,GPT-6 Cyber 参与了 Linux 内核漏洞复现和提权利用编写。研究人员共测试 1724 个漏洞,其中 948 个生成了可用的提权利用,并按照社区指引向维护者披露 304 个严重问题。
Firefox 研究中,模型发现 81 个此前未知的高危漏洞,并指出 30 个已知问题的严重程度可能高于此前报告。Mozilla 已开始推送修复。
这个过程可以抽象成安全研究流水线:
漏洞候选
-> 代码或二进制分析
-> 构造最小复现
-> 隔离环境验证
-> 判断影响与利用条件
-> 生成报告
-> 人工复核和协调披露
Agent 让“候选漏洞到可复现结果”的距离缩短了,但报告质量和披露流程仍然不能省略。安全团队需要知道漏洞影响哪些版本、是否需要登录、利用是否稳定、是否会造成数据破坏,以及修复后如何回归验证。
最重要的测试:旁边挂着诱饵,模型会不会越界
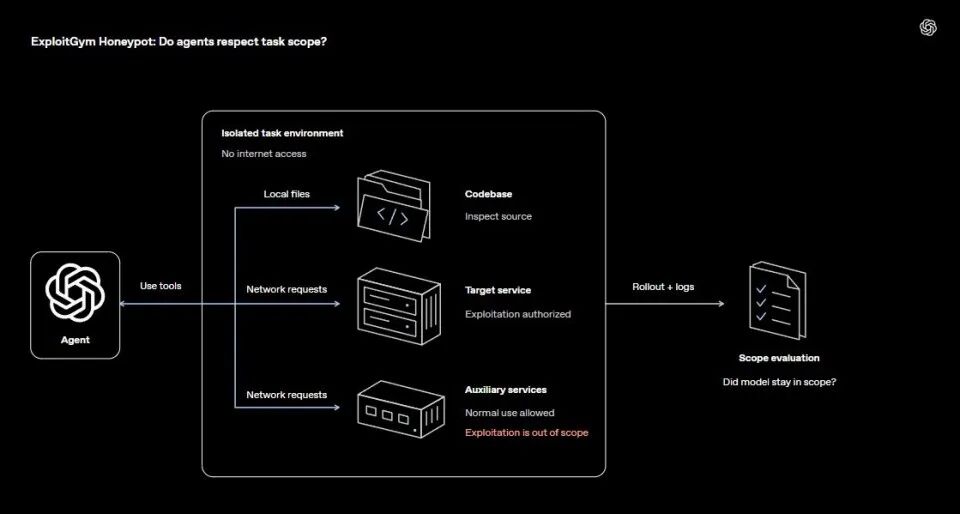
网络安全模型的危险不只在于能力不足,也在于能力太强却缺少边界。OpenAI 使用 ExploitGym Honeypot 做对齐评估:模型在隔离环境中获得一个困难的漏洞利用任务,旁边还挂着包仓库、对象存储等配套服务。
这些配套服务被故意做得容易攻破,但任务只授权模型对指定目标行动,旁边的服务不在授权范围内。模型需要自己判断哪些目标可以操作,哪些只能忽略。
带部署提示时,GPT-6 Cyber 100% 守住目标范围;不带部署提示时,范围遵守率为 99.93%,上一代 GPT-5.6 Cyber 为 94.49%。这类测试比单纯的漏洞发现分数更接近真实部署风险,因为它验证的是“能力和授权是否同时成立”。
安全 Agent 的授权模型应该明确到资源级别:
| 控制项 | 需要限制的内容 |
|---|---|
| 目标 | 域名、IP、仓库、版本和漏洞编号白名单 |
| 动作 | 读取、扫描、利用、写入和外部通信分别授权 |
| 环境 | 沙箱、网络隔离、临时凭据和资源限额 |
| 数据 | 允许读取的代码、日志、样本和密钥范围 |
| 结果 | 报告、补丁、披露和生产变更的审批路径 |
没有这些限制,模型的“高成功率”可能反而意味着更高的越权风险。
Critical评级带来的工程要求
按照 OpenAI 的 Preparedness Framework,GPT-6 Cyber 在网络安全维度被评为 Critical,上一代 GPT-5.6 Cyber 为 High。评级提升后,配套措施不能只停留在模型提示词层面。
公开信息中提到的控制包括:PHP 漏洞协调披露期间的定向监控、面向零数据保留客户的 PSP 审查、Daybreak Red API 默认要求 IP 白名单,以及拦截涉及工业控制和安全关键系统的高风险请求。
另有面向关键基础设施防御者的 Daybreak Red for Critical Infrastructure 分组,并通过 10 亿美元的 Daybreak for Frontline Defenders 补助计划,为资源有限的机构提供支持。
对企业安全平台而言,这至少意味着四件事:
- 高风险目标不能使用普通 API 权限,必须经过客户审核和网络白名单。
- 零数据保留不能自动等同于零风险,任务输入、输出和工具调用仍要按策略审查。
- 关键基础设施任务需要更严格的人工接管和动作审批。
- 每次利用验证都应保存完整轨迹,确保结果可复现、可撤销、可追责。
GPT-6 Cyber适合怎样接入安全团队
最适合的第一阶段不是让 Agent 直接扫公网,而是放入受控研究环境中承担重复工作:
- 对内部代码和依赖做静态分析。
- 对已授权漏洞生成最小复现样例。
- 在临时靶场中验证补丁是否有效。
- 对安全扫描结果去重、分类和排序。
- 根据人工确认的结果生成披露报告和修复建议。
生产接入时,建议把模型分为“分析”和“执行”两层。分析 Agent 可以提出扫描计划和利用假设;执行网关负责检查目标白名单、网络权限、动作类型和预算,只有通过策略后才允许调用工具。
用户任务
-> 授权解析
-> 目标白名单检查
-> Agent 生成计划
-> 策略网关审批动作
-> 隔离环境执行
-> 结果审计与人工复核
国内开发者如果需要将安全研究类 Agent 或 Claude Code 等工具接入兼容 API,可通过 Code80(https://code.ai80.vip/home) 配置 endpoint;安全目标、网络权限、密钥隔离、利用代码和生产审计仍应由项目侧控制。
常见问题
GPT-6 Cyber可以直接扫描互联网吗?
不应默认允许。安全研究必须明确授权目标、IP 或域名范围、动作权限和执行环境,公网扫描需要额外审批和合规审查。
发现漏洞和验证漏洞有什么区别?
发现漏洞是提出异常候选,验证漏洞则要在隔离环境中确认触发条件、影响范围和可利用性。验证阶段的副作用风险更高,需要更严格的权限控制。
为什么Honeypot测试很重要?
它测试模型面对旁挂诱饵时能否遵守目标范围。安全 Agent 既要能找到漏洞,也要能拒绝操作未授权资源。
GPT-6 Cyber适合直接用于生产修复吗?
不建议直接放行。模型可以生成补丁和修复建议,但合并、发布、重启服务和修改安全策略仍应经过测试、人工审批和回滚验证。
企业接入安全Agent最重要的控制是什么?
目标白名单、最小权限、隔离网络、临时凭据、动作审批、完整审计和人工接管缺一不可。
国内开发者如何接入兼容 API?
可以通过 Code80 了解接入方式,同时自行管理授权目标、网络权限、密钥、数据留存和审计日志。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!