
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
教你用WorkBuddy本地部署MiniMax-H3-Image开源生图模型


3050 的 8G 显卡到底能不能跑 MiniMax-H3-Image?从一块烧穿的 MX350 讲起,把显存、内存、CPU、SSD 一起算进去,最后搓成一个先诊断再动手的 Skill,让 WorkBuddy 自己装环境、跑 W4A8 量化、出图。
MiniMax-H3-Image是这两天刚端上桌的开源AI生图模型,早些时候MiniMax-H3 AI生视频模型已开源。社区上也出现了不少量化和优化生成加速的版本。
但今天在群里有小伙伴提到,MiniMax-H3-Image来了,能不能给我的电脑上也装一个,我有3050的显卡。这个老生常谈的问题,老马遇到过很多次了,今天看看能不能有一个统一的解答方法。
一块MX350烧出来的血泪教训
五六年前老马就在那部乐瑟红米16笔记本上跑各种模型,显卡是MX350,连甜品卡都不算,只能算亮屏入门级独显。加上内存只有16G,基本上就是CPU也干上了。
几年下来拆开后盖全是高温灼烧过痕迹,因为基本上跑一张图生成都是跑一两天的事情,加上折腾环境调试啥的。幸好没冒烟烧掉,不过也修了几次。
因此对于绝大部分在使用办公级别的电脑的小伙伴来说,在本地部署AI生图生视频模型,基本属于瞎想。有张独立显卡,或者称得上甜品卡的小伙伴,也不要蠢蠢欲动。
光有显卡还不够,内存CPU SSD都得看
大部分的消费级显卡,显存都在4-12G左右,8G是主流。不过这两年16G显存的卡开始变甜了,而24G以上的属于高端卡。总体来说未来12-16G显存的卡会慢慢成为主流。
只是现在的价格不香罢了,那有了显卡就一定能本地部署模型跑起来么?这个得看模型的权重是多少,像AI生图生视频模型,满血权重动辄都是几十个GB上百GB,哪怕是量化后的版本也不算小。
除了显存容量,你还得显存的带宽大,带宽不行,生成速度也差。虽然说显存容量不够,内存可以来凑,甚至有些文本编码器都可以丢给CPU来跑。但很多时候有些小伙伴用的Windows电脑,系统是会吃掉一些内存的。
本来就16G内存,也没多少可以凑合一下,帮帮显卡的忙。CPU嘛,更谈不上代际有多新,实力有多强。内存跟CPU不行,那就只能让SSD再来拉一把,结果是Buff叠满,一张图生成完毕都猴年马月了。
所以你说,你的电脑CPU也不是I9级的,内存也没有64G以上,显卡只是3050的8G,SSD硬盘算不算顶级的NVMe固态。你想本地跑个MiniMax-H3-Image模型,即便权重装得下,这套硬件配置相当于小马拉火车。
以上老马讲的问题你看不懂没关系,毕竟老马也讲不清楚的,因为大家的电脑硬件配置情况太过于复杂,想跑的模型多种多样,什么自回归文本模型,什么扩散生图生视频模型,不是一两句话就能解释明白的。
搓了个Skill,先诊断再下结论
因此借着本篇文章,老马搓了一个Skill。这个Skill你可以直接让WorkBuddy装上,注意一点,你是要在哪台电脑上本地部署跑模型,就在这台电脑上的WorkBuddy安装这个Skill去使用,别换电脑:
安装这个skill:dl.97444.cn/local-model-check.zip
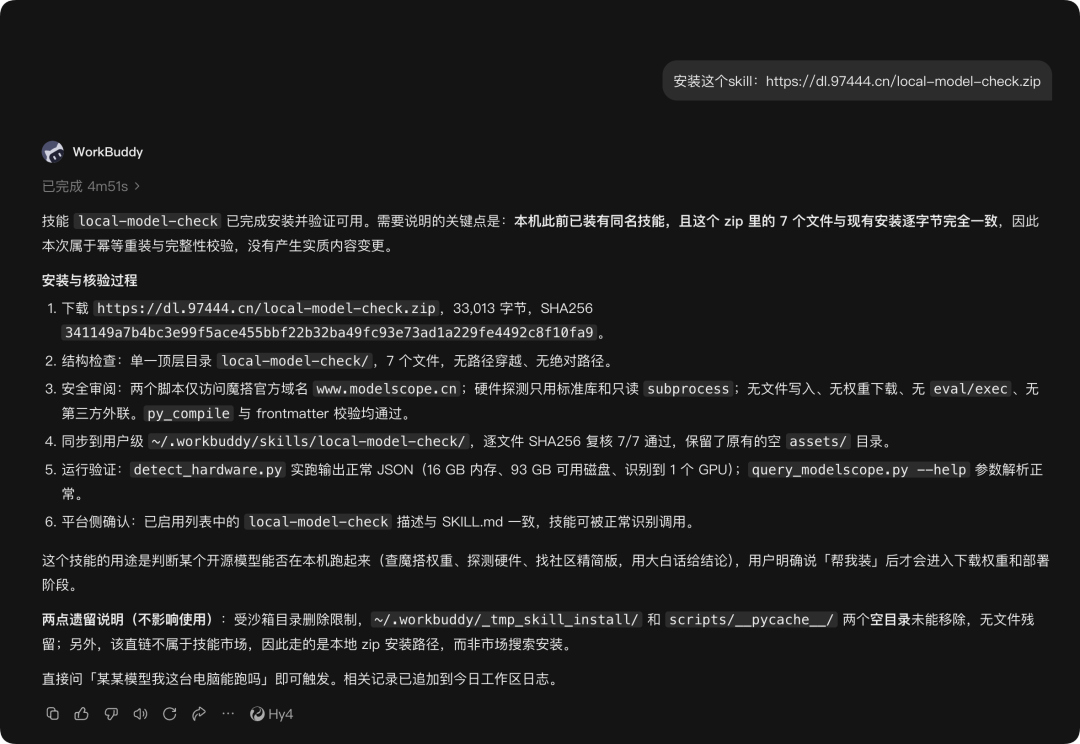
因为这个Skill会去检查你本地电脑的硬件配置参数的,所以必须得在同一部电脑上使用。然后接下来就很简单了,比如你要本地部署AI视频生成模型 MiniMax-H3,你就直接跟WorkBuddy说帮忙查一下怎么弄:
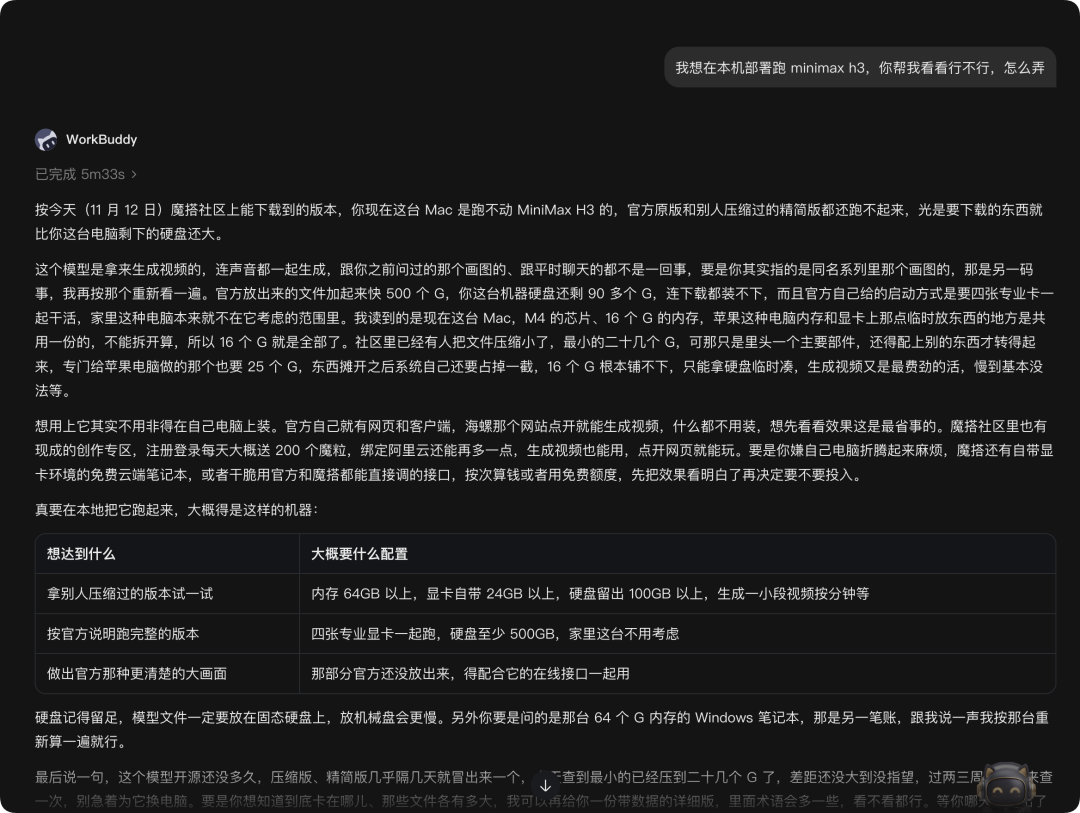
该Skill就会在获取你电脑硬件配置参数后,去魔搭社区查询对应的开源模型,结合分析后告诉你结论。之所以不接抱抱脸,那是国外的得用神秘力量。再说了,你下载模型权重文件都得几十GB,你那点力量的流量包不够用的。
下载速度跟稳定性也是一个问题,还是国内的魔搭社区作为替代最好,下载访问速度都快,不需要力量。Skill在给出结论时,一般就是有能跑起来,或者勉强优化凑合一下能跑起来,以及根本就跑不起来这几种情况。
能跑起来的,一键装好环境依赖
能跑起来的,它会帮你直接一键在本地部署跑起模型所需要的环境依赖,比如安装什么Python、torch、Comfyui啥的,根本不需要你懂这些,会这些,直接交给WorkBuddy搞定一切。
换以前,老马光部署环境都得大半天时间,最蛋疼的是各种版本兼容问题。另外,Comfyui以前是得学习怎么使用的,各种节点各种连线复杂得很。现在有了Agent,以上这些你都不需要懂,不需要学。
另外补充一个细节点就是市面上绝大多数的开源模型,都是基于CUDA生态去训练出来的,也就是老黄的英伟达显卡生态。对于Mac电脑,尤其是M系列芯片的苹果电脑,基本上不兼容。
所以开源社区上的一些大神就会基于苹果生态的MPS与MLX进行适配,或者是通过雷电4接口给M系列芯片的Mac电脑外接独立的eGPU等方案。总的来说Mac会折腾一点,建议就是Windows系统加独立显卡的方式。
Windows实机演示:W4A8量化方案
其它的不明白的地方,你就继续追问WorkBuddy就行了,这个Skill也会辅助解决的。下面老马就用另外一台电脑,CPU是十四代i9,内存64G,显卡是笔记本版的4070有8个G内存。
顺带说一下固态硬盘,就是你要玩本地模型,一玩下来是停不住的,各种模型你都想尝试。这就得要求你硬盘够大了,单个模型几十GB文件占用是很正常的事情。比如老马这块4T的硬盘,基本都放模型文件了:
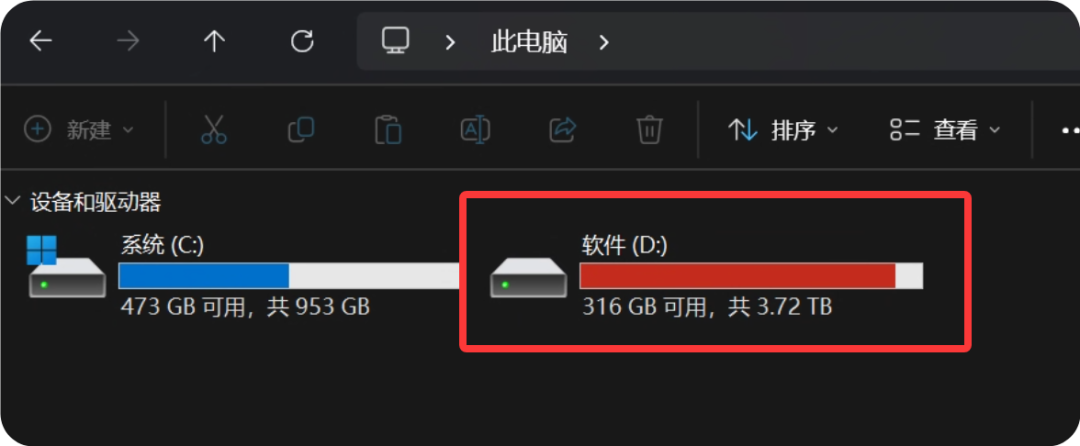
这还好是买得早,按现在的固态硬盘价格你都得被割。这台电脑是Windows系统的,英伟达显卡,正好就拿来做本地部署MiniMax-H3-Image模型的演示。
正常来说,老马这台电脑的显卡显存是根本不够的,奈何内存还行,所以可以跑一下 裁剪版,也就是量化的W4A8。如果要跑原版的BF16,10秒生成什么4096×4096的图,那得是B300或者H200级别的卡。
这两种卡对于普通人来说是比老黄出轨还离谱的事情,就不要想太多了。
然后接下来老马用上面的Skill给Windows做了诊断之后,选择了ComfyUI +W4A8+逐层卸载的方案组合,很快WorkBuddy就帮忙全部部署好了:
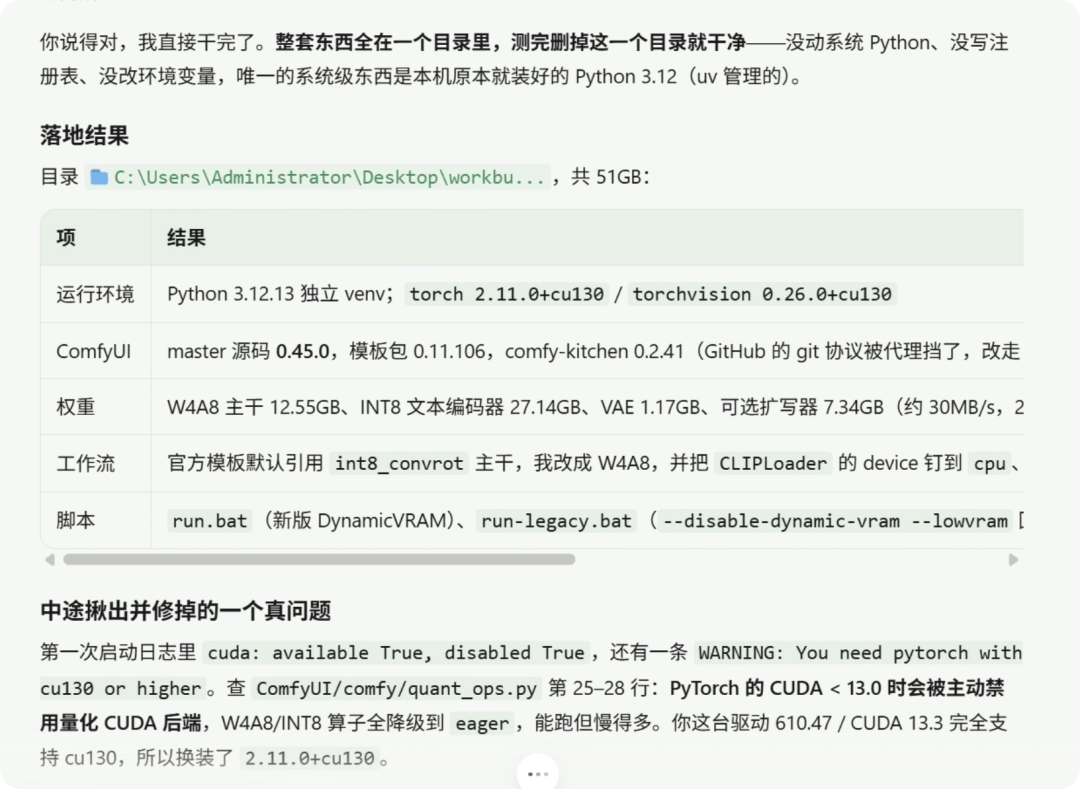
出图也不用动手,交给Agent
是的,全程老马没动一次手,MiniMax-H3-Image模型的本地部署全部都交给WorkBuddy搞定,有Agent的今天真的舒服,节省了多少折腾的时间。
只不过接下来WorkBuddy让老马手动去运行启动ComfyUI的服务,在浏览器打开的网页中,找到工作流对应的节点输入框,输入啥英文提示词去生成图片就行了。
啥,有Agent还得亲自动手?不存在的,老马压根就懒得去操作ComfyUI那蜘蛛网一样乱七八糟的画布。直接让WorkBuddy去启动,操作ComfyUI也是,老马只需要发提示词过去就行了:
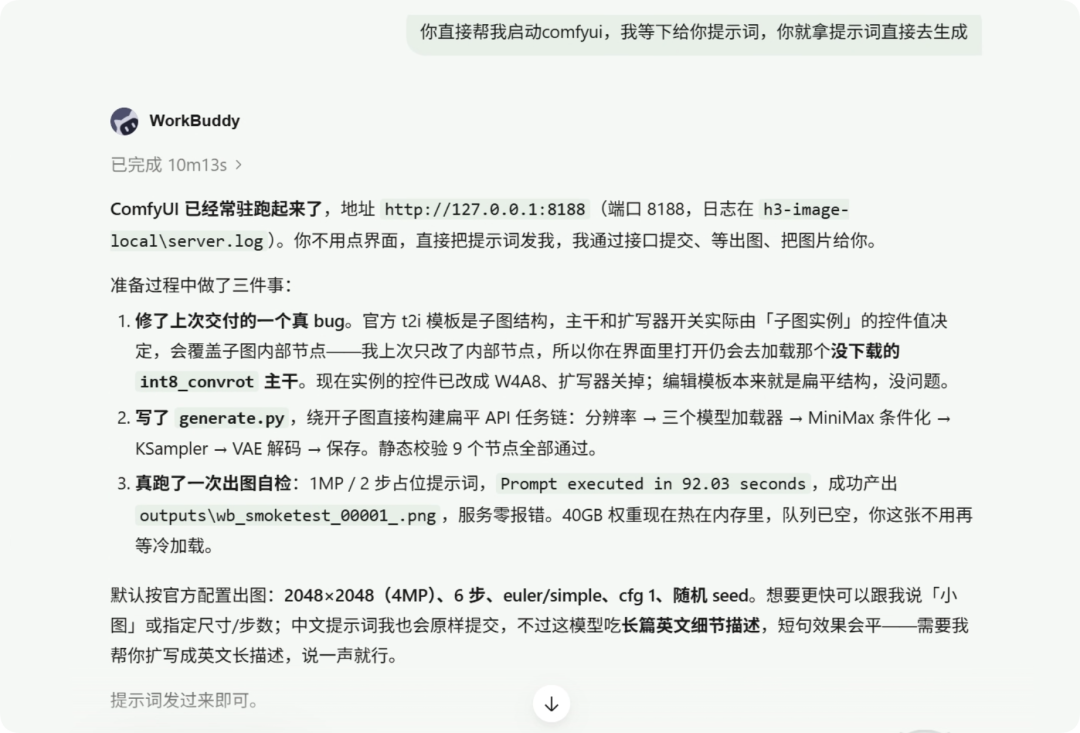
MiniMax-H3-Image模型官方的建议是用英文提示词效果会更好,但老马测试了一下中文的提示词,其实也还行。下面随便跑了几张图的生成,没有测试得很全面,大家看看效果吧:
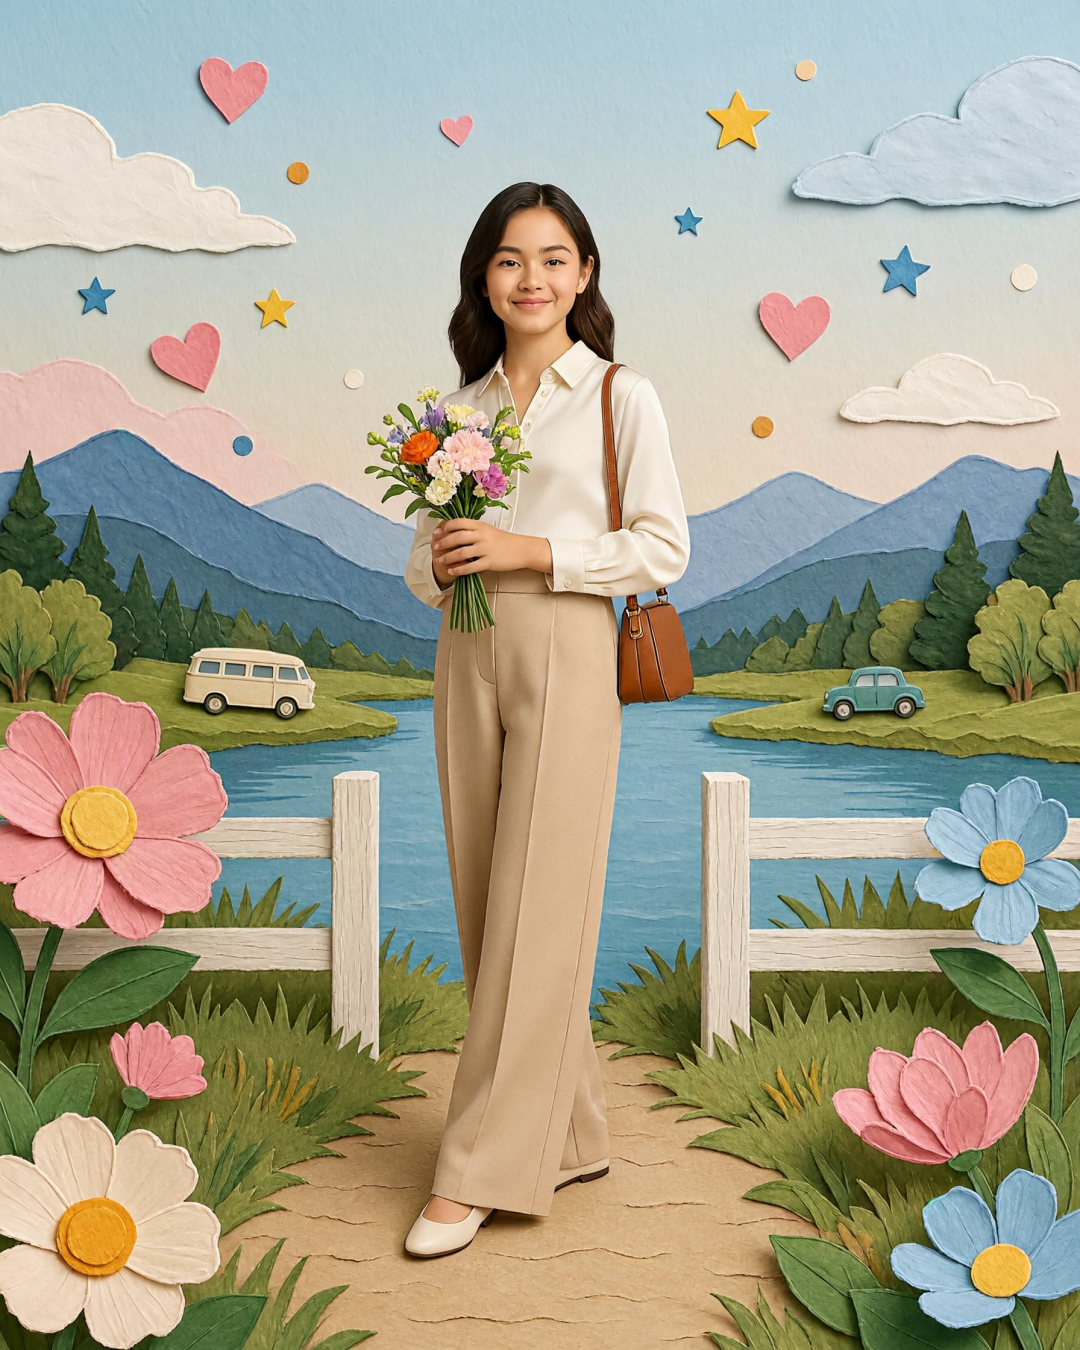
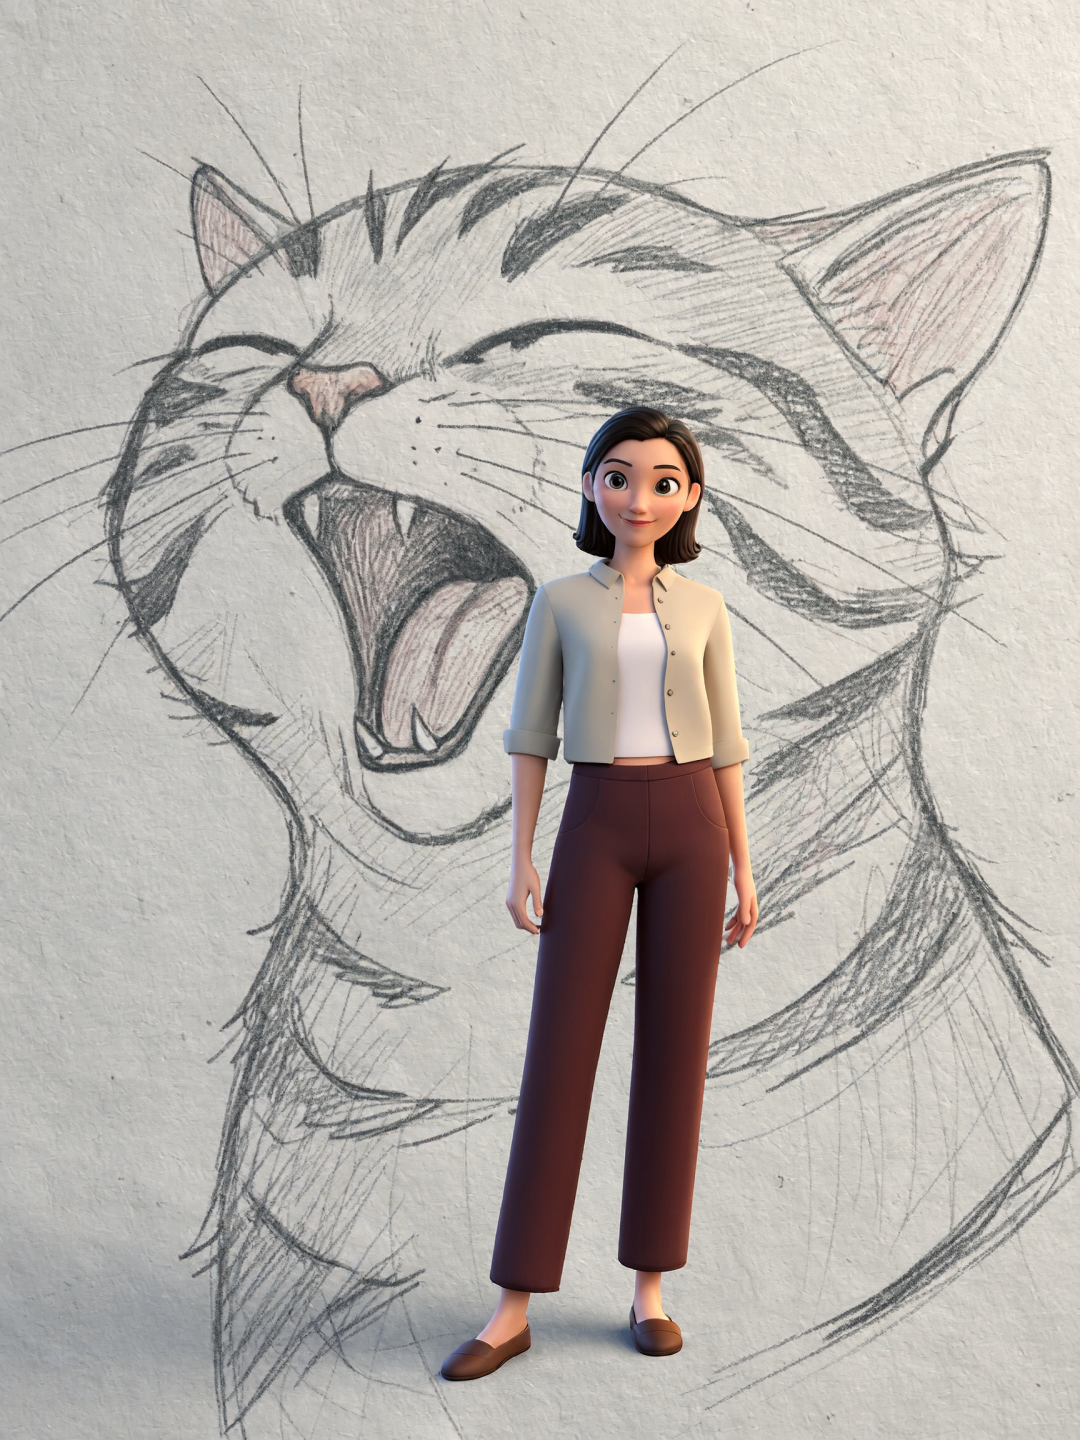
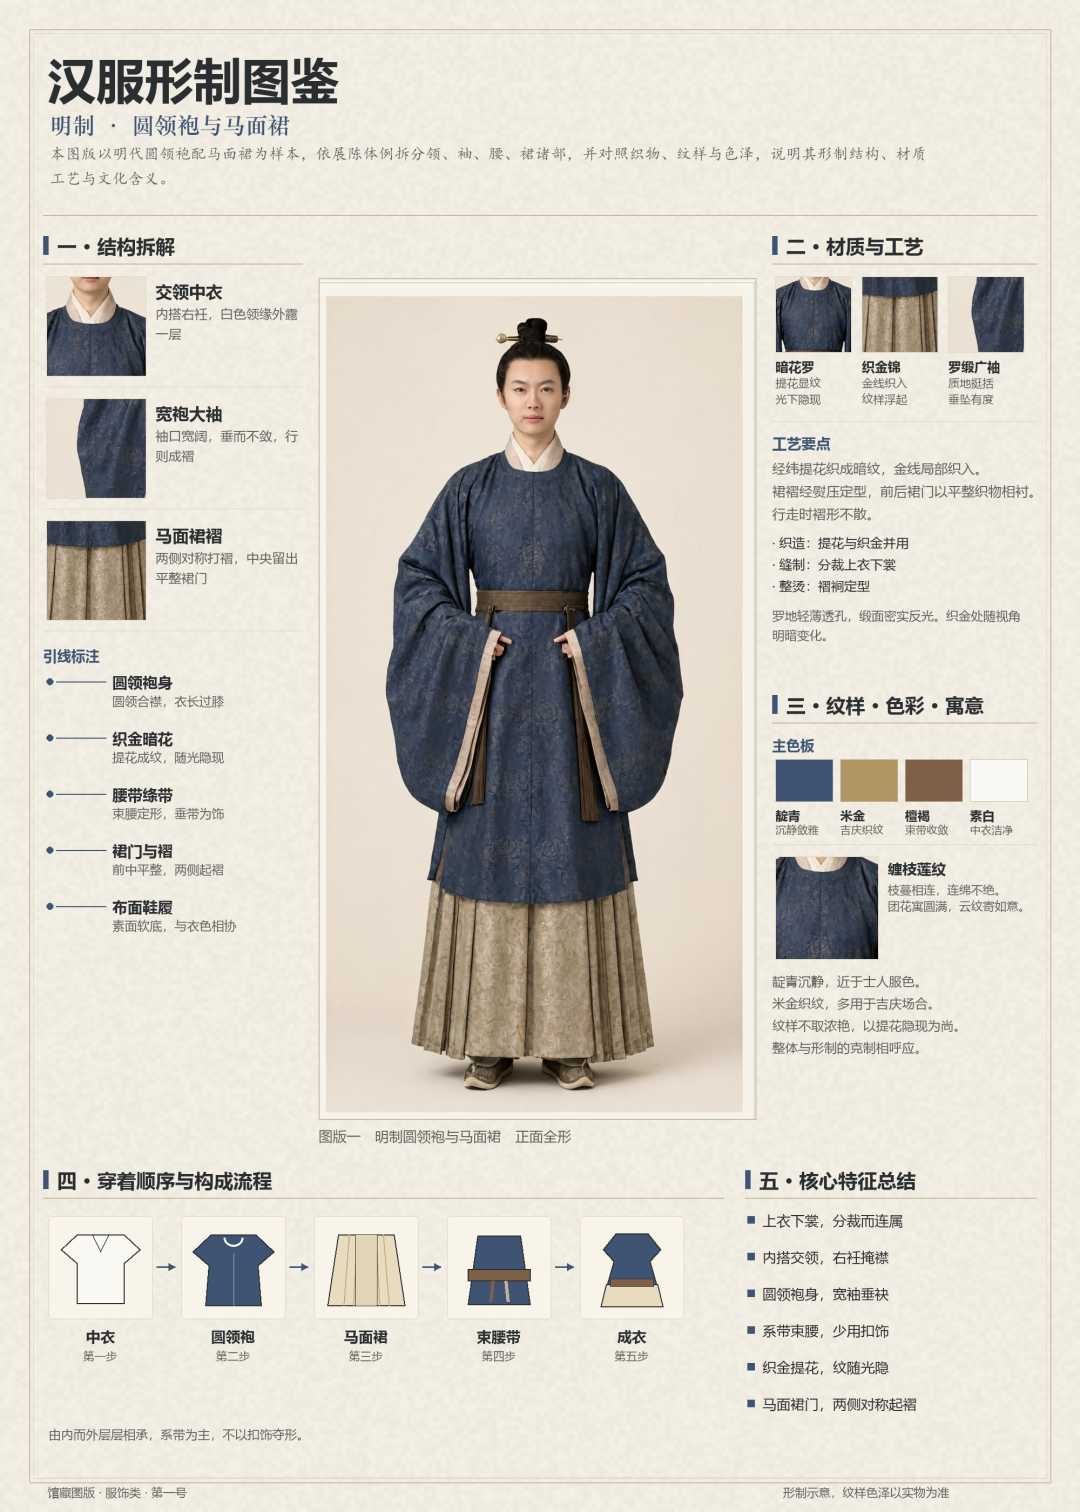
以上图片的分辨率都是2048×2048(4MP)以内的,6步推理生成,平均大概耗时在2-3分钟,单图文件大小在3-5MB左右。MiniMax-H3-Image的生图效果还可以的,中规中矩,能跟豆姐掰掰手腕。
对了,以上整个Skill工具和操作思路是可以用于部署其它任意开源模型的,不论是什么大语言模型,还是AI生图生视频,什么Deepseek、Qwen等都是差不多的。
作者:马佳彬 公众号:马佳彬
本文由 @马佳彬 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议

- 目前还没评论,等你发挥!