
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
a16z 合伙人最新分析:AI 应用该如何获得高溢价


当客户发现让工程师拿最新模型直接跑,效果差不多,你还能收多少溢价?a16z 合伙人把 Harvey、Clay、Decagon 的做法摆在一起看:溢价只能放在客户最难自己做出来的地方,按 token 收费是个坏主意。
你有没有想过,如果你做的是卖给企业的 AI 软件,客户某天在周会上说“我让工程师拿最新的模型直接试了一下,出来的东西差不多”,你手里还有什么能让他继续付现在的价格?这个问题以前不用认真回答,因为客户自己做又贵又慢。现在模型一代比一代强,开发工具一代比一代好上手,客户“自己动手”这个选项,每过一个季度就便宜一截。
11 月 2 日,a16z 增长团队的合伙人 Tugce Erten 写了一篇长文,专门谈这件事。Tugce 在 a16z 研究的是定价和打包方式,之前写过 AI 价格战怎么打,也写过为什么不该按 token(模型计费的最小单位,大致相当于一小段文字)收费。把 Tugce 的说法和 Harvey、Clay、Decagon 这几家的实际做法放在一处对照,我的看法是:AI 应用能收多少溢价,取决于客户自己动手要多费多少功夫。这个功夫一直在变少,所以溢价只能放在客户最难自己做出来的地方。
最先动摇你价格的,往往是客户自己的工程团队
想想家里做饭这件事,灶具越来越便宜,菜谱视频随手能搜到,买菜也能送上门,那外卖凭什么还能卖得比食材贵?因为你点外卖买的是买菜、洗切、收拾灶台这一整套功夫,每当其中一步变容易,外卖就得重新证明自己值那个价。AI 应用面对的就是这样的处境,只是变容易的速度快得多。
一家全球专业服务公司的采购负责人告诉 Tugce,如果直接给前沿模型写一段提示词,出来的工作成果比供应商的效率工具更好,公司就看不出为什么还要付平台溢价。这家公司已经搭了自己的 AI 平台,客户不允许用第三方产品的敏感项目,就在本地或者自己的机房里跑模型,同时还在试各种开源代码,看有没有能替代商业软件的。
这种威胁的门槛比大多数创业者想的低。客户用不着把你的整个产品重做一遍,只要把用量最大的那一项任务搬回内部,或者手里有一个看起来可行的替代方案,谈价格时就有了底气。Tugce 之前和不少大客户聊过,他们对自己做还是买有一条很清楚的线:一家金融机构的说法是,离核心业务近的自己做,非核心的一律买。我觉得这条线对创业公司的提醒是,被替代的风险和产品好不好用关系不大,更多取决于这个功能离客户的核心业务有多近。
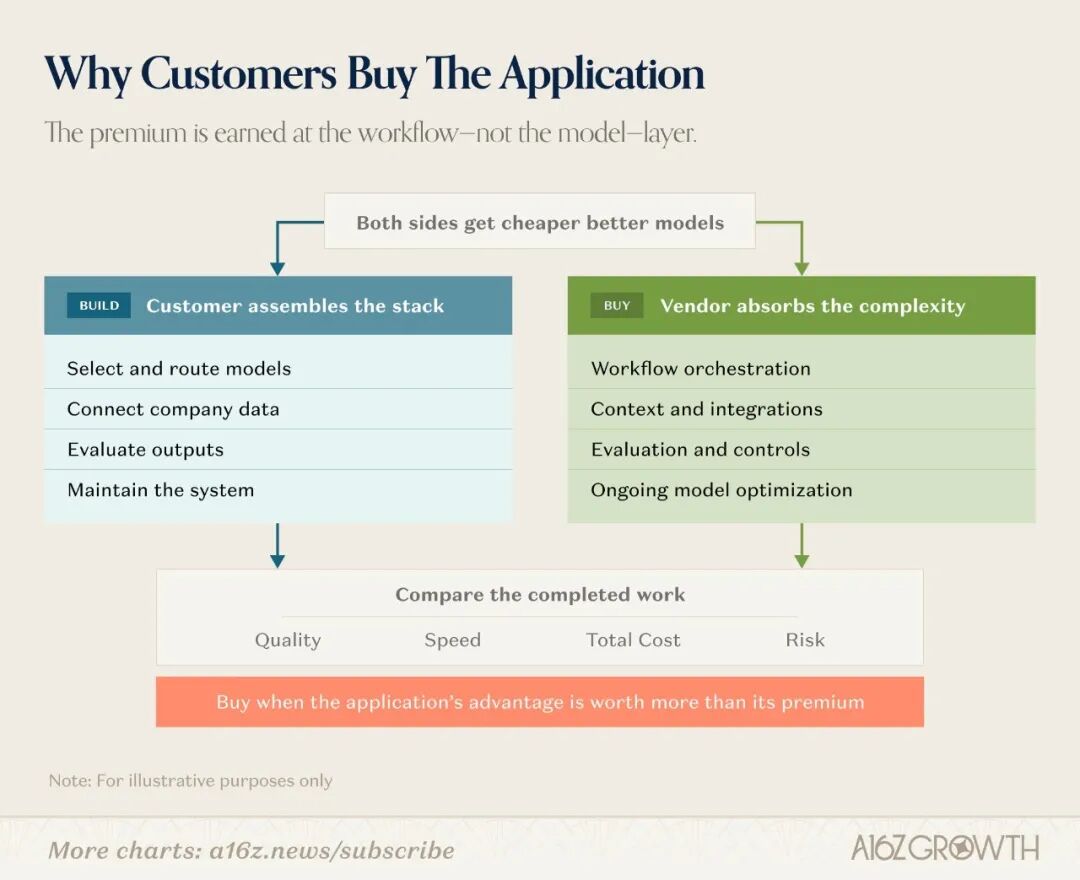
所以 Tugce 给的衡量办法很直接:把客户手里最靠谱的替代方案摆出来,从总成本、质量、速度和风险四个方面和你的产品比,实施、运营和维护要花的功夫也一并算进去。能赢,溢价就站得住;赢不了,再漂亮的价格表也只是一厢情愿。这个测试最有用的地方,是它问的不再是同行卖多少钱,而是客户自己做要多少钱。后者每次模型升级都会往下掉一点,所以这道题算一次不算完,每个季度都得重新做。
客户不怕贵,怕为随处可买的东西付贵价
客户对高价的态度,其实比创业公司担心的宽容。一家顶级金融机构的 AI 负责人告诉 Tugce,他们会故意在同一个用途上同时用两三个 AI 工具。原因是关键流程不能只靠一家供应商,产品还在成熟,表现会波动,也会出幻觉和宕机。还有一家做消费硬件的公司,放弃了大型科技公司的低价合同,转去选一家更小的 AI 原生供应商,只因为后者的代理最先进。聊下来没有人说自己选某个工具是因为最便宜。
这说明让客户不舒服的从来不是贵本身,而是为一个到处都买得到的东西付了溢价。Clay 花了将近一年反复测算,才想明白这一点,今年 3 月 11 日它公开了一份内部的定价备忘录,宣布做上线以来最大的一次价格调整。Clay 是帮销售和市场团队找客户、整理线索、自动跑外联的平台,背后接了一百五十多家数据供应商。它的老办法是按点数收费,每查一条数据花几个点数,起步时数据补全就是它的主要用途,这样收钱说得通。后来产品长成了一整套工作平台,客户用它跑外联、给线索打分、在通话前把账户研究推给销售,价值越来越多出在这些编排工作上,价格却还主要挂在数据条数上。他们自己写得很直白:客户来 Clay,不是来买原料的。
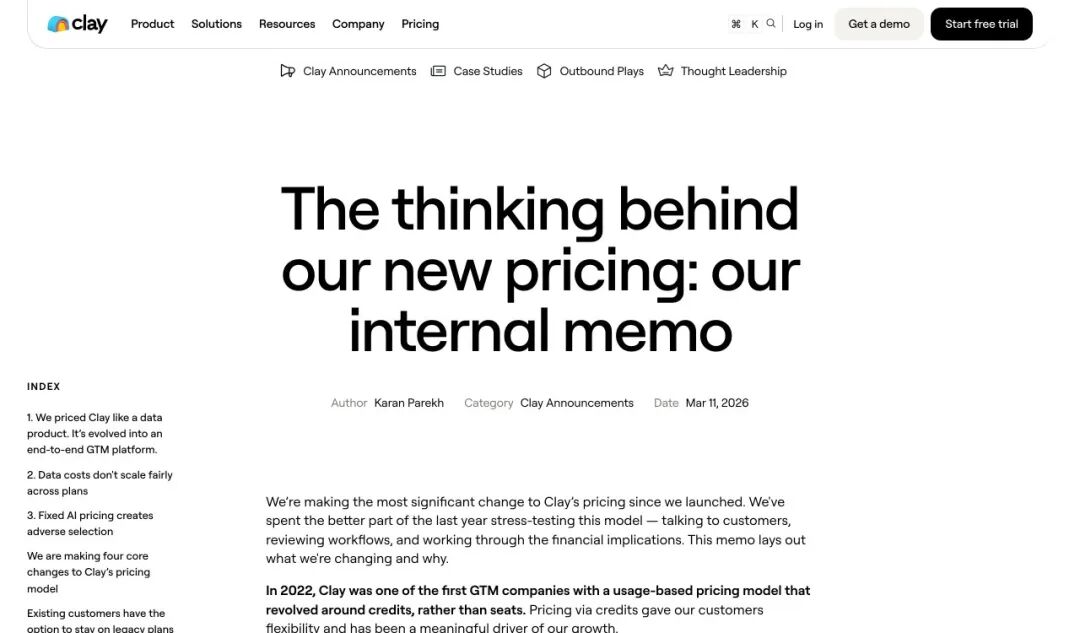
这套收费方式在两头都出了问题。最小的自助客户每个点数付大约 8 美分,另一些客户便宜了约八成,差了接近五倍,结果不是小客户付多了,就是大客户在让 Clay 亏本。AI 这一块更麻烦,因为推理型模型(会一步步想很多步再回答的模型)每次跑下来的成本差得很远,有的几步就完,有的要几十步。固定价格只能定在平均数附近,简单任务被多收了钱,复杂任务又赔钱。于是任务简单的客户干脆拿自己的接口密钥去用,觉得 Clay 不划算,任务复杂的客户反而都留在了固定价格里。
Clay 的做法,说白了是把便宜的东西还回便宜的价格。数据点数降价五成到九成,和客户在外面买差不多。另设一种叫 Actions(动作)的计量,专门算 Clay 自己做的编排工作,比如数据补全、AI 任务、接口调用和向第三方平台推送。多数模型保持固定价,复杂的推理型模型改成按实际用量收,一分钱不加价。这像一家打印店,纸张按市场价卖,贵的是帮你排好版、设计好封面的那份手艺,客人不会因为纸贵去别家,却愿意为只有这里做得出的排版多付钱。
Clay 为此愿意先吃亏,自己就写明这次调整短期内会让收入和利润都往下掉。他们还列出了六个风险,比如新客户可能因为起步价更高而不愿意买,客户可能因为有用量上限而不敢多试。但在我看来,错位的定价真正的代价不是少赚一点,而是客户结构被悄悄改掉:便宜的客户走了,贵的客户留下。账面上看生意还在,每留下一个客户却都在多亏一点。主动把这个口子堵上,比等客户用脚投票体面得多。
溢价要放在一句提示词写不出来的细节上
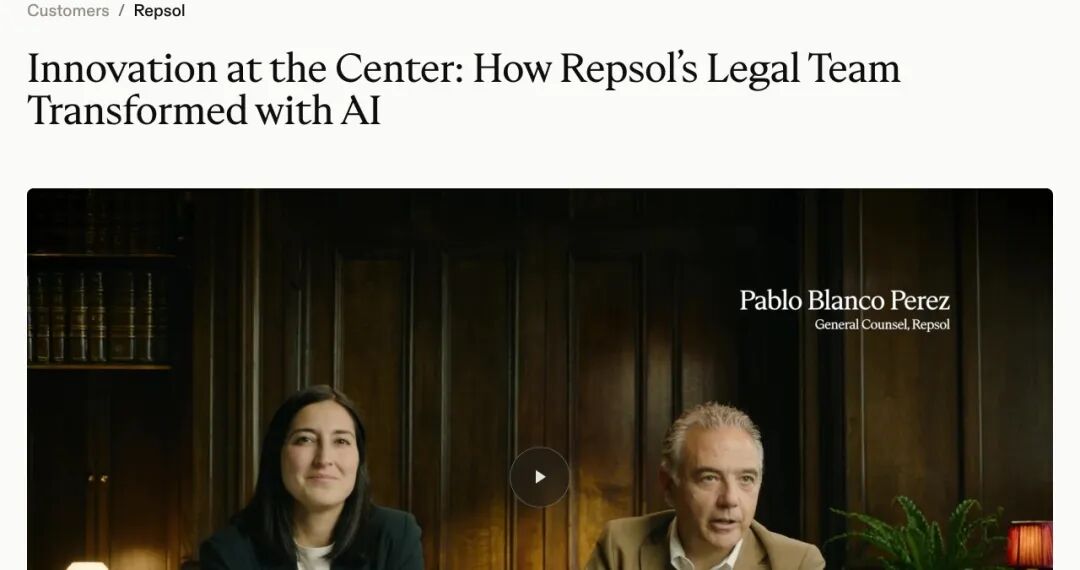
那客户愿意多付钱的那一块,到底长什么样?Harvey 做合同审查的方式是个很好的样本。西班牙能源公司 Repsol 的法务部有两百多名专业人员,分布在 12 个国家,2023 年底他们做了一次盲测,把 Harvey、微软的 Copilot 和公司自己做的内部原型 Lexia 放在一起比,Harvey 的输出质量最高。随后 50 名律师在 12 个司法辖区试用了八周,准确率和省时间两项 Harvey 又赢了,2024 年 4 月 Repsol 决定全面推广。审一条合同条款原来要三十到六十分钟,现在几分钟。
要看懂 Harvey 赢在哪里,得看它自己讲合同审查系统的那篇长文,赢的地方几乎都是小细节。一份合同里的条款会互相引用,一条关于转让权利的规则可能牵扯四个章节,另一条规则又想改同一句话,两处修改就打架了。同一个条款,在己方起草的合同里能接受,在对方起草的合同里就不行;谈到第一轮和谈到第七轮,答案也不同,对方已经拒绝过的建议不该再提第二遍。律师行里还有个说法叫“最轻的手”:一个条款只需要改三个字,就别把整条重写。每一处红线都会被对方律师一字一字地审,改得越多,谈判越慢,人工复核也越累。通用模型最爱犯的恰好就是这个毛病。
为了解决这些,Harvey 把原来固定顺序的多次模型调用,改成了像一个律师团队的结构。一个主代理扮演牵头律师,给每条审查规则派一个专门的代理,最多几十个同时干活。每个代理在文档的独立分支上修改,改完写一份简短的说明,讲清楚怎么归类、改了什么、为什么。最后主代理像版本管理软件合并代码那样把分支合起来,两条规则碰到同一句话时,由它按资深律师的办法拟一个兼顾的改法,有些决定还会交给真人,并把理由摆清楚。
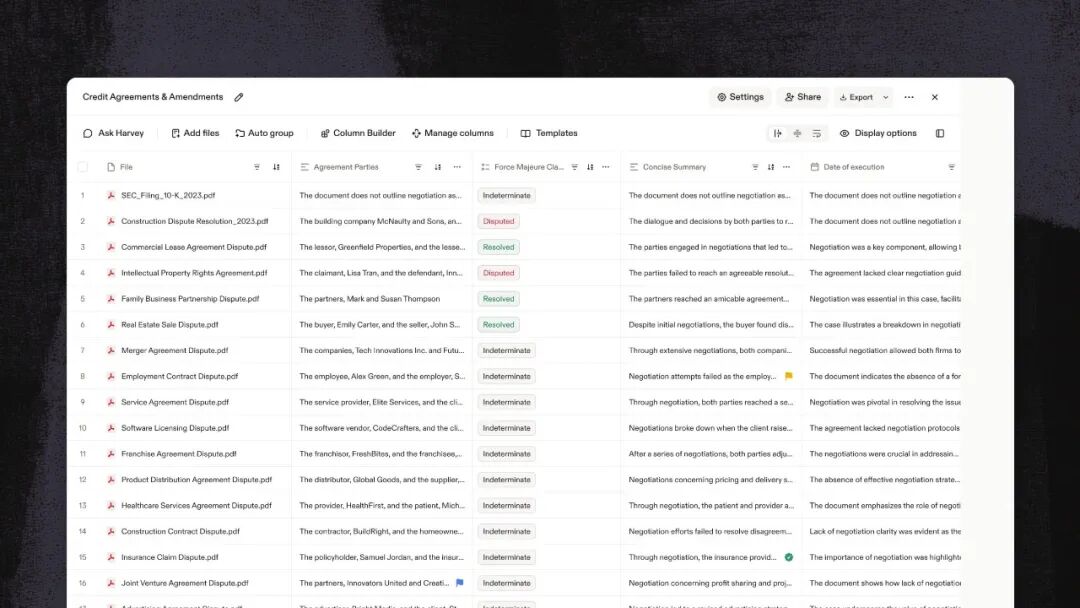
客户多付的钱,买的就是这些。它们都来自真实谈判里一次次吃过的亏,换一个通用模型临场发挥,很难恰好碰对。而且这种优势会随使用增长。Repsol 用 Harvey 对比了几千份过去的协议,发现有一条条款总是被对方挑战,于是改了合同模板,加上备用条款。Harvey 自己也在研究从律师接受、修改或拒绝的红线里学习,让以后每份新合同需要的指导更少。客户自己从零搭的版本,每次都得从头摸索。
往外推一步,这给做 AI 应用的团队留了一个很实际的问题:你的产品里,有哪些东西是用一次就比上一次更懂客户的?答案如果是“没有”,那溢价基本是靠客户还没来得及自己动手撑着的。
数据值钱,是因为客户自己整理太费事
另一种值钱的东西是上下文,也就是 AI 做事时需要的背景资料。Tugce 讲了一家垂直行业软件公司,多年来积累了大约三千家公司的价格基准数据,正在考虑通过 MCP(让 AI 系统直接调用外部数据的开放协议)开放给客户的 AI 去查。这笔账很容易算:收集、整理、校验、维护,这些功夫由供应商做一次,成本分摊到很多客户头上,每个客户租一份可靠又新鲜的数据,比自己从头做一份便宜。
这有点像办一张图书馆的借书证。书你当然可以自己买,可买书、编目、更新、找地方放,每一样都要花钱花力气,图书馆把这些摊给所有读者,借书证就比自己建一个书房便宜得多。图书馆赚的是省掉重复劳动的那部分,读者拿到的是更全的书和更低的总成本。
同样的逻辑也适用于客户自己的数据。政策文件、客户记录、合同、过往的工作流程,这些本来就是客户自己的东西,看上去没什么可收费的。可要让 AI 可靠地用上它们,得处理谁能看什么、统一格式、做检索,还要持续检查有没有错。这些活又繁琐又没有尽头,应用把它做好,就有了收费的理由。
所以做这类生意的人要时不时问自己:客户付的钱,买的是一份别处买不到的数据,还是一份别处也能拿到、只是自己整理太麻烦的数据?前一种几乎不怕模型进步,后一种就要看你的整理功夫能不能一直比客户自己动手便宜。Tugce 的建议是先分清客户究竟在为“拿到”付钱,还是为“整理好”付钱,再各自定价。
光做得好不够,客户得能亲手算出这笔账
执行和上下文只是让溢价有了可能,能不能收得到,还要看客户看不看得见。a16z 在 8 月访问了 100 位企业里负责大模型采购的决策者,94% 预计未来一年的大模型总支出会增加,37% 预计至少翻一倍。钱会越花越多,管钱的人就会越来越想问:这些钱到底买到了什么。
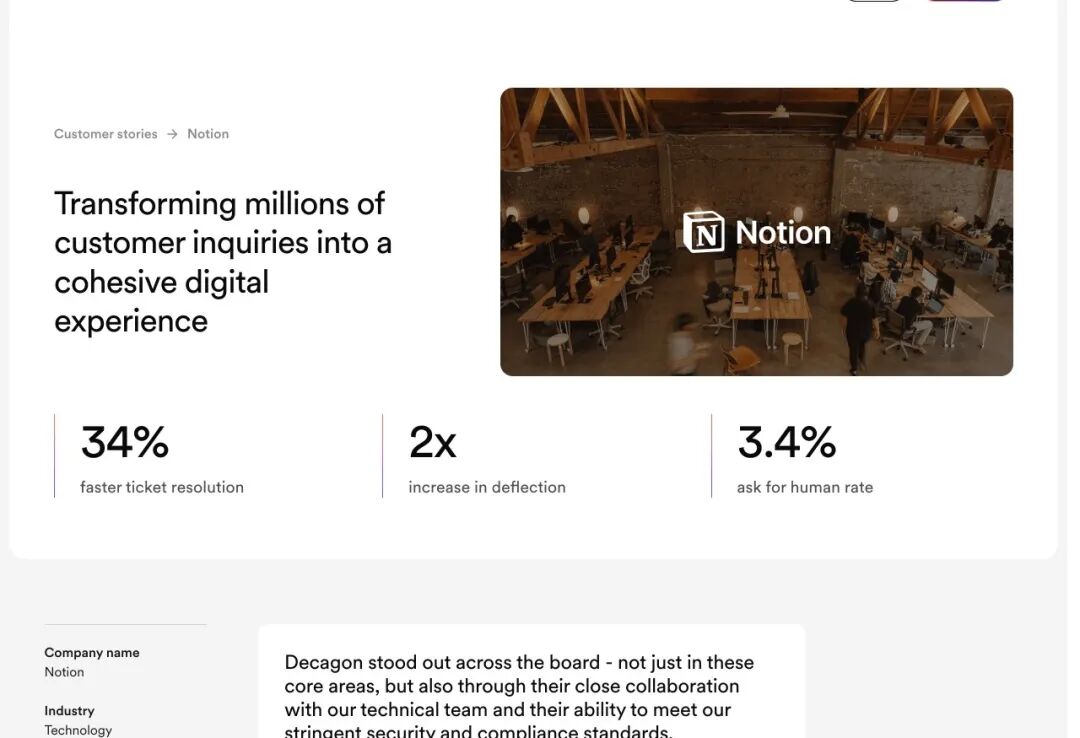
Notion 的客户支持团队就是这样做选择的。Notion 每年大约有一百万次客户咨询,起初考虑过自己做,后来决定评估外部方案,好让团队专心做核心产品。他们走了一轮正式招标,从是不是原生的生成式 AI、产品和界面好不好用、和现有系统的集成深度、路线图、合作关系这几方面比,最后选了 Decagon。上线以后,工单处理时间最多缩短了 34%。这个数字对买方的用处,是同时回答了两个问题:为什么买,以及怎么跟老板交代这笔钱。
要让每个客户都能这样算账,Tugce 建议先选一个客户认得的计量单位,比如审完一份合同、解决一次客服对话、完成一项研究任务。然后把完成这一件事的完整成本算清楚,检索、模型调用、工具、重试、评估和人工复核都算上,失败的那几次也要计入。最后拿这个数字去和客户原本的做法比,客户有可能自己做的话,开发和维护的成本也算进去。这听上去像内部财务的活,但它决定了价格站在什么地上:站在客户能自己验证的事实上,客户就不必靠信任来付钱。
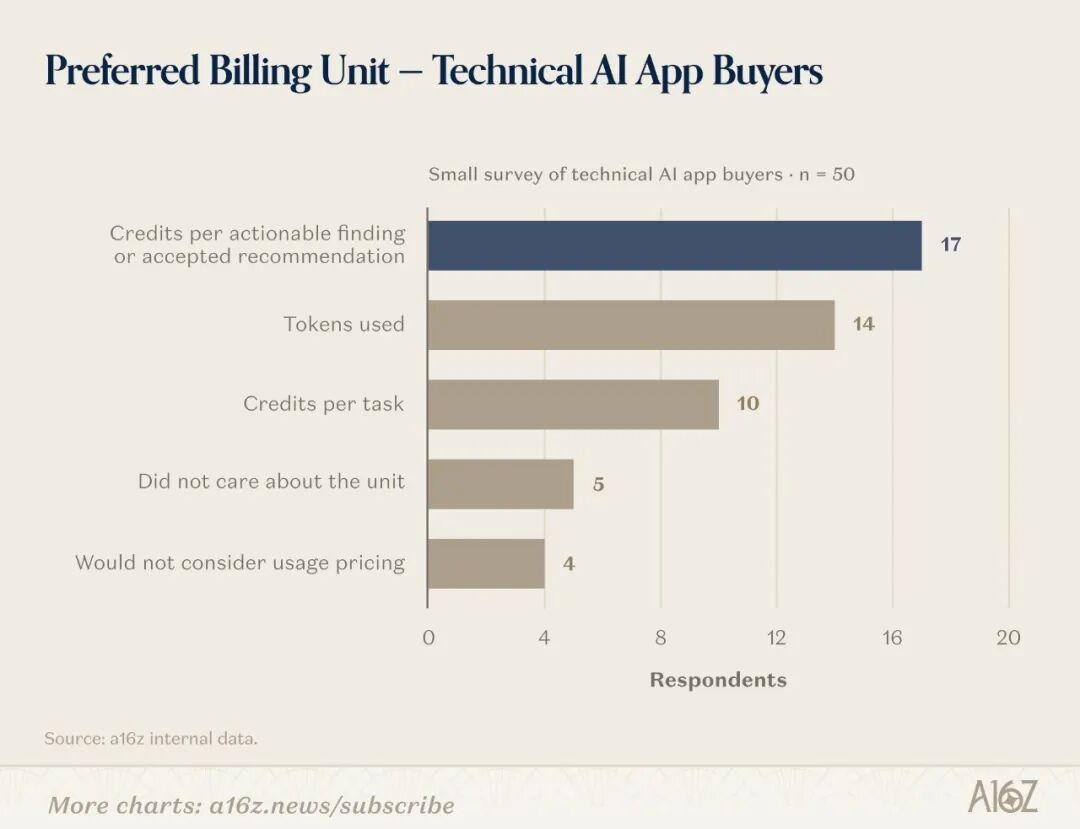
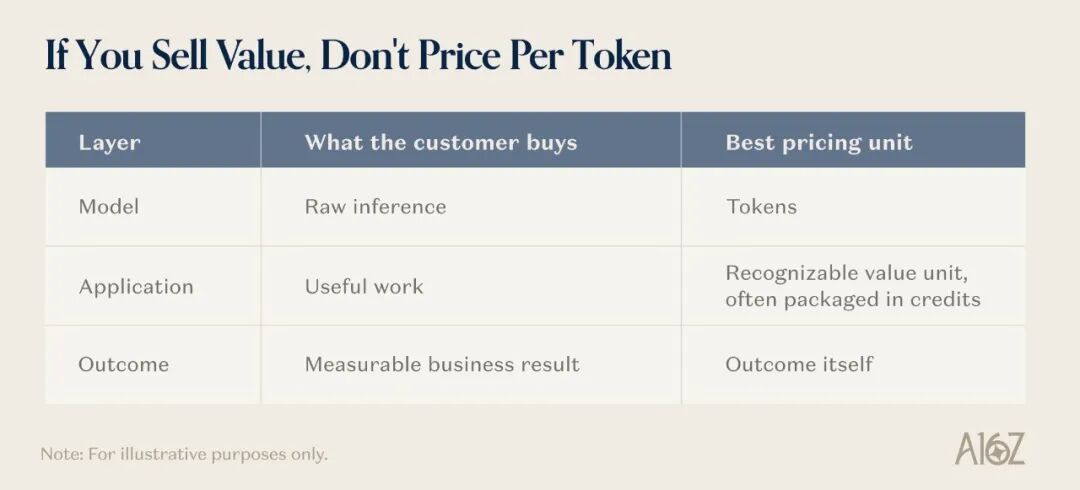
这也是为什么按 token 收费是个坏主意。Tugce 和同事 Sarah Wang 在 8 月写过,应用应该把价格定在它能可靠衡量、说得清归因、守得住的最高一层价值上。两人访问了 50 位有技术背景的 AI 买家,27 位更喜欢和具体工作绑定的点数,只有 14 位更喜欢按 token。按 token 报价,等于提醒客户拿你的应用去和原始算力比,而算力每个季度都在变便宜,把自己的价格钉在这个往下掉的东西上,只会越收越薄。点数也不是万能的,Tugce 的话说得很直接:点数是一种货币,不是价值的尺度,关键在于一个点数到底买到了什么。
我自己的一点思考
先说我担心的几件事。Tugce 举的 Harvey、Clay、Decagon,都是各自领域里跑在前面的公司,它们能证明一个应用怎样守住溢价,却回答不了大多数没跑到前面的应用怎么办。一个功能单薄、输出就是一段文字的 AI 工具,既没有可以积累的工作流,也没有别人拿不到的数据,很难靠这些办法立起来。另外这场比赛没有终点。Repsol 那次盲测是 2023 年底的事,当时的 Copilot 和内部原型,到今天已经是另一个样子,客户下次再比,会重新问一遍同样的问题。还有一点,证明价值本身要花成本,每次成功完成一件事的完整成本、和客户自己动手的对比,对一个刚起步的小团队并不轻松,样本和人手都不够。
但我仍然看好这条路,因为它要求的东西,恰好是做得越久越容易积累的。每完成一次工作,评测会更扎实,对客户的了解会更深,上下文会更准,算出来的成本也会更清楚。这些全都归应用公司所有,客户从头自己做是拿不到的。Tugce 收尾的那句话很不客气:模型每进步一次,客户手里的替代方案就好一截,应用的优势得拉开得比这更快,溢价才守得住。这句话听上去是压力,我读出来的却是一个很具体的工作方法,把差距当成每个季度都要盯的数。
想象一个做客服 AI 的团队,季度复盘时不先看收入,而是先看一张表。表上是同一批客服对话,客户自己拿最新的模型做,每成功解决一次要花多少钱,自己的产品做又要花多少钱,这个差距比上个季度是变大了还是变小了。差距在变大,价格几乎不用愁;差距在变小,降价也救不了多久。把溢价看成这样一张每季度更新的账,而不是一个定下来就不动的数字,我觉得才是这位合伙人真正想说的事。
本文由人人都是产品经理作者【深思圈】,微信公众号:【深思圈】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议
- 目前还没评论,等你发挥!