


 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
万字大白话解释大火的“JEV”模型是啥,相比传统LLM区别在哪?(内含对应产品演示和小型评测)


当所有人都在卷大模型对话时,OpenAI 老兵却反其道而行,做出了一个「不说话」的模型 JEV。它不生成文本,只输出类型化的决策和概率,上线首日 API 就被挤爆。本文从创始人背景、核心原理到与 LLM 的本质区别,用大白话讲透这个「机器原生智能」新物种,以及它为何可能成为 Agent 时代的「快判断层」。
哇!一打开我的黑色大叉叉软件,推特里面就全部是JEV相关的推送,你敢信?有人说这是新世界的大门,上线第一天官方 API 直接被开发者挤爆宕机,Vercel 自己统计说 24 小时内他们 AI Gateway 里大概 13% 的付费团队都调用了这玩意。想必在座的各位读者也非常好奇,这个JEV到底是一个什么玩意?
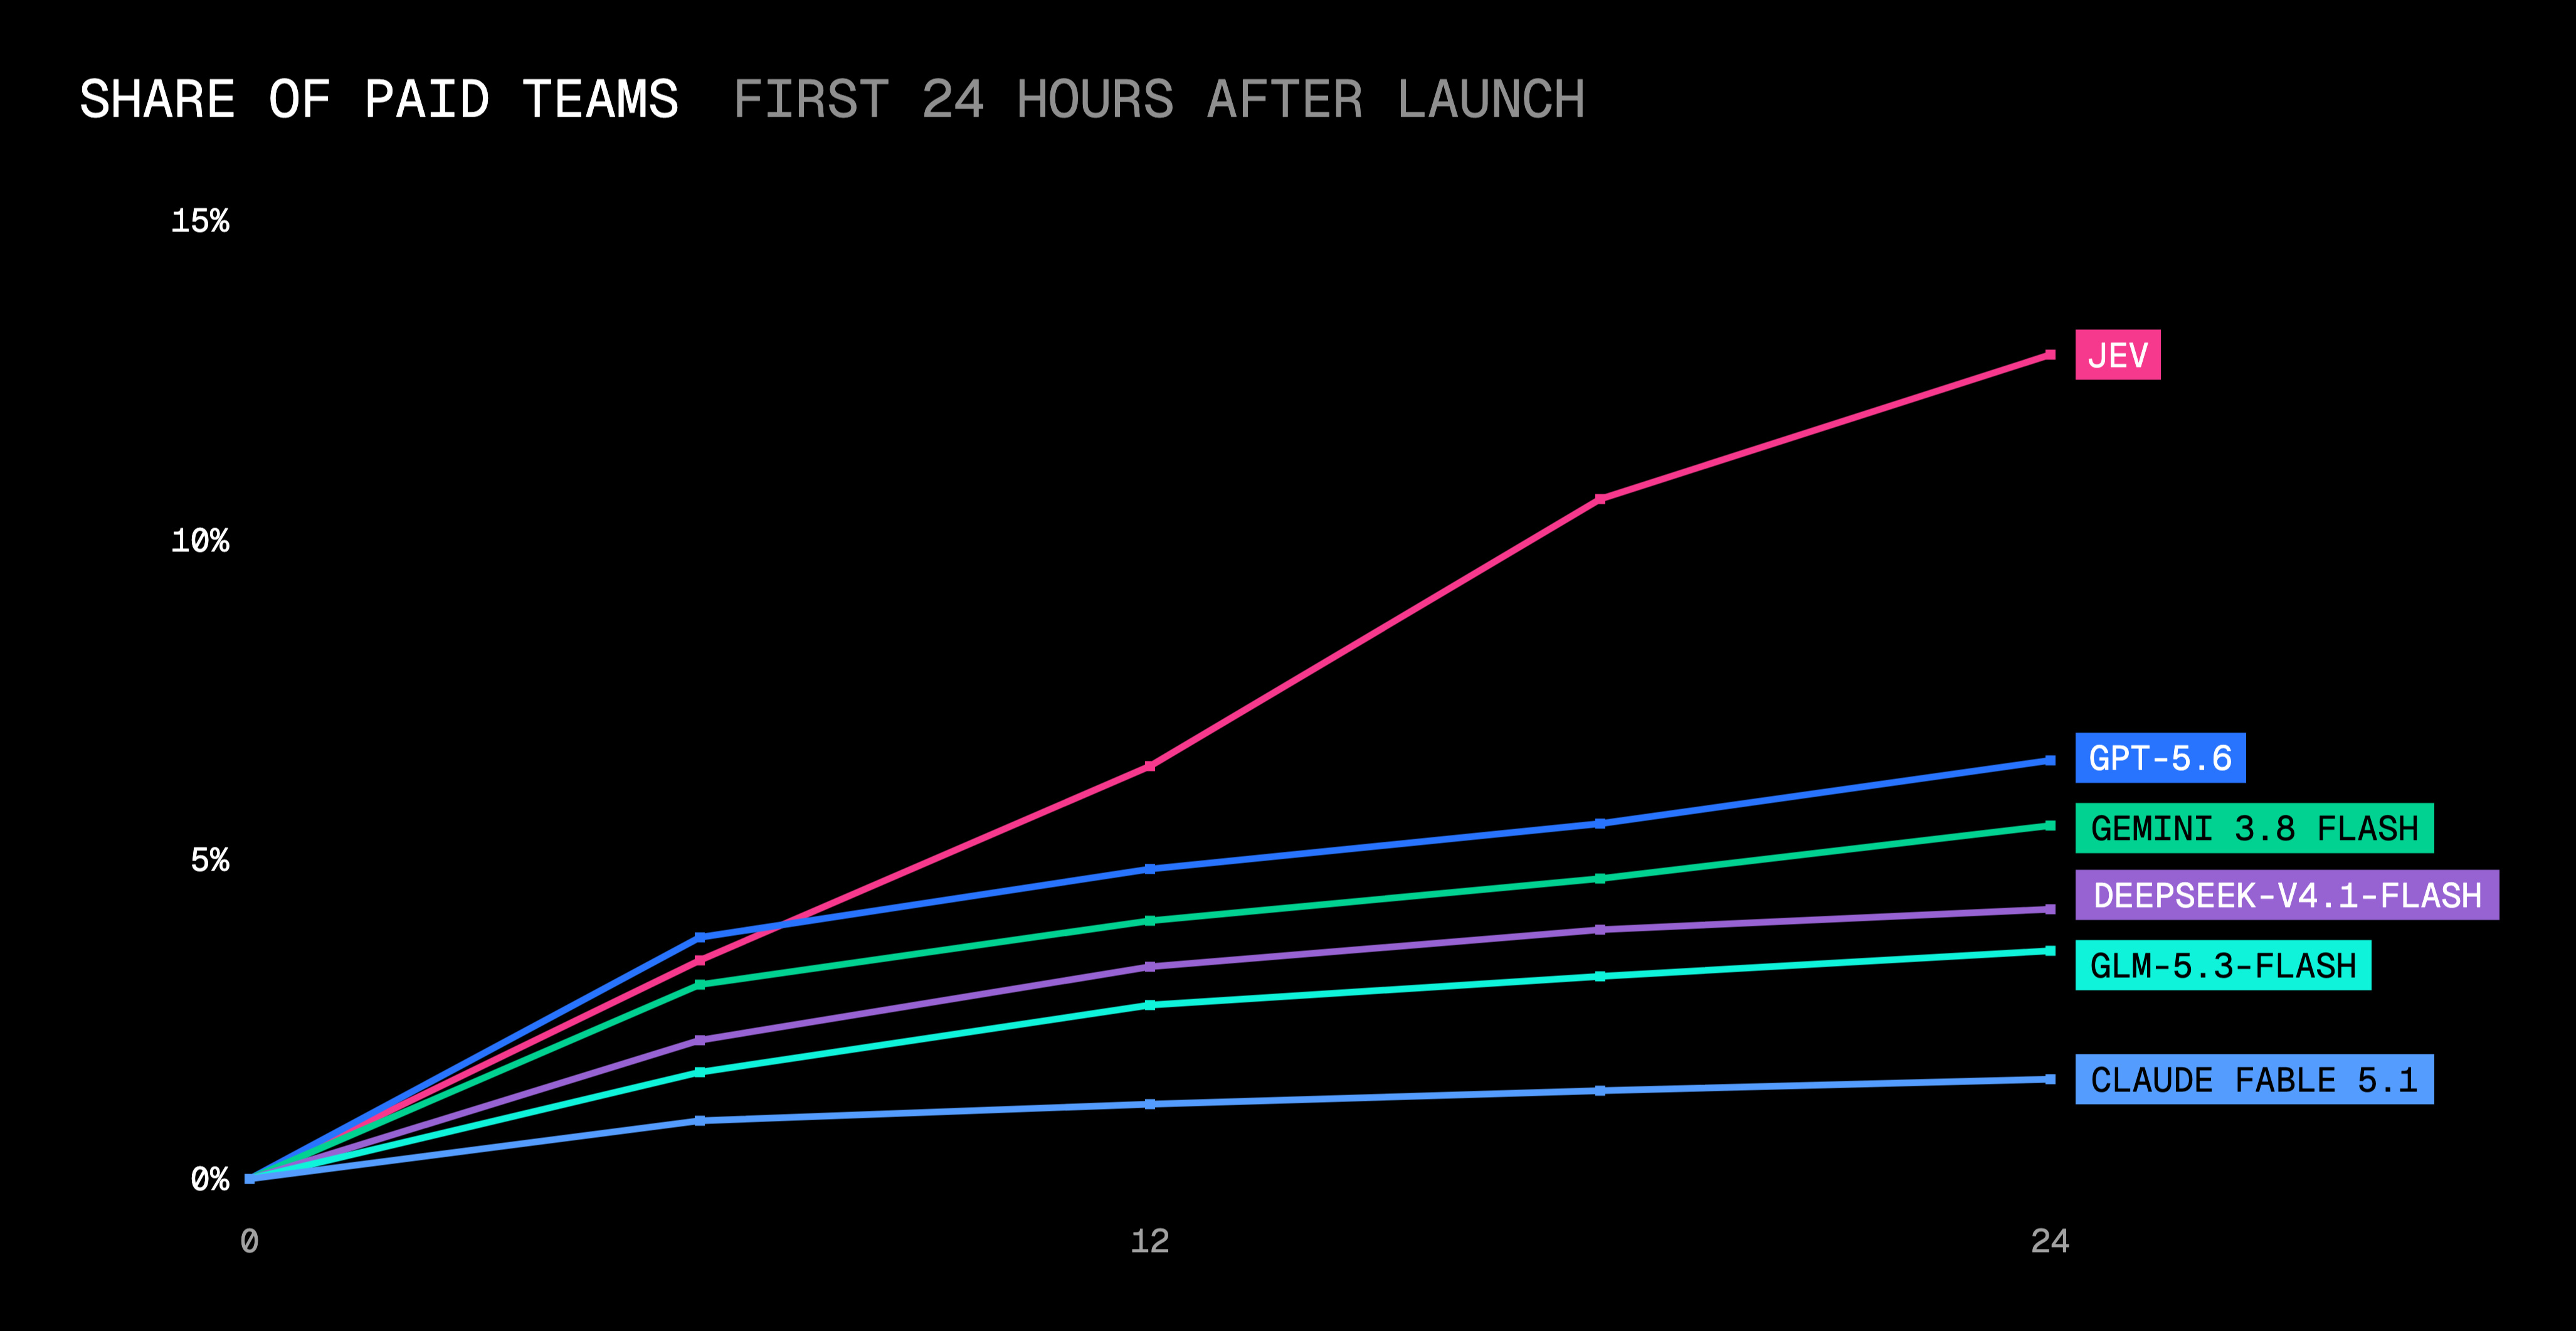
来源:Vercel 官方博客。这里用平台公开统计展示关注度。
在刻苦钻研相关文章,把官方博客、文档、评测站翻了个底朝天,最后自己仿写了小 Demo 之后,今天我就直接给大家用大白话讲透彻,讲明白,不多bb直接开始
先声明一下我的立场:我不是 TypeSafe 的托,文章里所有官方说的数字我都会标”官方自测”,所有第三方测的我都会标来源,我自己测的我会标”我测的”。这三类数据的可信度不一样,大家心里要有数。
先从它的创始人的背景故事开始讲吧:
JEV的创始人叫做 Diogo Almeida。他创办了 TypeSafe AI 这家公司,主要的产品系列叫:System One Model(JEV 就是这个系列下的旗舰产品,也是目前唯一的一个)。
Diogo Almeida 是 OpenAI 的老兵(注意不是创始人,是早期核心研究员),更是广为行业熟知的 RLHF 的发明者之一,他参与打造的 InstructGPT 就是 ChatGPT 的前身,可以说是这波 AI 浪潮的奠基人之一。但他对当时在 OpenAI 中的成果却大失所望。按照他接受 TechCrunch 采访时的说法:我们手里握着”瓶中闪电”,却没什么用。他花了很多时间才想明白,出现这个问题的最大原因就是:
“行业一直在优化人类的语言,而计算机说的是另一种语言。”
所以他一个造出 chat bot 的人,两年前离开 OpenAI,转头就做了个”不说话”的模型。这个反差是我觉得整个故事最有意思的地方。
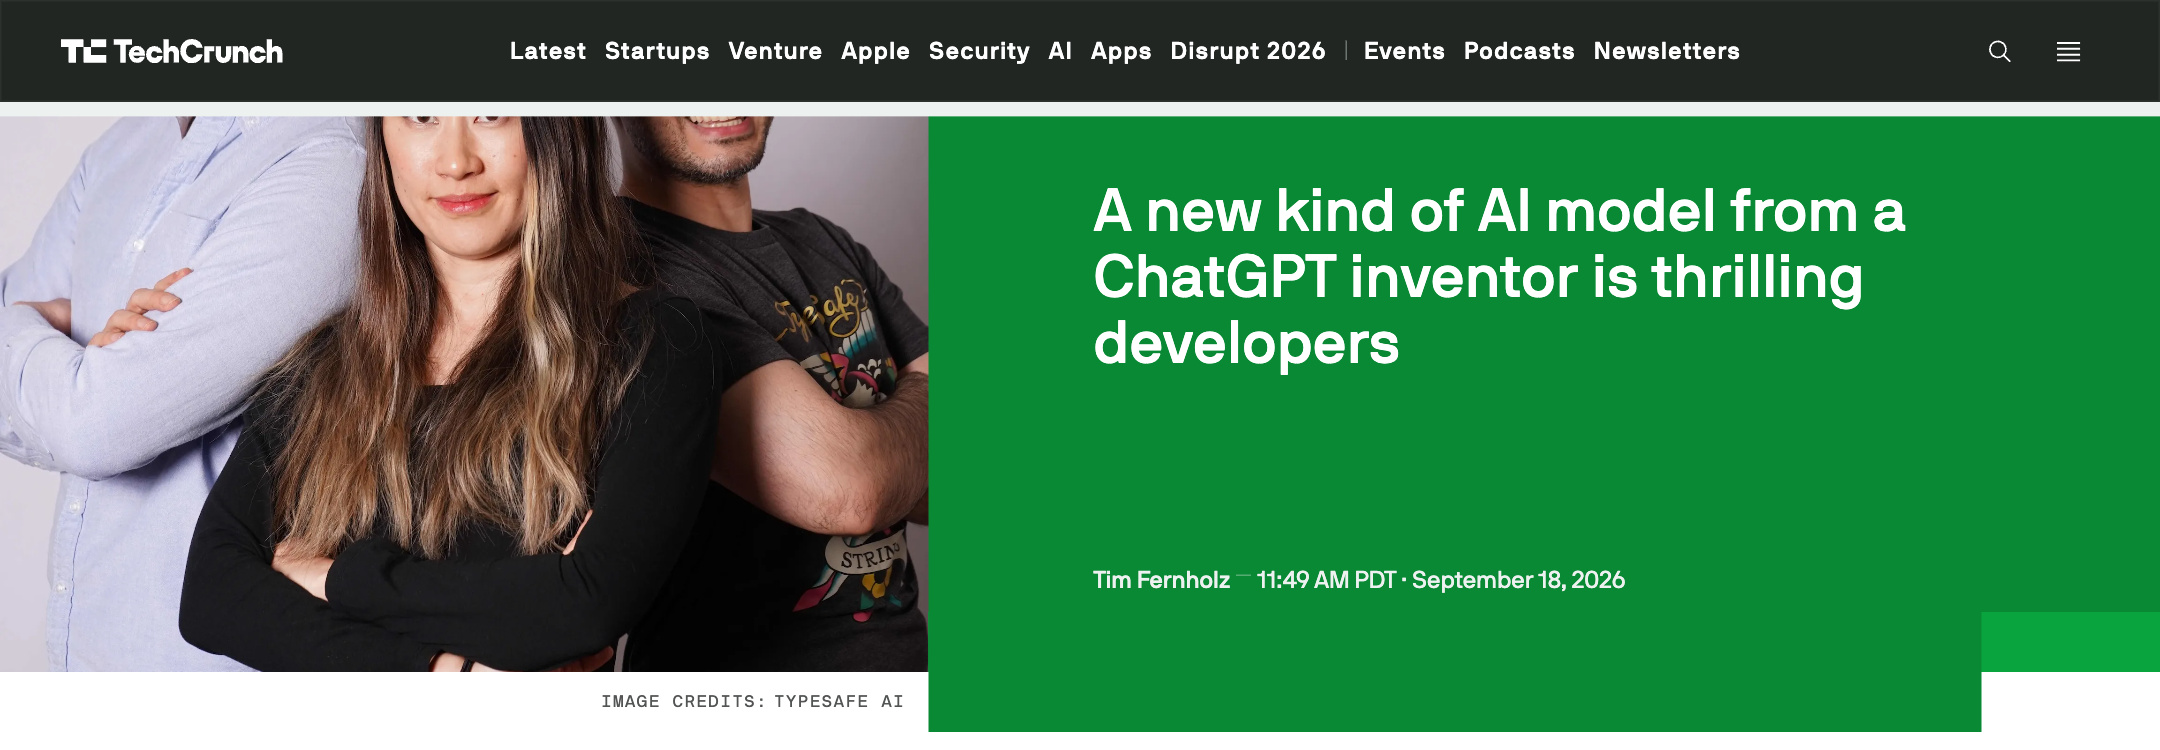
来源:TechCrunch 原文,真实网页截图。
还有几个小故事顺手讲了:
名字来自一个 19 世纪的经济学家。 Jev 取自 William Stanley Jevons。这哥们最有名的发现叫”杰文斯悖论”:蒸汽机效率提高之后,煤的消耗量不降反升,因为便宜了大家用得更多了。TypeSafe 给模型起这个名字,等于把自己的商业赌注写在脸上:智能便宜一个数量级,用量就会爆炸几个数量级。这个我们后面讲成本的时候会再回来。
他最得意的赌注不是 RLHF。 采访里他说,很早就押注所有训练数据都自己造(纯合成数据),他认为这是他人生中最好的赌注之一,比这次发布更好,甚至比 RLHF 更好。同时他对模型架构守口如瓶,外面有人怀疑 Jev 是建在某个开源 LLM 上的,但没人能证实。
对前沿实验室的吐槽。 被问到 TypeSafe 算不算 frontier lab 时,他的回答大意是:前沿实验室的主要产品是恐惧或者炒作,他希望自己的主要产品是智能。考虑到他自己就是从 OpenAI 出来的,这话挺有火药味。
好,故事讲完,进正题。
一、JEV 到底是个啥
首先要说明的是:就像大型语言模型一样,System One 模型也能理解自然语言输入。但是和 LLM 不同的是:
它返回的是经过类型化的决策和概率信息,而不是生成的文本。
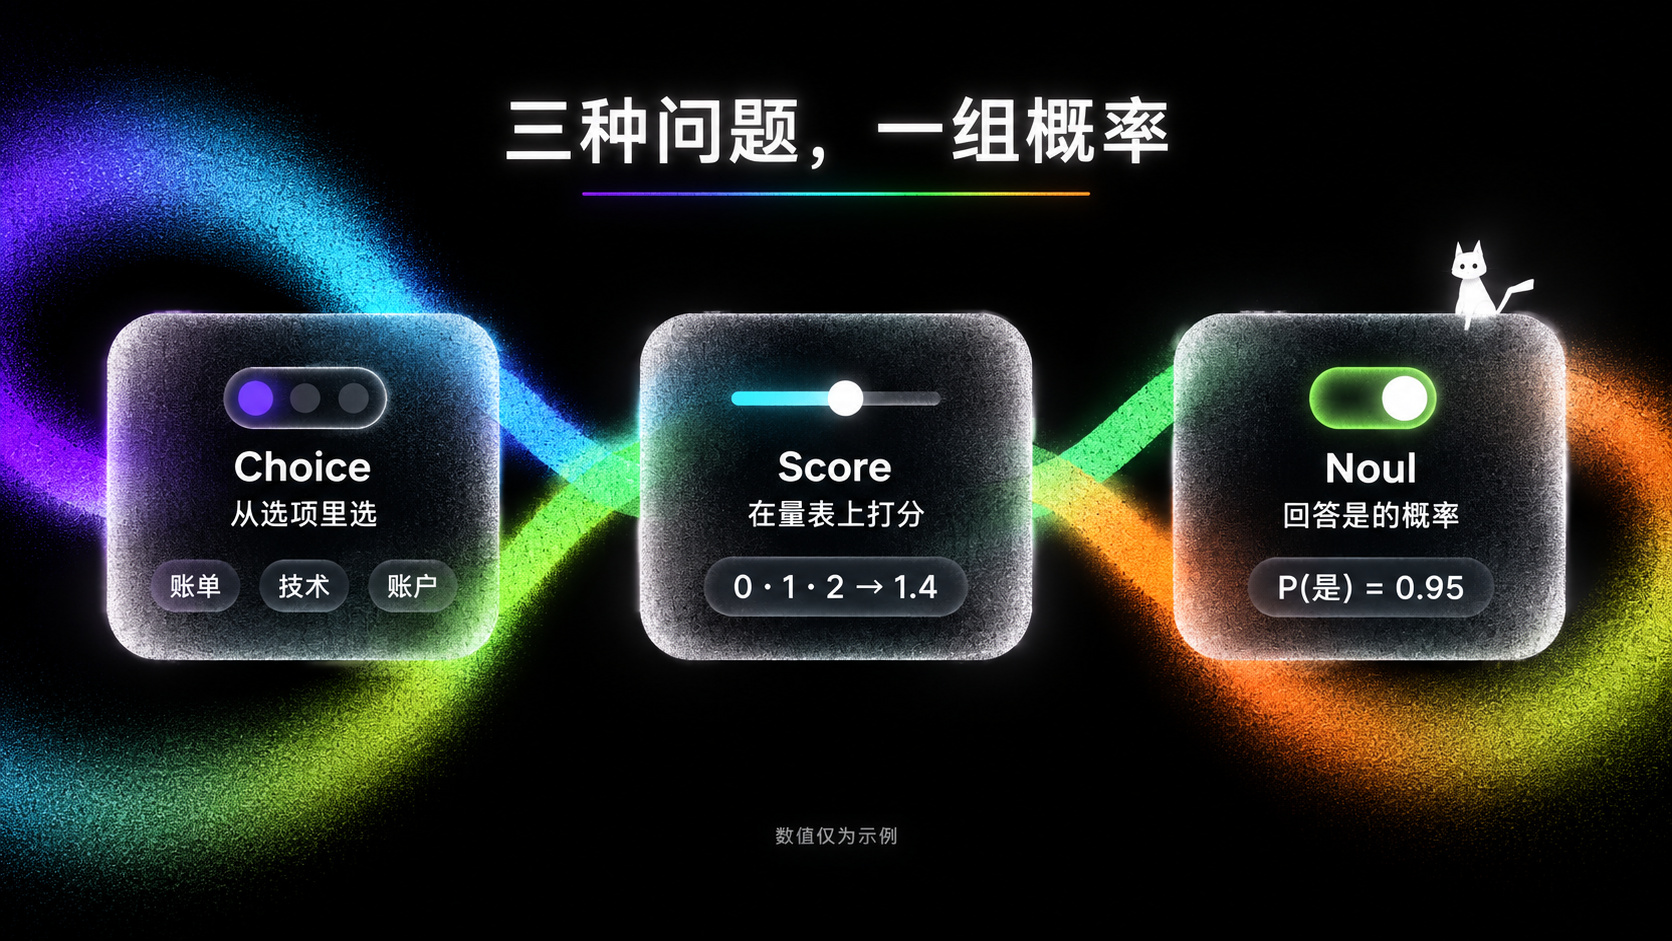
System One(这里指的是 JEV)模型不写回复、不生成代码、不解释自己的推理过程。你能问它的所有问题,都必须是下面三种基本类型(官方叫 primitives)之一:
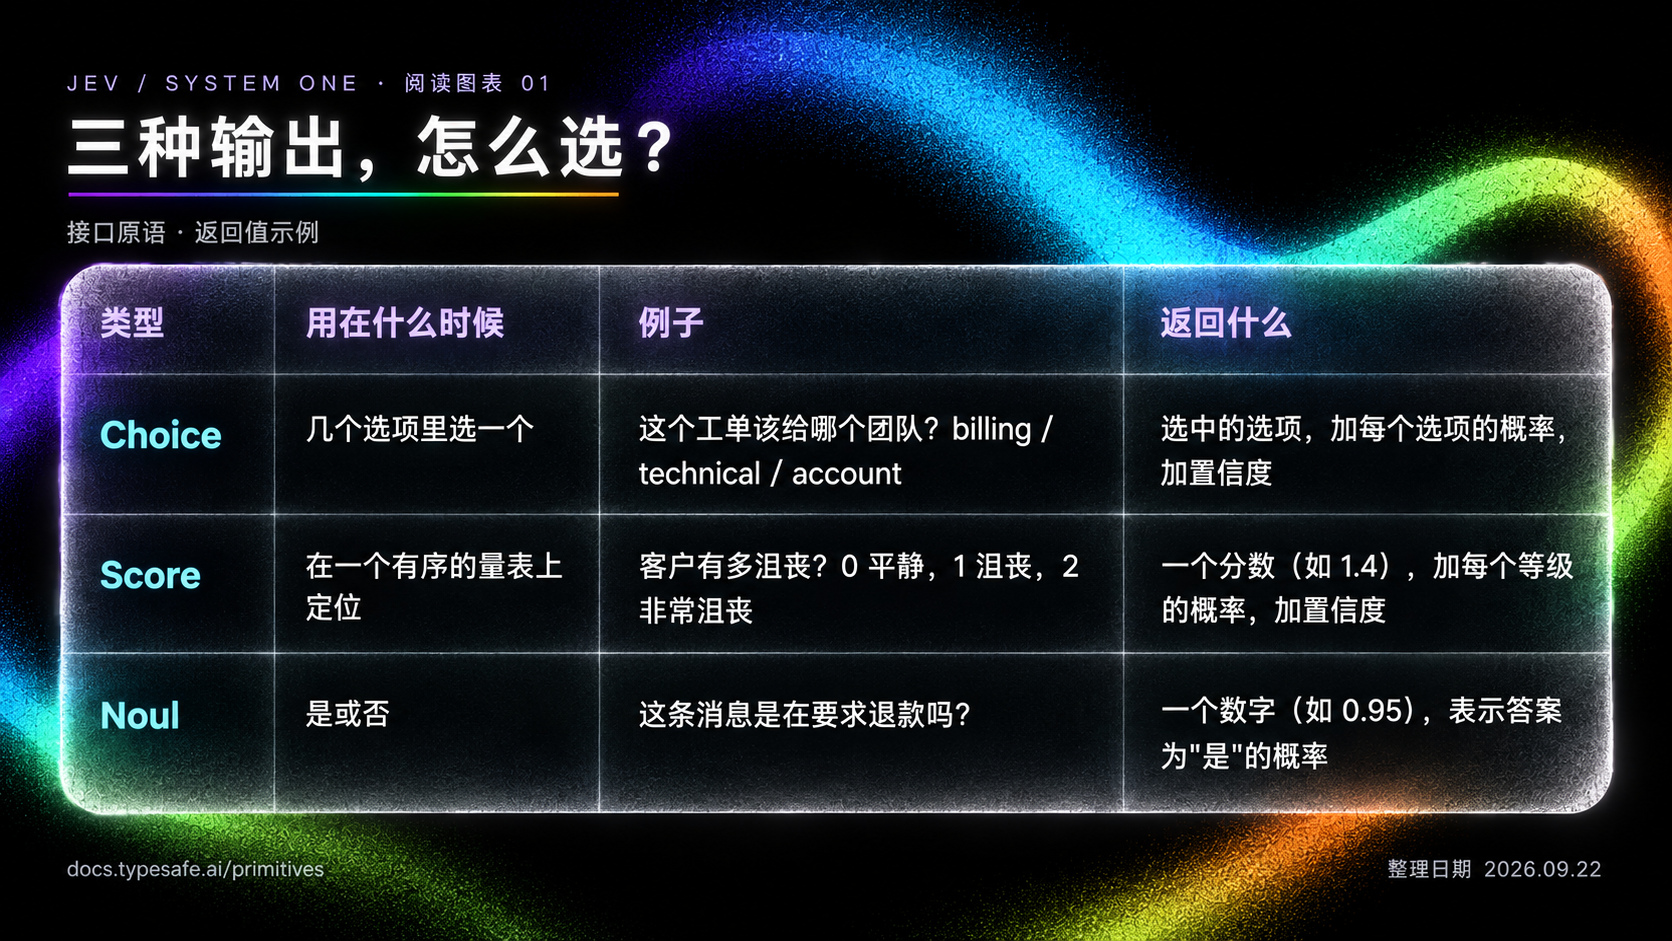
两个细节提一下,都是社区里有人踩过的坑:
- Noul 返回的不是”是”或”否”,是一个概率。 0.95 的意思是”95% 的可能性是在要求退款”。它没有单独的 confidence 字段,返回值就是事件为真的预测概率;接近 0.5 表示预测更难偏向任意一侧。(顺便说一下哈,Noul 是官方生造的词,不是 Bool 的错别字,可以理解成”带概率的布尔值”。)
- Score 的 1.4 是加权平均,不是某个档位。 量表只有 0、1、2,模型先给每档一个概率,比如 0.1 / 0.4 / 0.5,算出来 0×0.1+1×0.4+2×0.5=1.4。坑在于:如果模型觉得客户要么很平静要么很愤怒(0.5 / 0 / 0.5),平均也是 1.0,看起来像”中等沮丧”,但其实恰恰不是中间状态。所以重要决策别只看平均分,要看各档概率的分布。
一次调用的完整过程是这样的:
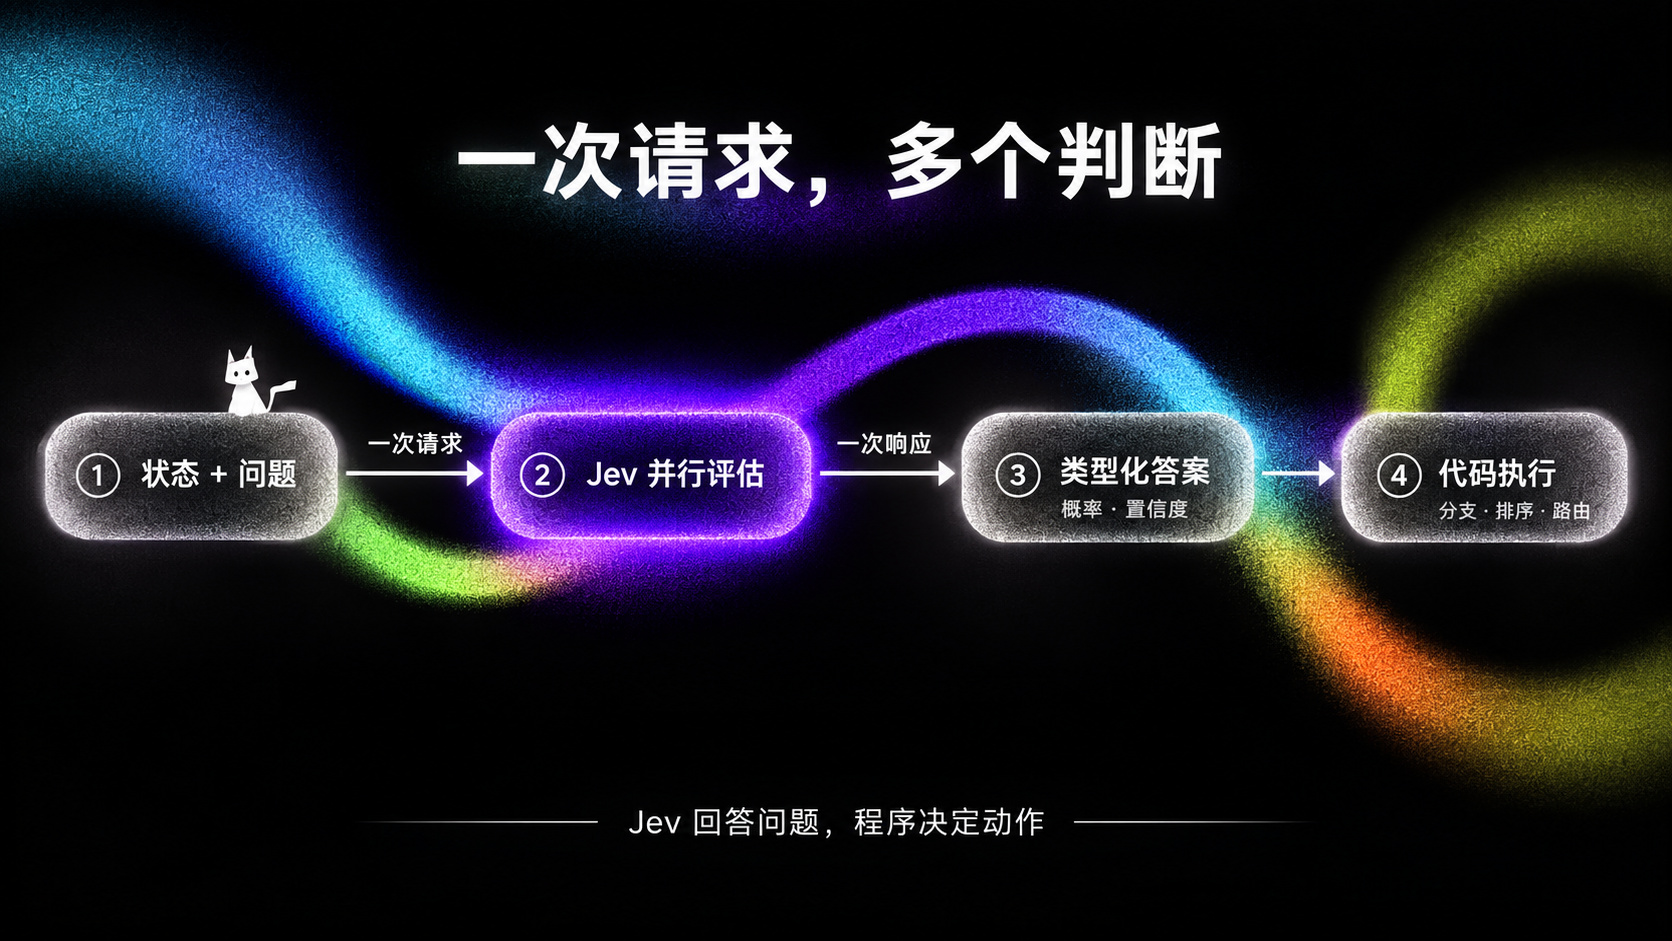
接口流程示意接口流程示意;Choice / Score 另带 confidence,Noul 直接返回事件概率。
重点是箭头上那两个词:一次请求、一次响应。 不管你问 1 个问题还是 20 个问题,都是打包一次发过去,所有答案同时算出来一起回来。这个”同时”是后面成本和速度两节的核心,先记住。
还有一个隐藏的点:这张图里没有”对话历史”。每次调用都是独立的,模型不记得上一次发生了什么。想让它知道”前车已经连续减速 3 秒”,得由你的代码算好、写进状态里。记忆和上下文的管理责任,从模型转移到了你的程序。
其实从这里就能够窥得端倪。TypeSafe 并不是为了打造一个能处理所有事情的模型,他想做的是用在工程或者生产环境中,代码要能够快速做出决策并迅速采取行动。官方的判断是:在大规模自动化过程中,AI 与 AI 之间、AI 与软件之间的交互将占据主导地位,而且机器交互比聊天交互更为重要且更为高效(TypeSafe 将其称为”机器原生智能”)。
它解决了一个比较具体的当前存在的工程问题:
Agent 里面很多模型的调用不全是为了生成答案,而是为代码做一次判断。”这封邮件归哪类””这个请求路由给谁””这条输入是不是越狱攻击””现在该不该变道”。这些问题不需要写一段话来论证,需要的是一个快速、可靠的判断。用 LLM 做这些事,相当于每次有人问你 2+2,你都要写一篇小论文再回答。
所以它是生态里的新角色,而不是 LLM 的替代者。LangChain 官方博客给它的定位也是这个:开放式推理和生成交给 LLM,过程中的快速结构化决策交给 Jev。它是 agent 系统里面重要的一块拼图”快判断层”!
顺便解释一下 System One 这个名字。它出自 Kahneman 那本《思考,快与慢》:人脑有两套系统,系统 1 快、自动、凭直觉(看到前车刹车灯亮脚就移过去了),系统 2 慢、需要集中注意力做推理(算 17×24)。现在带推理模式的 LLM 就是典型的系统 2 工具:逐字生成、一步步思考、能处理开放问题,但慢且贵。TypeSafe 想做的是机器版的系统 1。
不过 Kahneman 原书里系统 1 的另一面是”容易出错”,各种认知偏差都出自它。官方 FAQ 自己也承认这层含义,说他们认为机器版系统 1 可以做得比替代方案更可靠,”理由以后再讲”。注意:这是一个还没给出论证的主张,后面可信度那节我会专门掰扯。
LLM 和 JEV 的区别边界表:
这张表是官方博客里的,我把中文翻译修了一遍(原来机翻的有几处会误导人)。
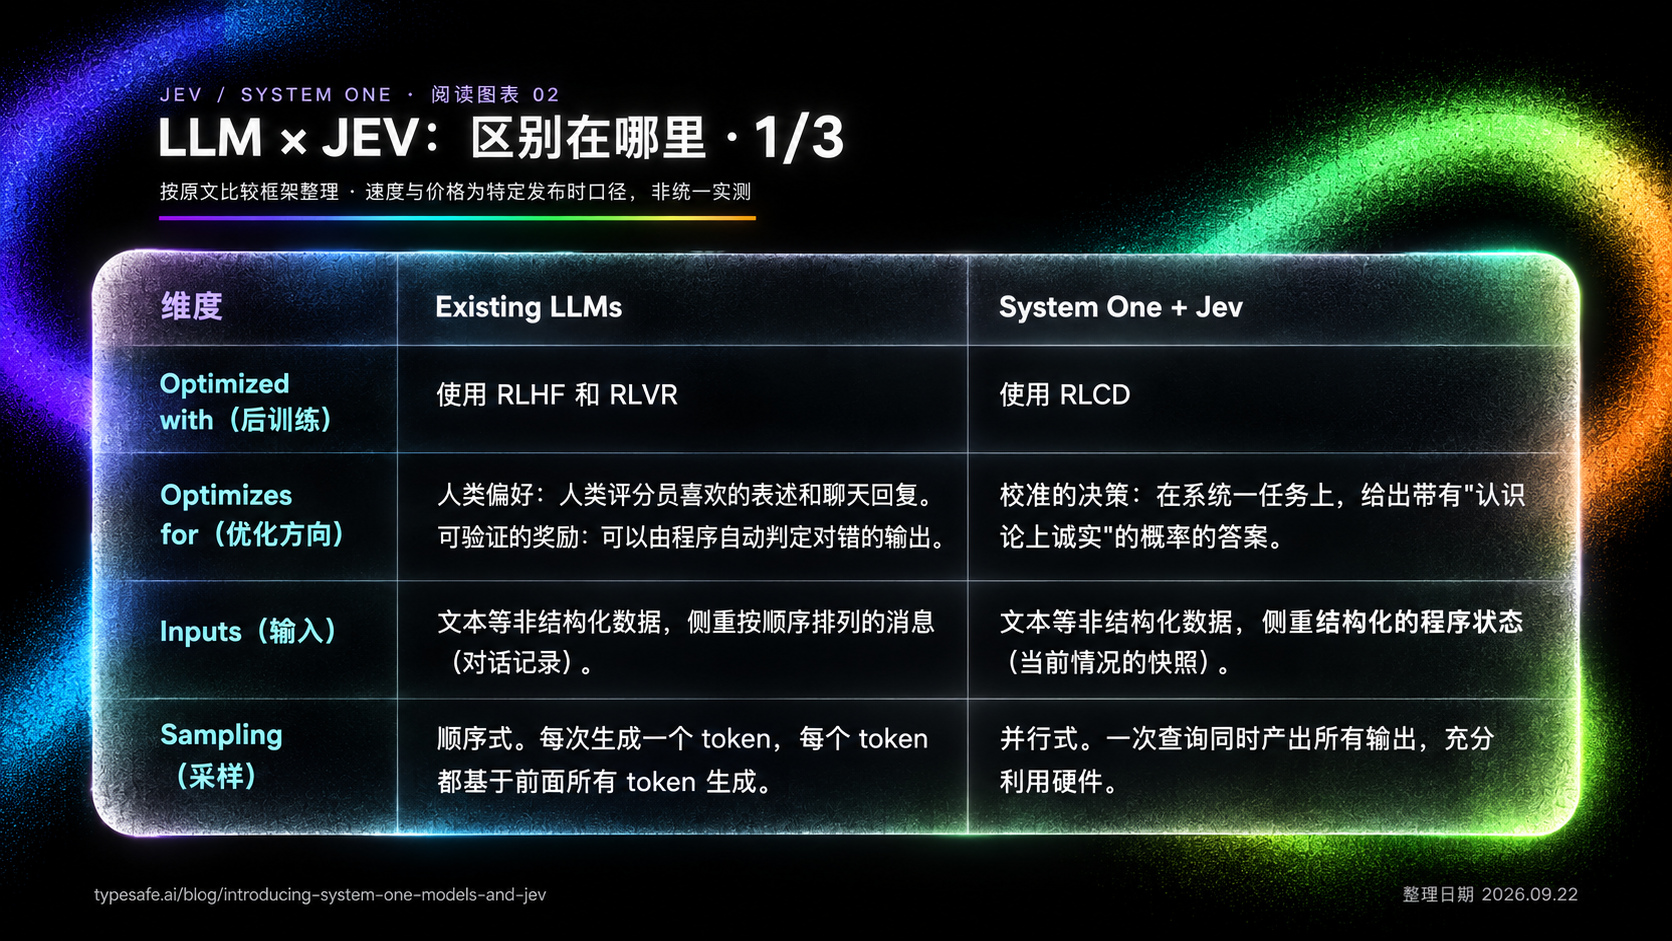
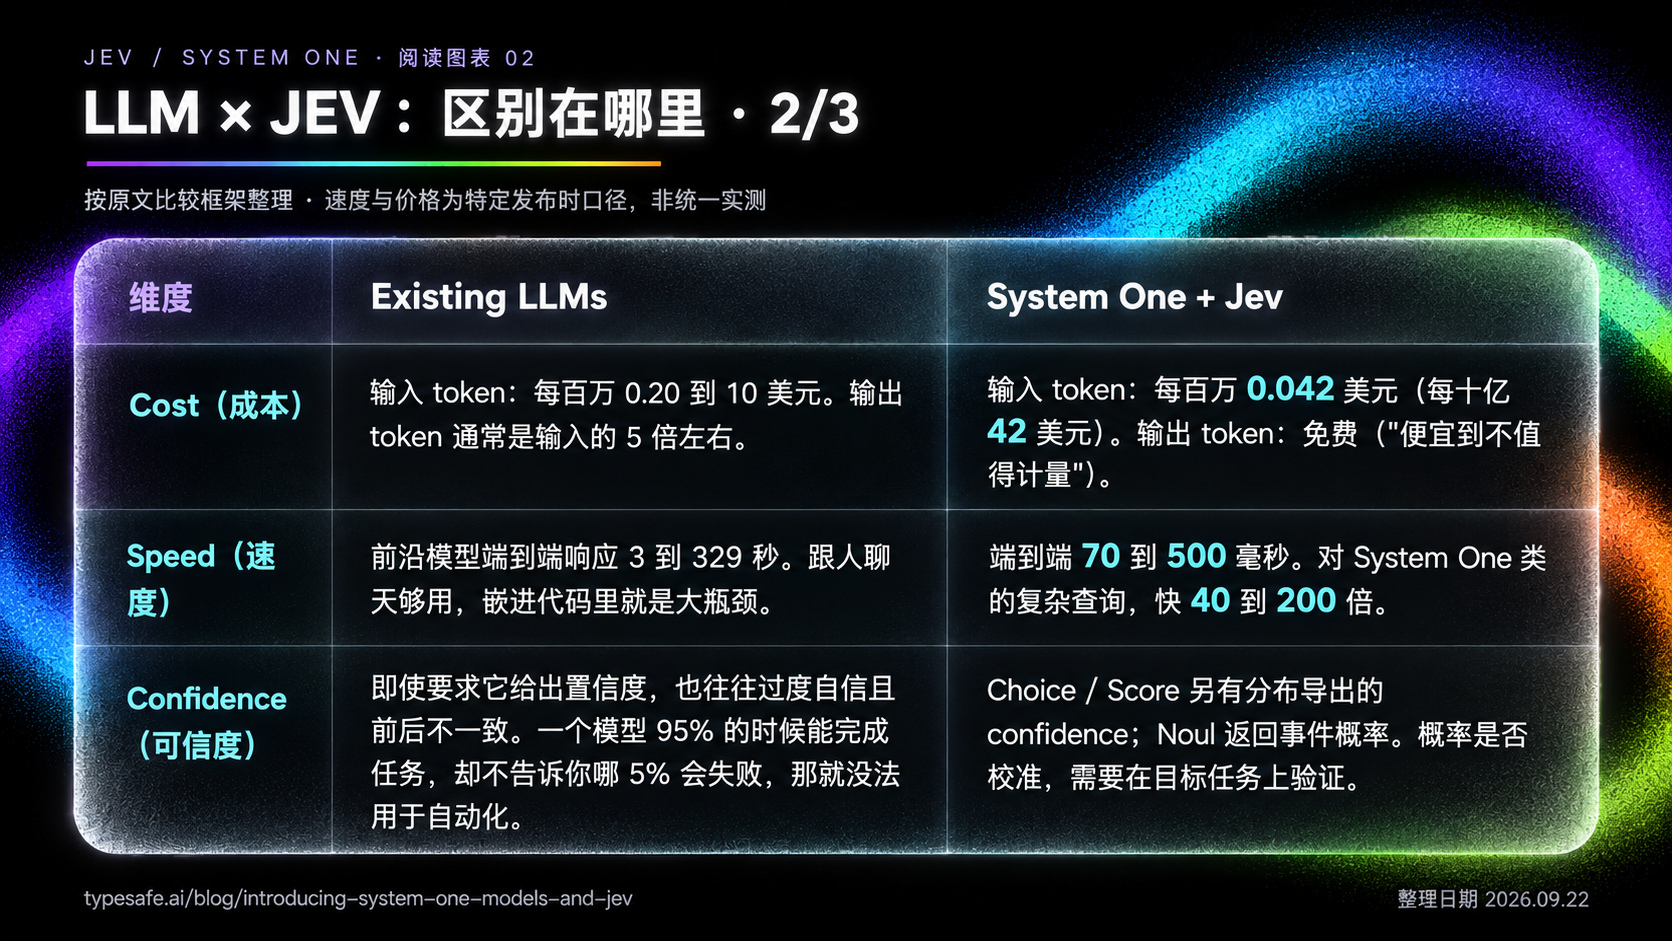
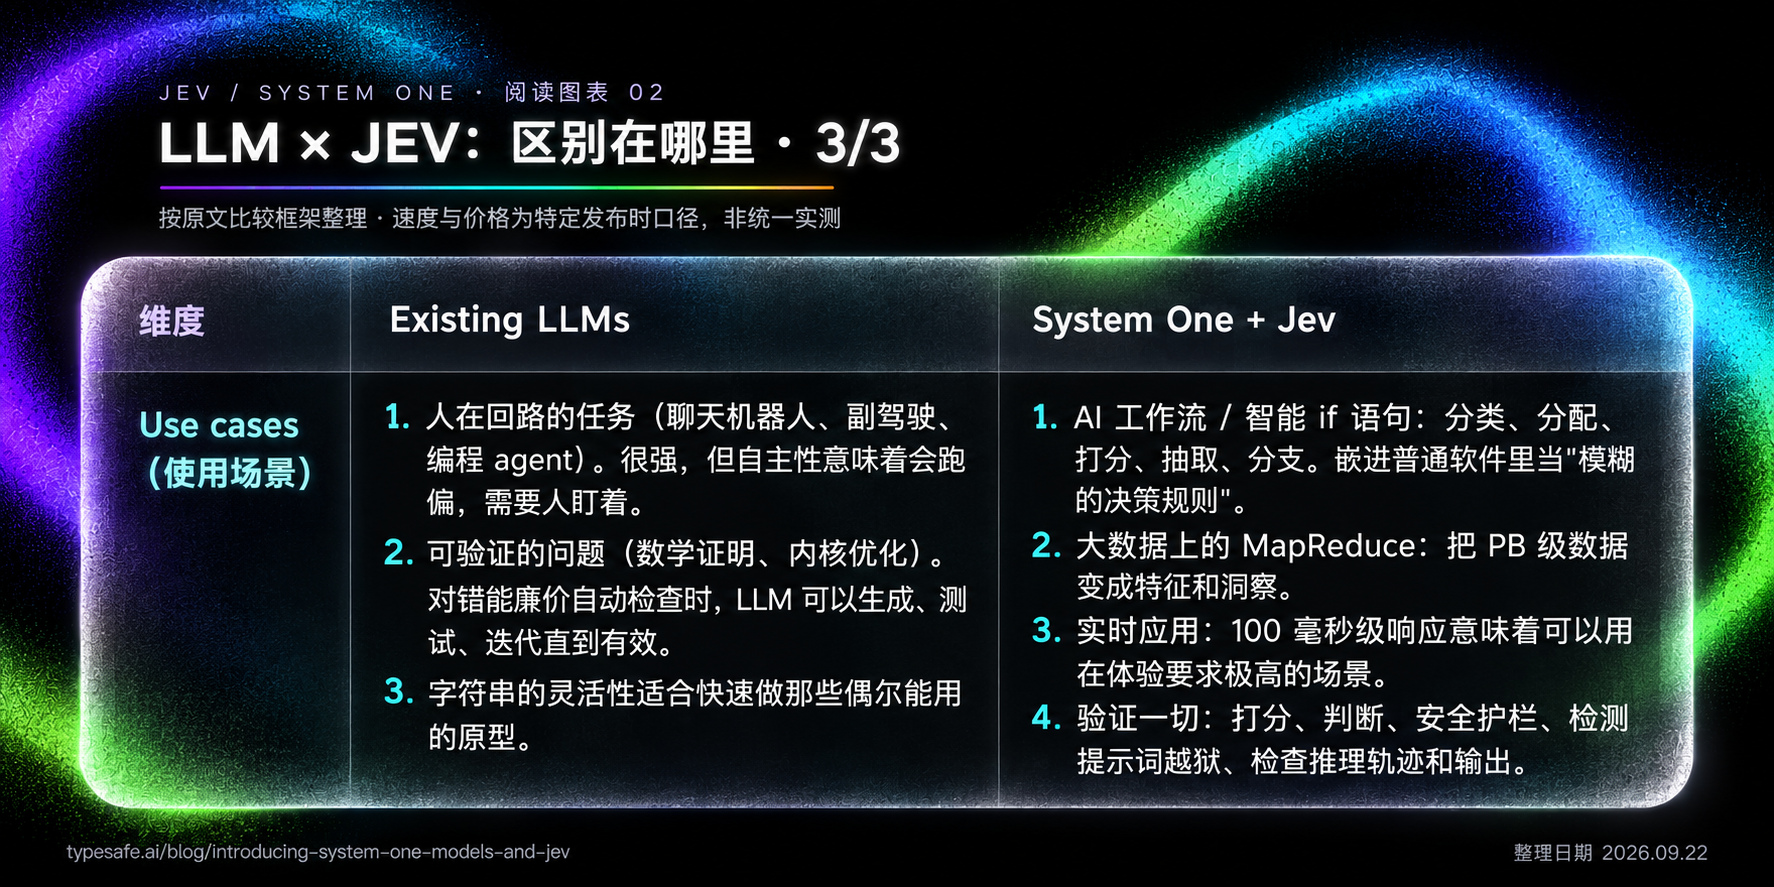
知道大家看到这个表一定会很懵,别急,别怕,带各位一块一块去解析!
1. 两个模型的后训练方法不同,且方向轻微不同
当前主流的 LLM:
使用的 RLHF:基于人类反馈的强化学习(Reinforcement Learning from Human Feedback)。我说白了,我白说了,就是”让人给 AI 的回答打分,AI 照着人喜欢的方向改”。过程三步:AI 对同一个问题写几个回答;人来评哪个更好;AI 记住哪种受欢迎,以后多写这种,重复几十万次。ChatGPT 能像人一样好好说话就靠它。
它的毛病是:AI 学到的是”让人满意”,不是”说对的话”。人往往更喜欢自信、流畅、顺着自己说的回答,所以 AI 也学会了讨好,学会了没把握的时候也说得斩钉截铁。
RLVR,基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards)。就是让 AI 大量做有标准答案的题(数学、编程),对了加分,错了不加分,它自己摸索出怎么解题。现在那些”先想很久再回答”的推理模型主要就是这么练出来的。
它的毛病是:只能练有标准答案的东西,”这封邮件得不得体”没法自动判分;而且只看最后对不对,蒙对了也给分,同样没教会 AI 诚实地说”我不确定”。
System One + Jev:
而 RLCD 是什么呢?面向校准决策的强化学习(Reinforcement Learning for Calibrated Decisions)。这是 TypeSafe 为训练 Jev 提出的方法,具体技术细节没有公开(没论文、没技术报告),最明白的话就是:不光奖励 AI 答对,更奖励它“把握程度说得准”。
比如:像训练一个天气预报员。你不是看他哪天报对了,而是长期记账:
- 他说“90% 下雨”的那些天,是不是真有九成下了?
- 他说“60% 下雨”的那些天,是不是真有六成下了?
对得上就奖励。两种毛病都要罚:明明没把握却说 95% 的(盲目自信),和明明很有把握却只敢说 60% 的(畏畏缩缩)。理想目标是让他说的概率更接近长期频率;到了一个新任务里,仍要重新检验,不能直接当真。
三个放一起就很清楚了:
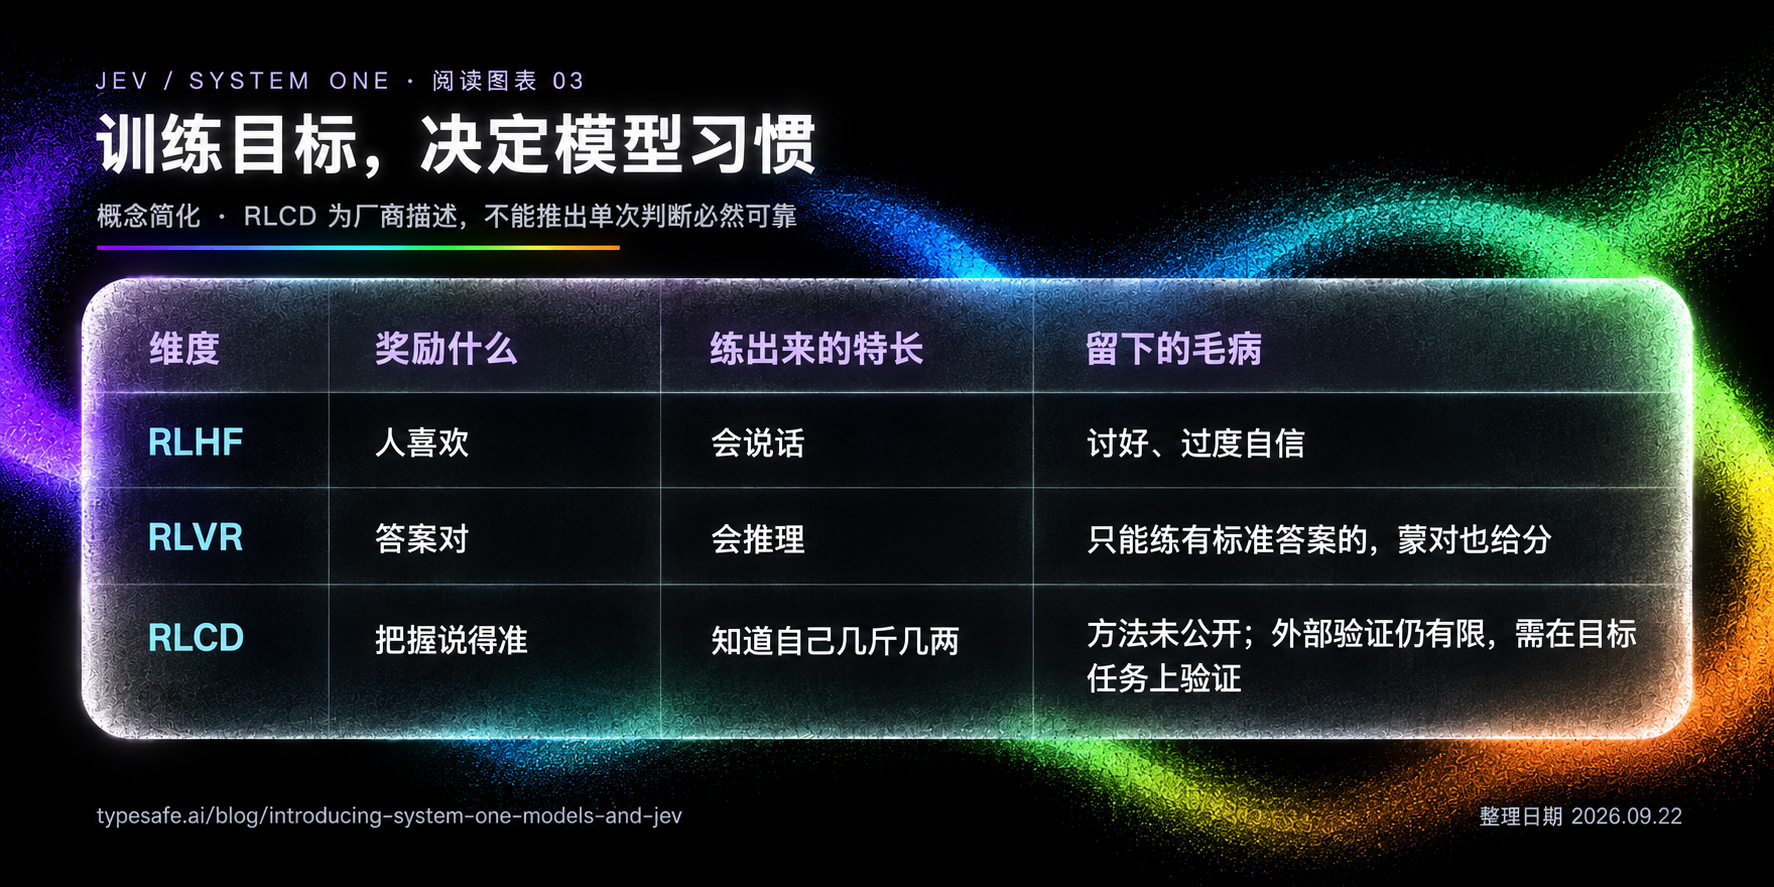
看出来了吗?LLM 校准差不是偶然,是训练目标的副产品:RLHF 和 RLVR 的目标本身不保证概率校准。Almeida 的叙事逻辑就是:我当年发明的 RLHF 让模型学会了讨好人,现在我要做一个学会诚实面对不确定性的模型。
(如果之后询问的朋友多的话,我会单开一篇文章去拓展讲讲)
2. 输入的数据不同:两种模型都读文字,但各自擅长读的”文字长相”不一样。
当前主流的 LLM:
侧重按顺序排列的消息。简单理解为:LLM 擅长读聊天记录。 一条接一条、有先后顺序的消息,就好比:
用户:我的包裹坏了
客服:能提供订单号吗?
用户:A1024,我要退款
它的任务是接着往下说。
System One + Jev:
Jev 擅长读”此刻的情况汇总”。像一张填好的表,外加几段自由文字,像这样:
订单号: A1024
金额: 89元
历史退款次数: 0
客户留言: “杯子收到就是碎的,我要退款”
它的任务是看完这张表,回答你提的几个问题。
打个比方:LLM 像接电话的客服,听你一句一句说,边听边回。Jev 像看病历的医生,拿到一张写好的病历单,扫一眼直接下判断,不跟你聊天。
那句”非结构化数据,但侧重结构化状态”为什么不矛盾:很简单,因为两边吃的都是文字(所以都叫非结构化),Jev 也能读懂”杯子收到就是碎的”这种大白话,这是它需要智能的地方。区别只在于它被专门训练成看”情况汇总表”,而不是看对话。
这里有个实用的限制,Flavio Copes 的深度解读里专门提到:state 里塞进和决策无关的内容越多,准确率越低。 官方自己也说这模型和别的模型一样会”context rot”(Chroma有专门一篇文章讲这个,我善心大发告诉你们吧:https://www.trychroma.com/research/context-rot)解决办法在你这边:只给一条工单打分的话就别把客户全部历史都塞进去,分类一段话就别把整篇文档都发过去,先用代码过滤。强调一下:Jev 目前每次请求最多 64k token,其中 state 加最长的问题不超过 32k,而且只吃文本。
3. 成本
当前主流的 LLM:
输入每百万 token 0.2 到 10 美元,输出通常是输入的 5 倍左右。这里很多人会不知道:为啥输出也要单独收钱,还更贵?
因为对 LLM 来说,”读”和”写”是两种完全不同的计算方式。读一段 1000 个 token 的文字,可以把这 1000 个 token 同时送进 GPU,一轮算完,GPU 最擅长这种大批量并行。但写就只能一个一个来:每个 token 都取决于前面所有 token,标准自回归解码要依次完成生成步骤。批处理、KV cache、推测解码和具体架构会改变执行效率,不能简单理解成每个词都从头重算;但顺序依赖仍是它和并行判断的关键区别。
来个生动无比的比喻:读一页书你扫一眼就完了,写一页字只却能一笔一笔写。是不是很真实?哈哈哈。
而且现在的推理模型回答前还要先”想”几千个 token,这些思考过程全按输出计费。Arize 转述了 NearHere 的一组测试:一个通用模型为了回答一个是/否问题,平均花了大约 910 个输出 token 在推理上,而 Jev 用了 85 个,而且不收钱。
System One + Jev:
Jev 不生成文本,输出只是在你预先定义好的选项上给概率。它读完输入之后,所有问题的答案在同一轮计算里一起出来,不存在”一个词一个词往外蹦”的过程。也就是说,Jev 只有“读”的成本,几乎没有“写”的成本。 你问 1 个问题还是 20 个问题,多出来的只是那几个问题本身作为输入的 token 费,输出端的计算量小到不值得单独计费。所以”便宜”和”快”其实是同一个原因,就是他TM直接放弃文本生成。
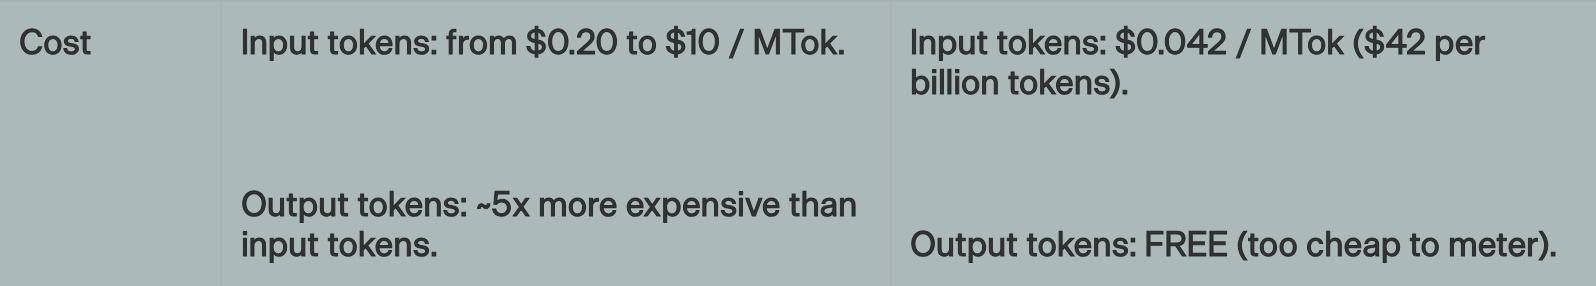
来源:官方发布文章,截图保留原始页面样式;价格核对于 2026-09-22。
换个更好懂的:每次决策多少钱。 每百万 token 0.042 美元对普通人没感觉,换算一下:官方基准上平均一次决策约 0.0004 美元,一万次决策约 4 美元。有人算过一个账:一个月 3200 万输入 token 的决策量,Jev 大概 1.34 美元;同样 3200 万输入 token,在每百万 10 美元和 1 美元的输入单价下,分别为 320 美元和 32 美元,输出费用还要另计。(数据是按公开价格算的模型,不是实测哈,Flowtivity 那篇自己也注明了。)
第三方实测的数据,比官方的 444 倍靠谱。 上线这一周其实已经有好几组独立测试:
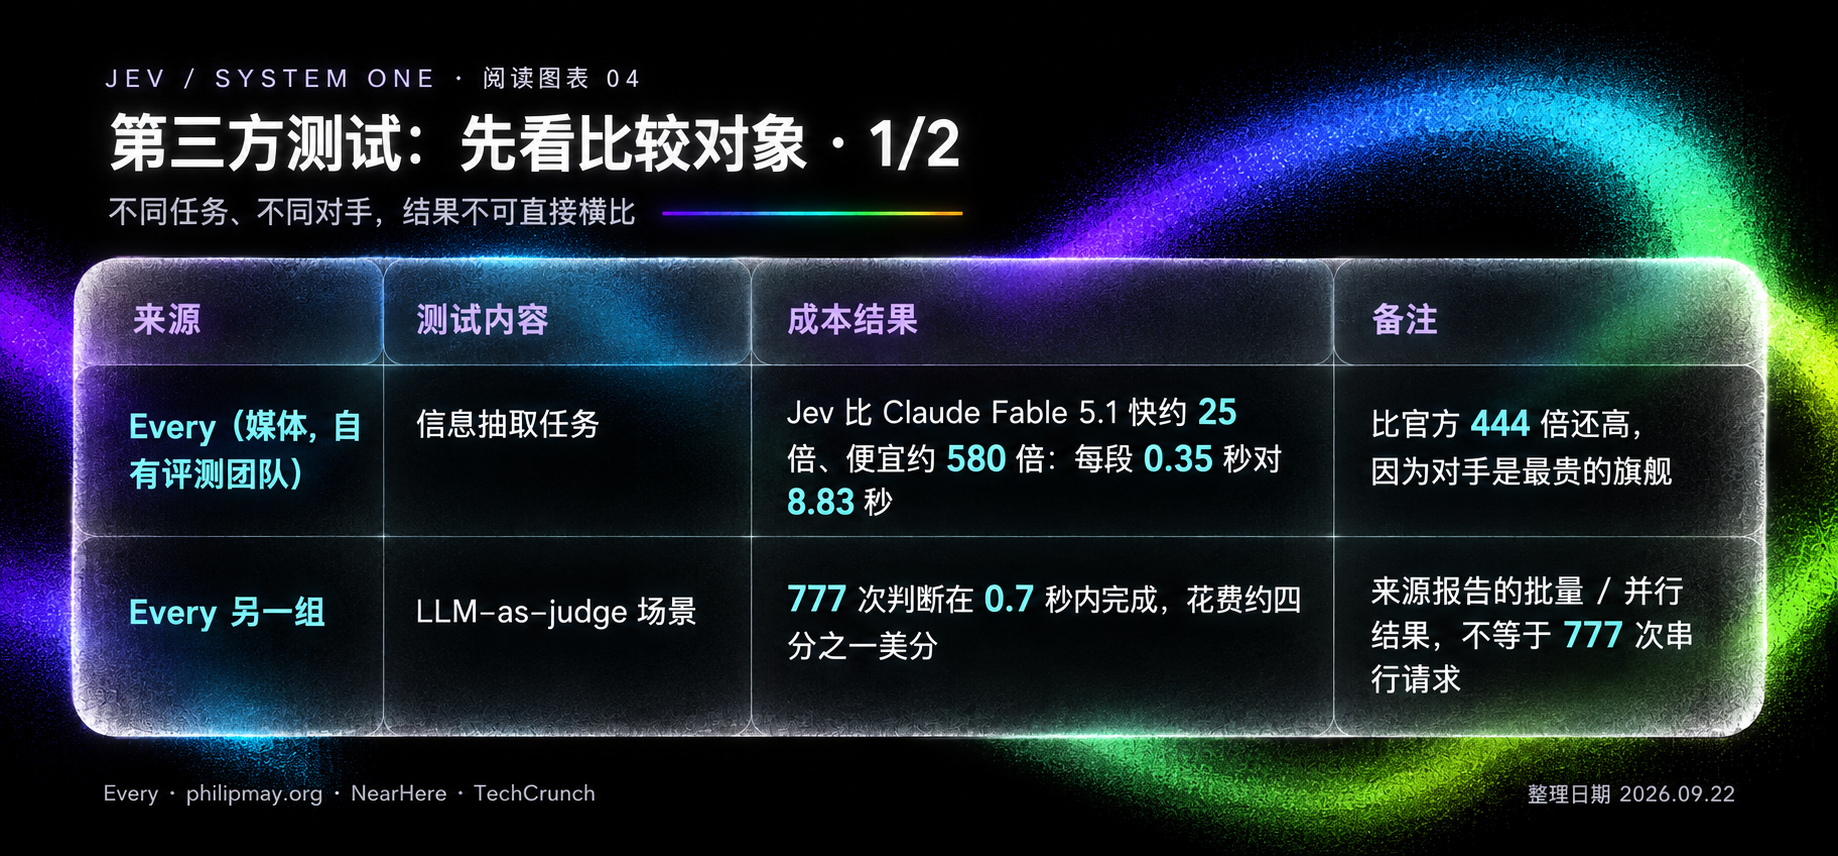
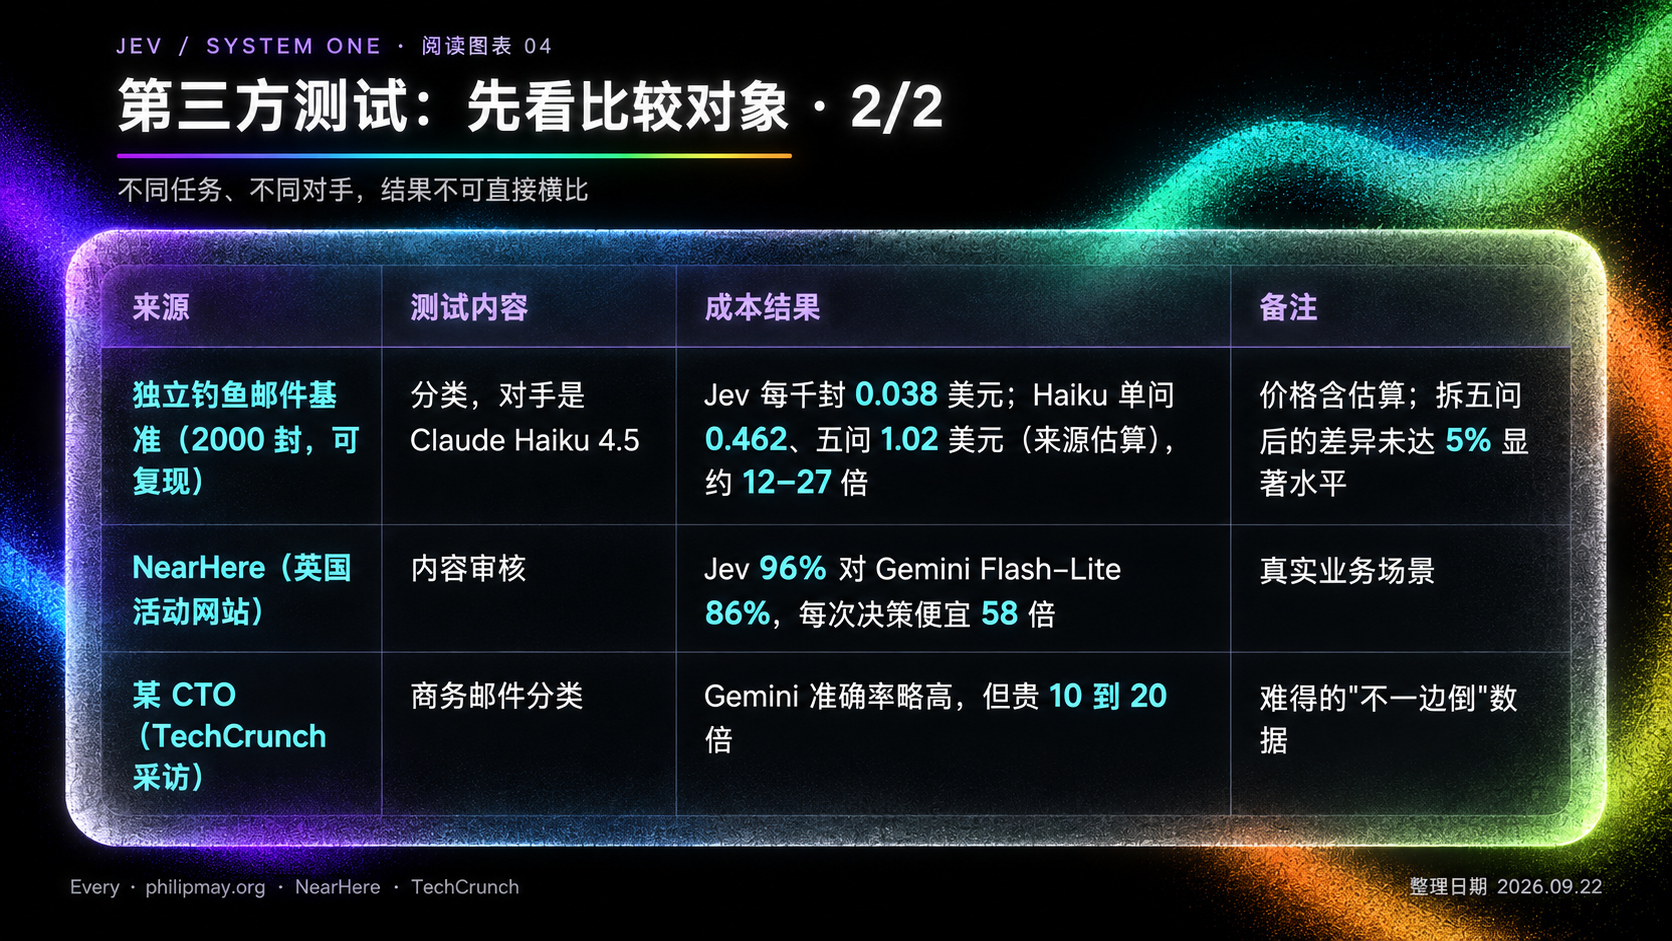
来源:Every 原文。
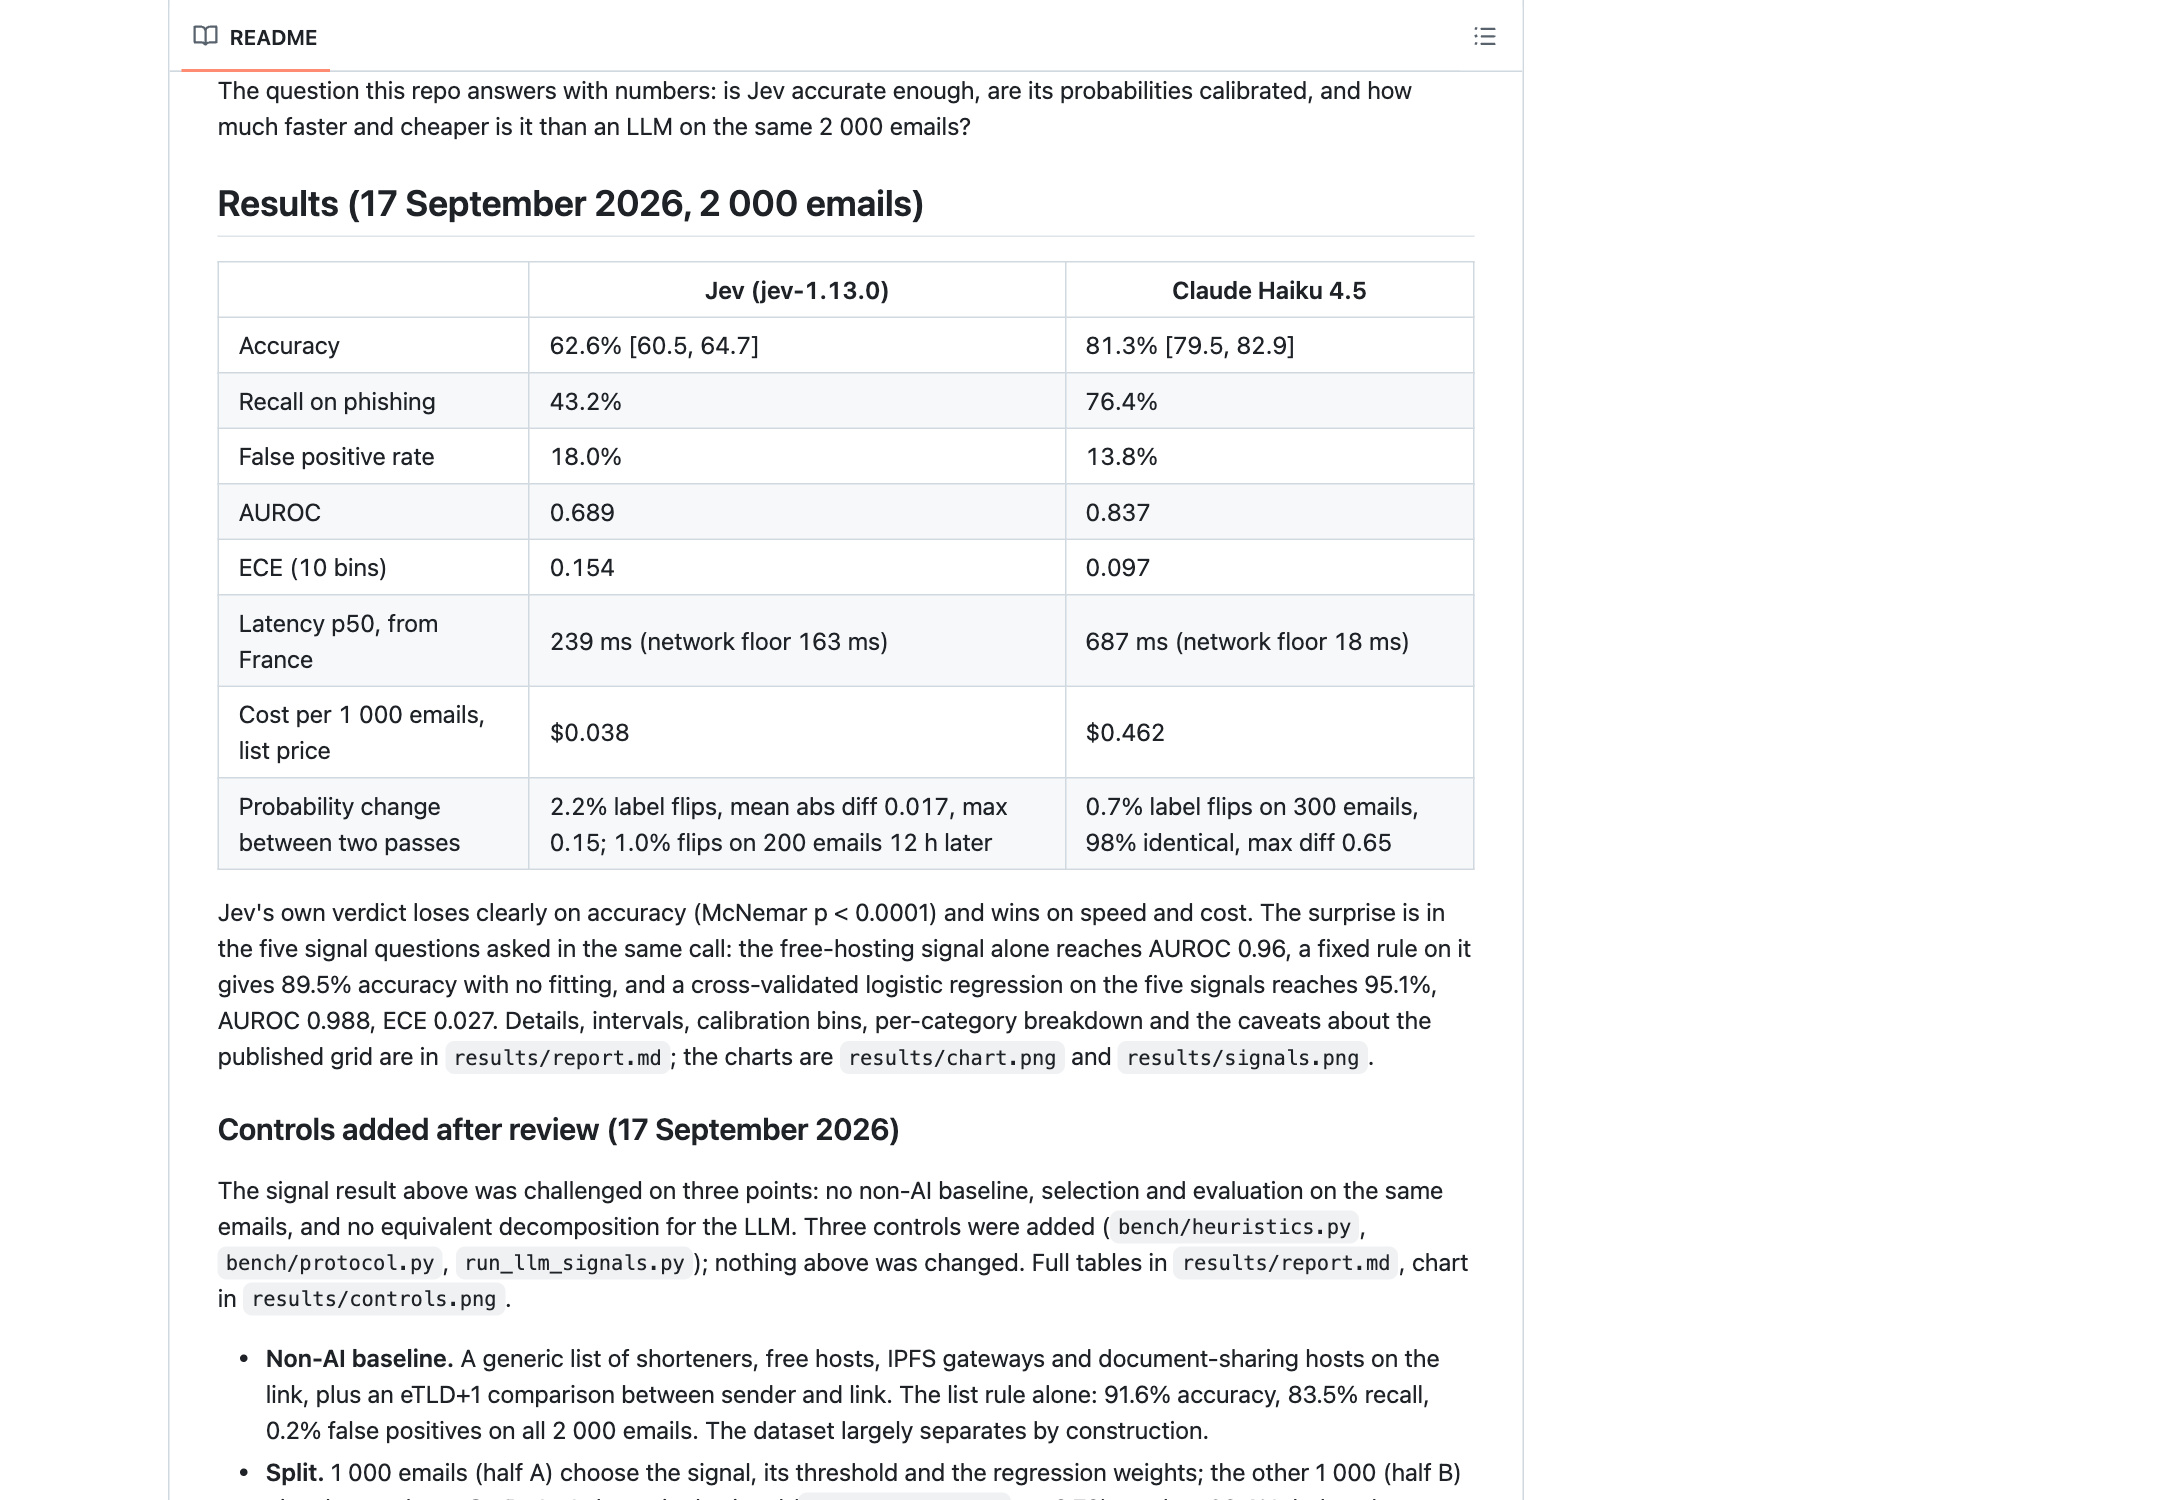
来源:评测作者 GitHub,真实结果截图;与 Every 属于不同任务。
注意这张表里的规律:对手越贵,倍数越夸张。 对旗舰模型是几百倍,对 Haiku、Flash-Lite 这类小模型只有十几到几十倍。为啥这个规律后面讲优势的时候咱们会再提。
小葵花故事又来了:“too cheap to meter”这句话有个典故。 “便宜到不值得计量”不是随口说的:1954 年美国原子能委员会主席 Lewis Strauss 预言核电将让电力便宜到不用装电表。这个预言后来并没有实现,这句话也因此成了科技史上”过度乐观”的著名例子。TypeSafe 用这句话,要么是自信的致敬,也有可能是没意识到这个典故的反讽意味。加上官方自己也承认无法证明定价没有补贴、需要长期来验证可持续性,这个梗放在这里还挺感觉的,你说是吧。
所以关于成本我的结论是三句话:便宜是真的,第三方测出来了;倍数没有 444 那么夸张,看你拿它和谁比;而且这个价能撑多久还不知道。
4. 速度
当前主流的 LLM:
前沿模型端到端 3 到 329 秒。329 秒这个上限是开着推理模式的旗舰模型,思考几千个 token 再回答。为什么慢?上一节讲成本时已经说了:逐个 token 生成,没法并行。在和人聊天的时候几秒钟无所diao味,因为你也有可能在打字。但嵌进代码里就完全是另一回事:一个 agent 一次任务里要做几十次判断,每次几秒,加起来就是几分钟;一个实时系统每秒要判断 10 次,LLM 根本跟不上。
System One + Jev:
端到端 70 到 500 毫秒。快的原因和便宜的原因是同一个:并行采样,一次计算所有答案同时出来,把 LLM 最慢的”逐词生成”那一步整个砍掉了。
官方最能说明速度的是那个 Doom demo:他们让 Jev 控制《毁灭战士》里的角色,每秒发起约 10 次查询,输入的是游戏引擎导出的文本状态(敌人在哪、血量多少、弹药多少),不是画面。算下来成本约每小时 7 美元。用普通 LLM 做不到这个频率,单次响应就要几秒。(官方也坦承,一个传统的非 AI 的 Doom 机器人打得更好,他们要展示的是模型能适应不同的状态表示,并且能听自然语言指令,比如让它”保守一点”。)
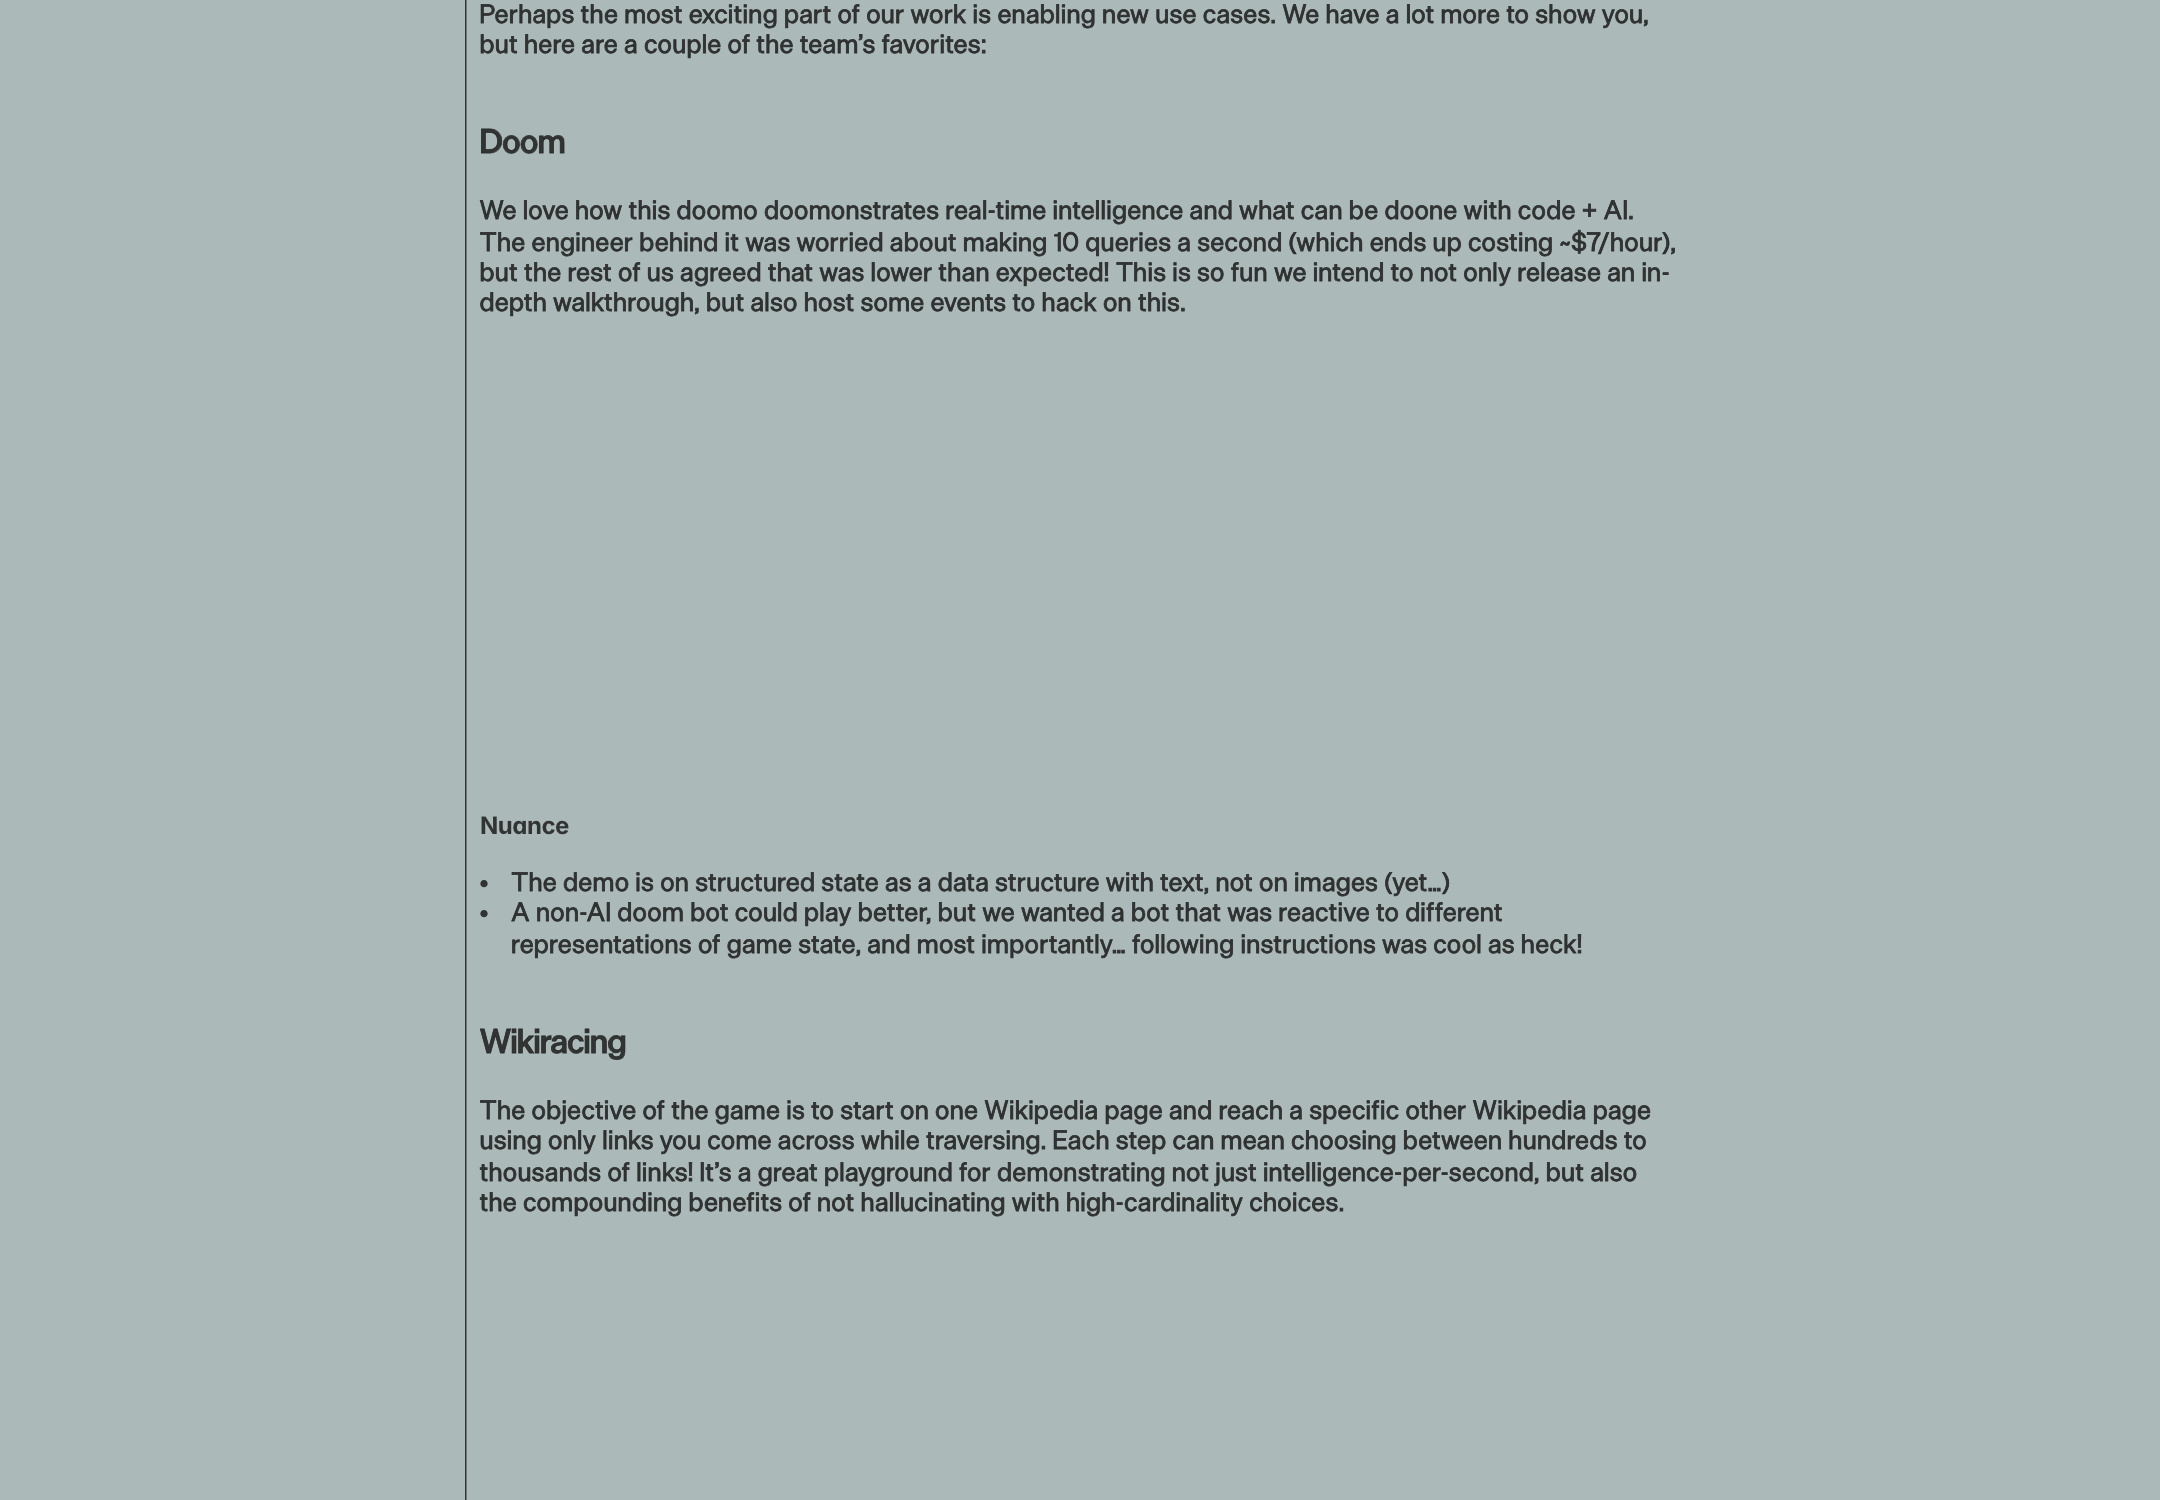
来源:官方 Doom 说明。这张是真实网页文字截图;10 次/秒、约 7 美元/小时是官方演示口径。
第三方数据:Every 测到的是抽取任务每段 0.35 秒对 Fable 5.1 的 8.83 秒;Vercel 的工程师把用于审查命令安全性的分类器从 OpenAI 的模型换成 Jev 后,快了 5 到 18 倍。
有一点大家看官方数字时要留心:70 到 500 毫秒是他们从美国西海岸的笔记本上测的,离自家服务器很近。你从国内或者其他地区调用,真实延迟是多少?而且对实时场景,尾部延迟比平均值重要,P95 是多少?官方没给。说实话全是小心机啊,所以这也是我后面 demo 要去测的。
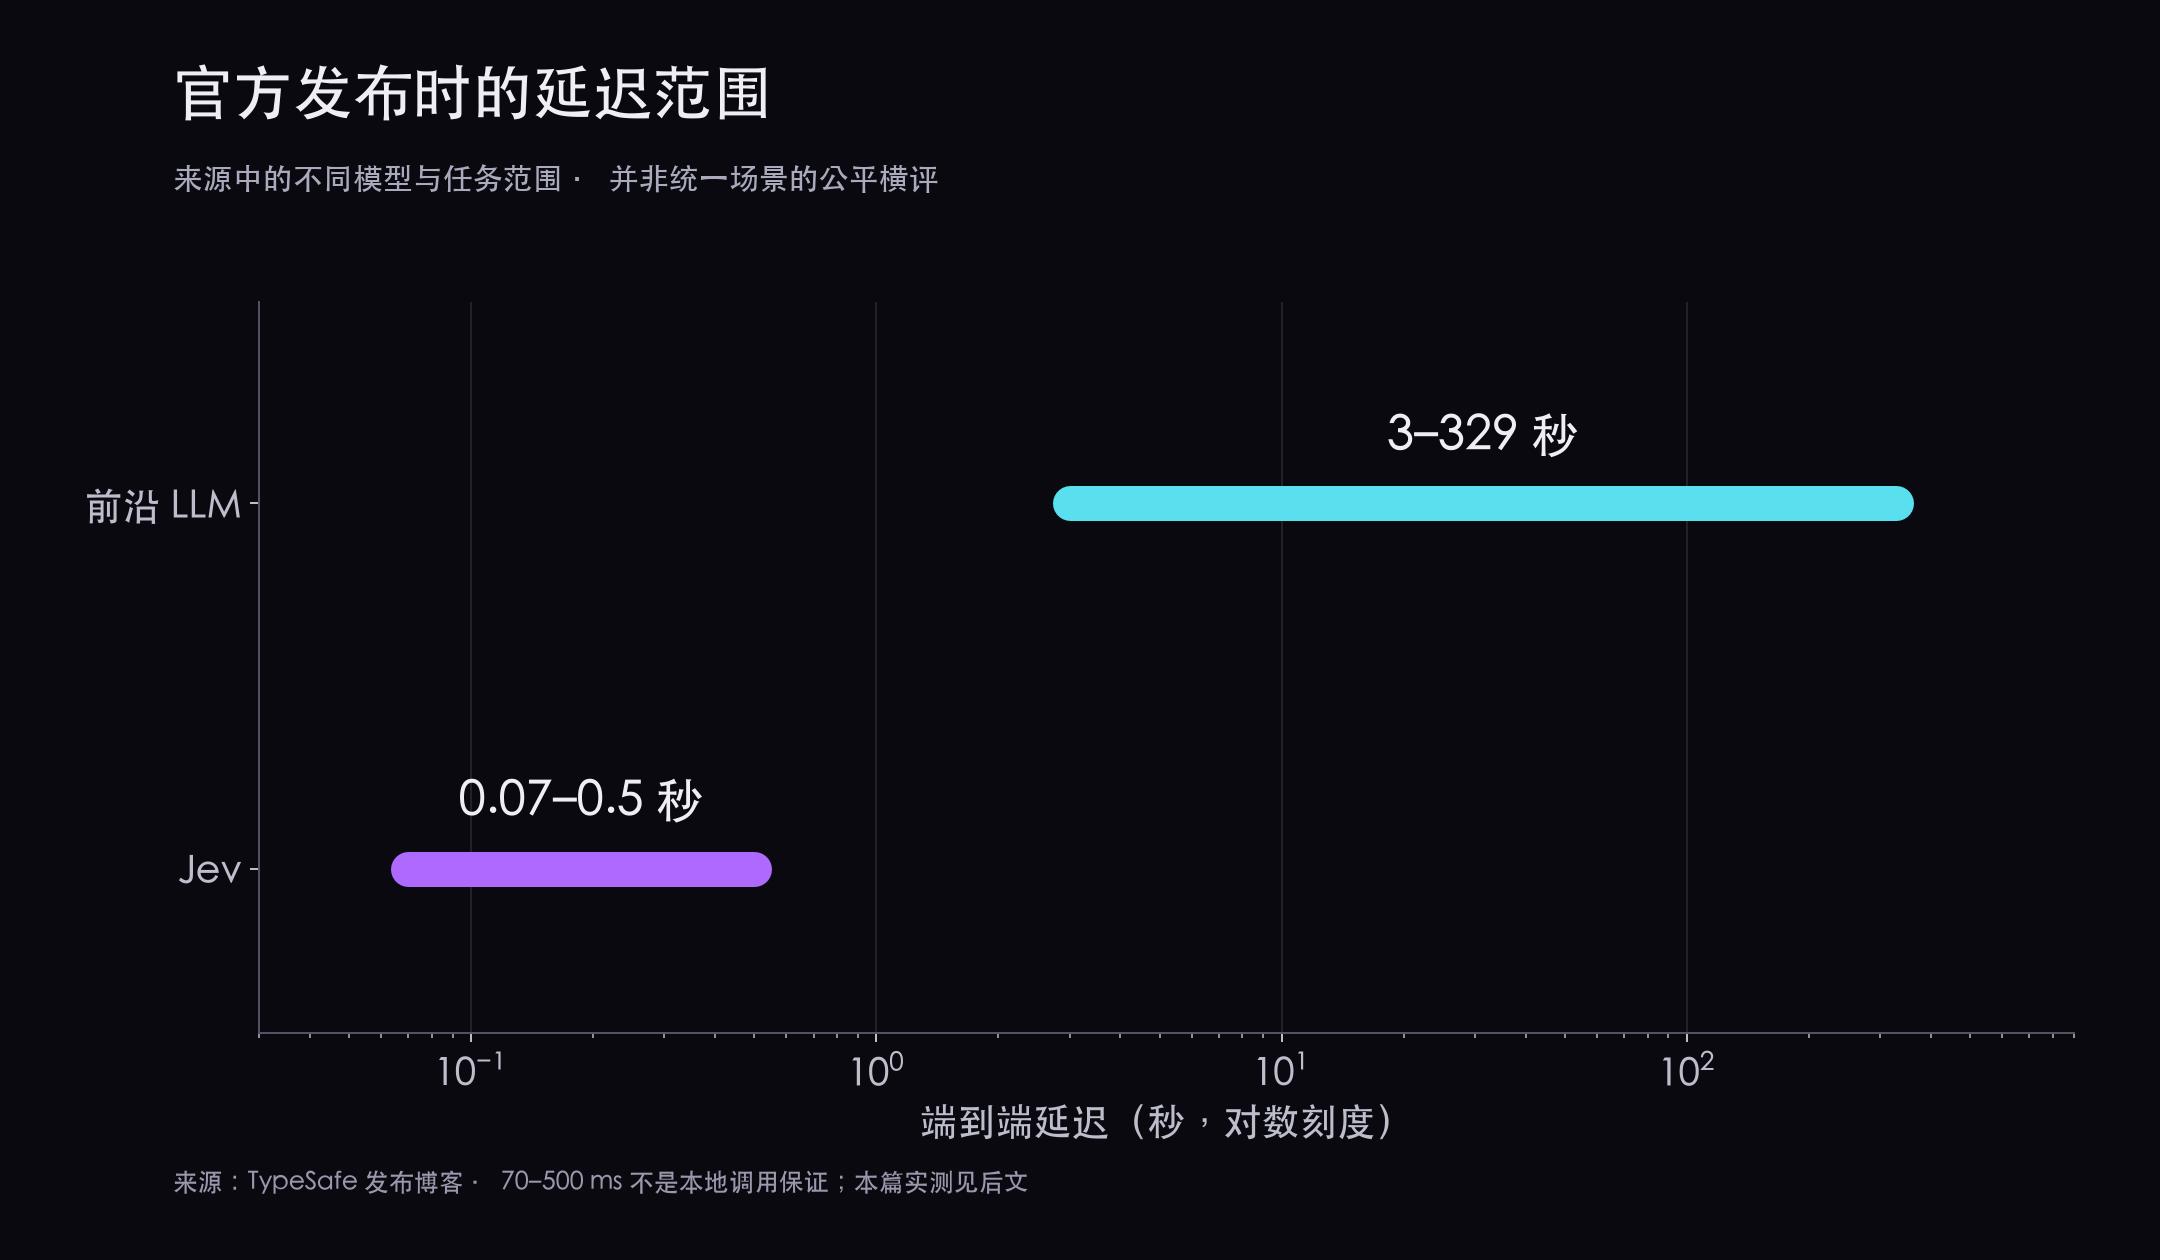
仅展示厂商给出的范围,不是本篇统一条件实测。
5. 可信度
敲锣打鼓,朋友们仔细看了,这一节是全文最重要的一节,因为 Jev 所有的可靠性主张都压在这上面。我分四个概念讲:类型安全、不会幻觉、校准、置信度。
当前主流的 LLM:
LLM 输出的永远是字符串,一段自由文本。你让它”只回答 低、中 或 高”,它大多数时候会照做,但偶尔会给你”风险等级:高”(多了前缀)、”我认为是中等偏高”(发明了新选项)、”高,因为前车正在急刹……”(附带解释)、格式残缺的 JSON。所以用 LLM 的程序都要写一堆防御代码:解析、校验、不合格就重试。
出错率听着很低,比如 0.1%,但算一笔账:每秒调用 10 次,一小时 36000 次,平均出 36 次格式错误。聊天时出错了用户重新问一遍就行,但在每秒跑 10 次的实时循环里,没有人在旁边盯着,每一次错误都得由代码自己兜住。官方博客有句话讲得尊嘟很棒:在一个 agent 里,幻觉出一个工具调用只是麻烦;但如果它处在有延迟保证的系统里,或者深埋在依赖链的好几层之下,那就是不得了的事情了。
再说置信度。你可以让 LLM 在回答后面附一句”我有 80% 把握”,但官方表格里那句话说得很对:它往往过度自信且前后不一致。原因第 1 节讲了,忘记的同学自己回去看:RLHF 侧重人类偏好,RLVR 侧重可验证结果,这些目标本身不保证概率校准。
System One + Jev:
类型安全(Type-safety)。 这家公司的名字就来自这个词。编程里”类型”就是数据的种类:整数、布尔值、枚举(只能是预先列出的几个值之一)。”类型安全”就是程序保证不会把错误类型的数据塞到不该去的地方。
Jev 的做法是:你预先定义好每个问题的类型(Choice / Score / Noul),模型的输出结构在架构层面就被锁死在这个类型里。Choice 问题只会在你列的选项上分配概率,它没有能力输出第四个选项、没有能力附带一段解释、没有能力返回格式不对的东西,因为架构上就没有这条路(糙话:就好像男人没有子宫,所以根本没有宫外孕的风险)。所以官方敢说类型错误”在数学上不可能”,图表里直接填 0%(不是实测值,是由构造保证的)。正常模型响应更容易被代码直接消费;网络中断、服务错误和接口版本变化仍然需要校验与兜底。
“不会幻觉”到底是什么意思。 官方宣传语是 “can’t hallucinate”,这个说法没说谎,但有误导空间。”幻觉”我先解释一下,一般有两种含义:
- 编造不存在的东西:虚构的引用、不存在的 API、格式错乱。这一类 Jev 确实从结构上消除了。
- 给出错误的判断:该选“保持”却选了“变道”,把正面新闻判成负面。这一类 Jev 完完全全可能发生。
类比:LLM 像让人写简答题,可以写出任何内容包括胡编的;Jev 像选择题加”你有几成把握”,答案只能落在选项里。但选择题照样可以选错。 官方说的”不会幻觉”指的是第一种,读者很容易理解成第二种。
还有一个人可能都想不到的一个点:幻觉风险有一部分被转移到了你身上。如果你定义的选项漏掉了真实情况(驾驶场景里没给”紧急停车”这个选项),模型只能在现有选项里硬选一个,而且可能还显得挺有把握。所以选项设计得好不好,变成了使用者的责任。
校准(Calibration)。 那判断错了怎么办?Jev 的思路不是”保证不错”,而是”错的时候让你知道”。每个输出都带概率,训练目标(RLCD)强调校准。这里要特别区分:Choice / Score 的 confidence 是由输出分布计算的统计量,不是“这次答案正确的概率”;本文校准评测用的是有明确定义的 Noul 事件概率。官方解释。理想状态下,它说 95% 把握的那决策真的有 95% 是对的,剩下没把握的情况会表现为低置信度,这时候你的代码可以丢给 LLM 或人了。
但官方文档里有一句非常诚实的话必须搬过来,真心值得强调:校准是在一组预测上衡量的,它不保证某一个具体答案是正确的。 天气预报员说”90% 下雨”结果没下,他错了吗?单看一天没法判断,只有把他所有说”90%”的日子放在一起看才行。如果在这个任务上已经验证校准良好,Jev 说”变道安全 0.95″才可以理解为”在一大批我给 0.95 的情况里约 95% 是对的”,但是你眼前这一次可能恰好是那 5%。设计系统时,阈值高低要和出错代价匹配:不同任务需要分别验证阈值;推荐场景的经验阈值不能直接移植到紧急刹车,更不能仅凭一个云端概率决定安全动作。
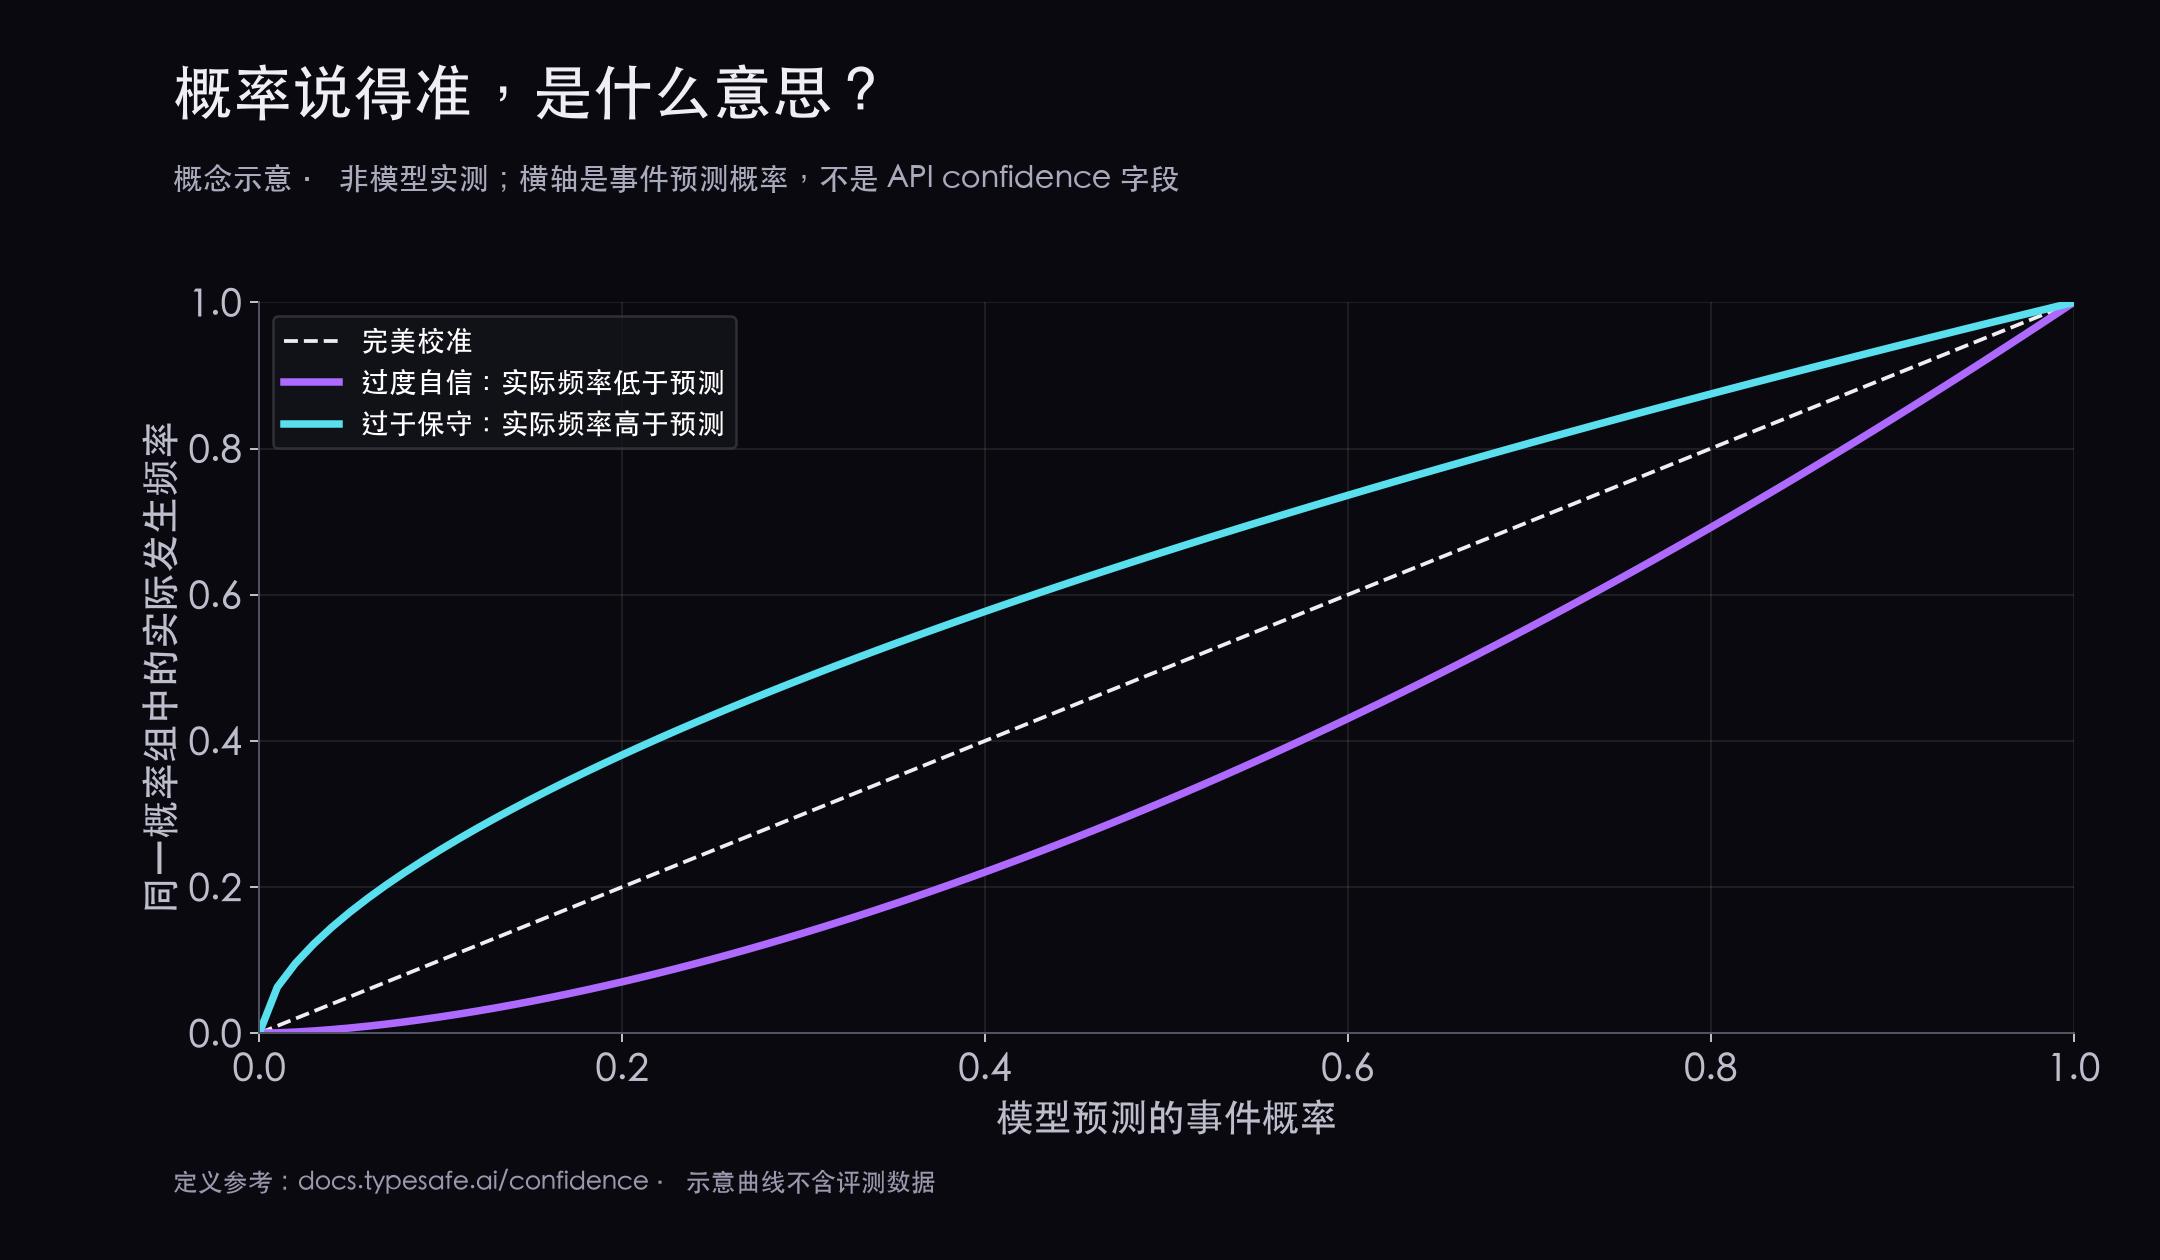
概念示意,不含实测数据。横轴预测概率,纵轴实际频率;过度自信在对角线下。
系统 1 也会出错,和“不会幻觉”矛盾吗? 当然是不矛盾的。回到 Kahneman 那道经典题:球拍和球一共 1.10 元,球拍比球贵 1 元,球多少钱?大多数人脱口而出 0.1 元,这是系统 1 的答案,是错的(正确答案 0.05 元)。如果把这题做成选择题,选项是 0.05 / 0.10 / 0.15,凭直觉的人会选 0.10。他没有”幻觉”,0.10 是合法选项、格式完全正确,但答案就是错的。
Jev 面临的正是同样的风险,而且原因相似:人类系统 1 出错是因为不经过逐步推理,直接凭模式匹配给答案;Jev 也不做逐步推理,一次计算直接出结果。遇到那种表面像 A、细看才是 B 的问题,它原则上也容易掉坑里。会推理模式的 LLM 反而就闪闪发光,可以在思考过程中发现”等等,不对”。
官方凭什么说能做得更可靠?他们没告诉你们的是,但从博客能够推出三道防线:① 校准,人类系统 1 最大的毛病不是会错而是错了还很自信(答 0.10 的人通常非常确定),对于Jev 来说遇到陷阱题时应该给出较低的置信度;② 任务拆解,把需要多步推理的大问题拆成不需要推理的小问题,推理的直接丢给代码的 if-else 整;③ 没把握就上交给 LLM 或人,相当于”系统 1 搞不定时叫醒系统 2″。
这三点逻辑上自洽,但成立与否全压在第一点上:如果 Jev 在答错的时候依然显得很自信,后两道防线就不会被触发,整套论证就塌了。 所以校准是这个模型真正的承重墙,而它恰恰还没被充分独立检验。目前可以参考的外部数据之一来自那个可复现的钓鱼邮件基准:Jev 的概率在某些问题类型上过度自信,在另一些上又过于保守。样本不大,但方向值得警惕。所以我 demo 里就会测这个!
summery一下!这节的三个概念的关系:
- 类型安全 = 输出的格式一定对。数学保证。
- 不会幻觉 = 官方对类型安全的宣传说法,指不会编造选项之外的东西。
- 校准 = 输出的概率可信。经验性的,需要验证。
三者里只有第一个是铁板钉钉的(ai行业中少见的咬死笃定的事情)。
6. 使用场景
当前主流的 LLM:
表格里列的三类都是”需要生成”或”需要人盯着”的活:聊天、写代码、做数学证明、快速搭原型。LLM 在这些地方没有替代品,Jev 一个字都写不出来,根本不在同一个赛道。
System One + Jev:
官方给它的定位是 “smart if-statements”(智能 if 语句)。要理解这个定位,最好的办法是看官方 evals 站上那个安全告警处置的工作流,我把它翻成中文重画了一下(我是不是很贴心):
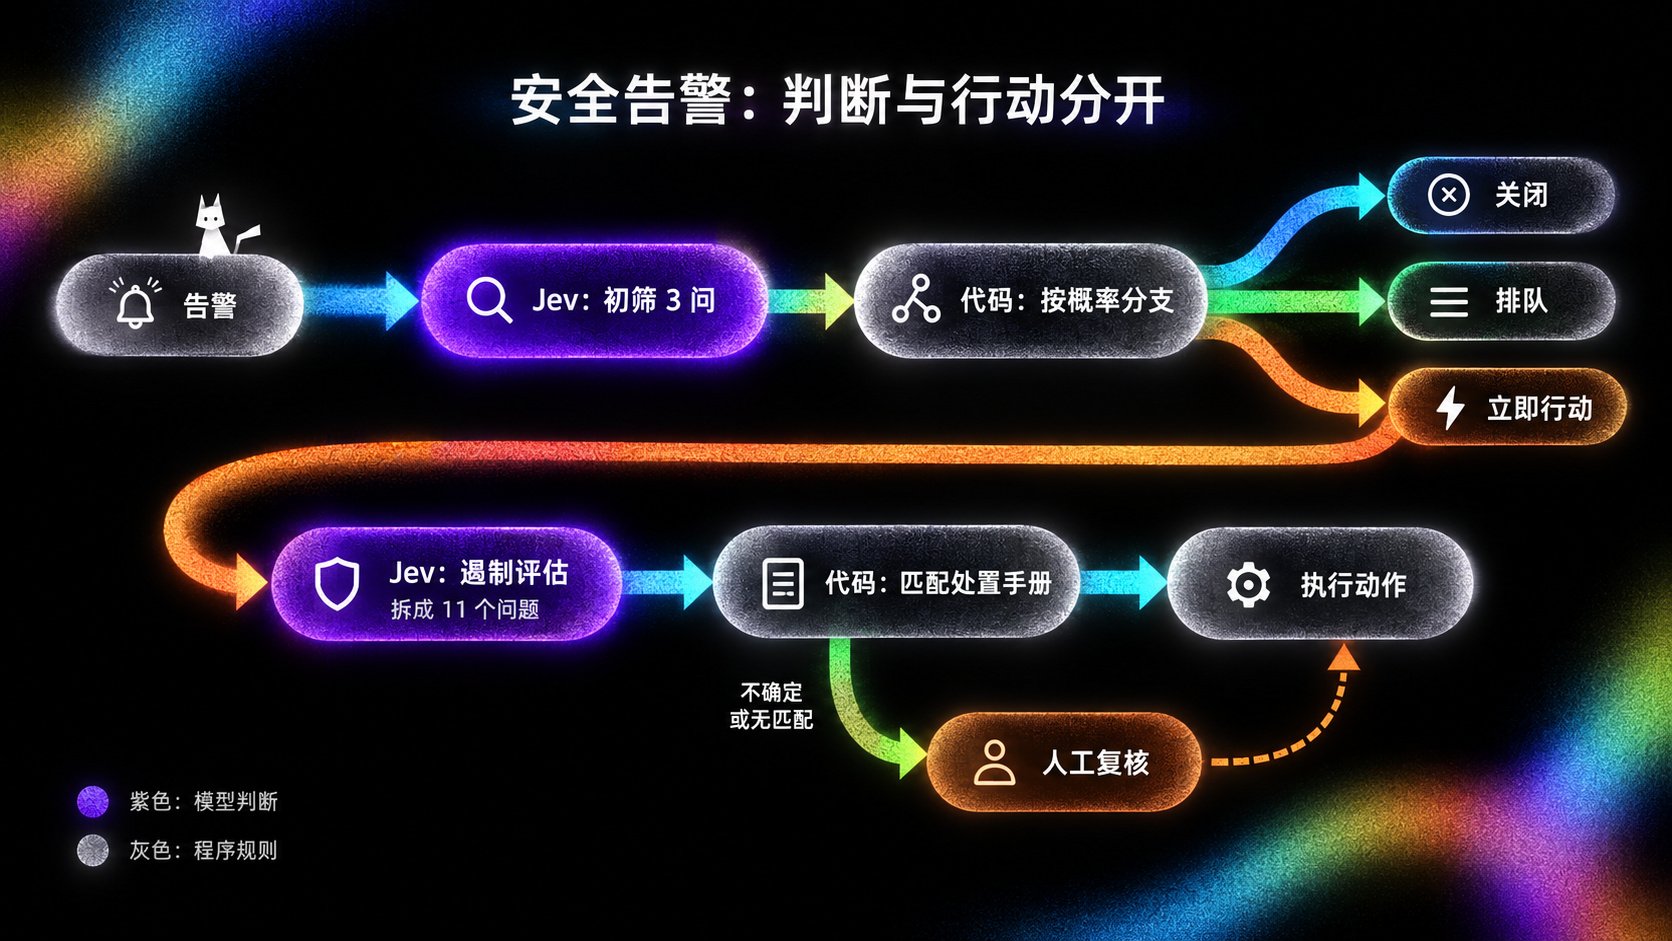
依据官方工作流绘制,紫色为模型判断,灰色为程序规则。
这张图里最值得带走的三个设计思路:
第一,模型只回答问题,不做决定。 紫色和灰色是交替出现的。Jev 从不直接输出”隔离这台主机”,它只回答”有没有恶意进程在运行”这类事实性问题,由代码根据答案的组合来选动作。这样每一步都可审计:出了问题,你能查到是哪个问题答错了,还是哪条规则写得不对。
第二,问题拆得很细、彼此独立。 不是问一个”该怎么办”的大问题,而是拆成三个加十一个小问题。官方原文的说法是:最可靠的工作流往往由许多独立、拆解开的问题组成,行为细节依赖概率而不是离散决策。大问题的答案好坏很难检验,错了也不知道错在哪;小问题每个都简单、明确,容易答对,答错了也能精确定位。而且 Jev 是并行回答的,十一个问题和一个问题耗时差不多,拆细几乎没有代价,多整点,想细点,总不会错,还不亏。
第三,不确定时交给人。 整个流程有三个出口通向人:灰区通知用户、转二线、紧急上报。只有高置信度的两端(明显没事、明显有事且能对上手册)才全自动。这就是”校准概率”在实际系统里的用法。
“用概率而不是用是/否”这一点再多说一句。如果模型只回答”是越权”或”不是越权”,那么 51% 把握的”是”和 99% 把握的”是”在代码看来完全一样,会触发同样的动作。有了概率,代码就能做精细区分:越权概率 > 0.75 立即行动,0.15 到 0.60 之间发消息让用户本人确认,很低且有记录解释就自动关闭。同一个问题因为概率走不同三条路。
这套方法官方叫“拆解工作、搭建 harness”。 harness 就是包在模型外面那层代码。(harnsee后面会单出一篇去讲哈)对 LLM 来说 harness 是辅助,模型本身能干完整件事;对 Jev 来说 harness 是主体,Jev 自己什么都”做”不了,先问什么、后问什么、阈值多少、触发什么动作,全写在 harness 里。harness 是一段程序,Jev 就好像是这段程序里的智能 if 语句。没有harnsee,Jev就好像断手断脚一般。
官方实验结论又又又来了:四个示例任务平均下来,每一个模型(不只是 Jev,也包括各家 LLM)放在这种拆解过的工作流里跑,都比”把同样的策略写成一大段提示词让模型一次性解决”更准、更便宜、更快。也就是说这是一个关于方法的结论,不只是关于 Jev 的。那个钓鱼邮件基准也提供了一个例子:Jev 单问一个”是不是钓鱼”只有 62.6%(Haiku 81.3%),拆成五个窄问题、用 1000 条标注样本拟合权重之后,在另外 1000 条留出样本上到了 95.0%,Haiku 为 93.2%。但两者差异的 p 值为 0.063,没有达到 5% 显著水平;这里的提升也包含标注数据和监督拟合的贡献。
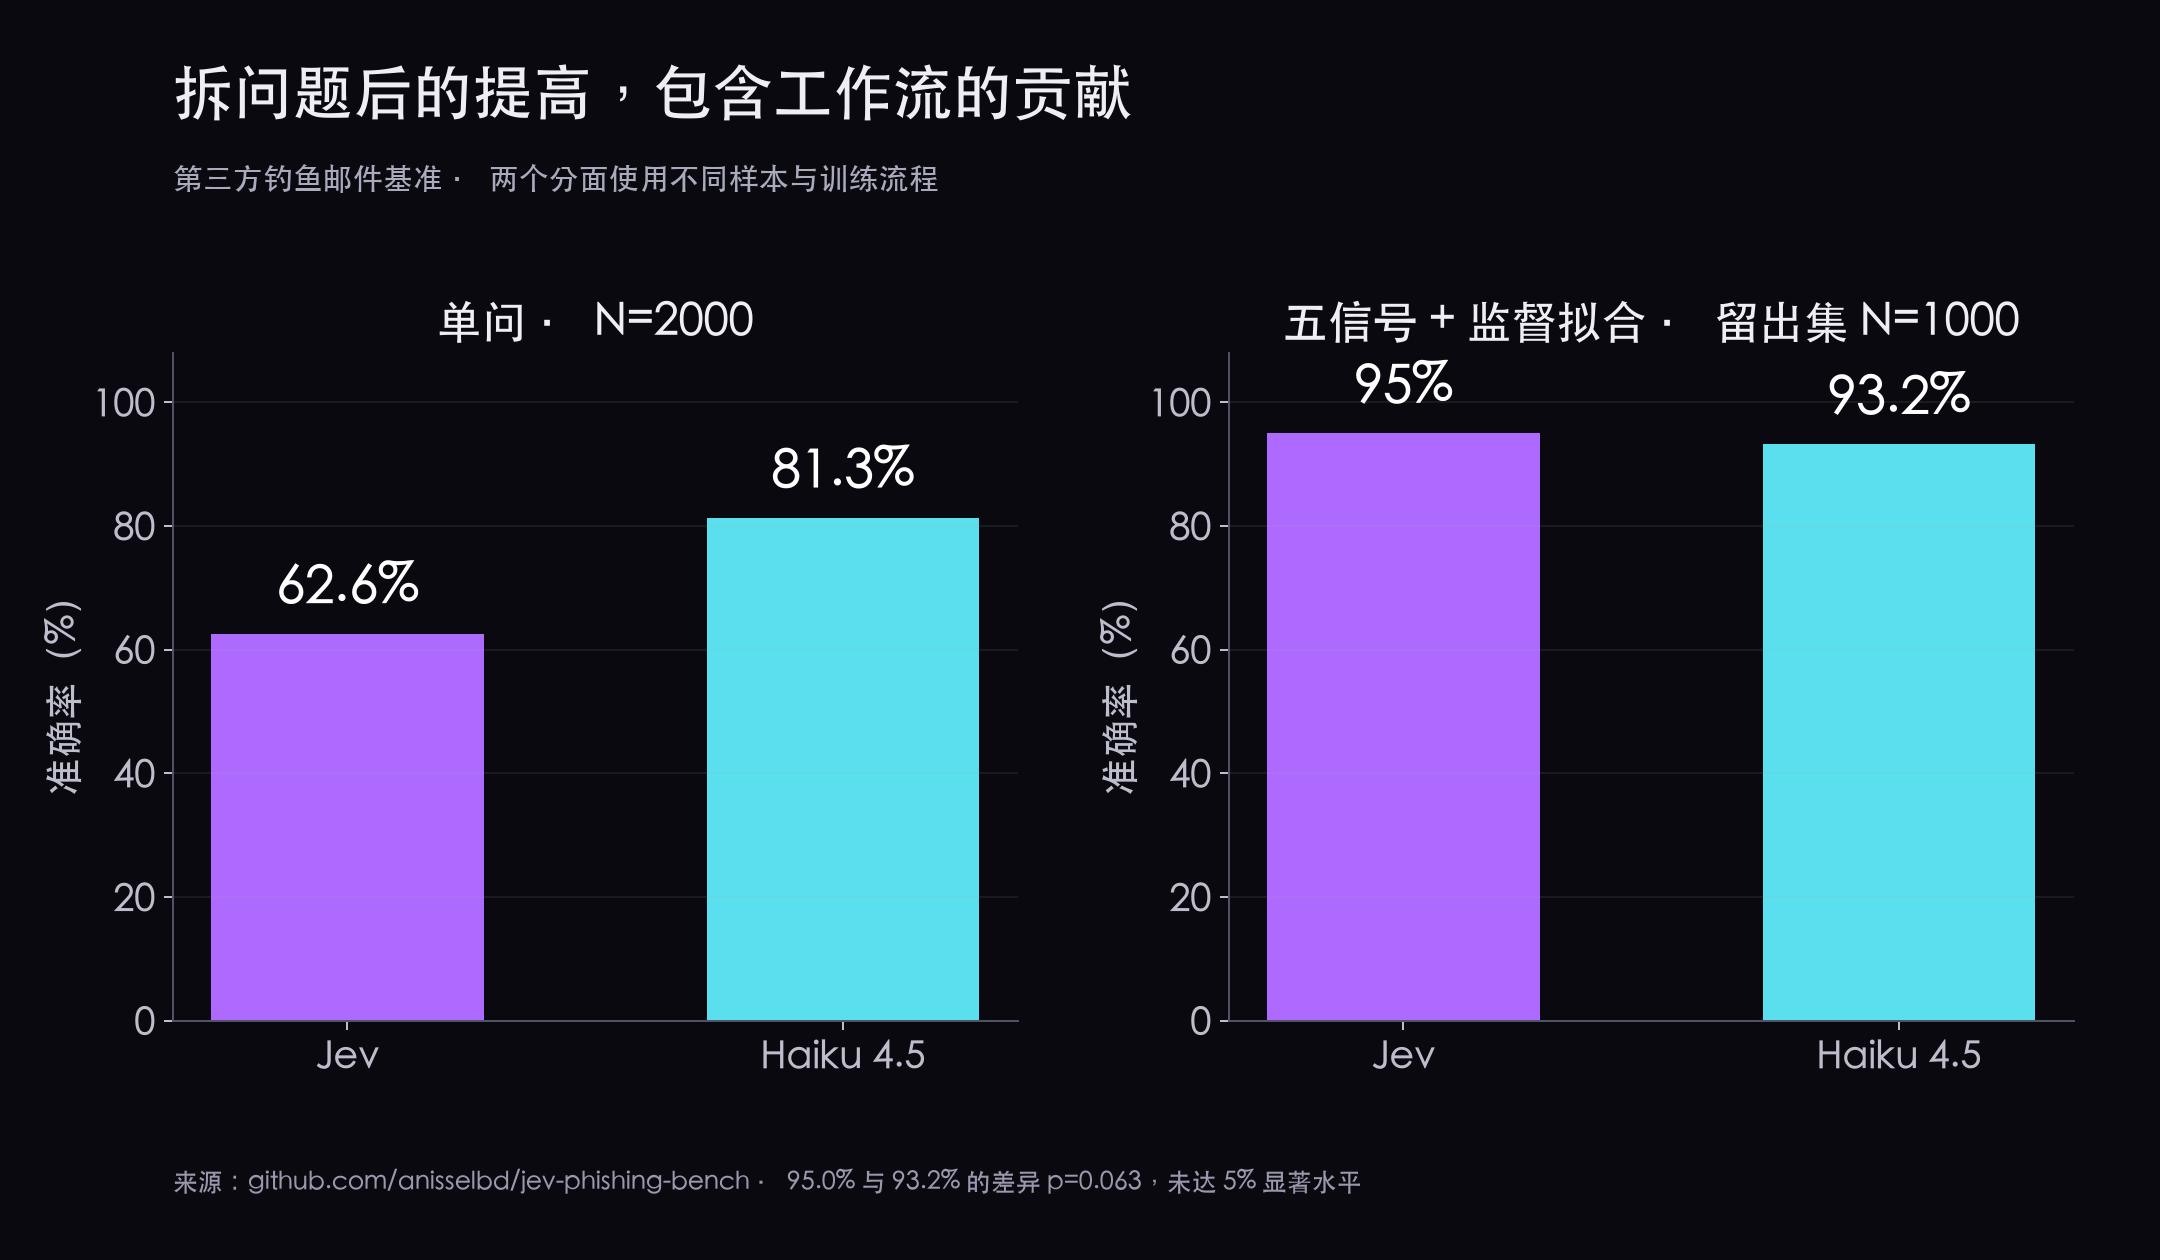
来源:评测仓库。五信号一组使用 1000 条训练、1000 条留出测试;数值差异未达到 5% 显著水平。
不过也要看到代价:这种方式把工作量从”写提示词”转移到了”设计工作流”。写一段提示词十分钟,设计上面那个安全告警工作流可能要一个安全专家花几天。Jev 省下的是运行成本,增加的是设计成本,适合要跑成千上万次的高频任务,不适合偶尔做一次的事情。
优势所在:
看完上面的描述其实就很直观地发现 JEV 的优势所在。官方的说法是 Jev “占据帕累托前沿近两个数量级”,这句话得解释一下。
帕累托前沿是啥。 买手机场景中你只关心两件事:价格越低越好,性能越高越好。五款手机里,D 比 B 贵、性能还比 B 差,那 D 没有任何存在的理由,被 B “支配”了。剩下没被支配的那几款连起来的线就是帕累托前沿:想在一个指标上变好,就必须在另一个指标上牺牲。AI 评测里常见的图就是横轴成本、纵轴智能,各家最新模型构成一条从左下到右上的前沿。每次有新模型,最常见的宣传就是”我们推进了前沿”。
官方那句话翻译成人话:在他们的图上,横轴从最便宜往贵的方向数,有接近 100 倍宽的一段范围里,Jev 都是最优的那个点。通常新模型只把前沿往外推一点点,一口气霸占 100 倍宽的区间是非常夸张的说法,所以他们自己也用了”off the charts”(爆表)这个词。
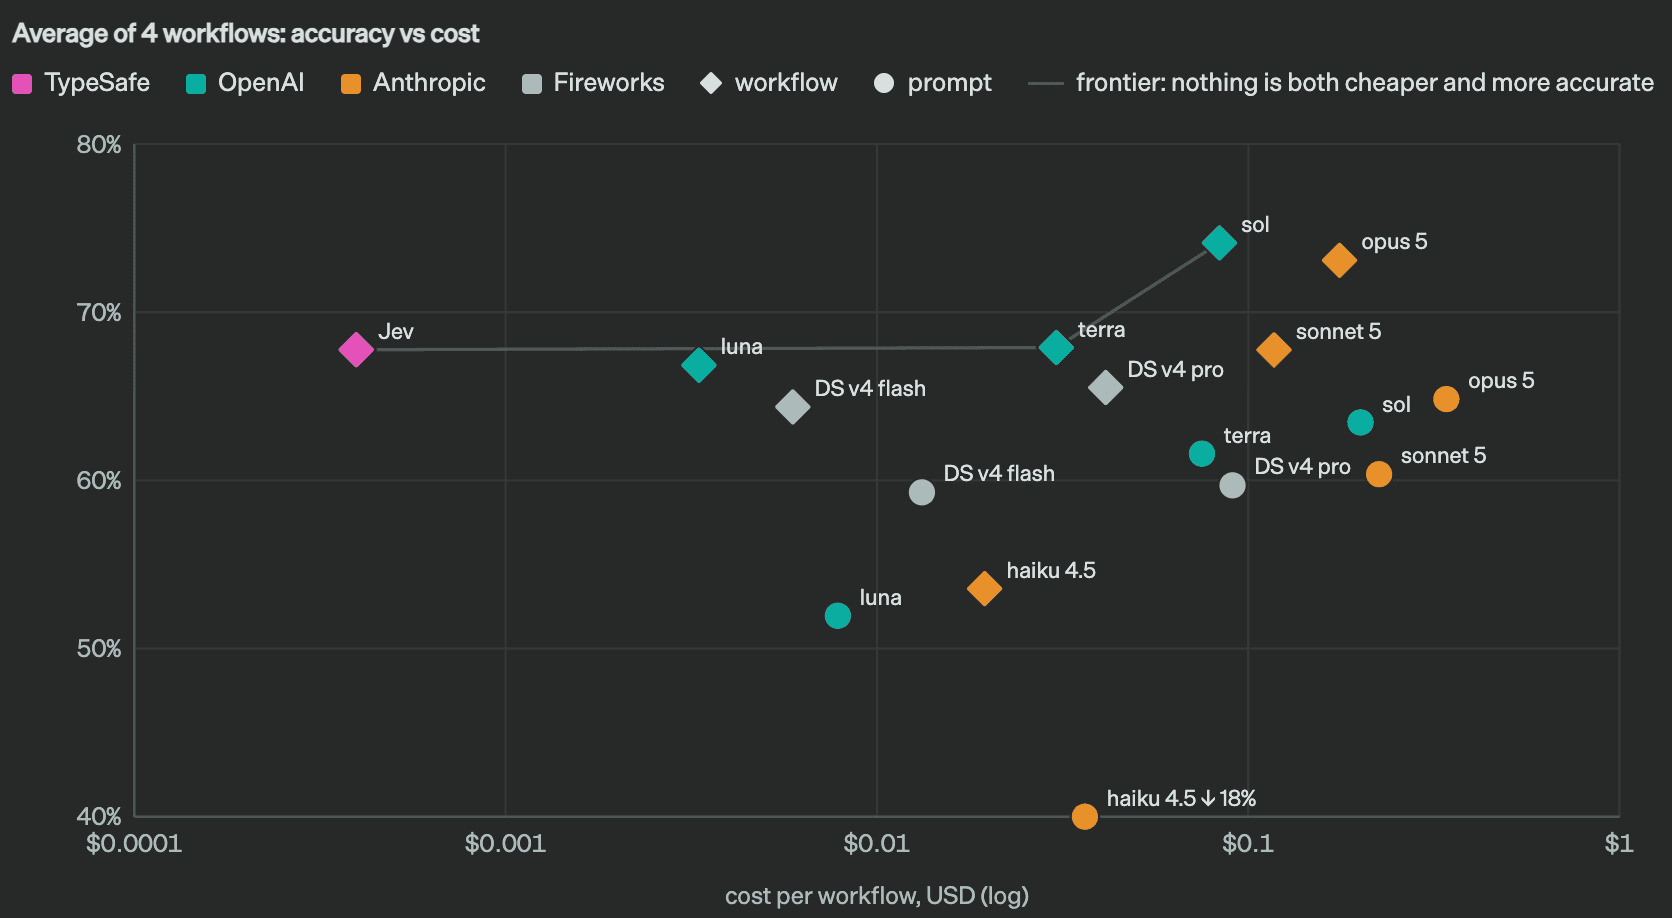
来源:TypeSafe 官方评测。纵轴是其模型参考答案口径;不与其他数据集的成绩混画。
官方数据是怎么来的。 他们设计了四个工作流(安全告警、agent 轨迹审查、发票处理、客服),共 711 个案例,让所有模型跑同一套固定的 harness,不允许各家针对考题调提示词。没有人工标注的标准答案,而是拿 GPT-6 Astra 和 Fable 5.1 两个最贵模型的平均答案当”参考答案”,看谁最接近。结果:四个工作流平均,Jev 68% 准确率、每案例 0.0004 美元、0.4 秒;GPT-5.6 Terra 68%、0.03 美元、10 秒;Opus 5 73%、0.18 美元、38 秒。Arize 的总结是:比 Opus 5 落后 5 个点,但便宜 440 倍。
那个“快 193.6 倍、便宜 444.6 倍”就出自这里。 但官方在博客的 Nuance 小节里主动写了四条折扣,贴心的我整理成一张表:
主动写这些在 AI 公司发布文里真的是少见的,在我这里算加分项哈,好感度+++。但首页大字写的仍然是 193.6 倍和 444.6 倍,导致媒体传播的几乎都是前者(所以建议大家真的学会阅读一手资料)。
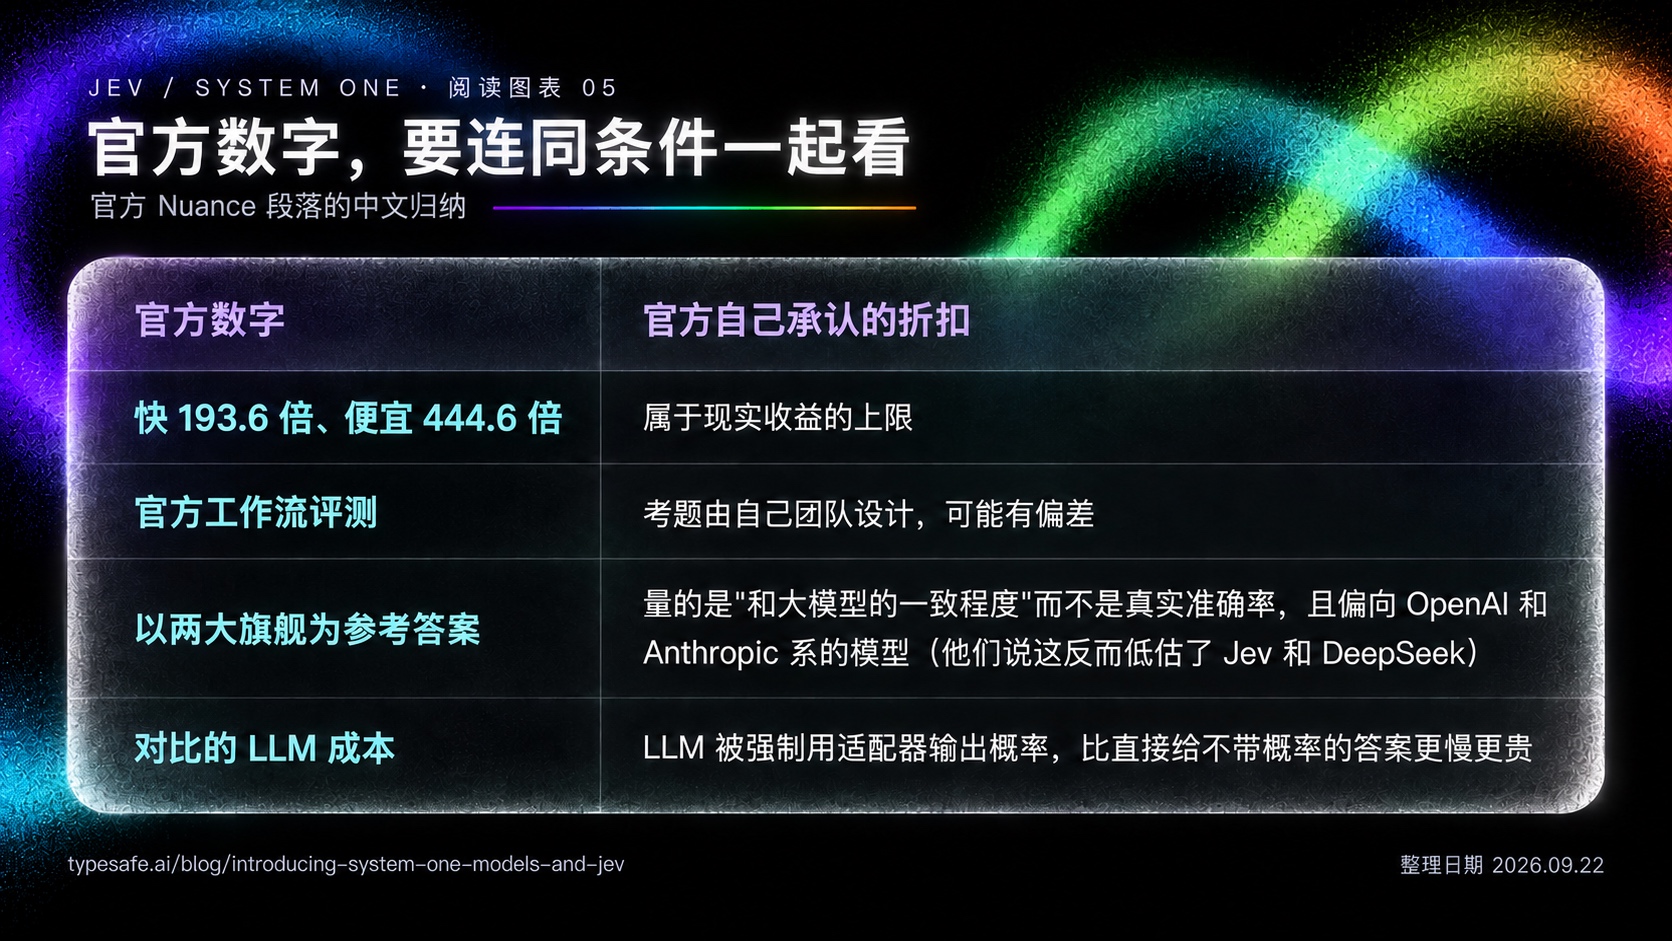
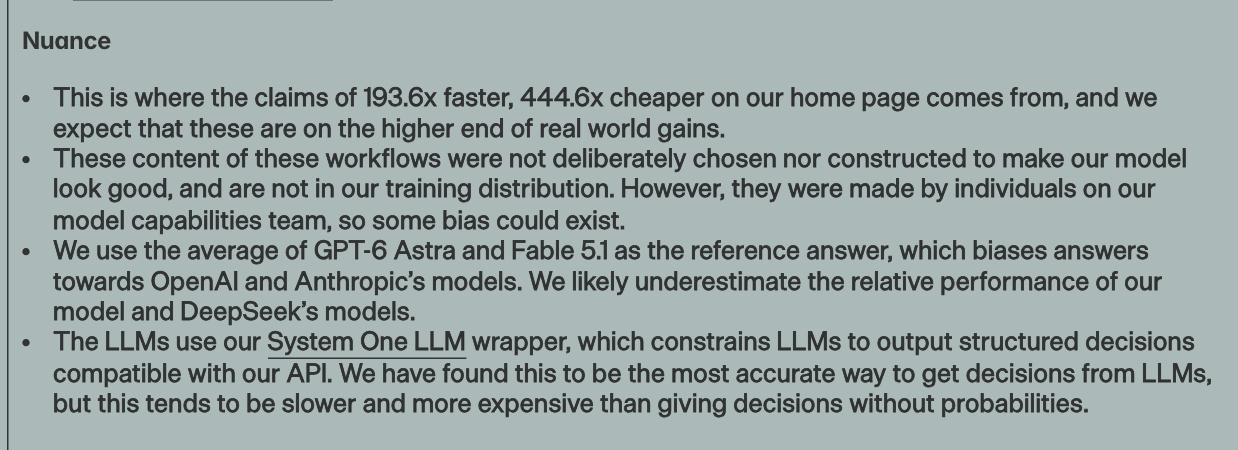
来源:官方评测的 Nuance,保留原文四项限制。
所以我的判断是: 虽然官网都在和出名的大模型比较,Jev 真正的竞争对手不是 GPT-6,而是那些原本就用来做分类的便宜小模型(Haiku、Flash-Lite、各家的 mini)。在那个赛道上它的优势要温和得多:便宜十几到几十倍,准确率互有胜负。这个优势仍然很大,但没到 400 倍的夸张数值哈。
另一个值得看的设计是:Jev 把类型约束和概率输出直接组合进接口。 便宜模型的格式稳定性和概率校准也应按任务检验。如果你的系统需要靠概率阈值来路由,Jev 把这组能力直接做进了接口。传统分类器也能做概率校准,这个组合能否形成他们家的护城河,还要看目标任务上的验证结果。
二、小型评测:我把驾驶决策 demo 真跑了一遍
光转述官方数字没意思,我把 highway-env 模拟器、Jev 接口和记录工具都搭好了。结论先行:接口跑通了,成本很低;但这组驾驶预测任务里的概率没有表现出良好的校准,本机端到端延迟也没有达到 100 毫秒。)
(这只是行为决策层的概念实验哈。模拟器里有完整路况状态,真实道路上的感知噪声、湿滑物理、交通法规和车规级控制,都没有在这次实验里覆盖。
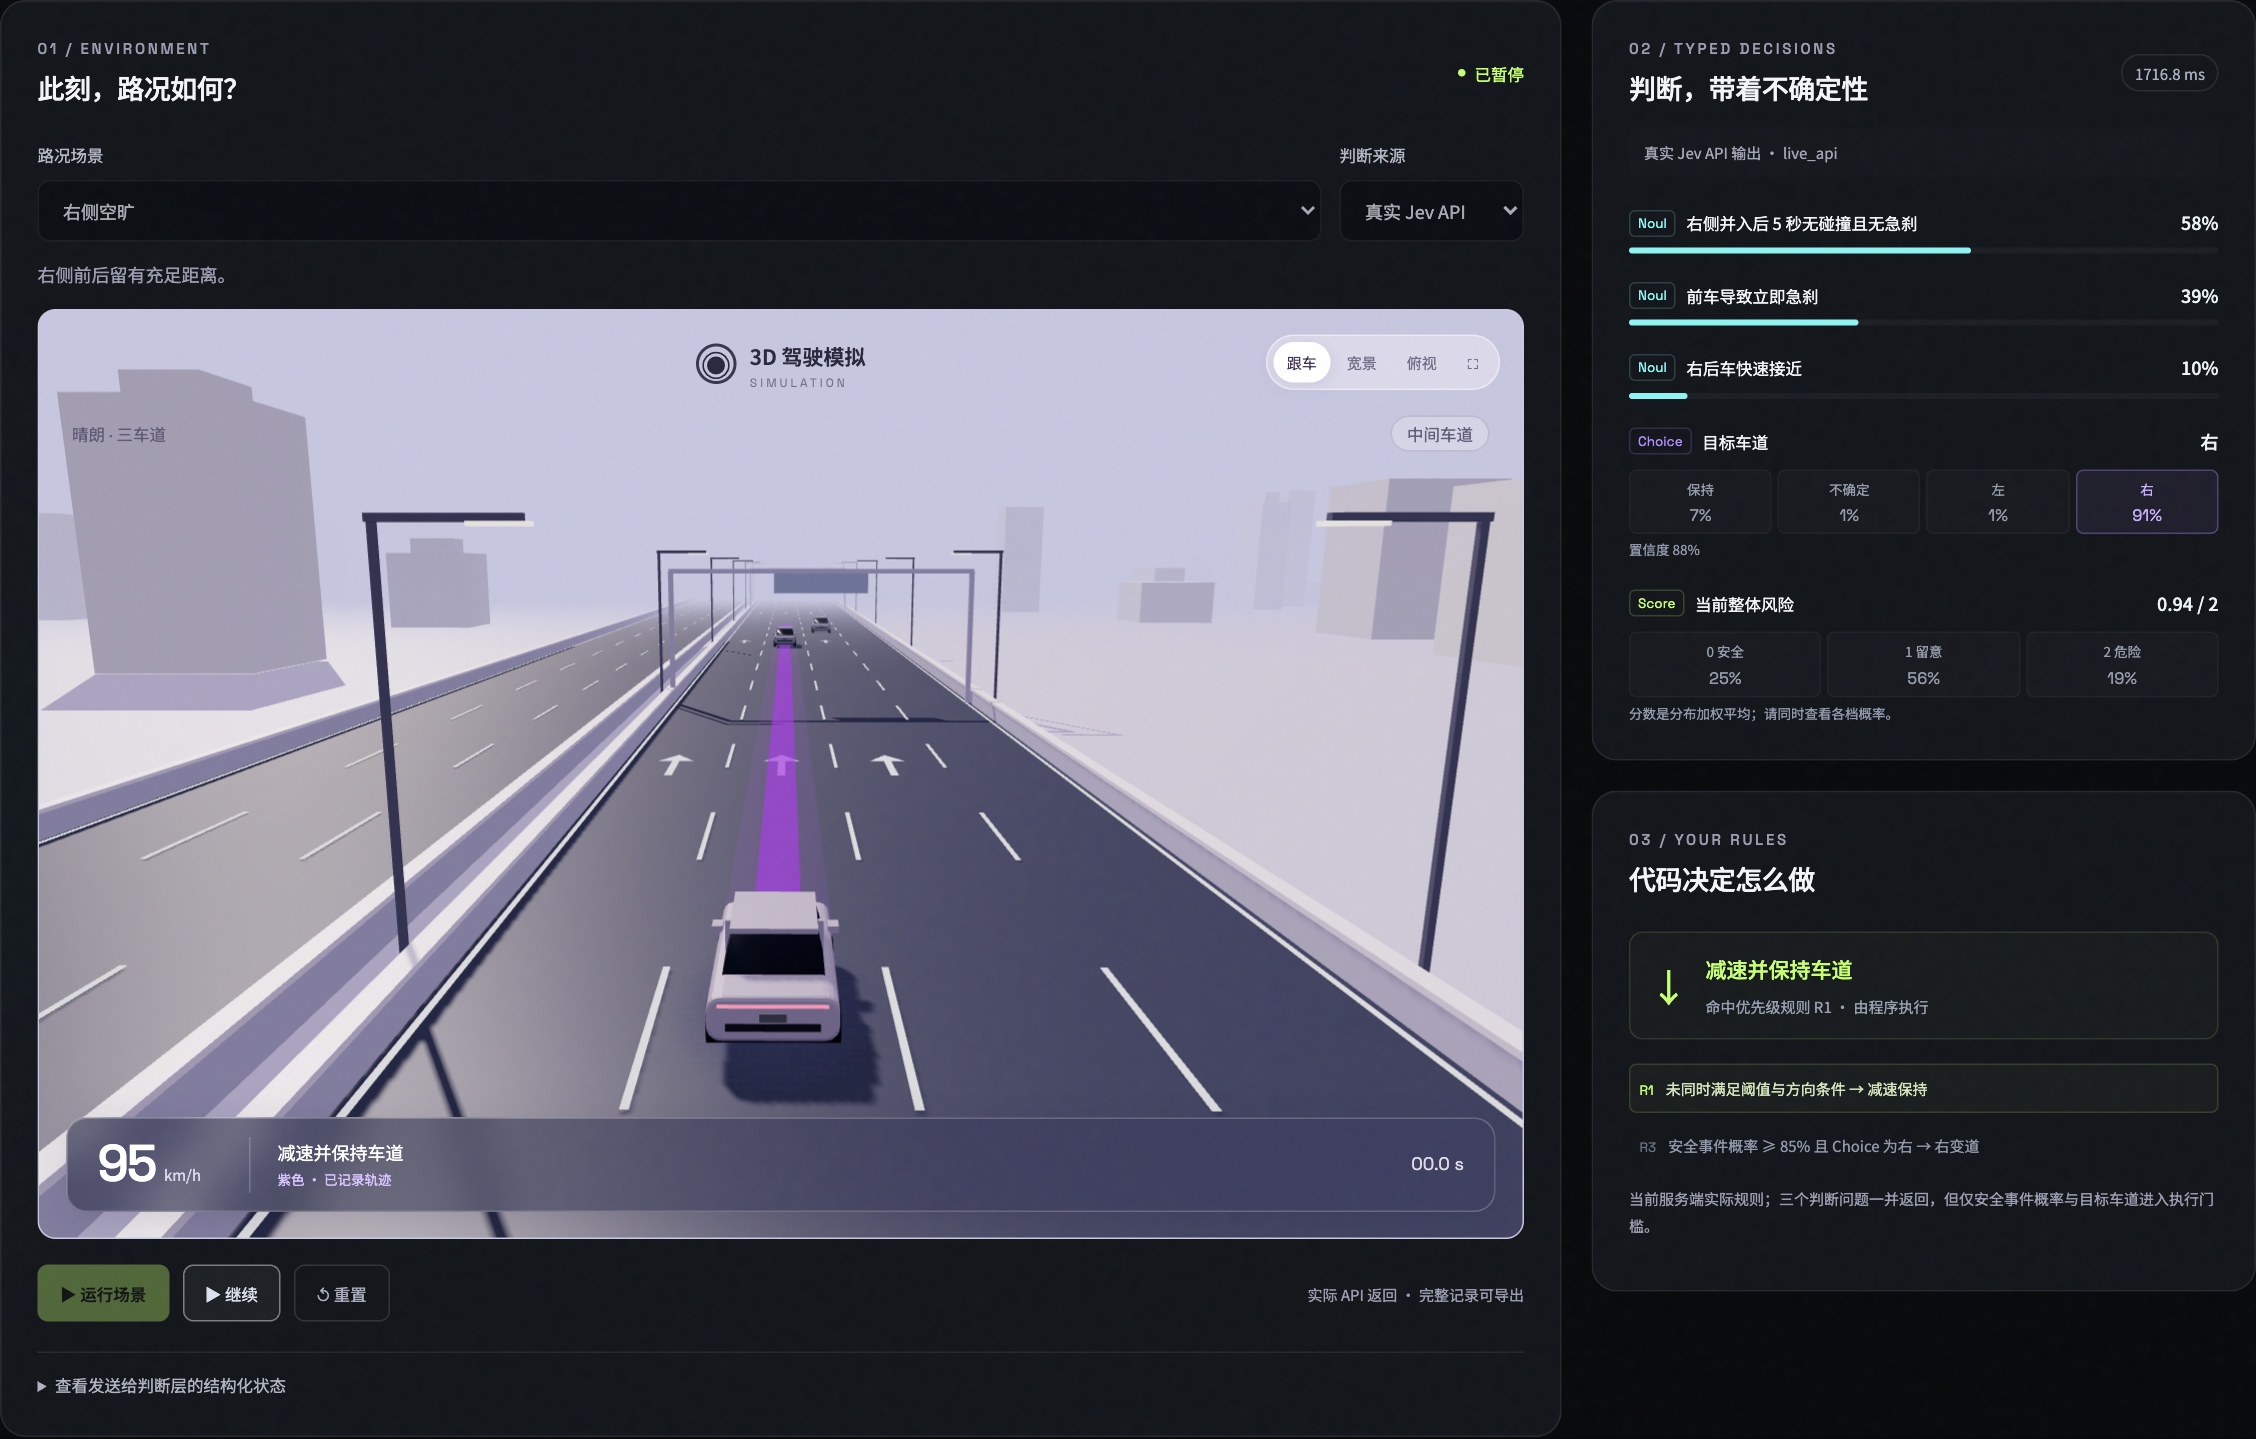
驾驶 demo 界面:3D 跟车视角、立体车辆与道路,以及行驶轨迹回放。画面仍由 highway-env 的路况与轨迹数据驱动,模型输出和执行规则可在页面中查看。
我的demo 是怎么搭的
环境: highway-env 1.10.2,固定随机种子 20260922。设计了六类模板:右侧空旷、右后车快速接近、右侧近处慢车、外侧车辆计划汇入、右侧远处静止车、前车慢但距离充足。每类采样 20 个参数组合,共 120 个基础场景。
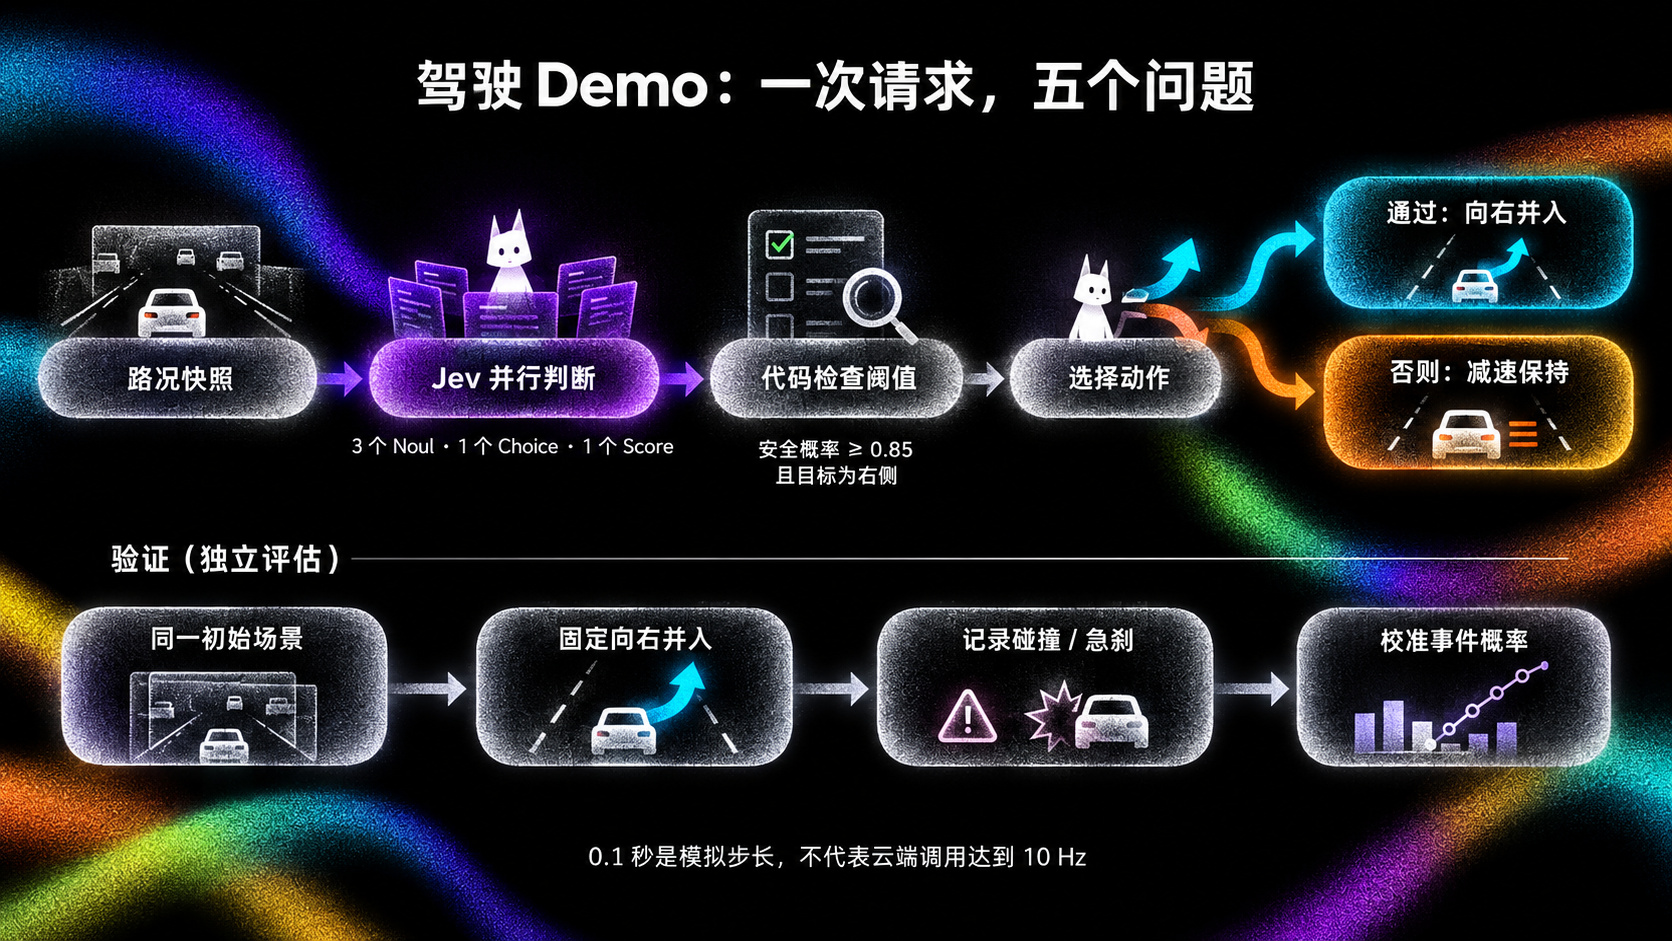
一次判断的流程:读取路况快照 → 一次请求把五个问题发给 Jev → 代码检查概率阈值 → 选择动作 → 在模拟器中播放后续轨迹。模型返回的实际版本为 jev-1.13.0。
模拟器是每 0.1 秒推进一步。这是模拟时间步长,不能说云端每秒完成 10 次决策。当前交互 demo 等待模型返回后再执行和播放;批量评测里的并发,也不等于实时驾驶控制。
输入仍然是“情况汇总表”:自车速度、当前车道、各车的相对位置与速度、计划汇入事件,以及要预测的五秒时间窗。这里没有把模型不知道的模拟器隐藏状态拿来判错;评价事件和固定控制策略也写在了输入中。
五个问题:三个 Noul 分别判断“现在向右并入后五秒内能否无碰撞且无急刹”“前车是否导致立即急刹”“右后车是否快速接近”;一个 Choice 选择左、右、保持或无法判断;一个 Score 给整体风险打分。
Noul 没有“无法判断”这个第三种选项,Score 也不应把它混进有序等级;这次把显式“无法判断”放在 Choice 中。执行规则很简单:右并入安全事件概率 ≥ 0.85,而且 Choice 为右,才允许右并入;其他情况减速并保持车道。 请求失败则提示错误并保持保守行为。
对照组的边界设定:代码接好了官方 system-one-adapter 0.2.0,能够让普通 LLM 回答同一组问题。但本次只提供了 Jev 凭据,所以没有运行 LLM 对照;下面所有实测图都只画 Jev,可不干凭借这个判断它比某个 LLM 更好或更差。
测了三样东西
一、校准质量。
校准必须先定义“正确”到底指什么。这次只看一个二元事件:从同一初始状态固定向右并入,按 IDM 控制器前进五秒,自车既不碰撞,也不出现低于 −4 m/s² 的纵向加速度指令。 不评价后车舒适性,也不把它叫完整的驾驶安全标准。
每个场景都单独跑一次这个固定动作的模拟,不管模型实际是否愿意变道。这样不会只挑模型敢执行的动作来评价。实际执行动作的结果和校准用的固定右并入结果分开记录。
120 个基础场景各调用原文、改字段顺序、换速度单位、换措辞四种版本,共 480 次请求,466 次成功,14 次连接中断。原始表述中有 1 次失败,因此校准图的有效样本量是 N=119,不是 480。
在这 119 个场景里,用十个等宽概率区间计算,ECE 为 0.2703,Brier 分数为 0.2122。这说明当前提示方式与这组模拟任务的概率—频率对应关系并不好。但这是六类人工模板的固定种子采样,没有独立自然场景测试集,也没有足够样本把它说成“Jev 的通用校准误差”。
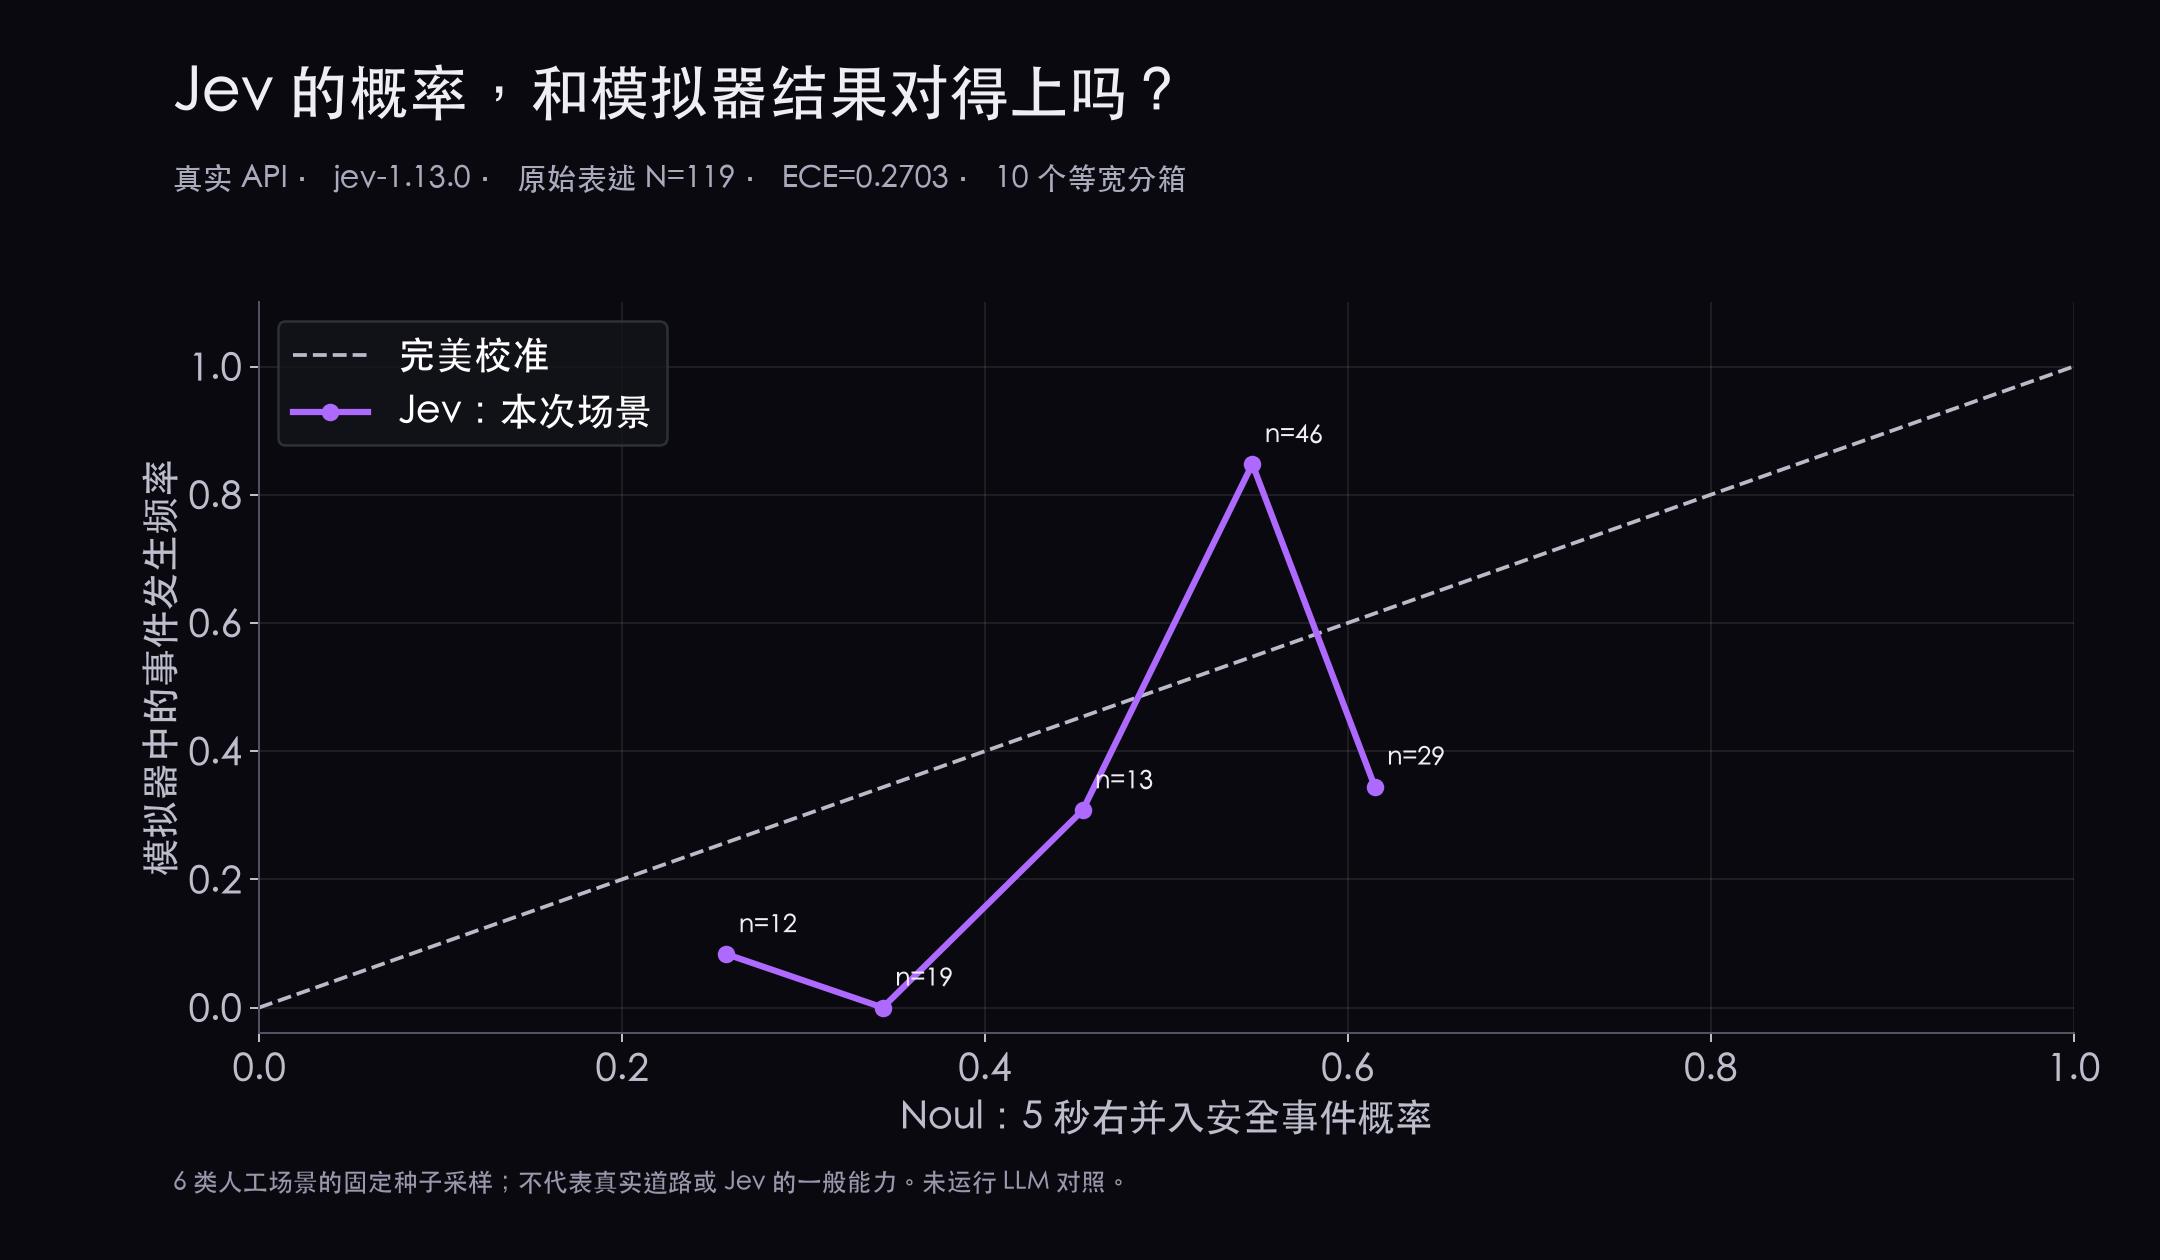
一个更直观的例子:20 个右侧空旷场景全部满足事件条件,但平均安全概率只有 0.551;20 个计划汇入陷阱场景全部不满足条件,平均概率反而为 0.618。在这个任务上,低 ECE 的期望没有兑现。 其实这个也提醒我:让模型精确预测一个动力学控制器五秒后的结果,本身就比普通文本分类更难。
大白话就是:在这两组场景里,它对容易过关的情况信心不足,对过不了关的情况反而更乐观。
目前在这套提问方式和模拟任务里,Jev 的概率不够可靠。但是不能据此认定它在所有任务上都不可靠。
二、延迟和成本。
为了缩短采集时间,主批次用了并发 6;另外单独做了 20 次串行验证,全部成功。串行端到端 P50 为 1375.60 毫秒,P95 为 1795.83 毫秒;并发 6 时,119 个成功原始请求的 P50 为 1583.21 毫秒,P95 为 8527.83 毫秒。这些时间包含本机网络和连接建立,记录的是这一次路径与实现,不能全归因于模型计算。
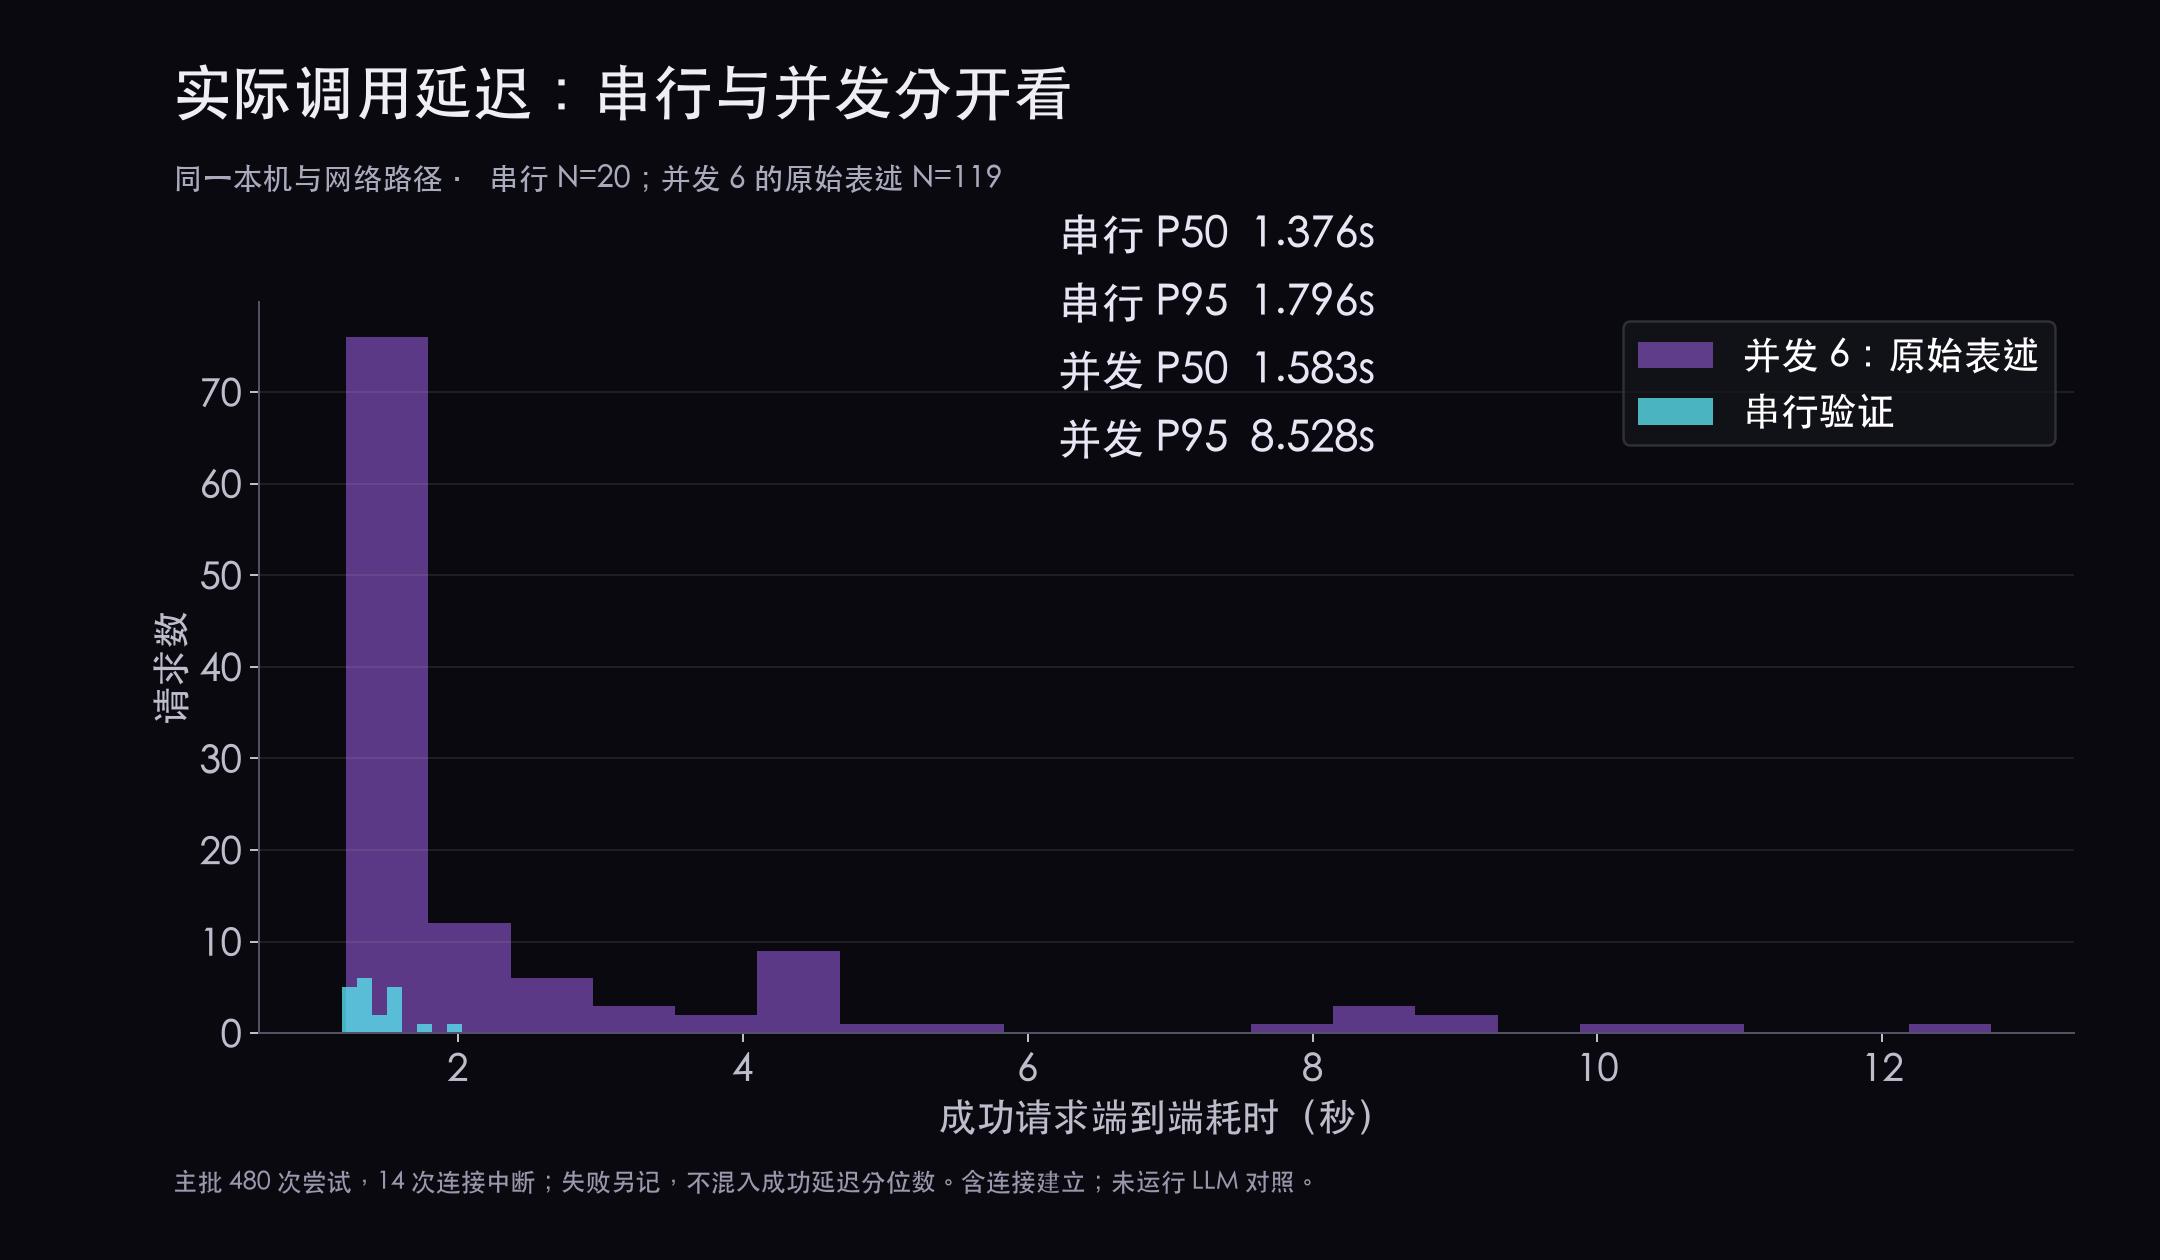
主批次成功请求共返回 396,615 个输入 token。按公开的每百万输入 token 0.042 美元、输出免费计算,约为 0.01666 美元;另 20 次串行验证约 0.000707 美元。这是根据 usage 计算的费用估算,不是控制台账单,失败请求的实际计费用量未知。
原始请求平均约 839.5 个输入 token。假设以同样输入长度每秒调用 10 次、持续一小时,即 36,000 次,费用外推约 1.27 美元。这次没有跑一小时,也没有证明能持续达到 10 Hz;Doom 约 7 美元/小时的输入长度和调用实现不同,不能只比总价。
确实便宜哈。
三、一致性。
改字段顺序,有效配对 114 组,概率绝对变化平均 9.65 个百分点、最大 32.00 个百分点;换速度单位,115 组,平均 3.87、最大 16.00 个百分点;换措辞,115 组,平均 4.15、最大 12.00 个百分点。
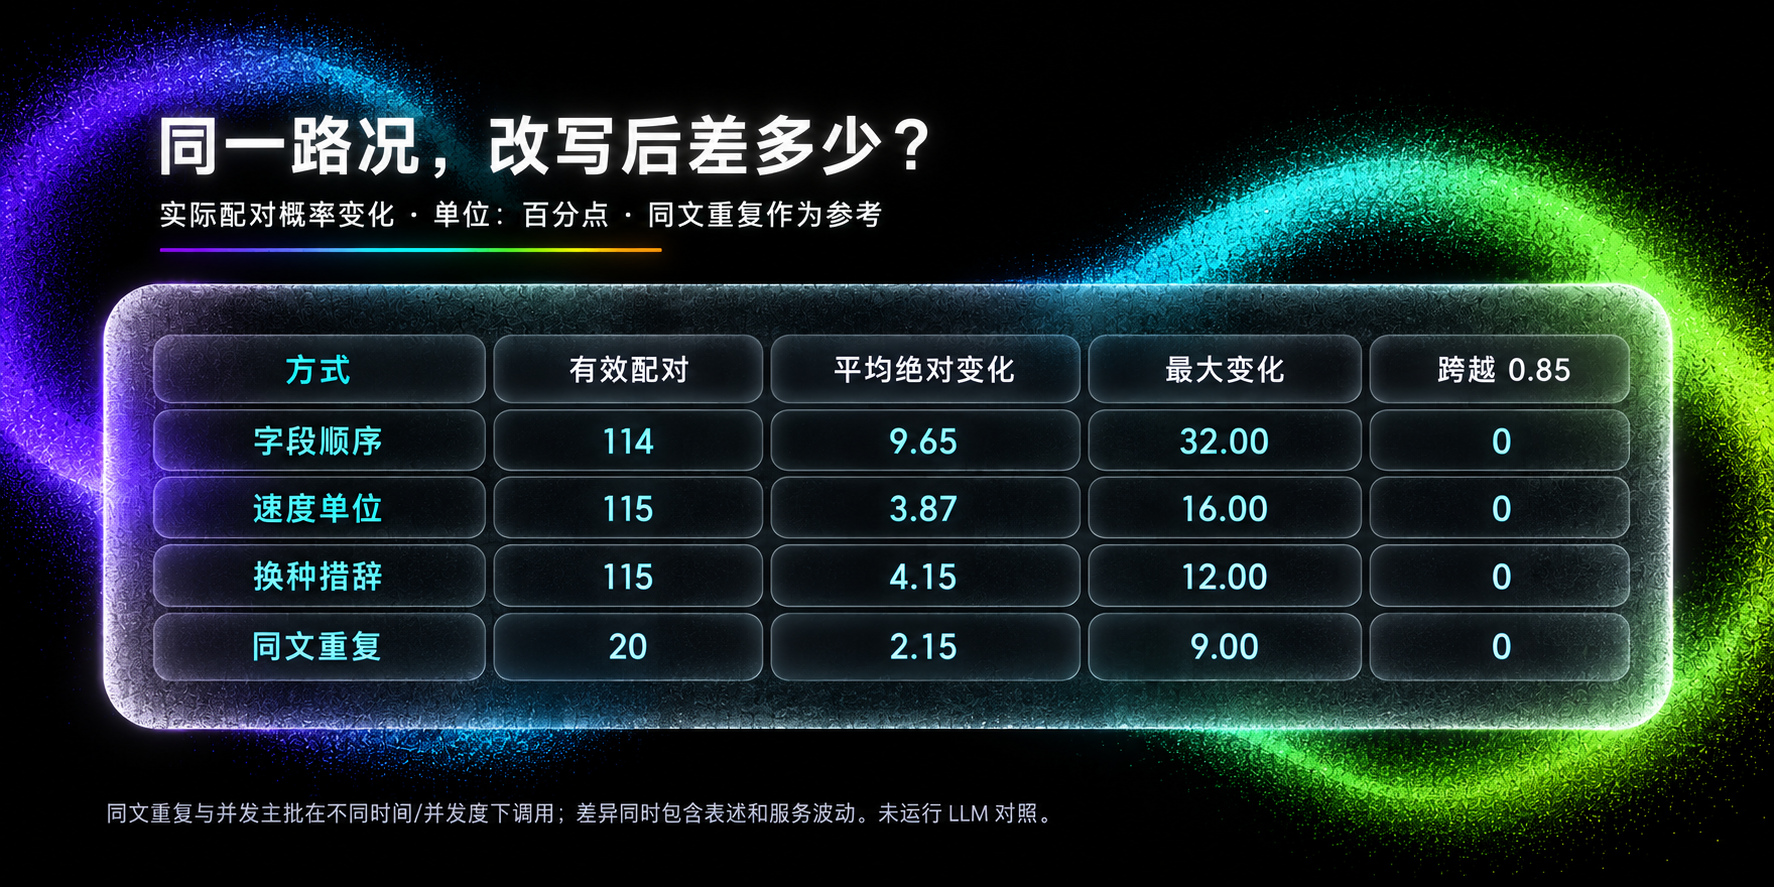
还有一个重要参照:同一原文另调一次的 20 组结果,变化平均 2.15 个百分点、最大 9.00 个百分点。这些重复调用发生在不同时间和并发条件下,所以不能把扰动前后的全部差异都归因于写法。至少从这批数据看,字段顺序的变化值得继续排查。
加一组陷阱题。 40 个陷阱原始样本里,没有出现安全概率 ≥ 0.85 却失败的案例。但这并不能宣布“兜底验证成功”:全部 119 个原始预测都只落在 0.23–0.65,这条 0.85 阈值根本没有放行任何一次右变道。一直拒绝操作,可以减少冒险,却不能证明模型会选对安全的操作。
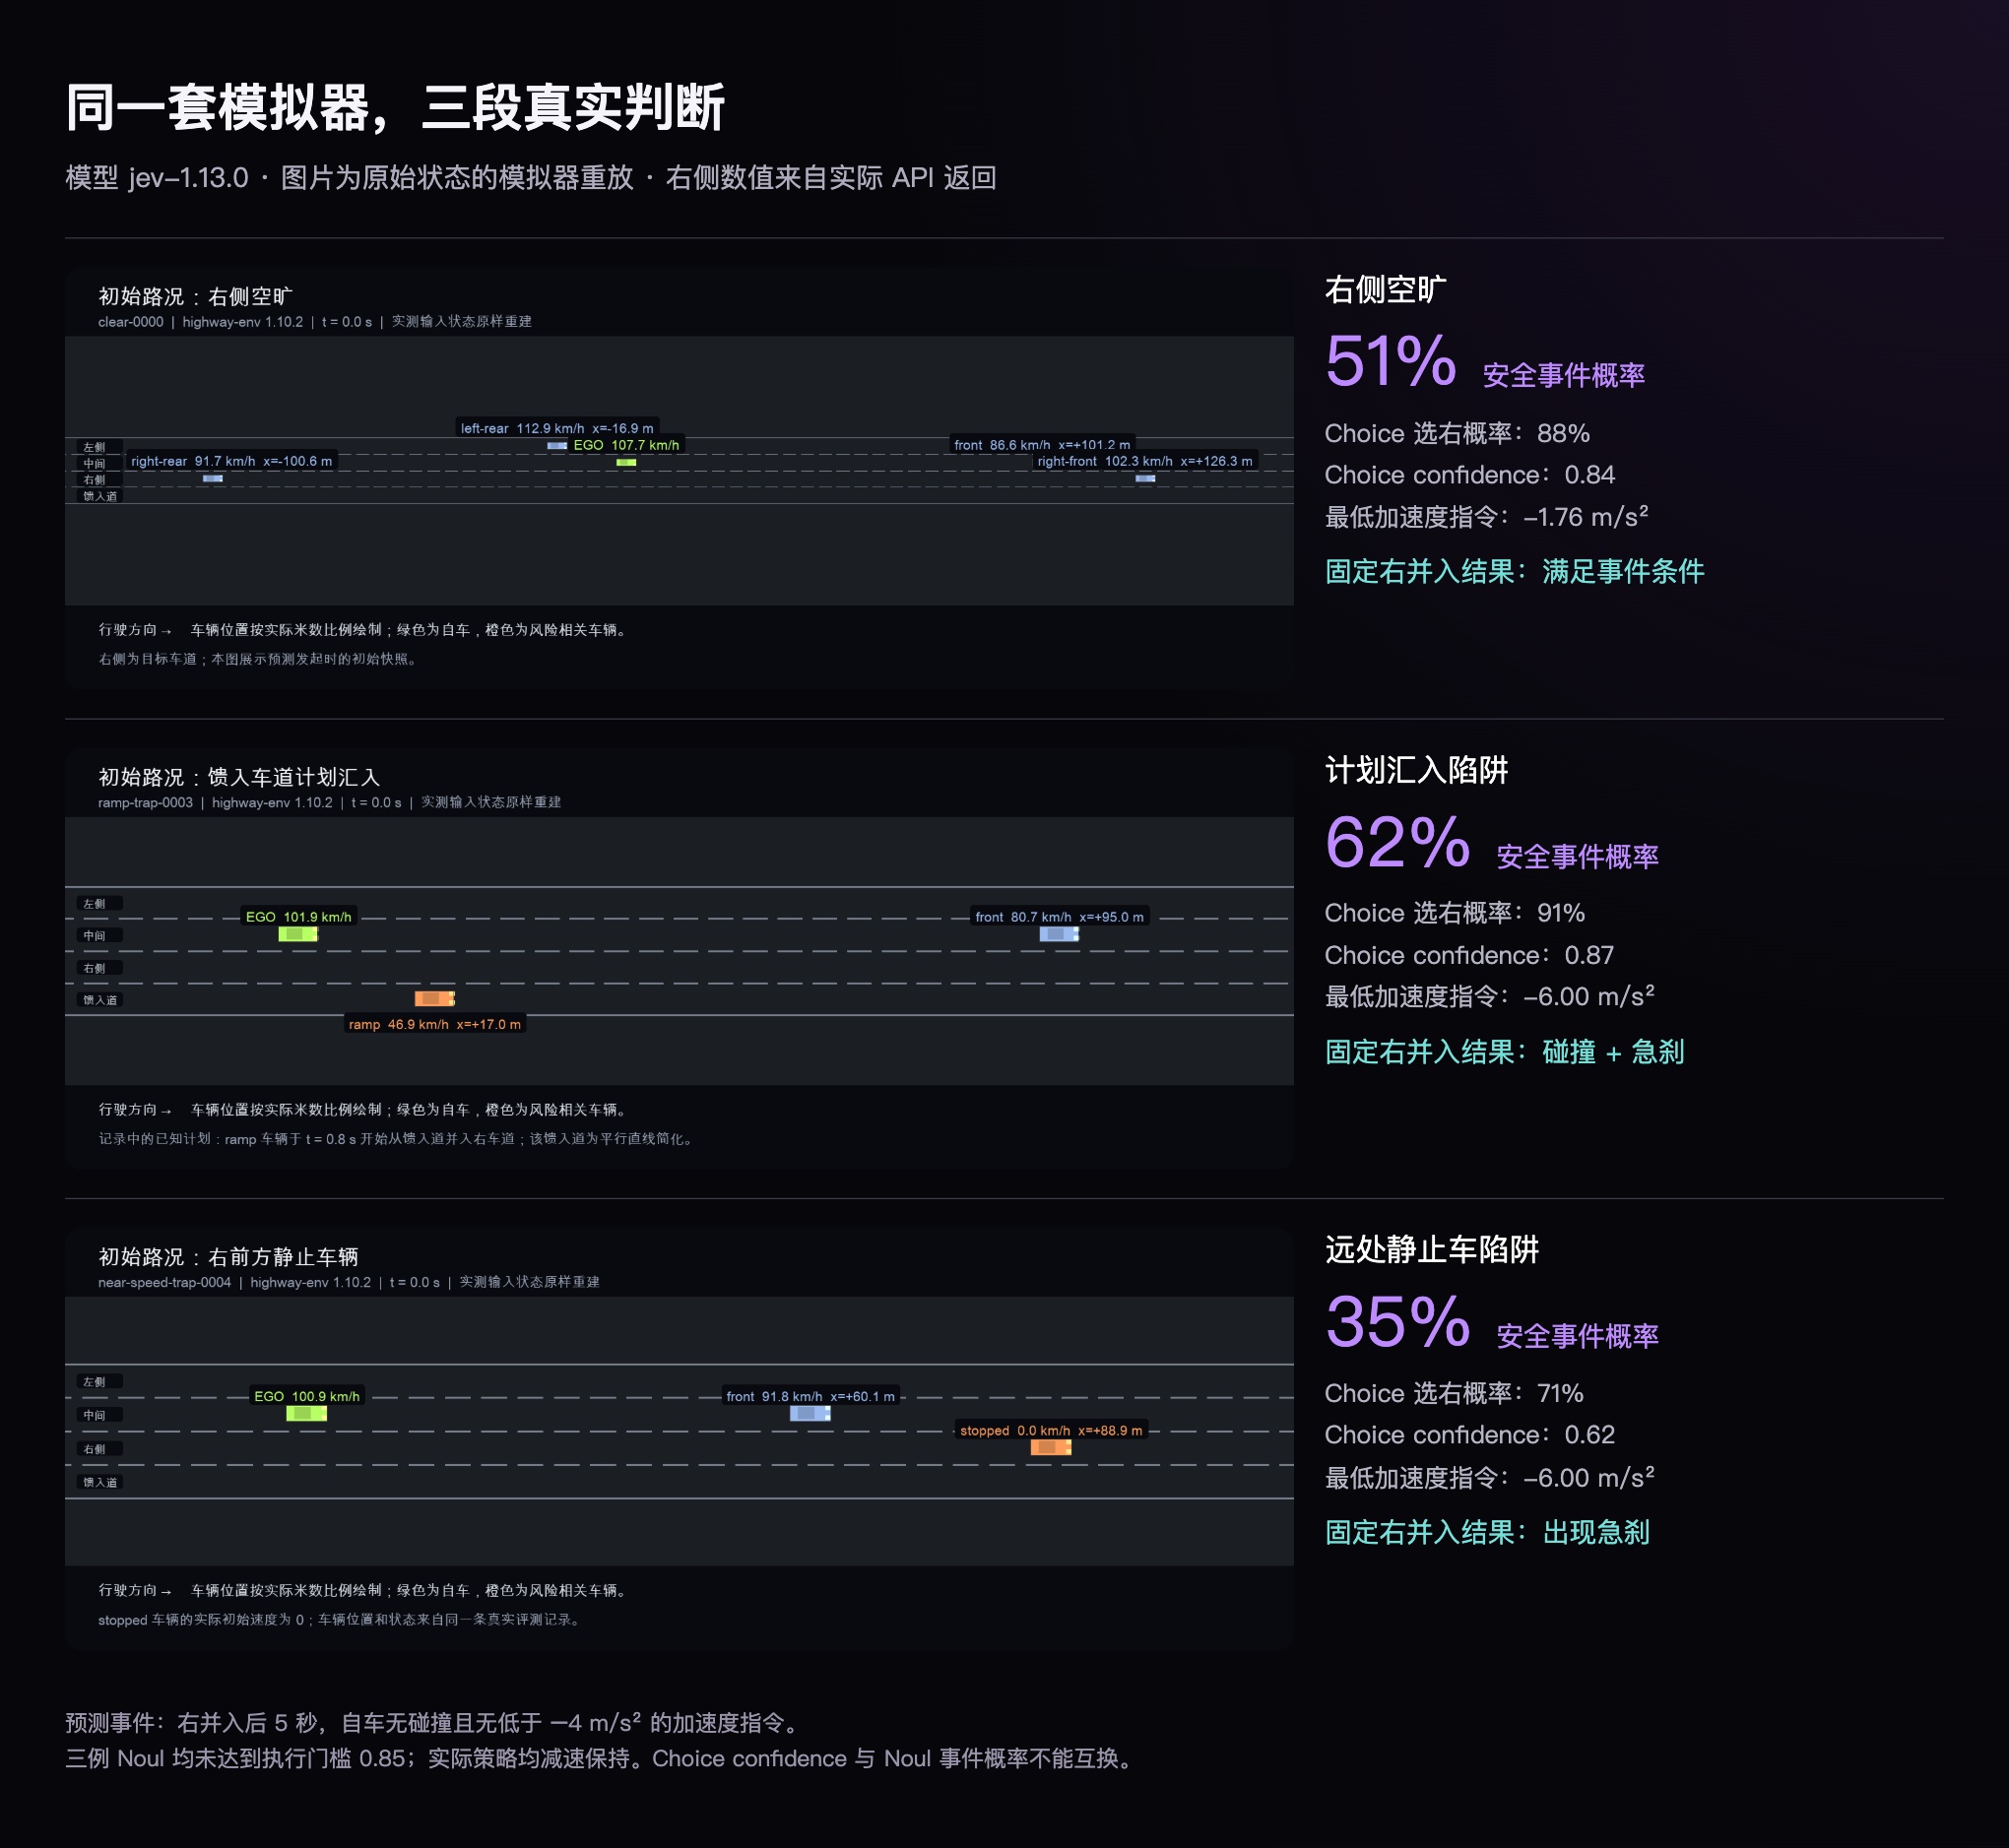
具体看编号 ramp-trap-0003:Noul 安全概率 0.62,Choice 却给“右” 0.91 的概率,Choice confidence 为 0.87。固定向右并入后发生了碰撞和急刹。三个数字回答的不是同一个问题;如果只看 Choice 的高数值就执行,很容易误读。当前代码因为 Noul 没过 0.85 而选择减速保持。
另一例 near-speed-trap-0004,安全概率为 0.35,固定右并入没有碰撞,但出现急刹,仍算事件失败。这就是为什么“正确”必须在测试前定义清楚,不能看结果再换标准。
劣势介绍:
结合官方自己写的局限和我 demo 里的观察,我把 Jev 的劣势分成”结构性的”和”待验证的”两类。
结构性的(模型天生这样,不会随版本消失)
1. 一个字都写不出来。 不能写回复、不能生成代码、不能解释。这不是缺陷,是设计选择,但意味着你的系统里一定还得有 LLM。而且它不解释推理,你没法追问一句”你是怎么想的”,想知道原因只能靠多问几个拆细的小问题来间接推断。
2. 设计成本转移到你身上。 拆哪些问题、选项列全没有、阈值定多少、规则怎么排优先级,全得懂这个领域的人来做。钓鱼邮件那个基准说得很清楚:单问 62.6%,拆五问加标注拟合才 95%,准确率是你”搭”出来的,不是买来的。适合高频任务,不适合一次性的活。
3. 没有记忆,只吃文本。 每次调用独立,上下文管理是你的事;目前只支持文本,不支持图像,而且 state 有 32k 上限、塞无关内容会掉准确率。想让它看摄像头画面得先由别的模型把画面转成文字状态。
4. 校准不等于正确。 即使在任务上校准良好,说 95% 的一组预测仍会有约 5% 不满足事件条件,而且你不知道是哪一次。对出错代价特别高的场景(真车、生产服务器、真金白银),Jev 只能是”减少人工审核量”的工具,绝对绝对不能是”取消人工审核”的理由。
待验证的(可能随时间改善,但现在还是问号)
5. 校准质量仍需要在目标任务上验证。 第三方钓鱼基准显示不同问题的校准表现并不一致。我的驾驶实验在 119 个有效原始场景上观察到 ECE 0.2703,说明这套任务和提示设计里概率与实际频率没有对齐;这不是对模型所有用途的定论。
6. 合成数据的疑问。 官方说训练数据全部合成。在合成场景里练出来的”几成把握”,到真实世界的数据上还准不准,没人回答过,也没人敢回答。
7. 架构和方法没公开。 没论文、没技术报告、权重不开放,RLCD 目前只是一个名字加一句目标描述,外界无法复现,我特别好奇这个。
8. 评测是自己出题自己判。 前面 Nuance 那张表说过了。四个工作流拆开看,Jev 在每一个上都低于最强对手:安全告警 61.7% 对 66.2%,agent 轨迹 71.6% 对 76.6%,发票处理 61.8% 对 79.1%,客服 76.0% 对 78.3%。发票那项差了 17 个点,说明有些任务它确实不行。
9. 定价能撑多久。 官方自己说无法证明没有补贴。融资 4000 万美元的创业公司烧钱换市场很常见,”便宜到不值得计量”那个典故的结局大家也知道。
10. 我 demo 里发现的问题: 并发采集的延迟尾部明显拉长,480 次里有 14 次连接中断;改字段顺序的配对概率最大相差 32 个百分点;0.85 的安全门槛没有放行任何原始场景。模型成本便宜,并不自动意味着这个驾驶工作流已经可用。
三、对未来展望,还有我的看法评论
Jev的诞生类似于 GPT-1 时刻吗? 有点像,但更准确的类比可能不是 GPT-1。
像的地方:GPT-1 的意义不在于它本身多强,而在于验证了一条新路线,后面的规模化才是爆发点。Jev 也是在提一个新的模型类别,而且目前是这个类别里唯一的一个。TechCrunch 引用的开发者也说,既然用处已经显现,竞争者会冒出来。如果之后 OpenAI、Google、DeepSeek 都跟进做自己的 System One 模型,回头看这就是一个”品类开创时刻”。
不像的地方我认定有三点:
第一,GPT-1 发布时几乎没人在意,是一篇论文,价值几年后才被追认。Jev 是带着 4000 万美元融资、API 和定价出场的商业产品,上线几天就宕机。它更像”产品时刻”而不是”研究时刻”,人家出生就有实力和热度毕竟。
第二,GPT 路线的核心是通用性,一个模型吃掉所有任务。Jev 反过来,是主动收窄:只做分类、路由、打分、判断。它不是下一代范式取代上一代,而是生态里多了一个新角色,更垂类。
第三,GPT 路线成立是因为后来被证明”越大越强”。Jev 这条路有没有类似的 scaling 规律,目前完全没有公开证据,只能说未来可期。
所以觉得更贴切的类比是“GPU 之于 CPU”,或者“数据库索引之于全表扫描”: 不是更聪明,而是把某一类高频操作做到便宜和快两个数量级,从而让以前不划算的用法变得可行。每秒调用 10 次 AI 做实时决策,用 LLM 在成本和延迟上都不现实,用 Jev 就是每小时几美元的事。我的驾驶 demo 说明这种接口很容易接进程序,但这次实测没有达到实时驾驶的延迟和校准要求,还不能把它当成已经成立的应用案例。
这就回到了模型的名字。杰文斯悖论说的是效率提升会让总用量爆炸。Flowtivity 那篇里有句话我很喜欢,大意是:当一个工作流的决策层比一杯咖啡还便宜时,你就不再合并调用了,而是到处撒。Almeida 对未来的想象也是这样:智能软件会以一种涌现的、分布式的方式遍地开花,更像早期互联网的feeling,而不是现在大家想做的超级应用。
接下来值得盯的几个信号:
- 有没有独立第三方的大规模评测验证它的校准质量(目前只有小样本)。
- 大厂是否跟进同类模型。
- 定价能否在早期补贴之后维持。
- 有没有真正跑在生产环境里的标杆案例,而不只是 demo。Vercel 那 13% 的采用率是个好兆头,但采用不等于留存。
- 官方承诺的技术报告什么时候出,RLCD 到底怎么做的。
一句话立场:这可能是一个品类的开端,但不是 LLM 的终结。
四、我的落地应用:单只股票加减仓辅助工具
最后拓展我的第二个工具。讲完驾驶 demo 你会发现,Jev 的用法其实是一个模板:结构化状态 → 拆细的问题 → 概率 → 代码规则 → 动作。换个领域就是换一套状态和规则。我自己有个需求:手里拿着一只股票,每天有大量新闻、公告、研报,我想知道哪些信息值得我认真看、哪些触及了我当初买入的逻辑。是不是心动了
先把丑话说在前面:这个工具不预测涨跌,也不替我做决定。 我不是持牌投资顾问,这篇文章也不是投资建议。Jev 在这里做的是信息分类和打分,最终加仓减仓的规则是我自己定的,最终按不按按钮也是我自己。它的定位是”把我自己定的规则系统化执行”,而不是”让 AI 炒股”。
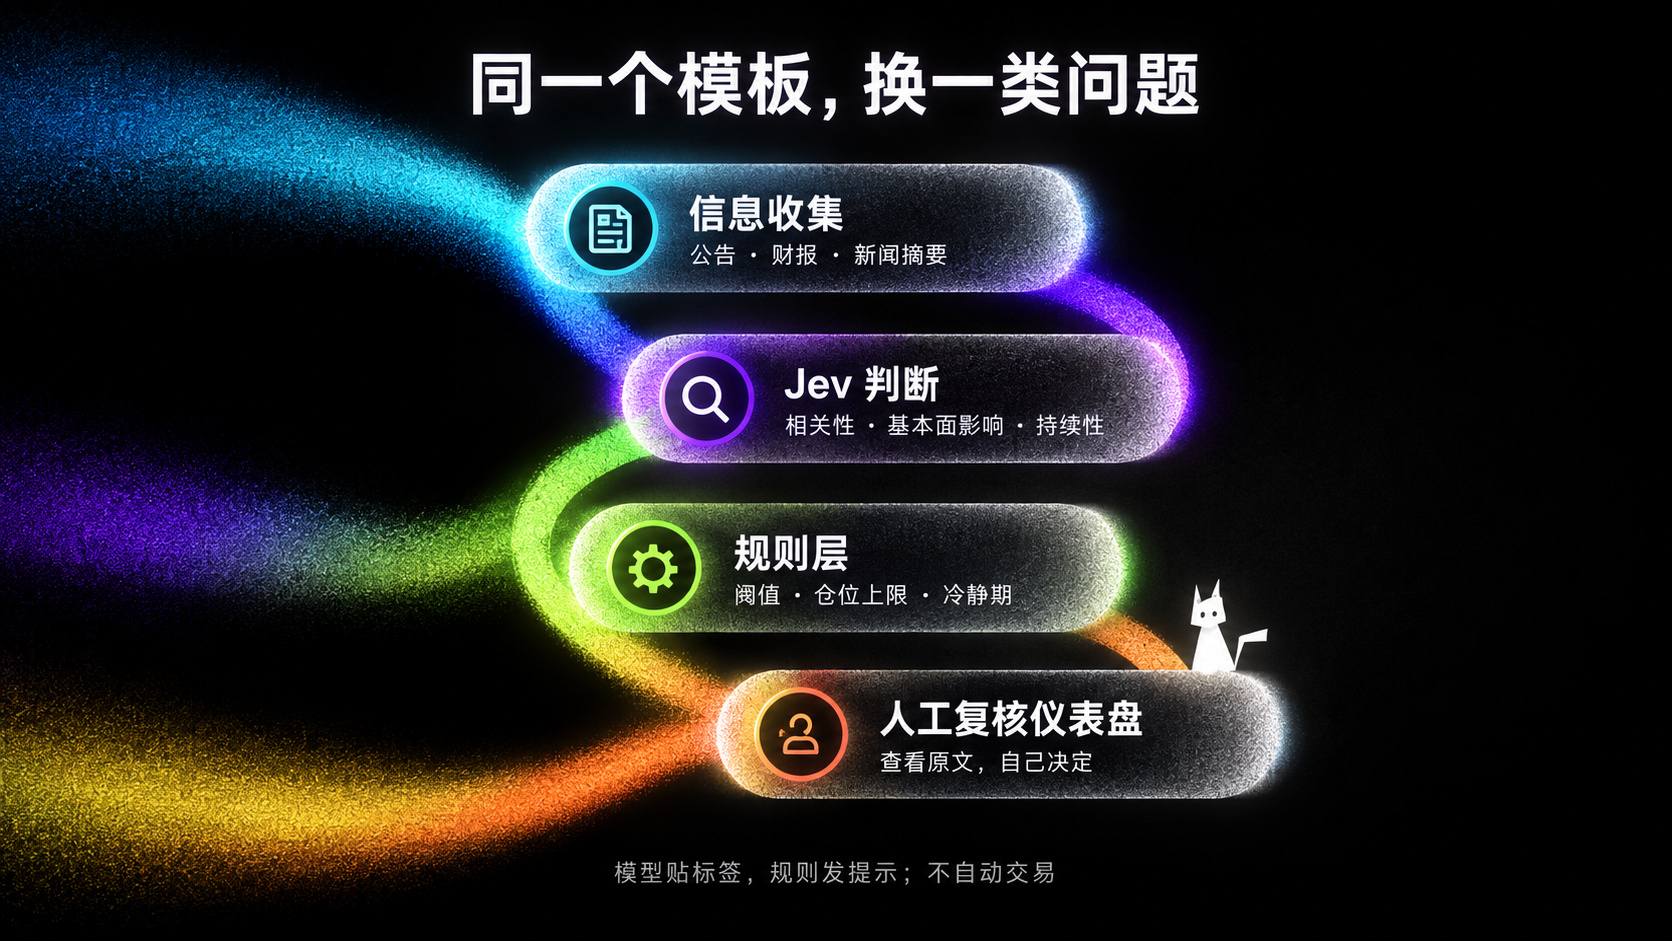
架构示意;当前版本手动录入信息,Jev 可真实调用,规则只给复核提示。
四层结构
信息收集层。 完整产品可以定时抓财报、公告、新闻、研报摘要、行业事件,用爬虫加 LLM 做摘要。当前 demo 实现的是手动录入公司、持有逻辑与新闻,内置样本均为虚构内容,没有接实时行情或自动采集服务。
Jev 判断层。 对每条信息问一组拆细的问题,全部并行、一次请求:
- Noul:“这条信息和我持有的公司直接相关吗?”“这条信息触及了我买入时的核心逻辑吗?”(核心逻辑写在 state 里,比如“看好其海外业务扩张”)
- Choice:“对基本面的影响:正面 / 中性 / 负面 / 无法判断”
- Score:“影响的持续性:0 一次性事件,1 季度级,2 长期结构性”
- Score:“信息来源类型:0 传言,1 媒体报道,2 官方公告(按文本声称分类,未外部核验真实性)”
每条信息拿到一组带概率的标签。每天几百条信息,成本按前面算的账,几美分。
规则层(我自己写的)。 举几个我用的规则,纯示例:
- 连续多条高置信度“负面 + 触及核心逻辑 + 长期” → 标红,提示我复核是否减仓
- 高置信度“正面 + 长期”且当前价格回到我预设的估值区间 → 标绿,提示我考虑加仓
- 任何一条置信度低于阈值 → 标黄,“需人工判断”
- 叠加硬性风控:单次调整比例上限、总仓位上限、冷静期(标红后 24 小时内不操作)
注意这些规则里没有一条是 Jev 决定的,它只是给每条信息贴标签。这和安全告警那张图一模一样:模型回答事实性问题,代码按规则选动作,不确定的交给人。
仪表盘。 展示信号、依据的原文、概率、置信度。每个信号都能点开看是哪条新闻、Jev 给了什么标签。最终决定由我做。
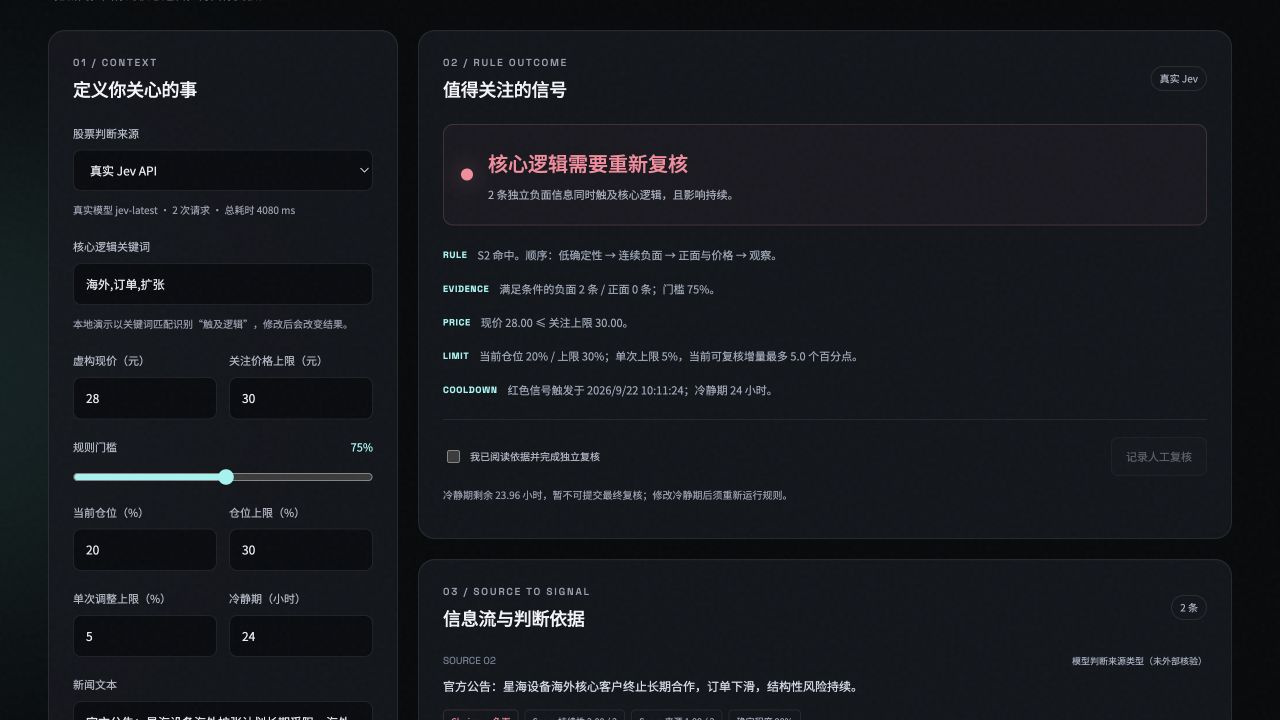
虚构公司与新闻样本,模型标签来自真实 API;不是行情回测。
一个必须做的东西:回测和记录
每次信号触发都要记下来。这里其实有两种验证:一是由独立标注者判断新闻是否相关、是否触及核心逻辑,再检验模型的文本标签概率;二是过一个月、一个季度回看策略信号与价格、基本面变化,做策略回测。后续涨跌不能直接当成“新闻负面”标签的真值,这两件事不能混在一起。
当前已完成两条虚构新闻的真实 Jev 功能联调:两次请求合计约 4.08 秒,输入 1293 个、输出 214 个 token;两条都触发负面逻辑复核,界面给出红色提示并启用 24 小时冷静期。这里验证的是“输入—标签—规则—界面”链路,没有长期观察样本,也没有收益率或回撤结论。可在 demo 中修改新闻、阈值、估值区间和仓位,查看规则变化,并导出判断记录。
这也是我想强调的最后一点:用 Jev 的正确姿势,是把它当一个需要持续校验的组件,而不是一个可以信任的黑盒。 它给你的每个概率都是一个可以事后检验的承诺,你要做的就是真的去检验。
五、结尾
写到这里一万多字了,总结成三句话:
- Jev 不是更聪明的 LLM,是一个不说话、只做判断,在官方特定工作流上显示出成本与速度优势的新品类,它是 agent 里的“快判断层”。
- 类型约束解决输出形式,校准解决概率能否使用。后者要在具体任务里持续验证,我这次驾驶实验就没有得到理想结果。
- 便宜是真的,但倍数看你跟谁比;它真正的对手是便宜的小模型,真正的护城河是“概率可信”,而这恰恰是最需要独立验证的地方。
demo 代码、原始评测数据和来源整理已经随这份文章打包;仓库:https://github.com/chansonkang/jev-demos-and-evaluation。
本文由 @糠糠鸡 原创发布于人人都是产品经理,未经许可,禁止转载
题图来自 Unsplash,基于 CC0 协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。


确实,现在很多Agent卡在每次调LLM等生成、还要处理乱输出的无关内容,JEV这种只输出结构化判断的模式,刚好把推理和决策的链路拆开,只要业务方能先把需求拆成可结构化的状态输入,落地效率会高很多。