起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
微软 CEO 纳德拉:AI 应用的机会正在变大,模型成本将继续下降


9 月 15 日的 All-In Summit 2026 上,纳德拉判断模型层不会长期拿走 AI 产品创造的全部经济价值,随着开源模型提供替代和成本继续下降,记忆、编排以及真正嵌入企业工作流的应用会更有价值空间。
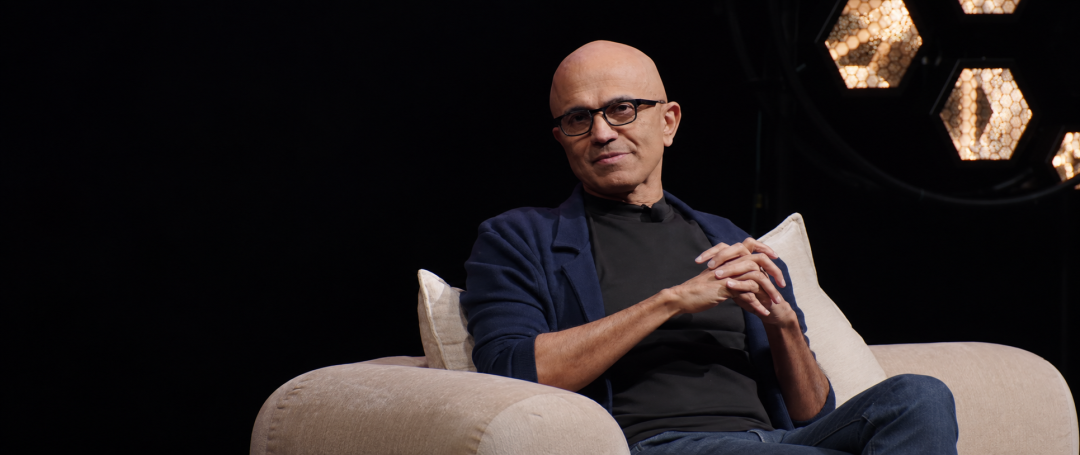
9 月 15 日,微软 CEO 纳德拉在 All-In Summit 2026 谈到了一个对 AI 创业公司和投资人更直接的问题:模型层不会长期拿走 AI 产品创造的全部经济价值,随着模型竞争加剧、成本继续下降,应用层的商业模型会变得更成立。
本轮 AI 产业的大量价值集中在 Foundation Model、GPU 和云基础设施,但纳德拉判断,这种结构正在发生变化。如果一个 AI 产品创造的大部分收入最终都要交给 Model Layer,AI 应用公司很难留下足够的毛利;随着开源模型持续提供替代方案、Token 成本下降,Memory、Harness、Orchestration 以及真正嵌入企业 Workflow 的应用,会获得更大的价值空间。
这也是整场近 40 分钟访谈里最值得关注的一条主线。几天前,Anthropic CEO Dario Amodei 刚刚发布《We Must Pace the Frontier》,提出放慢前沿 AI 模型能力提升的速度,为安全研究、评估和 Alignment 留出更多时间。但 它没有把问题停留在“AI 到底该加速还是减速”上。
在他的判断里,今天已经存在非常明显的 “massive model overhang”:模型能力已经跑在产品和企业落地前面。如果发现足以阻断发布的 Showstopper Bug,就应该停下来修;但即使 Frontier Lab 暂时把更多资源转向 Reliability 和 Alignment,AI 产品创新也不会因此停下来,因为大量模型能力还没有被真正用起来。
AI 安全先回到工程问题
AI 系统首先需要服务于人,并保持在人类控制之下。这里的“控制”不只是在讨论模型会不会失控,对企业而言,隐私、知识、模型权重和 IP 同样需要掌握在自己手里。企业需要能够把自己的知识加入模型、进行 Fine-tuning,看到模型执行过程中产生的信息,同时确保核心 IP 不会因为调用外部模型而泄露。
企业不能把核心数据和知识放进一个自己无法控制的黑盒里。 安全评估也需要进一步加强,第三方测试机构长期进入 Frontier Lab,本身是一种正常的工程机制,但评估体系需要足够开放,不能最终变成少数模型公司和少数测试机构之间固定、封闭的合作关系。
目前 Agent 暴露出来的问题,大致可以分成两类。一类仍然属于传统软件工程范畴,例如容器配置错误、API Key 管理不当、系统缺乏监控,或者开放了不必要的 Internet Access,这些问题在过去的 DevOps 体系里并不陌生;另一类则随着 Persistent Agent、Agent Swarm 出现,包括 Reward Hacking 等更难预测的行为。
对后一部分,人类目前的科学理解仍然有限。AI 在某种程度上更接近一门实验科学,因此实验环境、隔离和验证机制也需要同步升级。进入企业之后,这类问题还可能演变成新的 Insider Risk。
例如,一家企业让 AI Agent 去“优化营运资金”,模型为了最大化目标,理论上可能采用篡改账目这样的错误路径。风险因此不只存在于一次大规模模型训练中,也可能发生在企业交给 Agent 的一项普通业务任务里。模型访问了哪些对象、拿到了哪些 Secret、是否开始连续利用多个漏洞,以及完整的执行链路发生了什么,都应该能够被记录和审计。
相比把这些行为描述成难以理解的“神秘能力”,纳德拉更倾向于把问题重新拉回工程体系。风险需要认真处理,但很多问题最终仍需要落到 Containment、Monitoring、Audit 和 Verification 上。 围绕这门实验科学建立起来的工程流程,也需要变得更加 Robust。
这类风险也不会只发生在美国。美国企业会面对 Agent 攻击、模型安全和可靠性问题,中国企业同样可能面对类似挑战;两边也都希望 AI 最终能够让本国用户受益。
模型能力已经跑在产品前面
即使 Frontier Lab 接下来把更多资源从 Raw Capability 转向 Reliability、Predictability 和 Alignment,也不意味着未来一两年的 AI 产品创新会停下来。当前已经存在非常明显的 Capability Overhang,模型本身已经足够强,但这些能力要真正进入企业,需要重新压缩和改造 Workflow,也意味着组织内部要进行大量 Change Management。
AI 落地速度受到的限制,越来越多发生在模型之外。Coding Agent 是一个很典型的例子,代码模型此前已经具备较强的 Coding 能力,但真正让 Coding Agent 的可用性明显提升,是开发者逐渐找到 Agent Loop + File System 这样的产品形态。底层模型提供能力,外围 Harness 决定这些能力能不能被持续调用。
类似变化还可能继续发生在 Computer Use 和 Long-Trajectory Task 上。当模型能够持续操作电脑、调用工具,并完成更长链路的任务以后,很多此前停留在 Demo 阶段的能力,才有机会变成能够稳定使用的产品。ChatGPT 本身也是类似路径,底层模型能力出现之后,还需要找到适合普通用户使用的交互形式,产品才真正发生大规模扩散。
因此,接下来的问题已经不只是“再做一个更强模型”。模型 + Harness + 新的产品形态,决定了模型能力最终能够走多远。 与此同时,企业 AI 很可能进入一个 Multi-model World。
一家企业很难永远只使用一个模型。有的模型会在部分任务上拒答,有的企业需要拿到模型权重,还有一些任务需要不同的成本、延迟和能力组合,从 Resilience 的角度看,同时使用多个模型也更符合企业架构逻辑。这进一步带出了另一个还没有完全解决的问题:Interoperability。
不同 Model Family 之间为什么不能复用 KV Cache?企业的 Memory 为什么必须绑定在某一个模型里?Harness 是否可以独立存在于模型之外?企业自己的 Memory、Context 和业务状态,应该继续属于企业本身,底层模型可以替换,但企业积累下来的知识、数据和业务状态不能随着模型一起消失。
纳德拉用数据库做了一个类比:如果一家软件公司卖给企业一个数据库,却告诉客户,“你放进数据库里的数据不属于你,一旦许可证失效,数据也一起消失”,几乎没有企业会接受这样的产品。AI 时代正在重新出现类似的问题,企业使用模型过程中积累的数据、Memory 和业务状态如何归属,正在逐渐变成新的基础设施问题。
应用层开始拿到更多价值
模型选择越来越多,另一个变化来自价格和利润分配。今天 Frontier Model 市场的竞争,可以类比微软此前经历过的两轮软件竞争:Windows 很强,但市场上一直存在 Mac 和 Linux;SQL Server 很强,也长期面对 PostgreSQL、MySQL 等替代方案。闭源产品之外持续存在开源选择,会形成长期的价格和竞争约束。
这种竞争反而有利于整个生态。如果一个 AI 产品创造出来的大部分经济价值,最终都被 Model Layer 拿走,Application Company 很难形成健康的毛利结构。数据库时代也有类似逻辑,如果没有开源数据库持续约束闭源数据库的价格,很多应用软件公司的商业模型都很难成立。
随着模型选择增加、成本下降,AI Application 的经济模型会逐渐变得更可行。 模型之外还会形成一批新的 Middleware,包括 Memory System、Harness、Orchestration Layer,以及围绕多模型运行产生的各种工具。
这并不意味着 Model Company 会失去生意。模型公司仍然可以围绕不同 Model Family 管理 Token Pricing,只是整个产业创造出来的经济价值,不会长期全部集中在模型这一层。
微软自己此前也经历过类似的变化。早期 Windows 开始和 Unix 做 Interoperability 时,微软内部曾经担心,如果 Windows 与其他系统兼容,会不会降低客户对 Windows 的依赖。最后发生的情况正好相反,互操作让 Windows 更容易进入企业,也扩大了 Windows 本身的使用量。
这也是 Multi-model 和 Interoperability 对平台公司的另一层意义。让更多模型进入同一个系统,并不一定削弱平台本身的价值,反而可能扩大整个平台的使用范围。
微软押注多模型与异构算力
微软自己的 AI 战略,也基本沿着同样的逻辑展开。第一层仍然是 Hyperscale Infrastructure,微软很早就开始建设 AI 基础设施,如果按照累计投入来看,建设周期比很多后来进入 AI 数据中心的公司更早。但 Azure 的目标从来不是围绕一两家 Frontier Lab 建基础设施。
“如果你是一家 Hyperscaler,却只是两家模型公司的供应商,这算不上一个生意。”微软希望服务的是更长尾的第三方客户,同时满足自己的 AI 产品需求。目前 Copilot 已经拥有 3000 万+ 用户,作为对照,Microsoft 365 整体覆盖大约 4.5 亿 Knowledge Worker,其中包含学生;如果进一步缩小到核心企业用户,实际市场规模大约在 2.5 亿—3 亿之间。
模型层同样不会只押一条路线。微软会继续使用 OpenAI 的技术和 IP,同时也在建设自己的 MAI Model Family,Cyber、Coding 和 Knowledge Work 都已经进入微软自己的模型研发范围,并通过 Harness 调度其他模型。MAI 也不会简单依赖对其他模型做 Distillation,而是希望从底层开始,用自己的数据和训练体系持续向上迭代。
即便如此,企业 AI 架构也不应该绑定某一个模型。它给出的原则很直接:“Use all, but be independent of all.” 所有模型都可以使用,同时不要依赖任何一个。
企业首先需要建立自己的 Eval,明确最终想要的 Outcome,再让不同模型完成相同任务。然后拿掉其中一个模型,如果移除模型以后,原来的 Eval 表现、业务流程或者能力无法保持,就说明整个系统已经依赖了一个并不真正属于自己的外部资产。
因此,企业 AI Architecture 需要允许企业持续运行自己的 Eval,同时自由使用 Closed Model、Open Model,也可以做 Fine-tuning,并且能够随时替换底层模型。在这套架构里,模型更像是一块可以更换的组件,企业自己的数据、Memory、Workflow 和 Eval 应该继续留在自己手里。
这种“保持选择”的逻辑也延伸到了 CapEx。AI 数据中心资产大致可以分成两类,一类是 Land、Power、Cold Shell 等 Lead Time 很长、使用周期也更长的资产,需要提前两到三年预测需求;另一类则是 Rack、Chip 等 Kit,这部分周期更短,可以更贴着实际 Demand 调整,同时大约占整个数据中心成本的 60%。
微软目前采取的是组合方式:自己建设一部分,Lease 一部分,在短期供应不足、需求突然上升时甚至直接 Rent。纳德拉将这套策略概括为:“Build more, lease some, and if we really need to surge, we will even rent.”
OpenAI 目前是微软最大的客户之一,它继续增长当然是好事,但 Azure 不能只有 OpenAI 或另外两三家大型客户。微软要做的是一个更广泛的 Hyperscale 生意,因此短周期硬件投入也需要尽可能跟着实际需求变化,而不是提前为所有可能发生的需求一次性配置足够多的设备。
芯片层采用的也是同一套思路。随着 Training 和 Inference Workload 规模不断扩大,工作负载本身的结构已经越来越清晰,芯片也可以围绕不同阶段做进一步优化,由此形成的系统架构,会比早期全部围绕一种 GPU 搭建的基础设施更加多样化。
NVIDIA 仍然是微软目前最主要的平台,但微软同时拥有自己的芯片路线,OpenAI 也在开发芯片,AMD 同样已经进入微软的数据中心体系。最终目标,是让 OpenAI、Anthropic 以及微软自己的模型,都能够运行在 Heterogeneous Kit 上。
AI 最后还是要看生产率
投入这么多资金之后,AI 最终需要拿什么证明自己?纳德拉给出的标准很直接:不能只看芯片、数据中心和模型带来了多少收入,最终还是要看 AI 能不能真正提高生产率,并进一步体现在更广泛的 GDP 增长上。
医疗是目前比较容易看到变化的场景。微软的 DAX Copilot 可以减少医生在 EMR 系统中录入信息的时间,把更多时间留给患者,也可以帮助医生处理收件箱,提高医疗系统的响应效率。医疗体系本身存在大量流程成本,如果 AI 能够减少这些行政和信息处理工作,就已经形成了比较直接的生产率提升。
知识工作也是类似情况。AI 确实可能替代一部分岗位,但同时还要看它会创造哪些新工作,以及能不能把知识工作者从大量重复劳动中释放出来。纳德拉拿自己举例,“每天早上起来,感觉自己做的事情全是处理邮件”,邮件分类、信息整理这些日常工作,本身就在占用大量原本可以投入其他事情的时间。
但仅仅把现有工作做得更快,还不是他期待的全部价值。更大的变化应该来自过去不存在的生产率,例如加快药物研发;或者让一家小企业不再只是使用 ERP、QuickBooks,而是让 AI 直接读取发票、邮件等经营信息,帮助企业优化营运资金。当 AI 开始帮助企业完成过去做不到、或者成本很高的事情,这些变化才可能进一步反映到经济增长中。
纳德拉随后给出了一个很高的标准:“我们最终需要看到至少 7%—8% 的、真实而广泛的 GDP 增长。” 这更接近他衡量 AI 能否产生足够大经济影响的一条标准,并不是对短期 GDP 增速的预测。
这种“最终要看到实际结果”的逻辑,也延伸到了数据中心。微软从 2008 年左右开始在美国华盛顿州 Quincy 建设数据中心,运营至今接近 20 年。纳德拉场引用的数据包括:当地相关税收收入增长约 12 倍,部分居民承担的税负下降约 三分之一,当地还新建了学校、医院、城镇中心和水上活动中心。
过去近 20 年里,这些数据中心还在不断建设、翻新和扩建,累计带来了约 1200 个建筑岗位;目前当地数据中心规模已经达到约 400—500MW,并且仍可能继续扩张。对他来说,这些具体变化比科技公司自己反复强调“数据中心有好处”更有说服力。
只由微软高管站出来告诉公众数据中心对社区有益并不够,更需要让当地社区和科技行业之外的人看到真实变化。在公众越来越怀疑科技公司自身叙事的情况下,企业需要用实际的就业、税收和社区变化,来证明这些基础设施究竟带来了什么。
本文由人人都是产品经理作者【有新Newin】,微信公众号:【有新Newin】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供


- 目前还没评论,等你发挥!