起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
企业把内部数据交给AI前,必须答对的7个问题


一个采购人员拿到六十多页的供应商合同,想让 AI 帮忙提取付款条件、违约责任和验收条款,却在把文件拖进对话框之前犹豫了:这份合同算不算机密?企业把内部数据交给 AI 之前,至少要回答这七个问题。
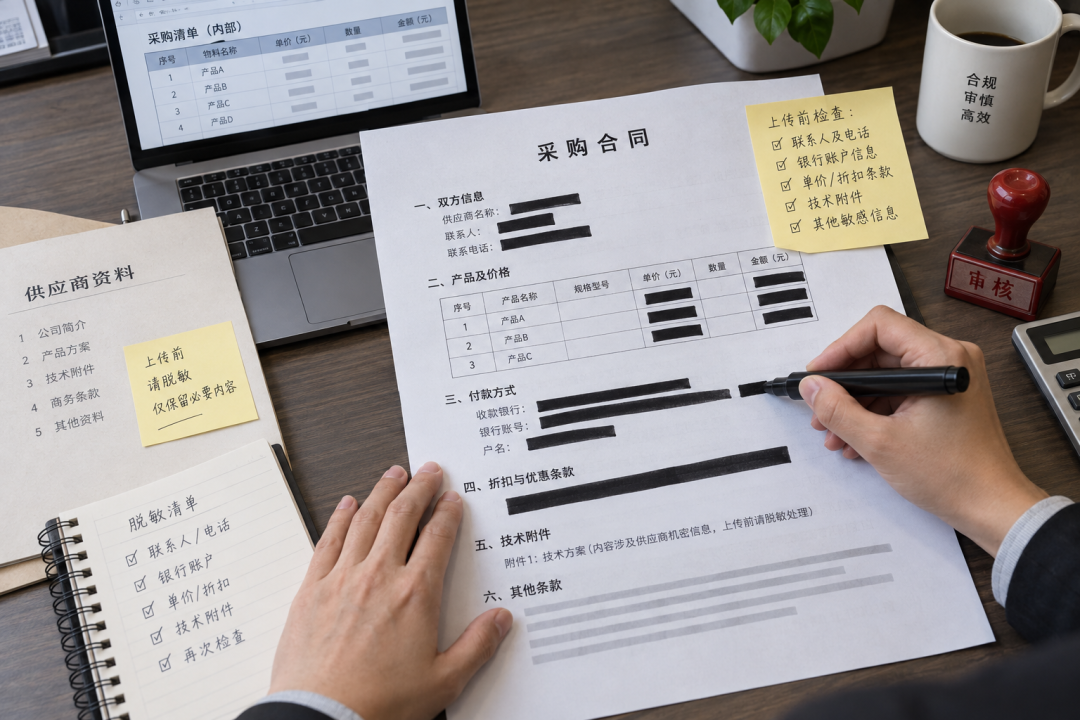
一个采购人员拿到六十多页的供应商合同,想让 AI 帮忙提取付款条件、违约责任和验收条款。文件拖进对话框之前,他通常只会犹豫一件事:这份合同算不算机密?
问题恰恰出在这里。合同正文里可能有公开的产品说明,也有联系人姓名和电话、收款账户、未公开的采购单价、折扣规则、技术附件及盖章页。同一份文档,可能同时装着公开信息、个人信息、敏感个人信息和商业秘密。 如果企业只给文件贴一个“内部”标签,很难回答其中哪些内容可以交给 AI,哪些字段需要遮蔽,哪些必须走审批。
我认为,企业不应急着制作一张“可喂数据清单”。清单很容易过期,同一份数据放进不同账号、不同模型和不同业务流程,风险也会变化。更可靠的做法,是把每次 AI 数据使用当成一次有条件的数据处理,依次检查业务目的、数据等级、处理环境和结果责任。
一份采购合同,为什么不能只贴一个标签
把上面的合同拆开看,情况会清楚很多。
产品名称、已经公开的规格参数和官网手册,通常可以作为低风险材料使用。联系人姓名和手机号码属于个人信息;银行账户属于法律列举的敏感个人信息类型。处理敏感个人信息需要具备特定目的、充分必要性并采取严格保护措施,在以同意作为处理依据时还要取得单独同意。
采购价格、折扣底线、供应商评估结果和技术附件则要看企业是否采取了保密措施,以及这些信息是否不为公众所知悉、具有商业价值。符合这些条件的技术信息、经营信息,可能构成商业秘密。 员工把它们复制到未经批准的外部工具中,已经超出一般的工具使用问题,还可能改变数据原有的保密边界。
这也解释了为什么很多企业的第一版制度不好用:它把“合同”“客户数据”“代码”当成完整物件管理,业务现场却需要处理某个字段、某段条款、某个代码片段。AI 数据治理的最小单元,应从“文档”下沉到“字段、片段和权限”。
“可输入”是一组处理条件
《数据安全法》要求建立数据分类分级保护制度,根据数据的重要程度,以及遭到篡改、破坏、泄露或者非法获取、非法利用后造成的危害程度实施分类分级保护,并对重要数据实行重点保护。 国家标准 GB/T 43697—2024《数据安全技术 数据分类分级规则》已于2024年10月1日实施,为数据分类分级和重要数据识别提供了通用规则。
这些规定放到 AI 场景里,不能简单翻译成“高等级数据一律禁用”。同一类数据是否可以处理,还取决于企业为什么使用、用什么环境、给谁看、保留多久、能否删除。
例如,员工通讯录用于内部会议纪要中的人员名称校对,与把整张通讯录上传到公开账号训练一个写作助手,处理目的和必要性完全不同。《个人信息保护法》第十三条列出了多种个人信息处理依据,同意只是其中之一,订立或履行合同、人力资源管理、履行法定职责等情形也可能构成处理依据。 因此,企业需要回答“这个 AI 任务是否落在原来的处理目的内”,不能只问“有没有拿到过一次同意”。
企业内部没有一张脱离场景、账号和部署方式的永久白名单。 一项数据能否输入 AI,要由处理条件共同决定。
先把三种 AI 环境分开
很多争论看上去在谈数据,实际混在了一起的是三种完全不同的工具。
公开消费级账号通常由员工自行注册,企业难以统一控制身份、权限、插件、数据保留和离职后的访问。它适合公开资料、已发布制度、产品公开手册,以及经过可靠匿名化或脱敏、无法回推到具体个人和商业事项的材料。公开消费级账号只处理公开数据和已完成脱敏的低风险材料。
企业级 SaaS 或 API 具备组织账号、合同条款、管理员控制、日志和数据处理承诺,可以承载更多内部信息,但仍需逐项核对:输入和输出是否用于模型训练,滥用监控日志保存多久,是否存在功能级持久化,数据由哪些主体和地区处理,删除如何执行。以 OpenAI API 为例,截至2026年9月21日,官方文档说明 API 数据默认不用于训练,除非客户明确选择加入;同时,默认的滥用监控日志最长可保留30天,部分端点还会保存完成相应功能所需的应用状态。 “不用于训练”只回答了一个问题,并不等于数据不会被留存、被人工访问或跨区域处理。
私有化、专有云或受控 VPC 环境可以进一步收紧网络、存储和运维边界,适合知识库检索、代码辅助、工单分析等内部场景。部署在企业网络里也不代表自动合规,权限继承、向量库副本、日志内容、模型输出和管理员账号仍然需要治理。把模型搬进机房,只是换了风险发生的位置。
四道闸门怎样落到项目里
第一道闸门检查目的和权限。业务负责人要说清楚 AI 完成什么任务,为什么必须使用这些数据,现有授权、合同、制度或法定义务能否覆盖。一个“帮我分析一下”的提示词,通常不足以证明整库数据都有必要进入模型。
第二道闸门检查数据内容。项目团队应识别个人信息、敏感个人信息、商业秘密、重要数据、知识产权材料和各类凭证密钥,并完成字段级删除、替换、汇总或抽样。姓名可以替换成角色编号,手机号可以删除,客户明细可以改为区间统计,长合同可以只截取待审条款。能少给一个字段,就不要给整张表;能给片段,就不要给整份文件。
第三道闸门检查服务边界。《网络数据安全管理条例》自2025年1月1日起施行。向其他网络数据处理者提供、委托处理个人信息和重要数据时,应通过合同约定处理目的、方式、范围和安全保护义务,并对接收方履行义务的情况进行监督。 落到采购表里,至少要有训练使用、保存期限、删除机制、访问主体、处理地域、分包方、事件通知、审计能力和服务终止后的数据处置。
第四道闸门检查输出和责任。AI 可能在答案里复述输入数据,也可能根据权限之外的知识片段拼出敏感结论。面向客户的回复、员工评价、信贷风控、财务判断、合同结论等高影响输出,应设置人工复核、引用来源、操作日志和纠错渠道。谁提交、谁批准、谁复核,需要在流程中留下记录,不能用一句“AI 生成,仅供参考”统一收口。
哪些数据通常可以用,哪些要停一下
如果企业需要一份能执行的初始规则,可以按下面三档起步。
可以直接进入已批准 AI 环境的,通常包括:已经公开发布的资料;企业明确允许内部广泛共享的制度与知识;不含个人信息和机密内容的模板;经过验证的匿名化数据;为测试专门构造的合成数据。这里的“直接”仍然受账号和用途限制,公开资料也可能受著作权、许可范围或版本时效约束。
完成处理或审批后可以使用的,包括:含员工、客户、供应商个人信息的业务记录;内部合同、工单、会议纪要;源代码和配置文件;经营分析明细;尚未发布的产品资料。常见措施是删减字段、去标识化、切分片段、限定角色、改用企业级环境、关闭非必要插件,并设置自动到期。
需要直接拦截的,包括账号口令、私钥、访问令牌、生产数据库连接信息,以及企业制度明确禁止外发的数据。国家秘密以及依法禁止进入非涉密信息系统的数据,直接划入红线。 新修订的《保守国家秘密法》自2024年5月1日起施行,明确禁止在互联网及其他公共信息网络或者未采取保密措施的有线、无线通信中传递国家秘密,也禁止在私人交往和通信中涉及国家秘密。
“重要数据”也不能被粗暴理解成某个固定文件夹。企业应结合行业目录、地区目录和自身分类分级结果识别,不能由普通员工在上传时临场猜测。没有完成识别和审批的高敏数据,先阻断,再由数据安全、业务和法务共同判断。
规则要长进系统里
《生成式人工智能服务管理暂行办法》主要适用于向中国境内公众提供生成式人工智能服务;行业组织、企业、教育科研机构等研发、应用生成式人工智能技术,未向境内公众提供服务的,不适用该办法。 这条边界很重要,但它不等于企业内部使用 AI 没有约束。个人信息保护、数据安全、保密、商业秘密、合同和行业监管仍然存在。
因此,一份员工承诺书远远不够。企业至少要把规则做进四个位置:身份系统决定谁能用哪类 AI;数据目录和标签告诉系统哪些字段需要遮蔽;网关或代理记录提交、拦截和审批;知识库继承源系统权限,避免一个普通员工借助检索增强功能看到原本无权访问的文件。
项目上线前,可以用七个问题做收口检查:
- 这次任务的业务目的和责任人是谁?
- 输入是否包含个人信息、敏感个人信息、商业秘密、重要数据或涉密信息?
- 能否删除字段、改用片段、汇总数据或合成数据?
- 当前账号属于公开消费级、企业级服务还是受控私有环境?
- 供应商是否训练、留存、人工访问或向其他处理者提供数据?
- 输出由谁复核,错误和泄露如何发现、撤回与追踪?
- 人员离职、项目结束或合同终止后,数据和权限怎样清理?
企业内部数据能不能喂给 AI,最终不取决于它叫“合同”“客户数据”还是“内部资料”。判断应落到具体任务、具体字段和具体环境。最终放行条件是:目的清楚、数据最小、边界可控、结果有人负责。 当这四件事无法说清楚时,先别点发送;当它们能够被系统验证、被日志追踪,AI 才算真正进入了企业流程。
本文由人人都是产品经理作者【老司机聊数据】,微信公众号:【老司机聊数据】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供


- 目前还没评论,等你发挥!