起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
1000000块GPU的集群,光在连线上就要烧掉180兆瓦


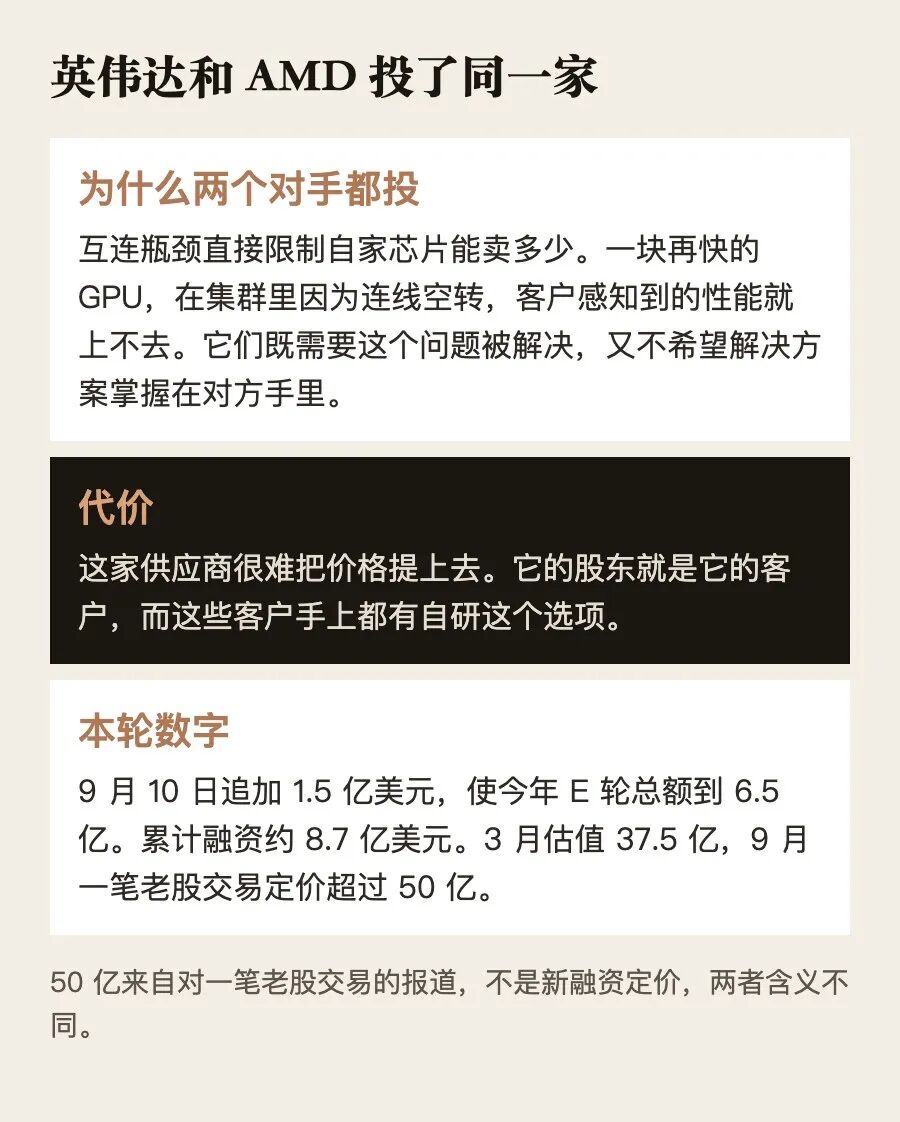
Ayar Labs 拿到 1.5 亿美元追加融资,这轮总额推到 6.5 亿美元,投资方名单里有英伟达和 AMD。它做的事很窄:把芯片之间的连线从铜换成光。背后是百万块 GPU 的集群光在连线上就要烧掉 180 兆瓦的物理上限。
9月10日,硅谷公司 Ayar Labs 宣布再拿1.5亿美元。
这笔钱是今年3月那轮5亿美元 E 轮的追加,把这一轮的总额推到6.5亿美元。公司累计融资约8.7亿美元。3月那轮对应的估值是37.5亿美元,而据9月的报道,一笔老股交易的定价已经超过50亿美元。
投资方名单里有英伟达和 AMD。
这家公司做的事情听起来很窄。它想把芯片之间的连线从铜换成光。
但这件事背后有一个正在逼近的物理上限,而这个上限决定了未来几年 AI 数据中心能不能继续变大。
01 算力不是唯一的瓶颈
大多数关于 AI 基础设施的讨论停在两件事上,芯片够不够快,电够不够用。
还有第三件事,它在过去两年才变成主要矛盾。芯片之间的数据交换。
训练一个大模型不是一块 GPU 的事,是几千到几万块 GPU 协同的事。每一步计算之后,这些芯片要互相交换中间结果。交换得越慢,越多的芯片在等待,而等待中的 GPU 仍然在耗电。
交换的是什么,可以具体说一下。训练时每块芯片拿到一部分数据,各自算出一组参数更新量,然后所有芯片要把这些更新量汇总再分发回去,让每块芯片手上的模型保持一致。这个动作每一步都要做一次,而一次训练有几十万到几百万步。
参数量越大,每次要汇总的数据越多。模型规模的增长,因此同时推高了两件事,算力需求和通信需求,而后者的增长往往更快。
所以一个集群的实际算力,不等于把所有芯片的标称算力加起来,它取决于这些芯片之间连得有多好。
行业里有一个大致的规律,网络带宽的需求每两到三年翻一倍。这个速度和芯片本身的迭代速度差不多,问题在于,连线的物理基础跟不上这个速度。
02 铜线撞上了一堵墙
芯片之间的电信号走在印刷电路板的铜走线和连接器上。信号频率越高,这些铜线上的损耗越大。
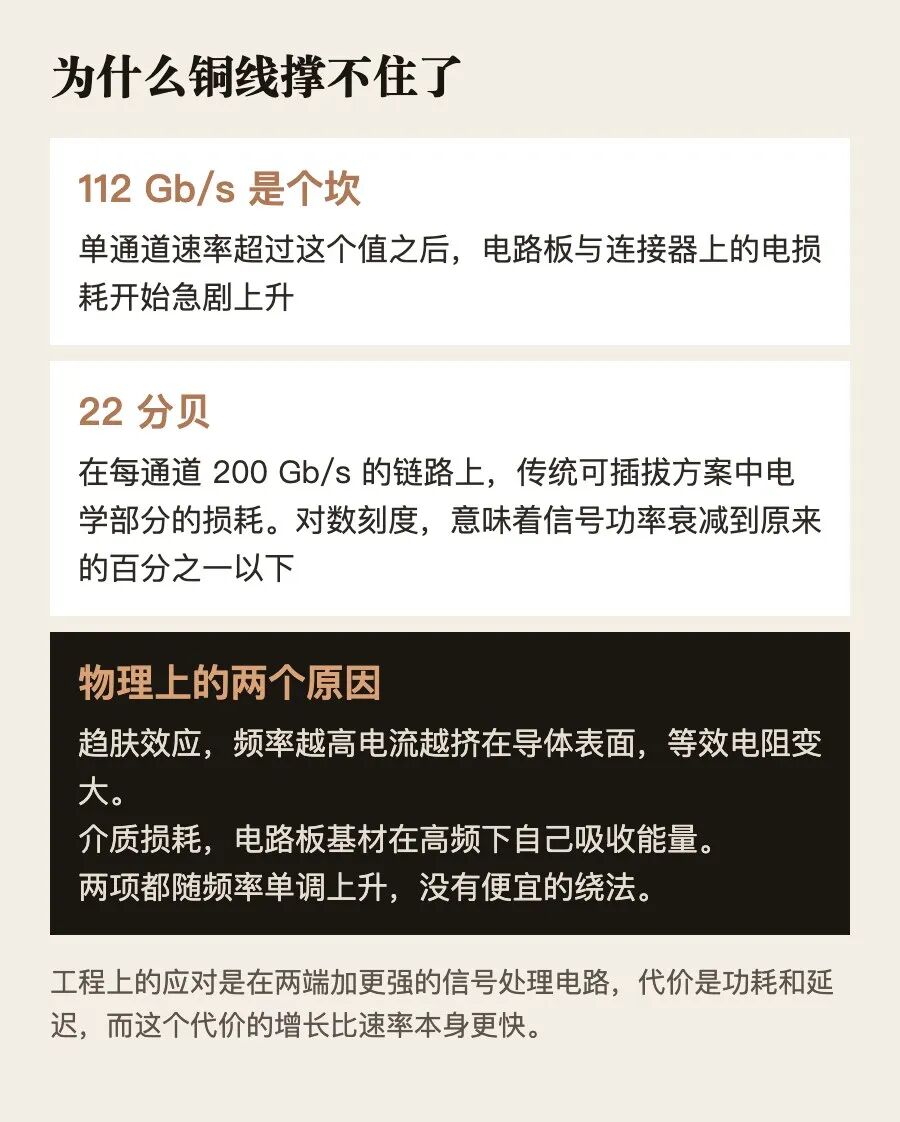
有一个门槛值得记住。当单通道速率超过每秒112吉比特之后,电路板和连接器上的电损耗开始急剧上升。
给一个具体的量级。在每通道200吉比特的链路上,一套传统的可插拔光模块方案,其中的电学部分损耗可以达到22分贝。
分贝是对数刻度,22分贝意味着信号功率衰减到原来的百分之一以下。要把这样的信号还原出来,接收端就得上更复杂的电路。电路越复杂,功耗越高,延迟也越长。
损耗为什么随频率上升,物理原因有两层。一层是趋肤效应,频率越高,电流越集中在导体表面很薄的一层里,等效电阻因此变大。另一层是介质损耗,电路板基材在高频下本身会吸收能量。这两项都随频率单调上升,而且没有便宜的办法绕开。
工程上的应对是在两端加更强的信号处理电路,业内叫 SerDes。它能把衰减和失真补回来一部分,代价是功耗和延迟。随着速率上升,这个代价的增长比速率本身更快。
铜线在高频下失效的两个物理原因。Sense AI 整理自公开技术资料
铜的另一个限制是距离。速率越高,铜能传的距离越短。这对机架内部影响还不大,但当一个训练任务需要跨机架、跨机柜组网时,铜就到头了。
03 把这件事换算成电费
这是最能说明问题的一组数字。
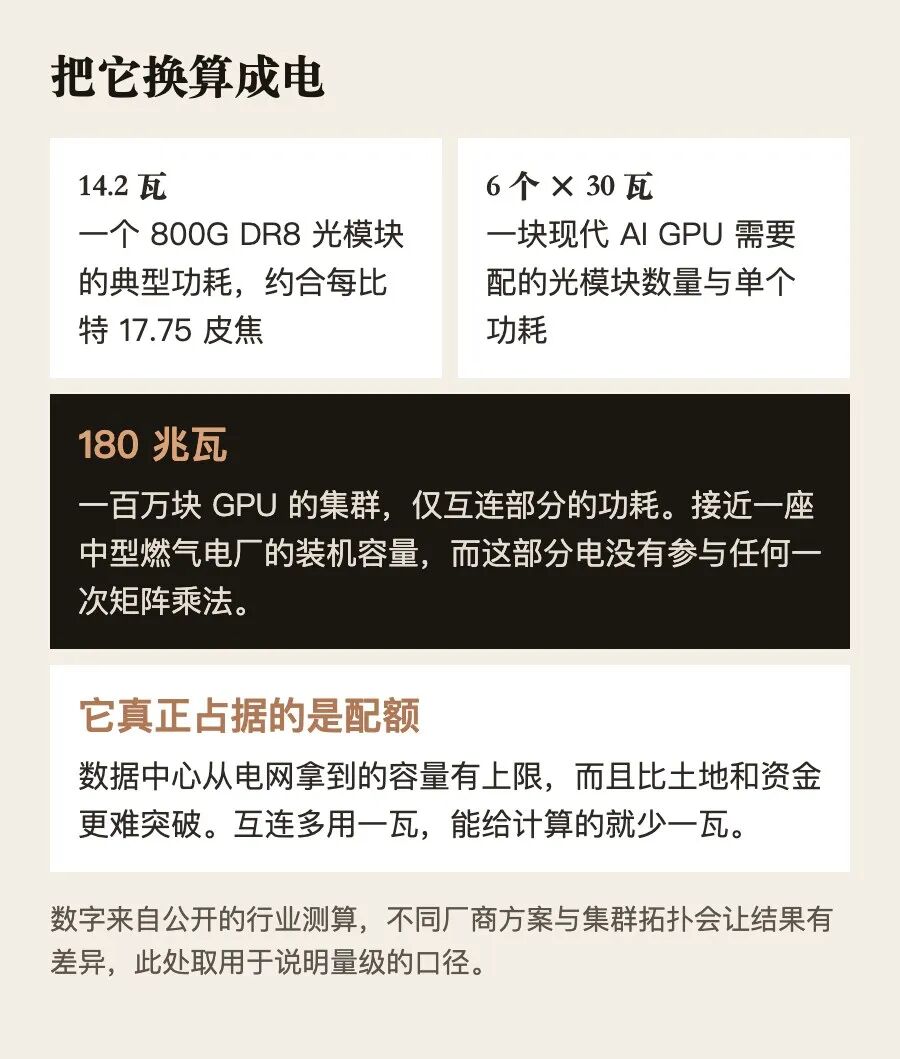
一个800G DR8 的光模块,典型功耗约14.2瓦。换算成每传输一个比特消耗的能量,约为17.75皮焦。
一块现代 AI GPU 需要配六个这样的光模块,每个约30瓦。
把这个数字放大。如果要建一个一百万块 GPU 的集群,仅仅是互连部分的功耗,就会达到180兆瓦。
180兆瓦是什么概念。一座中型燃气电厂的装机容量大约在两三百兆瓦这个区间。也就是说,光是让这些芯片互相说话,就需要接近一座电厂的电力,而这部分电没有参与任何一次矩阵乘法。
把互连功耗换算成电。数字来自公开行业测算,用于说明量级
还可以从另一个角度看这个数字。按工业电价粗略估算,180兆瓦连续运行一年的电费在一亿美元以上,这还没算为这部分功耗配套的供电和散热设施的投资。以上是我们按公开电价做的估算,不同地区差异很大。
更关键的是它占据了配额。一个数据中心从电网拿到的容量是有上限的,而且这个上限往往比土地和资金更难突破。互连多用一瓦,能给计算的就少一瓦。
这就是行业里说的功耗墙。它不是由计算造成的,是由连线造成的。
需要说明的是,以上数字来自公开的行业测算,不同厂商的方案和不同的集群拓扑会让结果有差异,这里取的是一个用于说明量级的口径。
04 解法是把光搬进封装里
目前的主流做法是可插拔光模块。数据在芯片里是电信号,走到电路板边缘,再进到一个插在面板上的模块里转成光,然后通过光纤发出去。
这条路径上,电信号要在铜上走一段不短的距离,而前面说的损耗和功耗,主要就发生在这一段。
共封装光学的思路是把转换点往前挪。把光收发器件直接做进和交换芯片或者加速器同一个封装里,电信号只需要在封装内部走极短的距离就转成光。
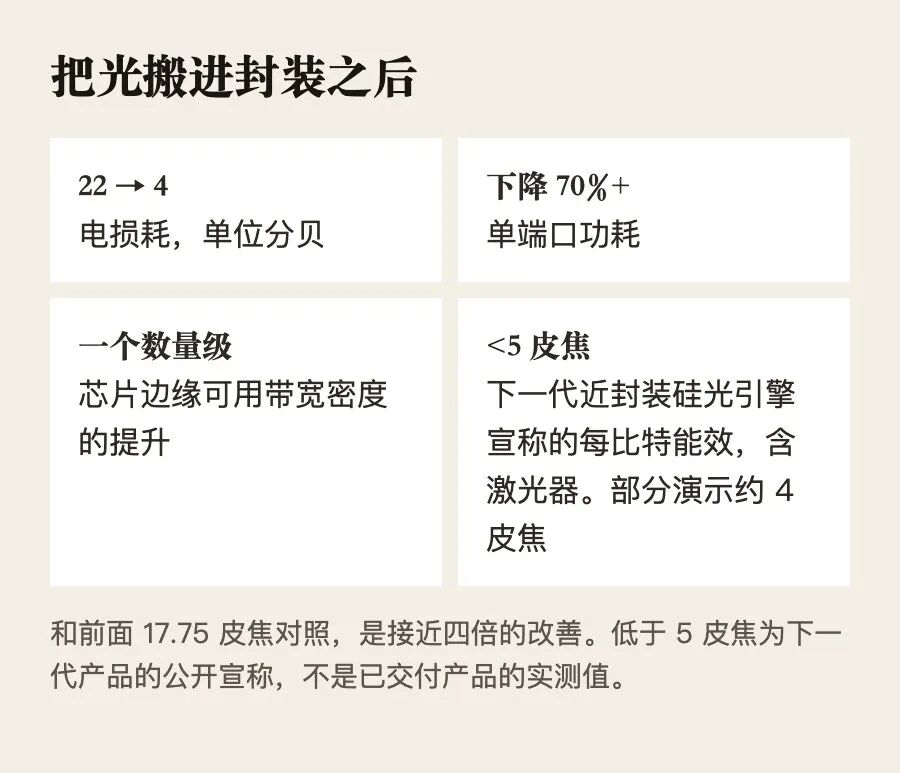
效果是可以量化的。电损耗从22分贝降到4分贝,单端口功耗下降超过七成,芯片边缘可用的带宽密度提升一个数量级。
能效上的改善更直接。下一代近封装的硅光引擎,公开宣称的数字是每比特低于5皮焦,并且这个数字包含了激光器本身的功耗,部分演示给出的结果约为4皮焦。
和前面17.75皮焦的对照放在一起,这是接近四倍的改善。
把光搬进封装之后的四项改善。低于5皮焦为下一代产品的公开宣称
05 Ayar Labs 做的是哪一块
05Ayar Labs 做的是哪一块
这家公司的核心产品叫 TeraPHY,是一种光 I/O 芯粒。
芯粒指的是把一颗大芯片拆成若干功能模块分别制造,再封装到一起。这种做法的好处是每个模块可以用最适合它的工艺,而且可以混搭不同厂商的模块。
TeraPHY 的定位是其中负责对外通信的那一块。公司的说法是,它是业内第一个符合 UCIe 标准的光互连芯粒。UCIe 是芯粒之间的互联标准,符合它意味着理论上可以被不同厂商的设计直接采用,而不用为每家单独适配。
最新一代 TeraPHY 的双向带宽是每秒8太比特,单方向每秒4太比特。
标准这件事值得多解释一句。在没有统一接口的年代,一家芯片公司想用别人的光互连方案,双方要一起做很久的联合设计,这个成本高到只有最大的几家玩得起。有了统一接口之后,理论上采购一个芯粒就像采购一个标准件,设计周期和验证工作都会大幅缩短。
这正是这类公司想要的位置。卖一个模块和成为一个标准件,长期价值差别很大。
06 投资人名单里的两个名字
英伟达和 AMD 同时出现在这家公司的投资方里,这件事值得单独说。
这两家是 AI 芯片市场上最主要的竞争对手,而它们都投了同一家做互连的公司。
原因不难理解。对它们来说,互连的瓶颈会直接限制自家芯片能卖出多少。一块再快的 GPU,如果在集群里因为连线而空转,客户感知到的性能就上不去。它们既需要这个问题被解决,又不希望解决方案掌握在对方手里。
两个竞争对手为什么投了同一家。Sense AI 整理
投资一家中立的供应商,是一个折中。这种做法在半导体行业不罕见,几家互相竞争的公司共同扶持一个上游环节,让它保持独立,谁也不吃亏。
代价是这家供应商很难把价格提上去。它的股东就是它的客户,而这些客户手上都有自研这个选项。
对 Ayar Labs 来说,这个位置有好处也有风险。好处是两大客户都有理由让它活下来。风险是它的产品必须保持中立,而一旦任何一家决定自己做,它的议价能力会立刻变化。
07 为什么是现在
把光引进芯片封装这个想法不新,硅光技术做了二十年。
它此前一直没有大规模落地,原因有几个。一是成本,光器件比铜贵得多,在带宽需求不高的年代算不过账。二是可靠性,激光器的寿命和温度敏感性是老问题,而封装内部恰恰是高温环境。三是产业链,光器件和芯片制造原本是两个体系,缺少把它们结合起来的标准和产能。
这两年变化的是第一条。当铜的功耗代价大到一座电厂的量级时,光器件的成本就不再是决定性因素了。
第二条尤其棘手。激光器的发光效率随温度上升而下降,而封装内部紧挨着的就是发热量最大的计算单元。业内的一种应对是把激光光源移到封装外面,用光纤把光引进来,封装内只保留调制和接收,这样激光器可以工作在温和的环境里,坏了也能单独更换。代价是多了一层耦合,而耦合处的对准精度本身又是良率的来源之一。
后两条仍然是真实的障碍,这也是这个行业现在的主要战场。
08 这条路上不止它一家
需要说明的是,把光搬进封装这件事,不是一家公司在做。
大型网络芯片厂商在从交换机这一侧推进,把光引擎和交换芯片封装在一起,这条路线的好处是客户明确、替换路径清楚。另有一批创业公司从不同角度切入,有的做光互连芯粒,有的做光交换结构,还有的直接做面向 AI 的光计算。
Ayar Labs 的位置在加速器这一侧,它想成为芯片设计公司可以直接采购的一个标准模块。这个位置的价值取决于一件事,芯粒这种拆分方式在 AI 芯片里到底会走多远。
如果主流路线是每家大厂把光引擎自己做进自家封装,那么第三方芯粒的空间会被压缩。如果行业真的走向模块化采购,不同厂商的芯粒可以像搭积木一样组合,那么这个位置会很值钱。
这个问题现在没有答案,而它决定了这家公司是一个部件供应商还是一个标准的一部分。
09 这门生意的难处
把风险列在这里。
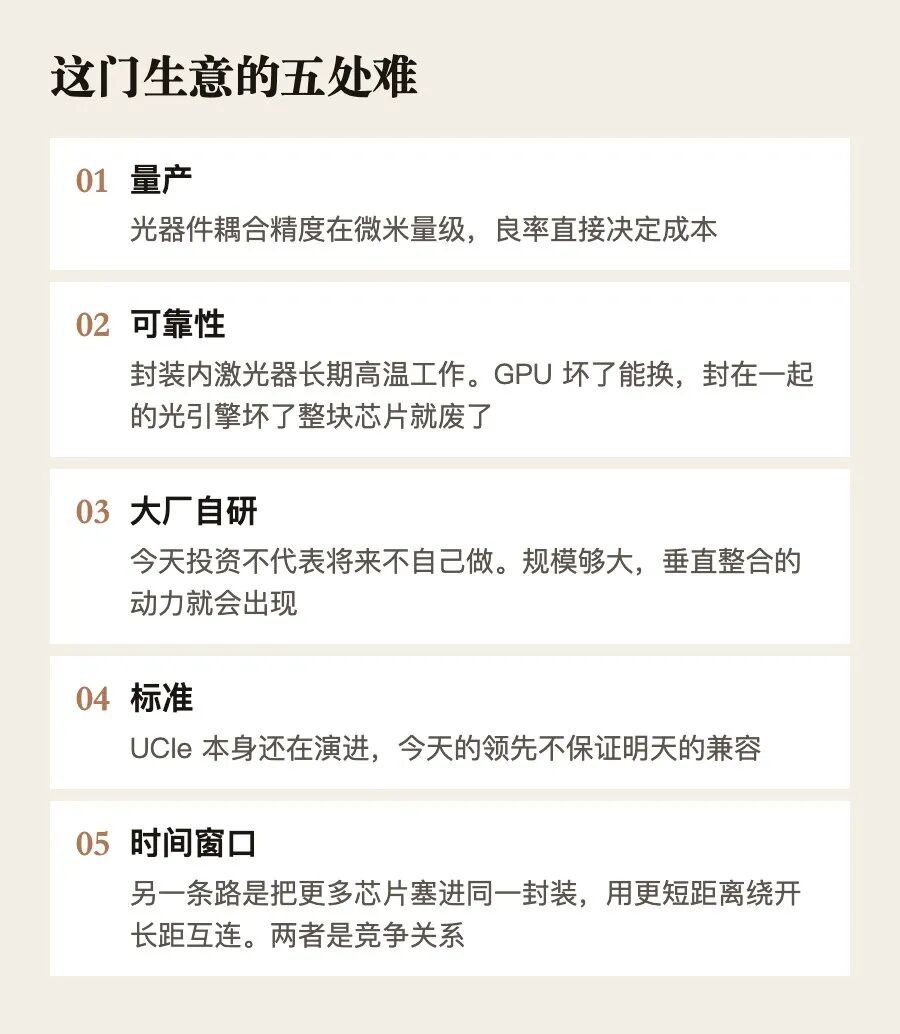
这门生意的五处难。Sense AI 整理
第一是量产。研发阶段能跑通和大规模一致地做出来是两件事。光器件的耦合精度要求在微米量级,良率直接决定成本,而这一步是所有硅光公司的共同难关。
第二是可靠性。数据中心的设备要求连续运行多年,而封装内的激光器长期工作在高温下,寿命衰减是必须回答的问题。一块 GPU 坏了可以换,封装在一起的光引擎坏了,整块芯片就废了。
第三是大厂自研。英伟达和 AMD 现在投资它,不代表将来不自己做。这类核心部件一旦规模足够大,垂直整合的动力就会出现。
第四是标准。符合 UCIe 是一个优势,但标准本身还在演进,而参与制定标准的公司很多。今天的领先不保证明天的兼容。
第五是时间窗口。如果铜的改进比预期更快,或者封装和拓扑上出现别的省电办法,光进封装的紧迫性就会下降。行业里一直有另一条思路,把更多芯片塞进同一个封装,用更短的距离绕开长距离互连的问题。这条路同样在推进,两者是竞争关系。
10 这件事对理解 AI 产业的意义
把这个案例放大一点看,它说明了一个正在发生的转移。
过去几年,AI 基础设施的叙事集中在芯片上。谁的芯片更快,谁的产能更多。
现在这个叙事正在往两侧扩散。一侧是电,数据中心选址开始围绕电力供应,我们此前写过这个方向。另一侧就是互连,芯片之间怎么连、连得多省电,成了决定集群规模上限的东西。
这两侧有一个共同点。它们都不是软件问题,也不是靠模型变好能解决的问题。它们是物理和工程问题,遵循的是另一套时间表。一个算法的改进可以在几周内部署,一条产线的良率爬坡要按年算。
这也解释了一个看起来矛盾的现象。模型能力在快速提升,而支撑它的基础设施投资周期却在拉长。数据中心的选址、变电站的审批、光器件的产线爬坡,每一项都以年为单位。当软件侧的迭代按周计算、硬件侧按年计算时,中间会出现一段时间的错配,表现为要么算力闲置,要么算力紧缺,而且两种情况可能在不同环节同时出现。
对于判断 AI 产业的节奏,这一点比大部分模型发布更有参考价值。
11 几个还不知道的
把没有答案的部分列清楚。
这家公司的收入规模没有公开,产品处在什么量产阶段也没有明确说明。
50亿美元这个估值来自对一笔老股交易的报道,不是一轮新融资的定价,两者的含义不同。
180兆瓦这个数字是基于公开测算的推演,取决于集群拓扑、模块选型和具体的使用率,实际数字会有出入。
低于5皮焦每比特是下一代产品的公开宣称,不是已交付产品的实测值。
英伟达和 AMD 在这家公司持有多少股权,有没有附带任何商业条款,没有公开信息。
UCIe 标准在光互连方向上的成熟度,以及有多少家芯片设计公司实际采用了这条路径,我们没有找到可靠的统计。
资料来源:
The Register 报道 Ayar Labs 5亿美元 E 轮(2026年3月)原文 https://www.theregister.com/2026/03/03/ayar_labs_500m/
Datacenter Dynamics 报道该轮由英伟达与 AMD 支持原文 https://www.datacenterdynamics.com/en/news/optical-interconnect-startup-ayar-labs-closes-500m-funding-round-backed-by-nvidia-and-amd/
Electronics For You 报道 Ayar Labs 追加1.5亿美元原文 https://www.electronicsforyou.biz/industry-buzz/silicon-valleys-ayar-labs-raises-150m-to-advance-ai-optical-chips/
Optics & Photonics News 报道本轮融资原文 https://www.optica-opn.org/home/industry/2026/march/ayar_labs_raises_us$500_million/
Gazettabyte 关于 Ayar Labs 光 I/O 路线的技术报道原文 https://gazettabyte.com/ayar-labs-prepares-to-fulfil-its-optical-input-output-i-o-vision/
Marvell 关于共封装光学的技术说明原文 https://www.marvell.com/blogs/co-packaged-optics-for-next-wave-ai-data-centers.html
Embedded 关于把铜移出数据中心能耗等式的分析原文 https://www.embedded.com/taking-copper-out-of-the-ai-data-center-energy-equation-the-optical-transceiver-design-path-forward/
Contrary Research 关于 Ayar Labs 的公司研究报告原文 https://research.contrary.com/company/ayar-labs
本文由人人都是产品经理作者【深思SenseAI】,微信公众号:【深思SenseAI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供


- 目前还没评论,等你发挥!