起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
拆了100个Seedance提示词后,发现3个切片粒度黄金分割点(附模板)


时间轴切片法被说烂了,但照着模板填,视频依然在第三秒崩坏。拆解100个Seedance提示词后,发现被忽略的切片粒度黄金分割点:3秒保动作、4秒保情绪、5秒保光影。本文用实测数据与DZS因果链框架,教你用工程化思维替代拍脑袋切片,让AI视频渲染稳定不翻车。
时间轴切片法被说烂了。
0-4秒写什么,4-8秒写什么,8-12秒写什么——这套模板几乎成了Seedance玩家的入门仪式。
但一个尴尬的事实是:照着模板填,依然有大量视频在第三秒开始崩。人物变形、动作跳帧、镜头运动突然卡顿。问题不在描述不够细,而在切片的粒度选错了。
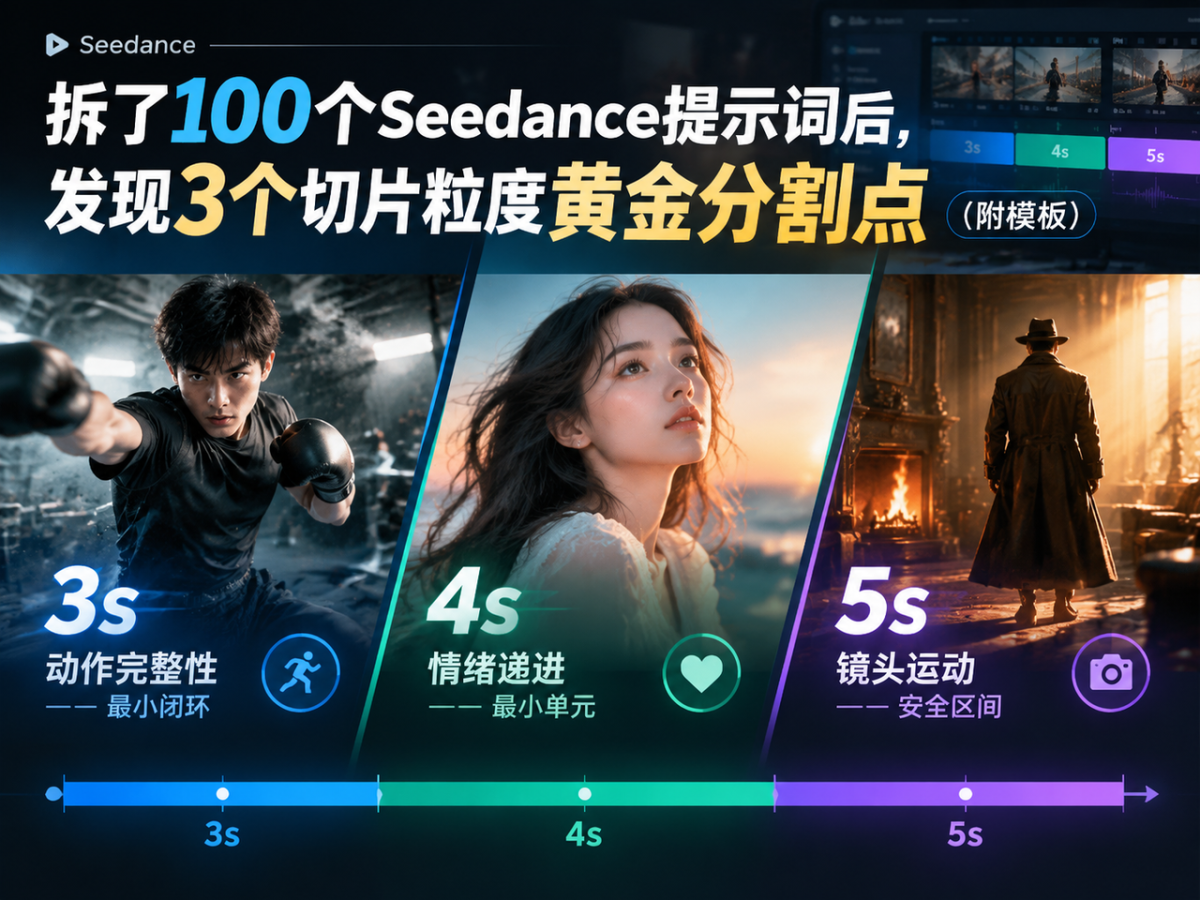
拆完100个Seedance提示词后,发现三个被忽略的切片粒度黄金分割点。它们分别对应三种完全不同的叙事任务。
第一个分割点:3秒——动作完整性的最小闭环
Seedance2.0对动作的渲染遵循一个隐含规则:一个完整的物理动作需要至少3秒的连续帧才能稳定收敛。
什么意思?出拳这个动作,从蓄力到挥出到收力,如果只给2秒,模型会在最后一帧强行压缩动作,导致肢体扭曲。给3秒,动作有始有终,帧间插值自然。
所以战斗类、运动类、舞蹈类提示词,切片粒度必须锁定3秒。这不是审美选择,是渲染稳定性的硬约束。
模板:
0-3秒:全景固定,[角色]从静止状态启动[动作A],动作完整呈现起势、发力、收束三个阶段。
3-6秒:中景跟拍,[角色]衔接[动作B],镜头随动作方向缓慢移动。
6-9秒:特写,[动作C]的细节呈现,强调手部/足部/面部的微表情变化。
第二个分割点:4秒——情绪递进的最小单元
情绪类、氛围类、唯美人像类提示词,切片粒度应该锁定4秒。
原因在于Seedance的语义注意力窗口。
测试发现,当一段描述包含“表情变化+光影变化+镜头运动”三重语义时,4秒是模型能同时处理而不丢失任一维度的上限。3秒太短,情绪还没铺开就切走了。5秒太长,模型会在后半段开始随机发挥。
4秒的节奏恰好容纳一个完整的情绪弧:起→承→转。
模板:
0-4秒:全景俯拍,[场景]建立环境氛围,[角色]处于静止或缓慢移动状态,光影柔和。
4-8秒:中景,[角色]面部表情从[情绪A]过渡到[情绪B],镜头缓慢推进。
8-12秒:近景,[情绪B]达到峰值,[细节描写]强化情感冲击,背景虚化。
12-15秒:特写,情绪余韵,镜头缓缓拉远或定格。
第三个分割点:5秒——镜头运动的安全区间
固定镜头和极缓慢的推拉镜头,切片粒度可以放宽到5秒。
这类镜头的渲染负荷最低,模型不需要在帧间处理复杂的运动矢量。5秒的连续画面反而能让光影和材质细节充分收敛。教父登场那种缓慢推进的镜头,5秒一刀比3秒一刀更稳,因为给了壁炉火光和枪身反光足够的渲染时间。
但注意:环绕、升降、快速摇移这几种运动,绝对不能用到5秒。镜头运动越复杂,切片必须越短。环绕镜头建议2-3秒一刀,否则模型会在后半段丢失空间一致性。
模板:
0-5秒:全景固定,[场景]全貌呈现,光影细节充分渲染,[角色]处于画面[位置]。
5-10秒:镜头极缓慢推进,[角色]动作[缓慢动作描写],材质反光清晰可见。
10-15秒:近景,[角色]面部特写,光影在面部形成[具体光效]。
三个分割点对应三种叙事任务:3秒保动作,4秒保情绪,5秒保光影。
选错粒度的代价很直接。用5秒切战斗,动作必崩。用3秒切情绪,观众还没代入就切走了。用4秒切环绕镜头,空间逻辑会在第三秒开始漂移。
DZS-因果链切片框架
以下提示词框架将上述逻辑封装为可复用的工程结构。直接复制发送给AI,即可开启专业切片模式。
# DZS-因果链切片框架
## 变量定义
– {{叙事类型}}:动作/情绪/光影/混合
– {{总时长}}:默认15秒
– {{主体描述}}:角色或物体的核心特征
– {{场景描述}}:环境、光线、氛围
– {{镜头运动}}:固定/推/拉/摇/移/跟/升降/环绕
– {{强化词组}}:画质类+稳定类+光影类+氛围类
## 工作流程
### 第一步:叙事类型判定
根据{{叙事类型}}自动匹配切片粒度:
– 动作主导 → 3秒/段,强制动作完整性
– 情绪主导 → 4秒/段,强制情绪弧完整
– 光影/固定镜头主导 → 5秒/段,强制光影收敛
– 混合型 → 按主叙事类型降一级处理(如动作+情绪混合,按3秒切)
### 第二步:镜头运动兼容性检查
若{{镜头运动}}为环绕/升降/快速摇移,强制将切片粒度压缩至2-3秒,并输出警告:“当前镜头运动复杂度高,已自动缩短切片以保证空间一致性。”
### 第三步:因果链填充
每段切片按“物理因果→情绪因果→镜头因果”三层填充:
– 物理因果:动作A导致动作B,动作B导致环境变化C
– 情绪因果:表情A过渡到表情B,触发条件是什么
– 镜头因果:镜头运动与主体动作的呼应关系
### 第四步:强化词冲突检测
按以下优先级排序,冲突时保留高优先级:
1. 稳定类(面部清晰不变形、动作流畅连贯无跳帧)
2. 画质类(4K超高清、电影质感)
3. 光影类(暖黄逆光、丁达尔效应)
4. 氛围类(治愈清新、史诗级)
### 第五步:输出
按时间轴输出完整提示词,每段标注切片依据。
## 交互指令
用户输入“开始”后,框架进入待命状态。用户提供{{叙事类型}}和{{主体描述}},框架输出完整提示词。用户可随时输入“调整粒度”或“更换镜头运动”进行迭代。
这个框架的核心变化在于:切片粒度不再是拍脑袋决定的,而是由叙事类型和镜头运动共同推导出来的。因果链填充替代了单纯的场景描写,每一段切片都有内在的逻辑驱动力。
写在最后
切片粒度这件事,本质上是在模型的注意力窗口和叙事完整性之间找平衡。
3秒、4秒、5秒这三个数字不是玄学,是对渲染稳定性和语义收敛速度的实测结果。模板可以抄,但理解为什么这么切,才能在自己遇到新场景时做出正确判断。
本文由 @抖知书 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务


- 目前还没评论,等你发挥!