
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
被字节开除的AI实习生,刚刚融资2个亿


AI创业圈又出了一个挺有意思的故事。
2024年,字节跳动曾经因为一名实习生恶意干扰大模型训练任务,将其辞退,后来双方还打起了官司。当时这件事在网上闹得沸沸扬扬,不少人应该还有印象。
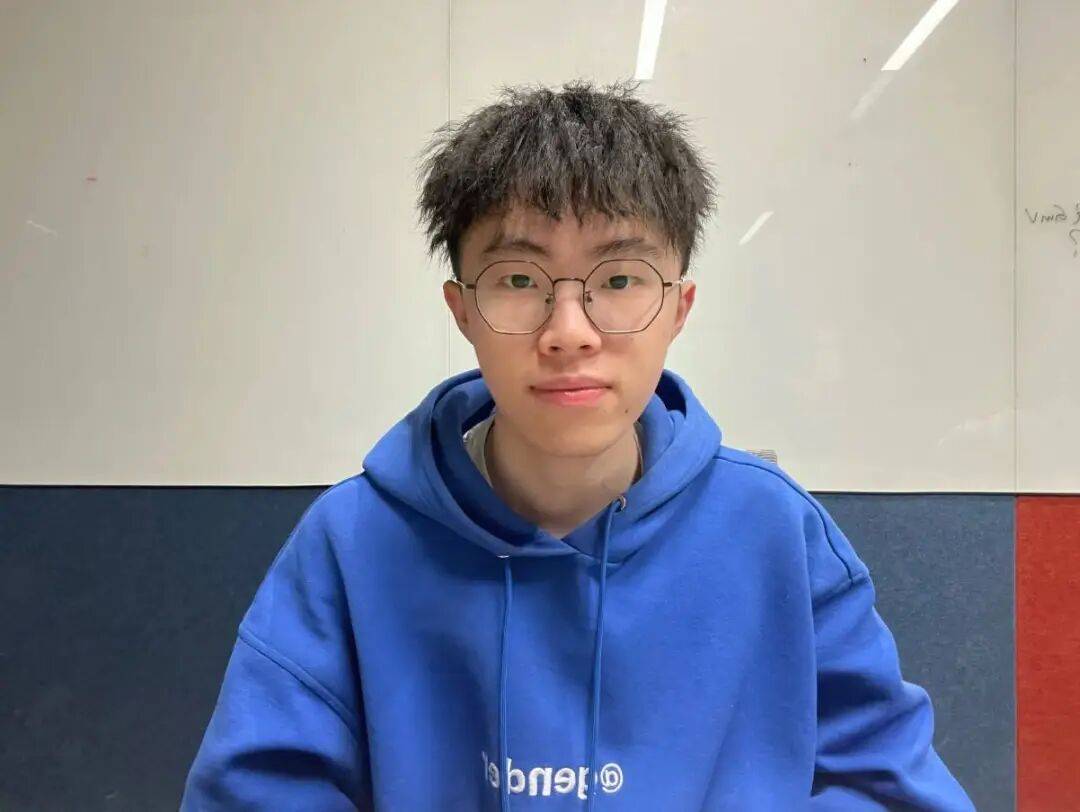
田柯宇/图片来源凤凰网
而如今,这位当事人田柯宇,居然自己创业搞起了AI,还拿到了一笔不小的融资。
据彭博社10月8日报道,田柯宇创办的AI公司已经完成近3000万美元融资,折合人民币约2亿元,公司投后估值达到2亿美元,约合13.4亿元。投资方包括五源资本、IDG资本等知名机构,其中五源资本此前还投资过杨植麟创办的月之暗面(Kimi)。
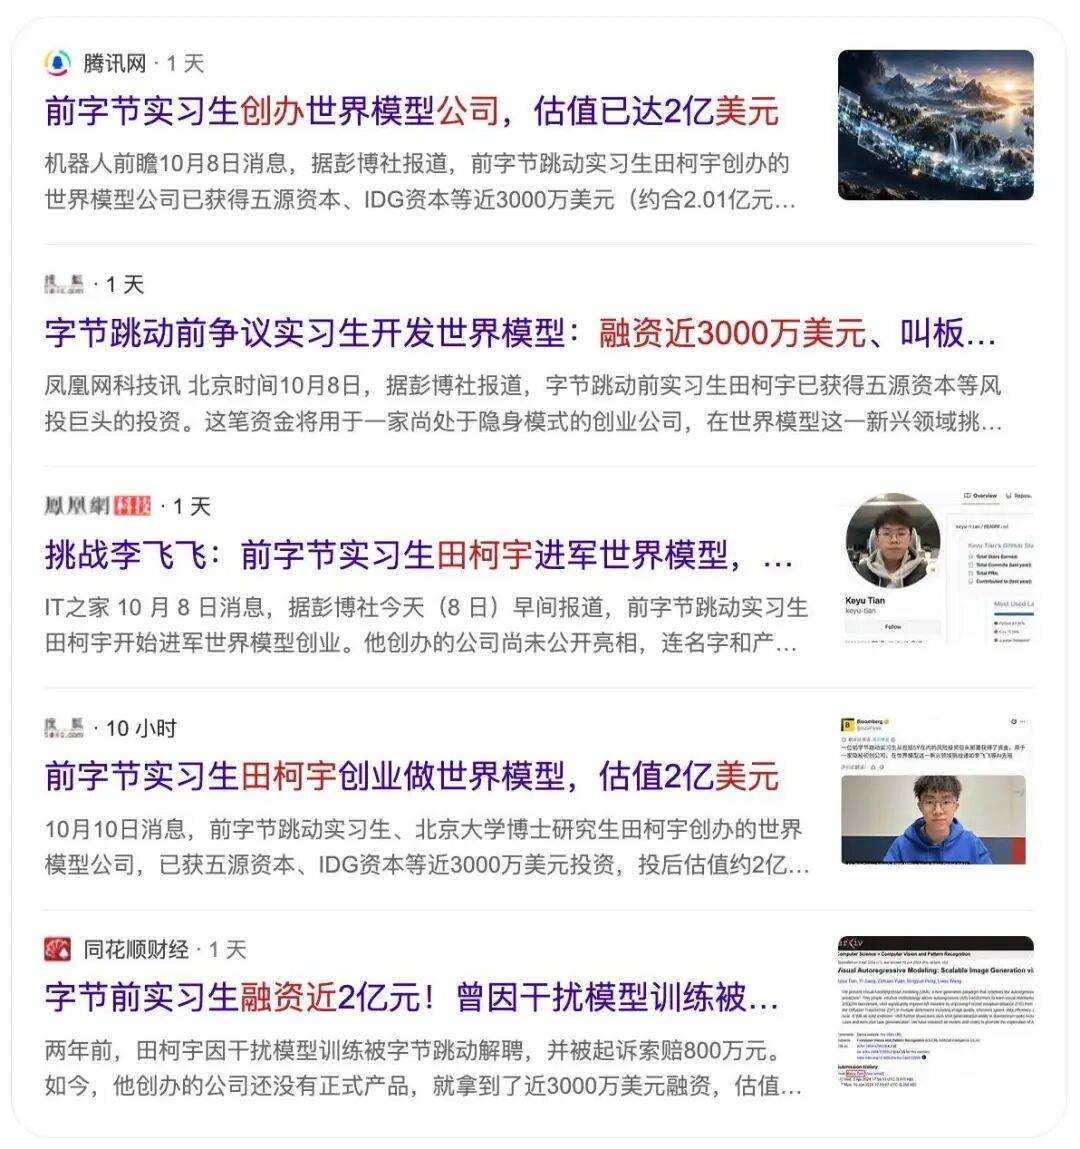
更有意思的是,这家公司目前只有10人左右,连正式名称都还没公开,也没有对外发布产品,预计要到2027年才会推出完整模型。
10个人,没有正式产品,估值就超过13亿元。放在前几年,这样的融资故事多少有些不可思议,但放到今天的AI圈,似乎也没有那么稀奇了。
不过,田柯宇这次创业的方向,还真值得关注。
他选择的是最近特别火的世界模型(World Model),而且准备走一条与李飞飞等研究团队不同的技术路线,希望大幅降低AI理解和生成视频的成本。
10个人撑起13亿估值,资本看中了什么?
先说说田柯宇的技术背景。
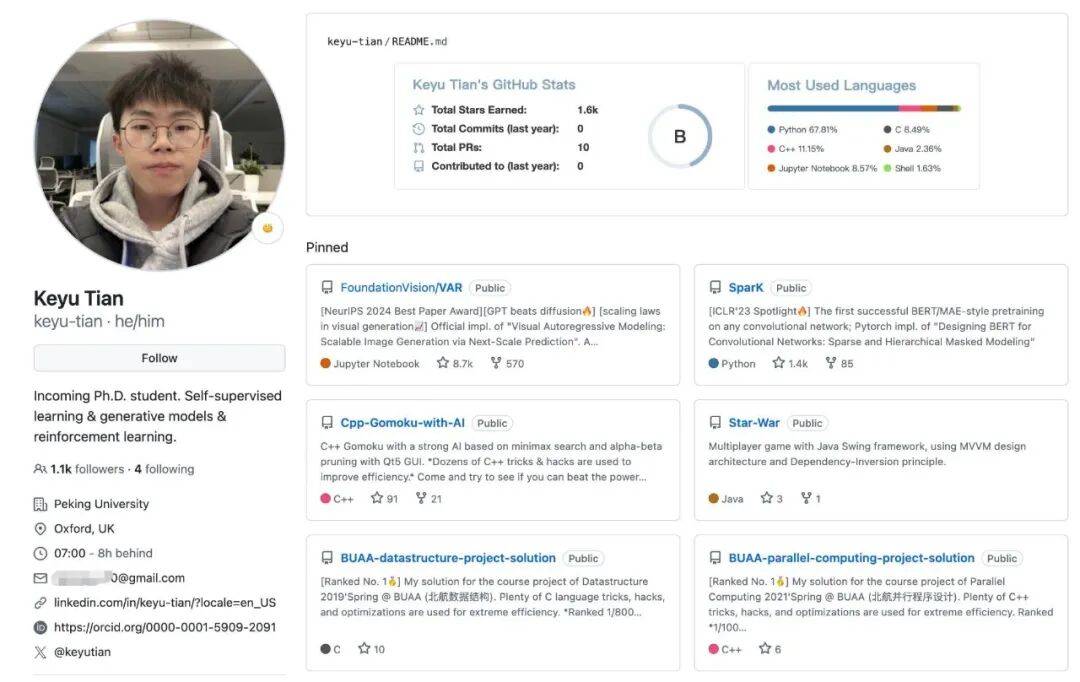
上图是他的github主页
他毕业于北京大学,2024年曾作为第一作者,与字节跳动及北大的研究人员共同发表论文《Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction》,并获得NeurIPS 2024最佳论文奖。
NeurIPS是全球人工智能领域最具影响力的学术会议之一,每年都有大量来自Google、Meta、微软、OpenAI以及全球高校的研究成果参与评选。
能够拿到最佳论文奖,已经是很有分量的成绩了。
这篇论文提出了一种叫VAR的视觉生成模型。简单来说,它改变了传统自回归图像生成逐个预测图像元素的方式,改为先生成粗略的整体画面,再逐步补充更高分辨率的细节。
有点像画画,先勾勒轮廓,再逐步把细节补齐。
这个方法的优势主要体现在效率上。根据论文公布的实验结果,VAR在特定图像生成基准测试中,相比此前的自回归模型实现了约20倍的推理速度提升,同时在生成质量和模型扩展性方面取得了不错的表现。
当然,这项成果由多名研究人员共同完成,不能简单算到某一个人头上。但田柯宇作为第一作者,至少证明了他在视觉生成模型研究方面具备相当不错的能力。
而这次创业,他也延续了之前的研究方向,只不过把目标从图像生成扩展到了更复杂的视频和世界模型。
按照彭博社的报道,团队目前已经开发出一套包含约20万个符号的视觉词典,希望让AI通过这些符号来表示、理解和预测视频中的信息。
田柯宇还提出了一个比较有吸引力的目标:将生成一秒钟视频的成本降低至少一个数量级。
如果真能实现,对于视频生成、实时交互等应用来说,确实是一个非常有价值的突破。
不过,这套技术目前还没有经过充分的公开验证,最终效果怎么样,还需要等模型发布后才能知道。
我觉得,这也解释了为什么五源资本、IDG资本愿意提前下注。
AI行业发展到今天,优秀的应用开发团队已经不少,但能够在底层模型架构上提出新方法,并且有顶级论文成绩的研究人才,依然是稀缺资源。
对于风险投资机构来说,花2亿元投资一个已经有学术成果的团队,赌的是它未来能不能在某个关键技术方向上取得突破。
尤其在世界模型这样一个尚未形成稳定竞争格局的领域,提前布局确实有机会获得比较高的回报。
至于13亿元估值究竟贵不贵,现在还很难判断。毕竟模型都没正式发布,投资人目前能看到的,更多还是团队的研究能力和未来潜力。
让AI发明自己的语言,听起来有点疯狂
最近一年,世界模型这个词在AI圈出现的频率越来越高。
不过,很多人可能还是有些懵:现在GPT、Claude已经这么厉害了,为什么还要专门研究世界模型?
举个简单的例子。
假设你让AI生成一段视频,一只猫从桌子上跳下来,然后撞翻旁边的水杯。
现在的视频生成模型,已经能够把这个画面做得非常逼真。但如果进一步要求AI预测猫跳下来的具体轨迹、水杯受到撞击后会如何倾倒,以及桌面倾斜后会发生什么,难度就明显增加了。
因为这些任务涉及空间关系、运动规律和物体之间的相互作用。
世界模型希望让AI具备更强的环境理解与预测能力。未来如果机器人要进入家庭、工厂,或者自动驾驶系统需要提前预判复杂路况,都可能用到类似技术。
目前,Google、英伟达、李飞飞创办的World Labs等团队都在探索这个方向,只是技术路线有所不同。
田柯宇的思路挺有意思,他希望给AI创造一套自己的视觉语言,让机器通过这套语言来理解现实世界。
我们人类习惯用文字描述看到的东西,但文字能够表达的信息其实相当有限。
比如,一个人走进房间,拿起桌上的水杯,再把它放到柜子上。用文字描述可能只有几十个字,但真实画面中包含的信息远远不止这些。人的运动轨迹、水杯的位置变化、手指与物体的接触方式,以及光影和周围环境的变化,都需要模型处理。
更麻烦的是,视频由大量连续画面组成,数据量非常庞大。如果每次都要处理完整的画面信息,对算力和存储都是不小的负担。
田柯宇希望通过视觉符号,把视频转换成一种更紧凑、更适合模型学习的表示形式。
按照他披露的信息,团队已经建立了一套包含约20万个符号的视觉词典。接下来,他们计划利用大约1亿小时的视频数据进行训练,让模型逐渐学习视觉信息与真实世界运动变化之间的关系。
这条路线有个非常现实的目标,就是降低成本。
现在很多AI视频产品已经能够生成质量不错的内容,但成本和生成速度依然影响着它们的使用场景。
比如可灵AI、即梦、PixVerse等产品,主要面向视频创作者。用户输入提示词,等待一段时间,生成一段视频,很多情况下是可以接受的。
但如果未来把类似能力放进游戏、机器人或者实时交互场景,情况就不同了。
假设你正在玩一款AI生成的开放世界游戏,每走一步,周围场景都需要根据你的行为实时变化。如果模型生成速度太慢,或者每秒钟的生成成本都很高,这类产品就很难普及。
同样,一台机器人也不可能每做一个动作,都等模型慢慢计算十几秒钟。
所以,世界模型未来能不能真正进入消费级产品,模型效率会是一个很重要的因素。
田柯宇希望把视频生成成本降低一个数量级,瞄准的正是这个问题。
但我觉得这里也有个需要注意的地方。视频生成得足够快、足够便宜,并不代表模型就真正掌握了物理规律。
生成一段看起来很真实的汽车碰撞视频,与准确预测不同速度、不同材质、不同角度下的碰撞结果,依然存在很大差距。
如果未来想进入机器人、自动驾驶等对可靠性要求很高的领域,除了生成效果,还需要验证模型对物理世界的预测究竟有多准确。
这也是田柯宇接下来需要证明的技术能力。
李飞飞被AMD花82亿美元收购,世界模型真火了
03.李飞飞被AMD花82亿美元收购,世界模型真火了
田柯宇这次融资,还有一个值得关注的背景。
世界模型正在成为全球AI资本市场的新热门方向,而且投资规模已经相当惊人。
就在9月28日,AMD宣布,计划以约82亿美元的全股票交易收购李飞飞创办的World Labs。
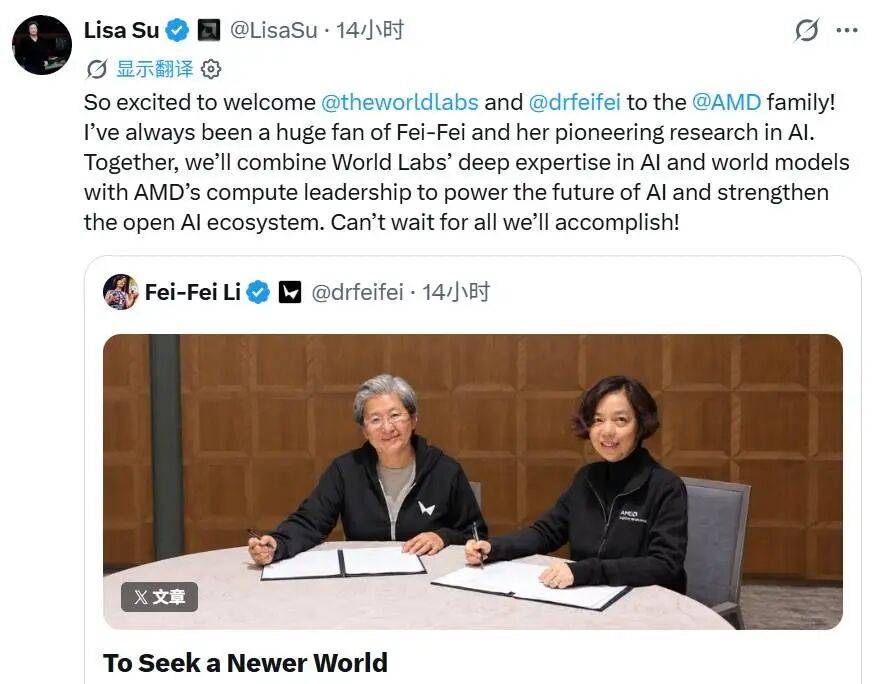
双方已经签署正式协议,预计在2026年底前完成交易。收购完成后,李飞飞还将出任AMD执行副总裁兼首席科学家。
82亿美元,折合人民币超过500亿元。
要知道,World Labs也是一家成立时间并不长的AI创业公司。它此前推出了Marble等产品,主要探索如何让AI生成、重建和模拟可以交互的3D世界。
一家公司为什么能够在这么短的时间里获得如此高的收购报价?
我觉得AMD这笔收购,很能说明问题。
AMD是全球重要的AI芯片厂商,过去几年一直在努力追赶英伟达。随着大模型训练和推理需求持续增长,芯片厂商已经开始思考下一代AI计算需求会出现在哪里。
如果机器人、自动驾驶、工业仿真、虚拟世界等应用真的大规模普及,背后可能会催生一个非常庞大的算力市场。
AMD提前拿下世界模型领域的研究团队,也有利于它更早参与下一代AI计算平台的设计。
当然,AMD也有自己的算盘,毕竟未来不能一直只靠大语言模型拉动GPU需求。
除了李飞飞,世界模型领域还有另一位重量级人物:杨立昆(Yann LeCun)。
这位图灵奖得主、前Meta首席AI科学家,也把世界模型及相关技术路线作为重要研究方向。他创办的AMI Labs此前获得了超过10亿美元的种子轮融资。
再看看Google DeepMind的Genie系列、英伟达的Cosmos,以及国内腾讯混元在3D世界生成领域的探索,整个赛道确实越来越热闹。
不过,各家研究的重点并不完全相同。
有的团队侧重生成逼真的动态环境,有的希望让AI更好地理解三维空间,还有的专注机器人和物理世界的预测。
目前还很难说哪条技术路线最终会胜出。
这也是世界模型比较有意思的地方。虽然听起来大家都在做同一件事,但实际技术方案、产品形态和商业落地方向都有很大差异。
对于创业公司来说,这样的行业阶段反而可能存在机会。
毕竟,如果技术架构、产品形态都已经成熟,后来者想要挑战Google、英伟达这样的巨头,难度会非常大。
但当行业还在探索不同方向时,一支小团队如果真的提出了效率更高的新方法,就有可能在某个细分领域获得优势。
田柯宇的团队选择从视觉表示和生成效率切入,至少从技术方向上看,有自己的研究重点。
不过,资本市场愿意给世界模型开出高估值,也有可能让这个赛道迅速进入新一轮烧钱竞争。
世界模型还没有迎来真正的大规模商业化,融资和估值倒是已经先卷起来了。
AI创业,越来越像一场顶尖人才争夺战
04.AI创业,越来越像一场顶尖人才争夺战
其实,除了世界模型,我觉得田柯宇这笔融资还反映出AI创业圈一个挺明显的变化。
创业公司的规模,正在变得越来越小。
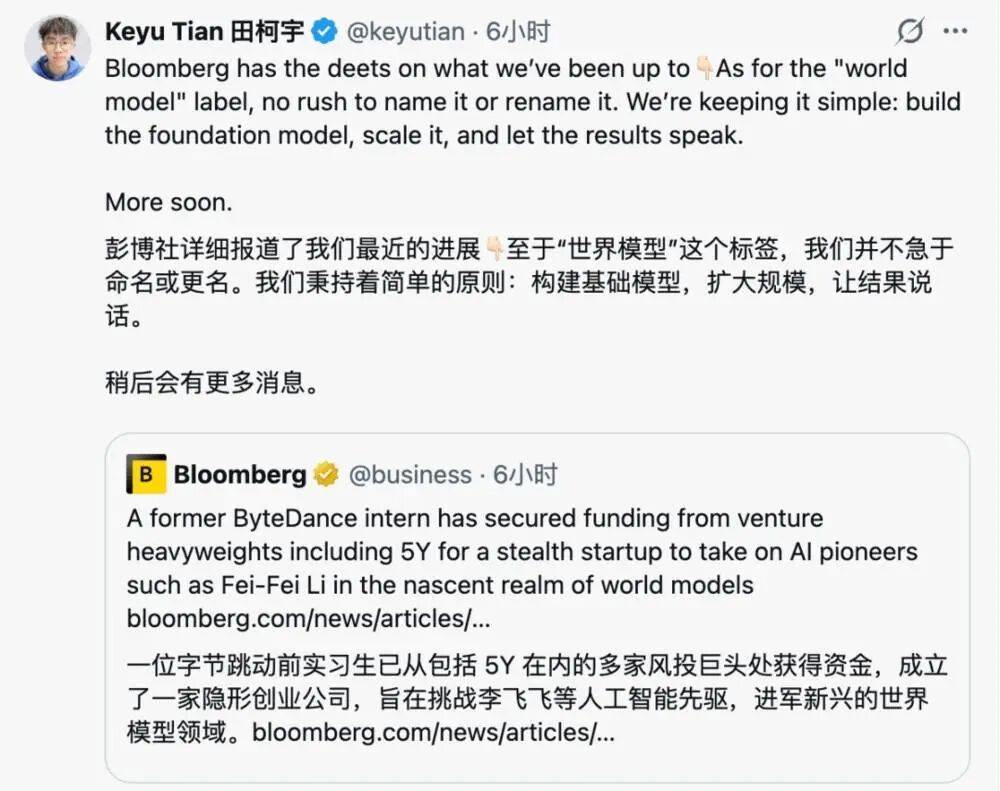
以前互联网创业,大家习惯了几十人、上百人的团队。做产品需要产品经理、设计师、程序员,产品上线以后还需要运营、市场、销售和客服。
公司发展到一定阶段,组织规模往往会快速膨胀。
但最近两年,AI行业出现了越来越多的小团队、高估值创业公司。
特别是基础模型和底层技术领域,投资机构甚至愿意在正式产品出现之前,就为一支研究团队投入数千万美元。
当然,这不代表AI创业已经不需要大量人力。训练大模型依然需要数据、算法、基础设施和工程团队协作,研发投入也相当高。
只是一些早期AI公司的价值,已经越来越集中在少数关键研究人员身上。
尤其是那些能够提出新模型架构、改善训练效率、突破技术瓶颈的人才,市场给出的估值可能远远超过传统互联网行业的想象。
我觉得这对国内AI创业也有一定启发。
过去一段时间,AI创业最热闹的方向主要集中在应用层。AI Coding、AI PPT、AI办公、AI设计,几乎每隔一段时间就会出现一批新产品。
我也体验过不少这类产品,有些确实做得不错,但有一个问题始终绕不开:大模型厂商正在不断扩大自己的产品边界。
今天一家创业公司凭借某项功能获得用户,明天Claude、GPT、豆包或者千问更新一次,就可能直接覆盖类似能力。
尤其是AI Coding和AI办公,国内外巨头都在不断投入,竞争已经相当激烈。
这类应用当然还有创业机会,但对很多小团队而言,想要建立长期竞争优势并不容易。
而基础技术研究虽然投入更大、风险更高,一旦取得真正的突破,反而可能拥有更强的技术壁垒。
田柯宇选择做世界模型,也属于这种高风险、高投入的创业方式。
他目前不着急商业化,计划先把模型研发出来,再考虑后续发展。这种打法需要投资机构有足够的耐心,创业团队也要能够持续拿出研究成果。
但也不能光看13亿元估值,就觉得这家公司已经成功了。
世界模型距离成熟还有很长一段路。田柯宇计划使用约1亿小时的视频进行训练,光是数据获取、筛选、清洗,就已经是一项非常复杂的工程。
更不用说后续的大规模训练、推理优化,以及模型评测。
近3000万美元融资看着不少,但在基础模型研发领域,这笔钱未必能支撑太长时间。如果2027年模型正式发布后,没能展现出足够明显的技术优势,后续融资恐怕也不会轻松。
而且,从产品经理的角度来说,我觉得世界模型还有一个很现实的问题:未来究竟谁会为它付钱?
现在大家讨论世界模型,最常提到的应用就是机器人、自动驾驶、游戏、影视等领域,但这些行业对模型的要求差异很大。
游戏开发者可能更关注生成速度、场景质量和交互体验;机器人公司需要稳定、可靠的物理预测能力;自动驾驶厂商则对场景真实性、安全性和可验证性有更高要求。
同一个世界模型,未必能够同时满足这些行业的需求。
未来究竟是向企业提供模型API,还是为特定行业开发解决方案,或者直接推出面向普通用户的产品,目前都存在不小的探索空间。
当然,也有可能像今天的大语言模型一样,先通过API向开发者开放,再逐渐形成应用生态。
但这条路同样会面对Google、英伟达等巨头的竞争。
所以,技术突破只是创业公司的第一道门槛,找到适合自己的商业模式,同样重要。
我倒是挺期待田柯宇在2027年发布的模型。
如果他的技术真的能够在保证生成效果的同时,把成本大幅降低,那么无论是在AI视频、游戏,还是实时交互场景,都有机会找到自己的市场。
回头看看这笔融资,最让我感慨的其实还是AI创业的变化。
一个只有10个人的团队,没有正式产品,也没有成熟的商业模式,仅凭技术背景和研发方向,就拿到了近2亿元融资。
这样的故事,放在传统互联网创业时代确实少见。
但对于今天的AI行业来说,资本愿意为潜在的技术突破提前买单,已经越来越常见。
至于13亿元估值最终能不能兑现,还得交给时间验证。毕竟,融资消息再漂亮,未来真正拿出来的模型好不好用,才是最关键的。
不过,10个人就能拿到2亿元融资,还是让人忍不住感慨:AI时代,顶尖技术人才的身价,确实越来越夸张了。
本文由作者@运营派AI Lab,授权发布于平台,未经许可禁止转载。

- 目前还没评论,等你发挥!