
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
融资 4500 万美金,红杉美国和英伟达联手投了一家让律师医生自己训模型的公司


一家成立一年、只有 18 人的公司,刚拿下 4500 万美金 A 轮,红杉美国领投、英伟达跟投,估值 3 亿美金。它想让律师、医生、分析师用产品里每天产生的修改和重试,把自己手上的模型越训越好,不用再养一支研究团队。
你有没有想过,你每天在 AI 产品里改掉的那些错,最后都去哪了?你让它重写一段合同条款,你把它算错的估值模型一格一格改回来,你又点了一次“重新生成”,这些动作其实都在告诉模型什么是对的、什么是错的。可是到了第二天,你用的还是同一个模型,它还会犯一模一样的错,你前一天花的那些心思,基本上都白费了。
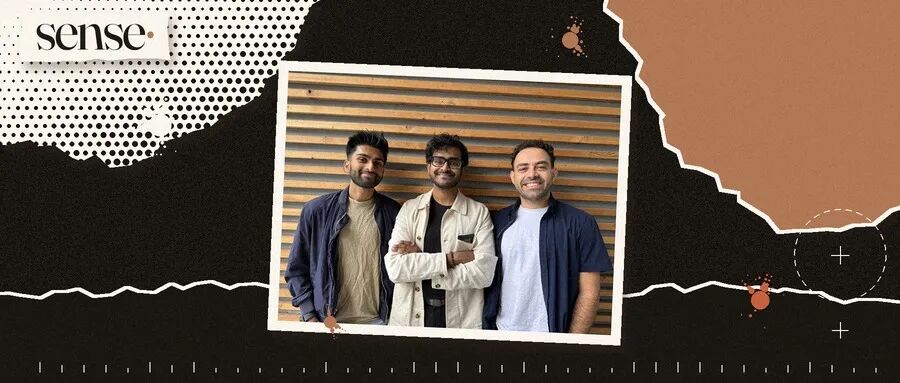
Ronak Malde 觉得这是现在的 AI 最可惜的地方。他的公司 Trajectory 刚刚拿到 4500 万美金的 A 轮,红杉美国领投,英伟达也跟了,估值 3 亿美金。公司成立一年左右,只有 18 个人,三个创始人是斯坦福大一第一周在同一节数学课上认识的同学。他们要做的事说起来很简单:让律师、医生、分析师这些行业里的人,用产品每天自然产生的反馈,自己把模型越训越好,不用再去养一个研究团队。
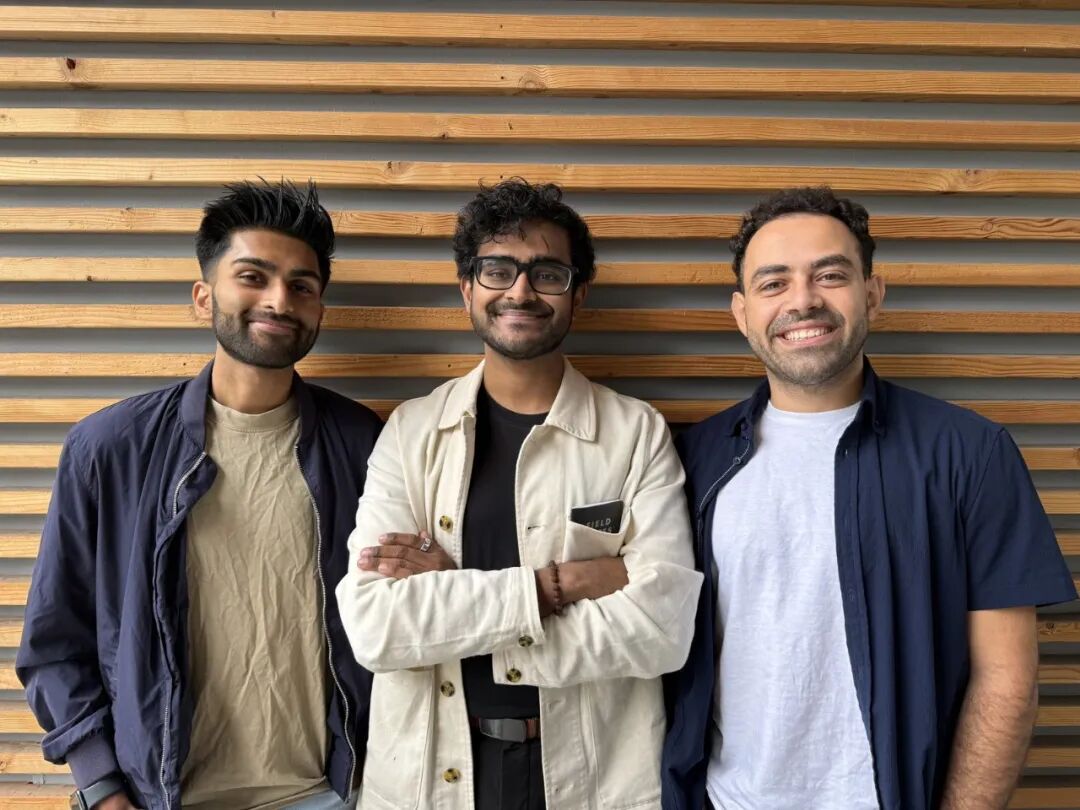
Trajectory 的三位创始人,他们是斯坦福大一时在同一节数学课上认识的。图片来自 TechCrunch
01 现在的模型很聪明,却不会从每天的工作里学东西
Ronak 打过一个比方,我觉得特别好懂。他说现在的基础模型就像一个非常聪明的博士生,但这个博士生永远是刚入职,什么都懂一点,对你这家公司具体怎么干活一无所知,而经济真正看重的,是一个在这份工作上干了 30 年的人。
差距在哪里?他的说法是,今天的 AI 再强,用起来还是和其他软件一样,是静态的。你昨天用的模型,明天还是那个模型,犯的还是那些错,用户在产品里给它的修改、纠正和重试,大多只是被记在日志里,然后就放在那里了。
他还用小时候的公路旅行讲过这件事。那时候家里出门自驾,要先去 AAA(美国汽车协会)领一沓纸质地图,工作人员把路线给你画好,路上要是想改路线,就得打电话回去,或者找一个线下网点重新拿一份。他觉得现在的模型就停在这个阶段,模型本身很聪明,但想更新一次,只能整批地、离线地重新训一遍,而且只有少数几个地方能做。Trajectory 想先做到 MapQuest 那一步,让每个人都能自己查路线,不用再跑去 AAA;最后想做到的是 Google Maps,你每开一次车,它都在学哪条路最快、哪里在堵。
这个比方好就好在,它把“持续学习”这个听起来很学术的词,讲成了一件大家都经历过的事。Google Maps 越用越准,靠的并不是哪个工程师每天在改地图,是几亿人每天开车留下的轨迹在帮它改。如果模型也能这样,那每家公司里的专家每天干的活,就都在顺手帮模型变好,这件事想想其实挺让人兴奋的。
02 他在 Windsurf 第一次看到,用户的修改能把模型训到前沿
Ronak 自己就是从这条路上走过来的。他在斯坦福读完硕士,当时可以直接去 Google 做 Gemini 的后训练,这是大多数人会选的路,但他见了 Codeium(后来改名 Windsurf)的团队,觉得那边人好、动作快,就去了。他那时候有个判断,下一次大的突破要么来自数学,要么来自写代码,因为这两样东西都足够有结构,而写代码显然更能赚钱。
一开始他们在训代码补全模型。后来 agent 起来了,他们发现手里的用户信号多得不得了,不只是用户接受还是拒绝了一条补全,还有用户怎么用 agent 搭起一整个网站、一整个应用,中间改了哪里、重试了几次。于是他们决定训一个自己的模型,叫 SWE-1,专门拿产品里这些真实的修改和重试做后训练,最后做出来的模型在他们自己的场景里超过了当时的前沿模型。
但他也说,这条路代价非常大。要几亿美金的研发和算力,要一个很大的研究团队,从开始到真正训出一个前沿水平的模型,花了六到九个月,而且一路上都离不开研究员手把手地盯着。Cursor 训自己的 Composer,走的也是同一条路,能这么干的公司,全世界没有几家。
SWE-1 出来没多久,Google 就把 Windsurf 的一批研究员带去了 DeepMind。Ronak 讲过那天的经过,听起来挺像电视剧:前一天 CTO 发消息,让他们第二天早上去一个酒店会议室,谁都别告诉。当时外面都在传 OpenAI 要收购 Windsurf,他以为进去会见到 OpenAI 的人,结果视频那头是 Demis 和一群 DeepMind 的人。那天是周四,他们当天就把工牌和电脑还给了 Windsurf,第二天已经是 DeepMind 的正式员工了。
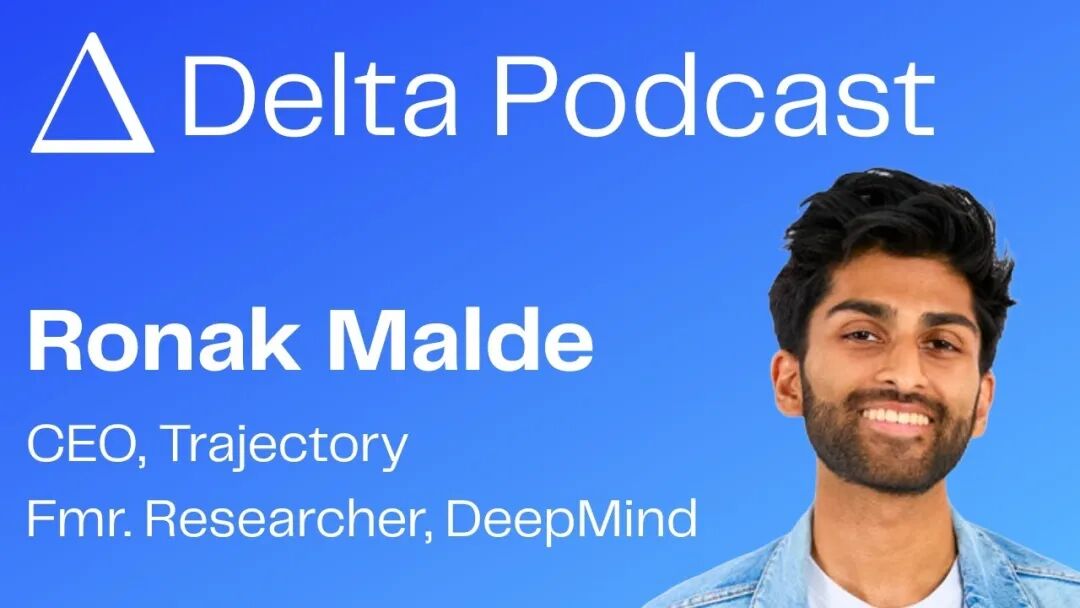
Ronak Malde 在 Delta 播客的访谈。图片来自 Delta Podcast 的 YouTube 视频
03 进了 DeepMind,他反而想明白大实验室做不了这件事
在 DeepMind,Ronak 参与了 Antigravity 的发布,也给 Gemini 3 出了力。他说那段时间让他见识到,一家算力充足的大公司能把前沿技术用到什么程度,但也让他想明白一件事:持续学习会是下一种主要的训练方式,可它很难在大实验室里做起来。
他讲的原因很直白,DeepMind 的全部精力是训一个巨大的模型,再把这一个模型发给全世界的人用,这个生意显然很成功。但如果你要为一个客户单独定制一个模型,再只给这一个客户部署,比如给 Harvey 训一个懂法律工作的模型,那要搭的基础设施非常多,对一个大实验室来说,为一个客户做这么多事很不划算。
他的两个联合创始人,在各自的位置上也碰到了同一个问题。Michael Elabd 在 DeepMind 做机器人,他们在想办法把机器人放到真实世界里,让它们每天根据新的数据更新一次。Arjun Karanam 在苹果做 Vision Pro 的交互模型,想的是怎么把艺术家的反馈用来改进多模态模型。三个人做的东西完全不同,问的却是同一个问题:怎么把真实世界里的反馈,变成模型实实在在的进步。
于是 Ronak 决定出来,放弃了收购给他的那笔钱。他的理由是,写代码这件事过去几年被 AI 彻底改变了,接下来法律、医疗、金融都会经历一样的事,而 SWE-1、Cursor 的 Composer、Claude Code 这些围绕产品和真实用户去打磨模型的做法,正是让这几家公司跑到前面的原因,他想把这个能力带给每一家公司。
我觉得他看到的这一层很关键。大多数人在大实验室里看到的是模型一代比一代强,他看到的是模型和真实的工作之间还隔着一段距离,而这段距离,大实验室天然没有动力去补,因为它的生意就是用一个模型服务所有人。
04 训一个自己的模型,到底要准备什么
那一家普通公司想用产品里的反馈训模型,要准备什么?Ronak 把它拆成了三样东西。
第一样是记录,你要把生产环境里发生的每一次任务完整地记下来,不只是主 agent 的那一次调用,还有它下面每个子 agent 做了什么,用户在产品里点了什么、改了什么、给了什么反馈,最好能拼成一条完整的时间线。很多 AI 原生公司已经在用 LangChain、Braintrust 这类工具做这件事了。
第二样是能把这些记录重放出来。光有记录还不够,你得能把生产里发生过的一次任务原样再跑一遍,才能拿它做评测、做训练,这就需要搭一个和生产环境尽量一样的环境。第三样才是真正的训练,损失函数、奖励函数、整套训练流程,这是公司自己最难做的部分,也是 Trajectory 最先替客户包起来的部分。
他说目前最费人工的有两块。一块是环境,很多时候根本搭不出一个和生产完全一致的环境。另一块是奖励,法律、投行这种工作,很少有一个能自动判断对错的标准答案。
针对环境,他讲了一个挺有意思的研究方向。现在后训练最常用的算法叫 GRPO,他打了个比方:一个游戏角色在关卡里跳来跳去,到终点拿到一个分数,GRPO 要求同一关打 8 次或者 16 次,互相比较,才知道哪种打法更好,这一组就叫一个 group。可人不是这样学东西的,人在真实世界里每件事通常只经历一次,没法把同一天重过 16 遍。所以他们在把 GRPO 改成每组只有一次,一万条记录各自来自不同的任务,每条只跑过一次,模型也能从里面学到东西,这样就不需要专门去搭那个重放的环境了。
奖励这一块,他们的办法也很实在,假如你有一万条记录,原本要一条一条去标哪个好、哪个不好,工作量太大。他们的办法是从里面挑出 100 条最有代表性的,让客户只在这 100 条上认真写清楚标准,然后训一个评分模型,把从这 100 条里学到的判断推到剩下的一万条上。Ronak 说他心里最理想的样子,是有一个看板告诉你,你的 agent 有五件事做得好、五件事做得差,你把差的那五件圈出来,点一下训练就行了。
从这里最能看出 Trajectory 在干什么,它把一件原本只有研究员能干的事一层层拆开,看哪些能自动化,哪些必须问人,最后只把“什么是好的”这一个问题留给客户回答,而这个问题,恰好是律师、医生、分析师最有资格回答的。
05 Harvey 和 Rogo 用它训出了什么样的模型
Harvey(做法律 AI 的公司)是一个很好的例子。它一直是在闭源的前沿模型上面搭产品,做得很成功,很多律所都在用。但 Ronak 说,Harvey 手里积累了大量的东西,它知道律所真正在意什么,还自己做了一套法律 agent 的评测,可只要底下用的是别人的闭源模型,这些积累就没法变成模型本身的能力。
用了 Trajectory 之后,Harvey 拿开源模型训了一个自己的模型。在那套法律评测上,原本开源模型的准确率大约只有 4%,训完以后到了 18% 左右,成本只有前沿模型的六分之一。Ronak 也承认 18% 离天花板还远,但他觉得更重要的是 Harvey 第一次有了一个研究实验室的能力,可以自己决定模型往哪里走,而且因为便宜了六倍,同样的钱可以让模型多花很多 token 去把一件事做好。
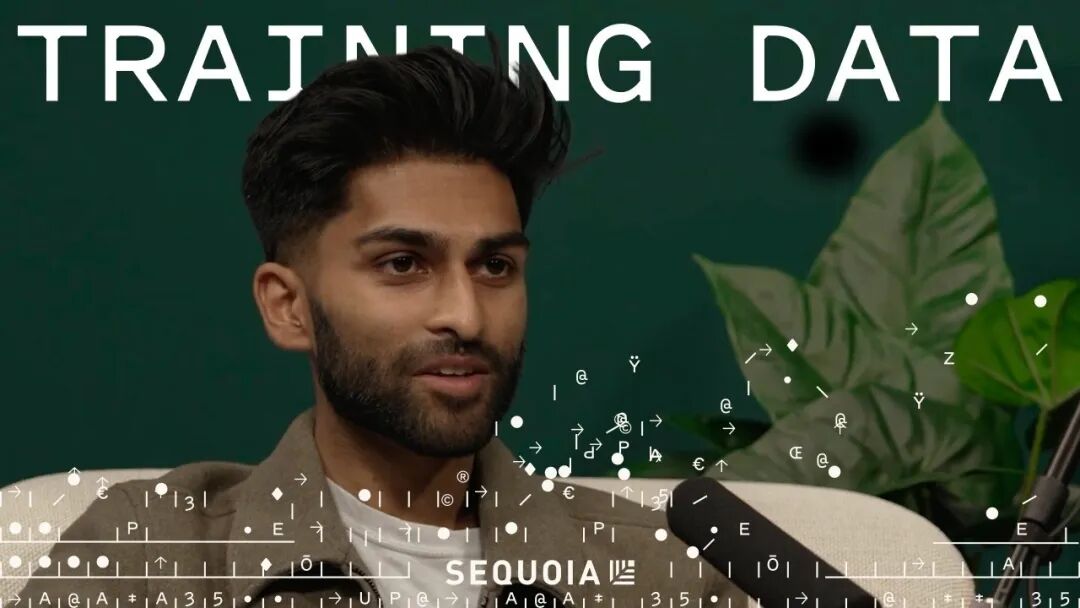
Ronak 在红杉美国的播客 Training Data 上讲 Trajectory 怎么做持续学习。图片来自 Sequoia Capital 的 YouTube 视频
Rogo(做金融 agent 的公司)想要的东西不太一样。Ronak 说很多 agent 很啰嗦,跑出去一大圈,回来带着一堆没用的东西,而 Rogo 想要一个简洁、干脆的金融 agent,能在后台自己把活干完,回来的时候给你的东西很精炼。他们管这个叫“智能密度”,同一件事,用更少的 token 做完。Rogo 用自己的数据训出来的模型,token 用量少了好几倍,也更快、更便宜,在他们自己关心的指标上还在往上爬。
我觉得这两个例子放在一起看挺有意思。Harvey 在意的是准确率,Rogo 在意的是简洁和省钱,两家对“好”的定义差别很大,这恰好说明为什么很难指望一个通用模型满足所有人。Ronak 说过,Harvey 可能比世界上任何一家公司都更懂 AI 怎么帮律师干活,这种专业判断应该握在 Harvey 自己手里,用不着另一家公司进来告诉它该怎么做。
06 他想把训练、评测和部署放在一个地方
Ronak 说他们做产品的很多想法来自苹果。21 世纪初,人们有能上网的电脑,也有能打电话的手机,但没人想到把两者合在一起,直到苹果说,把互联网放进一个拿在手里的设备里怎么样。他觉得训练、评测和部署今天也是散在三个地方的,Trajectory 想把三件事放在一起,简单到每个人都能用:你把 agent 的记录和你对“好”的定义放进来,一键训练,评测完直接部署,新模型回到产品里,收集新的记录,下一轮接着训。
Trajectory 官网。图片来自 Trajectory
公司的名字也是这么来的。他说现在整个行业都在算 token,好像 token 就是工作的单位,可人和人一起干活的时候,没人会数对方说了多少个字,大家想的是一件任务、一段过程。在强化学习里,trajectory 指的就是模型完整走一遍的过程,放到真实世界里,每一条 trajectory 就是一件有经济价值的任务,他希望以后大家衡量 AI 的工作时用的是这个单位。他还说,这个词对不懂强化学习的人来说也说得通,就是让每家公司自己走出自己的路。
他眼下的客户主要是 Harvey、Rogo 这样已经把 agent 搭得很完整的 AI 原生公司,英伟达 这样的大公司也在用。下一步他想把同样的思路用到 harness(包在模型外面的那一层调度和工具)上。在他看来,训模型带来的是效率,同一件事见过一千遍,就能做得更快、更便宜、更稳,改 harness 带来的则是以前做不到的新能力。他设想以后一家公司可能只有一成的任务交给最强的前沿模型,剩下九成交给自己训出来的模型,既快又省钱。
说到以后做产品的人干什么,他用了一个园丁的比方:产品会自己长,做产品的人要做的,是在地里插好架子,告诉它往哪个方向长。一个产品放给几百个用户,它会根据这些用户自己变好,人要做的是把自己的品味放进去。我觉得这话听起来有点远,但如果模型真能从每天的使用里学习,做产品的重心确实会慢慢从“写功能”挪到“定方向”上去。
我自己的一点思考
Ronak 提过一个对比,他说上一代最大的互联网公司,Google、Amazon、Facebook,其实一直都在做持续学习,推荐系统和广告系统就是把真实世界里用户的偏好不断收进来,系统越用越聪明。但到了 agent 这一代,这样的东西还没出现,他想让 Trajectory 最后变成一个巨大的推荐系统,让每一个 agent 都贴合每家公司、每个用户想要的样子。
我很认同这个对比。今天大家用 AI,有点像所有人都去问同一个神谕,问完了,答案好不好、哪里需要改,反馈都留在了自己手里,没有回到模型身上。Ronak 说现在大约只有 1% 的企业真正把 AI 用进了日常的工作,他想把它变成 99%。真要走到那一步,我觉得靠的大概不是一个更聪明的通用模型,而是每家公司都能把自己攒了很多年的经验,用一种不那么费劲的方式教给模型。
难处当然也很明显,Harvey 从 4% 到 18%,说明这件事有用,也说明离一个干了 30 年的老律师还差得远。挑 100 条写标准、再让评分模型推到一万条上,这个办法在法律、医疗这种连专家之间都会争论“什么算好”的领域里能不能站稳,还要看更多客户真正用下来的结果。我倒是挺认同 Michael 的一个说法,让人一直参与在训练过程里,比让模型完全自己改进自己要安全得多,专家定标准、模型去学,这个分工本身就比较让人放心。
Trajectory 现在已经把平台公开给所有人用了。接下来要看的是,有多少律师、医生和分析师愿意花时间,把自己心里“什么算好”写下来,再去点那个训练按钮。
资料来源:
TechCrunch,Trajectory raises $45M to make AI model training accessible to nontechnical experts,Marina Temkin,2026-11-02原文 https://techcrunch.com/2026/11/02/trajectory-raises-45m-to-make-ai-model-training-accessible-to-nontechnical-experts/
Sequoia Capital Training Data,A Model For Everyone: How Ronak From Trajectory Is Building Products For Continual Learning原文 https://www.youtube.com/watch?v=32vxW6GMeLY
Latent Space,Every product of the future will be a living system,Ronak Malde原文 https://www.youtube.com/watch?v=DcvgPEApHT8
Delta Podcast,Ep. 60: Ronak Malde, Trajectory CEO and Former DeepMind Researcher原文 https://www.youtube.com/watch?v=9Cp37Vz0zzc
Trajectory 官网原文 https://trajectory.ai
本文由人人都是产品经理作者【深思SenseAI】,微信公众号:【深思SenseAI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供


- 目前还没评论,等你发挥!