
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Qwen4-Max 发布后,2.4T 模型先把 Token 效率和工具闭环做成生产力


模型竞争的重心正在从参数体量转向完成同一项工作的实际成本:要花多少词元、调多少工具、经过几轮验证。新发布的模型把激活参数压到极小比例,在长任务里把单次调用的节省累积成账单差异,并把智能体编排、专业工具调用和持续交付放进同一套工作流验证。
模型竞争正在从“参数更大”转向“完成同一项工作要花多少 Token、调用多少工具、经过多少轮验证”。阿里发布 Qwen4-Max,公布的规格是总参数 2.4T、激活参数 71B,支持原生视觉和百万上下文;更值得开发者关注的是,它把重点放在智能体、编程、专业工具调用和长周期任务上。
原文披露,在 Terminal-Bench 4.0 的 Xhigh 思考档位,Qwen4-Max 单次尝试平均 Token 用量从上一代的 289K 降至 151K,评测分数从 38.9 提升到 48.5,单任务成本下降 58%。这类数字比“总参数 2.4T”更接近生产环境的真实账单。
Qwen4-Max 的意义,不只是又一个更强模型,而是把模型架构、持续交付、多 Agent 编排和行业工具调用放到同一套工作流里验证。
2.4T 总参数,真正被激活的是 71B
Qwen4-Max 采用基于 Qwen 稀疏注意力的 MoE 架构,总参数 2.4T,但单个 Token 只激活 71B 参数。相比上一代,每个 Token 激活参数减少 25%。
这类设计的核心不是让模型“看起来更大”,而是在保持容量的同时减少每一步推理需要参与计算的参数数量。对长任务 Agent 来说,单次调用的节省会被上下文长度、工具次数和重试次数放大,激活参数与 Token 消耗因此会直接影响成本。
开发者在评估模型时,可以把三个指标放在一起看:
| 指标 | 说明 | 为什么重要 |
|---|---|---|
| 激活参数 | 每个 Token 实际参与计算的参数量 | 影响推理效率和吞吐 |
| 平均 Token | 完成一次尝试所需的输入、输出和思考 Token | 影响长任务账单 |
| Cost per Task | 完成一个完整任务的平均费用 | 比单价更接近业务成本 |
一个模型即使单价更低,如果需要更多轮重试和更长上下文,最终成本仍可能上升。Qwen4-Max 给出的价值主张,正是把模型质量和任务级成本一起优化。
编程评测提升,关键是长任务效率
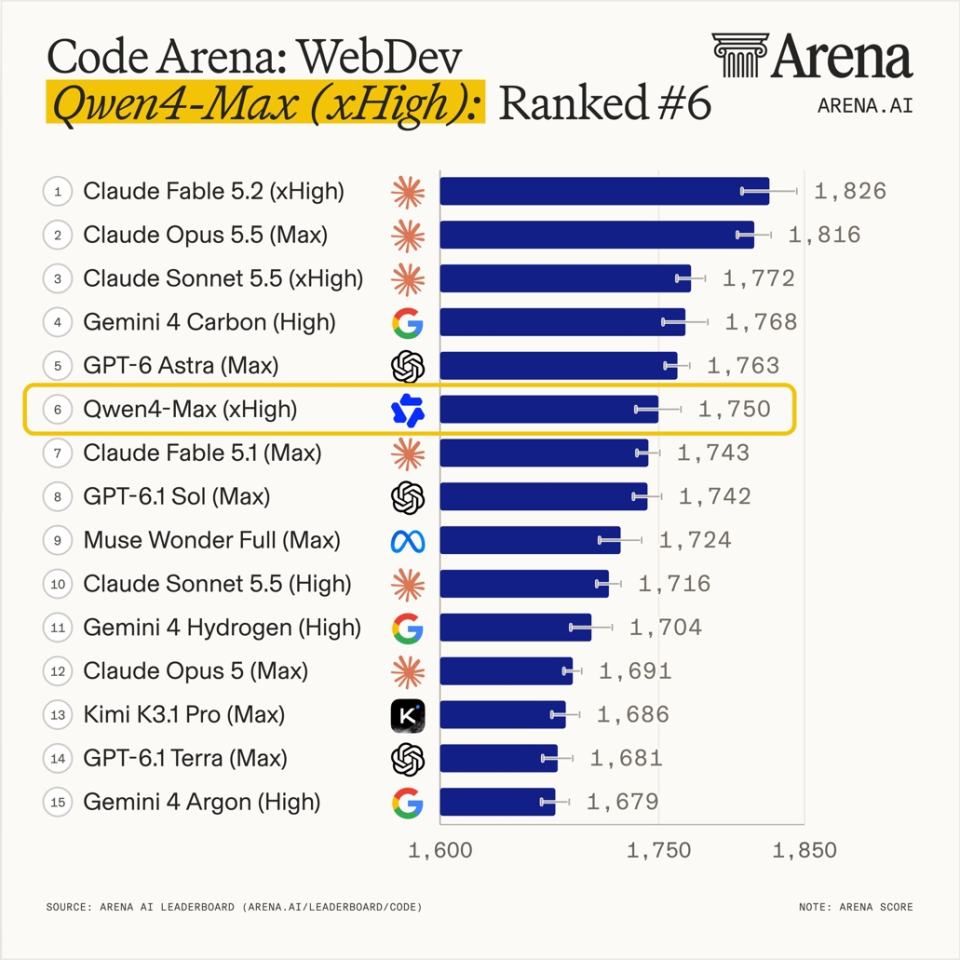
在 CodeArena 全球前端编程盲测中,Qwen4-Max Webdev 位列第 6;在 Agents’ Last Exam 中得分 46.7,较 Qwen3.8-Max 提升 18.8 分;Chartography 得分 54.2,JobBench 得分 68.5,HLAB-Vals-1.1 得分 21.3。
这些评测覆盖前端生成、智能体任务、专业图表理解、工作任务和法律场景。它们不能证明模型在所有代码库中都能稳定交付,但可以说明模型的优化方向已经从单轮代码补全扩展到多步骤专业任务。
更有工程价值的是 Terminal-Bench 4.0 的对比:同为 Xhigh 档位,Qwen4-Max 平均 Token 用量接近减少一半,得分反而提升。这通常意味着模型在规划、上下文使用和工具调用上更有效率,而不是只靠增加输出长度获得分数。
落地时仍然要把模型放进自己的基准集。建议至少包含:跨文件修改、依赖升级、测试失败后修复、终端权限限制、长上下文检索和人工验收。公开榜单适合做横向筛选,不能替代真实仓库回归。
Live Delivery:先交付可用版本,再持续扩展
Qwen4-Max 在模型内加入持续交付机制。它可以先生成一个可用的首版,再根据用户反馈逐版扩展,而不是等所有需求都澄清后一次性输出。
原文给出的案例是一个物理课堂科普网站:模型先交付可用版本,再经过 14 次迭代,最终加入 3D 动画、交互实验和原理说明。这个模式对 AI 编程产品很重要,因为用户往往无法一开始就写出完整需求,真正的需求会在看到可运行结果后逐步出现。
但持续交付必须建立版本边界。每次迭代都应保存:
- 用户反馈和本轮目标;
- 变更文件与差异;
- 自动化测试和视觉检查结果;
- 上一版本的可回滚入口;
- 当前未解决的问题和下一轮计划。
没有版本和回滚,持续交付很容易变成持续覆盖;有了版本链,Agent 才能像一个短周期迭代团队一样工作。
MCP 和专业工具,决定模型能不能进入行业现场
Qwen4 的应用重点不只在聊天和代码生成,而是调用专业工具。公开材料显示,金融投研场景中模型可以调用 90 个 MCP 专业工具,生成 Excel 底稿和 PPT 报告,并支持双重溯源;游戏开发中可以更好地调用 Blender,生成 3D 游戏;汽车制造则覆盖产线规划、零件设计和加工验证。
工具数量越多,编排难度越高。企业不能只把 MCP 列表交给模型,还需要为每个工具定义输入 schema、权限、超时、幂等性和审计字段。模型可以选择工具,但系统必须校验工具调用是否符合当前用户、项目和数据范围。
双重溯源也是关键。金融报告中的每个数字,应该能回到原始文件、计算步骤或数据接口;科学研究中的每个结论,也应保留检索证据和实验记录。模型生成的报告只是最终视图,不能替代底层证据链。
从 721 个工作领域到长周期 Agent
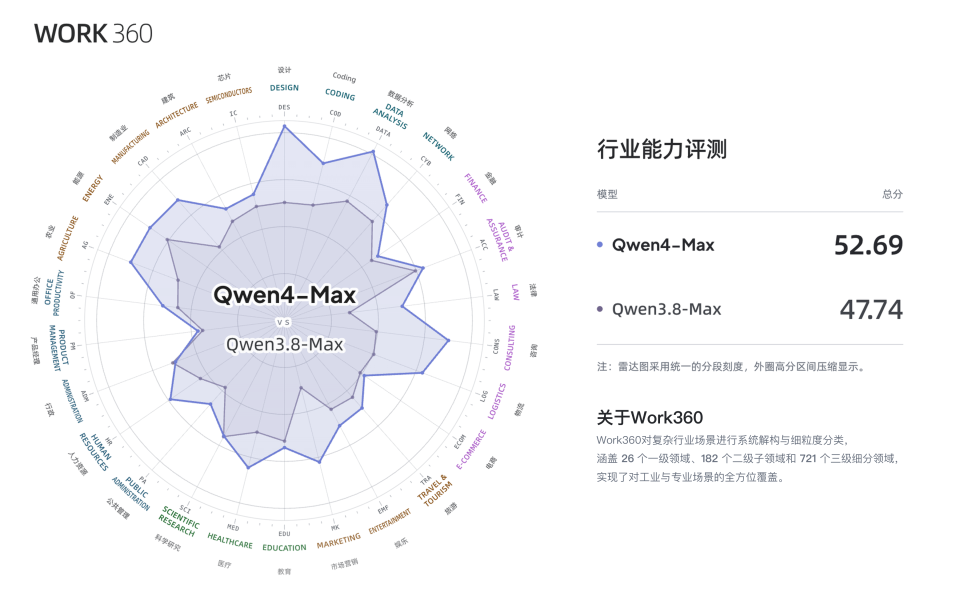
千问团队构建了覆盖 721 个细分方向的 Work360 体系,Qwen4-Max 得分 52.69,较上一代整体提升超过 10%。这类场景建模说明,模型优化不再只围绕通用问答,而是针对不同工作中的工具、数据和验收标准做适配。
材料发现案例中,Qwen4 连续运行 48 小时,从 270 万个候选分子中筛选候选,并通过 4 轮“设计 – 合成 – 测试”闭环,合成出一种新型冷却液材料。药物发现案例中,模型通过 454 次工具调用完成 3239 项计算评估,设计优化 24 个候选分子,最终优选分子的名义结合亲和力较起点分子提升约 3.6 倍。
这些数字更像研究流程展示,而不是可以直接复用的生产承诺。对开发者来说,真正值得借鉴的是长周期任务的组织方式:任务状态要持久化,工具调用要可重试,实验结果要可验证,Agent 需要在每轮结束时留下下一轮可以读取的进度。
如何把 Qwen4-Max 接进自己的系统
Qwen4-Max 已通过千问 AI 平台提供 API,也可以通过 Token Plan 或千问办公、Qoder、千问 App 等产品使用。开发者接入时,建议按三层设计:
- 模型层:管理模型版本、上下文窗口、思考档位和降级策略。
- 工具层:统一 MCP、数据库、文件、浏览器和企业系统的权限与超时。
- 任务层:保存计划、运行状态、产物、验证结果和人工审批。
这三层分开后,模型升级不会直接改变业务权限,工具替换也不会破坏任务状态。对成本敏感的团队,可以把 Qwen4-Max 用在复杂规划、长上下文和高难度调试,把更轻量的模型用于格式整理、简单生成和低风险分类。
国内开发者如果需要通过 API 统一接入模型,可以了解 [Code80]https://code.ai80.vip/home 这类渠道;但 Token 预算、MCP 权限、数据脱敏和人工验收仍要由团队自行维护。
常见问题
2.4T 参数是否代表每次推理都会消耗同等规模的算力?
不代表。Qwen4-Max 使用 MoE 架构,总参数为 2.4T,但每个 Token 激活约 71B 参数。实际成本还会受到上下文、思考档位、工具调用和重试影响。
Qwen4-Max 是否已经全面超过所有海外模型?
不能这样推导。它在部分编程、智能体和专业任务评测中进入领先位置,但不同评测的任务分布不同,其他模型在部分软件工程和综合推理测试中仍可能更强。
Live Delivery 适合什么开发流程?
适合需求会逐步明确的产品和原型项目。每轮交付都必须保留版本、测试和回滚,否则迭代越多,系统越难恢复。
MCP 工具越多越好吗?
不是。工具数量增加会提高路由、权限和审计复杂度。应该优先接入高价值、接口稳定、结果可验证的工具,再逐步扩展。
如何核算 Qwen4-Max 的真实成本?
不要只看 Token 单价。还要记录平均 Token、思考轮次、工具调用、失败重试、人工接管和每个完整任务的总费用。
国内团队如何接入 Qwen4-Max?
可以通过 Code80 等 API 渠道降低接入摩擦,但模型路由、密钥管理、工具权限和数据审计仍需自行配置。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!