


 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
只会搜关键词还不够,Agent 需要一套更聪明的本地搜索


ripgrep 之外,Agent 还需要语义检索。8 月底开源的 zvec-grep 把语义、BM25 全文、rg 正则和混合检索收进同一个接口,让 CLI 与 Agent 共用一份本地索引。
对于开发者来说,ripgrep,也就是常说的 rg,几乎是本地搜索的标配。它速度快,结果准确,尤其适合查找函数名、配置项、错误信息和一段明确的文本。只要知道要找什么,rg 往往能在很短时间内给出答案。
但 Agent 面对的任务,很多时候并没有这么明确。
比如 「主题偏好是怎么在应用启动时恢复的?」
代码里可能没有「主题偏好」这几个字,真正负责这件事的函数名却叫:
hydratePreferences
这时,单纯依赖关键词搜索就容易遇到问题。关键词猜错,可能什么也搜不到;关键词过于宽泛,又会得到一大批没有排序的结果。Agent 只能不断修改查询词、打开文件、阅读上下文,再尝试拼出完整的调用链。
这个过程可以称为「检索税」。它消耗的不只是时间,还有工具调用次数、上下文窗口和模型 Token。
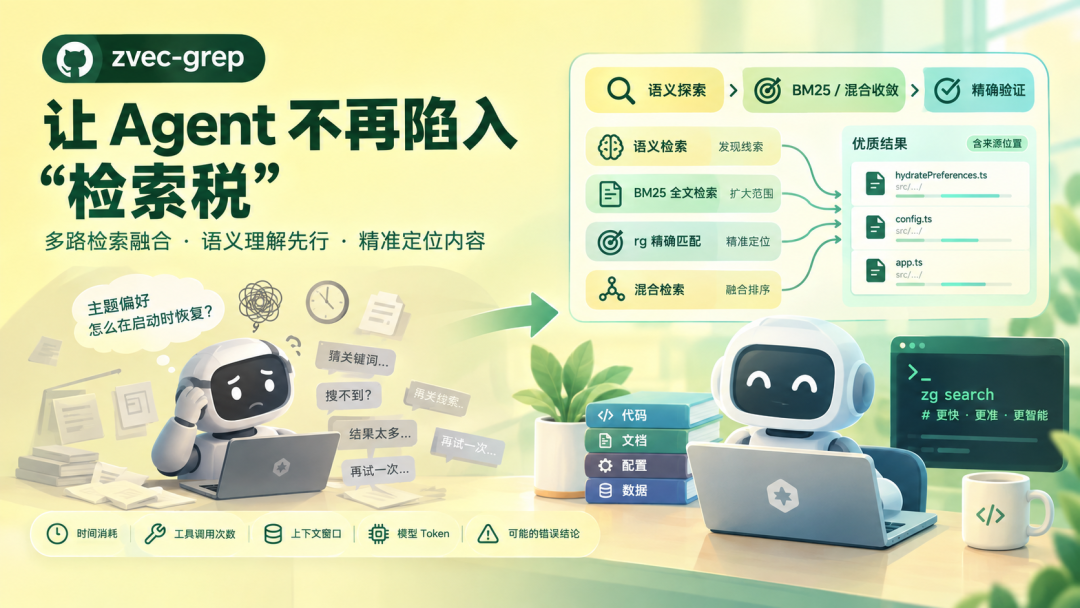
更麻烦的是,如果搜索过程遗漏了关键文件,Agent 可能会根据不完整的信息得出一个看似合理、实际错误的结论。
最近看到的 zvec-grep,简称 zg,正是针对这类问题设计的本地优先搜索层。
8 月底才开源,目前已经 3.5K Star,仓库也在持续更新
01 zvec-grep 解决的核心问题是什么?
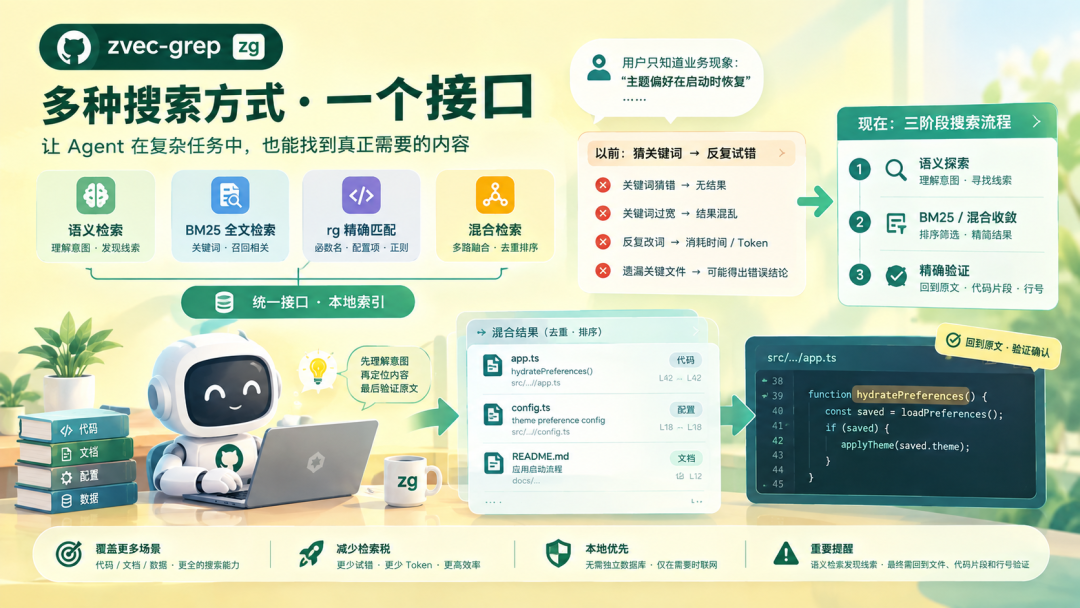
简单来说,zg 把几种不同的本地搜索方式放到了同一个接口里:
- 语义检索:用自然语言描述问题,就能找到可能相关的代码与文档
- BM25 全文检索:结果较多时用来排序和收敛,把不相关的内容压下去
- rg 精确匹配和正则搜索:已经知道要找什么的时候,依然是最快的那条路
- 混合检索与结果融合:多路结果去重排序,优先给出带来源位置的紧凑片段
它的定位不是取代 rg,而是让本地搜索覆盖更多场景。当用户只知道一个函数名、一段报错信息或一个配置项时,精确搜索依然非常有效;当用户只知道业务现象、实现意图或问题描述时,语义检索可以帮助发现可能相关的代码和文档;当结果较多时,BM25 和混合检索可以进一步帮助排序和收敛。
以「主题偏好在启动时恢复」为例,Agent 不必一开始就猜测 hydratePreferences 这个函数名。它可以先用自然语言寻找相关实现,再根据返回的文件路径、符号和代码片段,继续使用精确搜索验证调用关系。
这里的关键变化在于,搜索过程从「猜关键词」变成了:
「先理解意图,再定位相关内容,最后回到原文验证」
当然,这并不意味着语义搜索可以替代人工验证。语义检索适合发现线索,最终结论仍然应当回到具体文件、代码片段和行号。
02 一个索引,多种检索方式
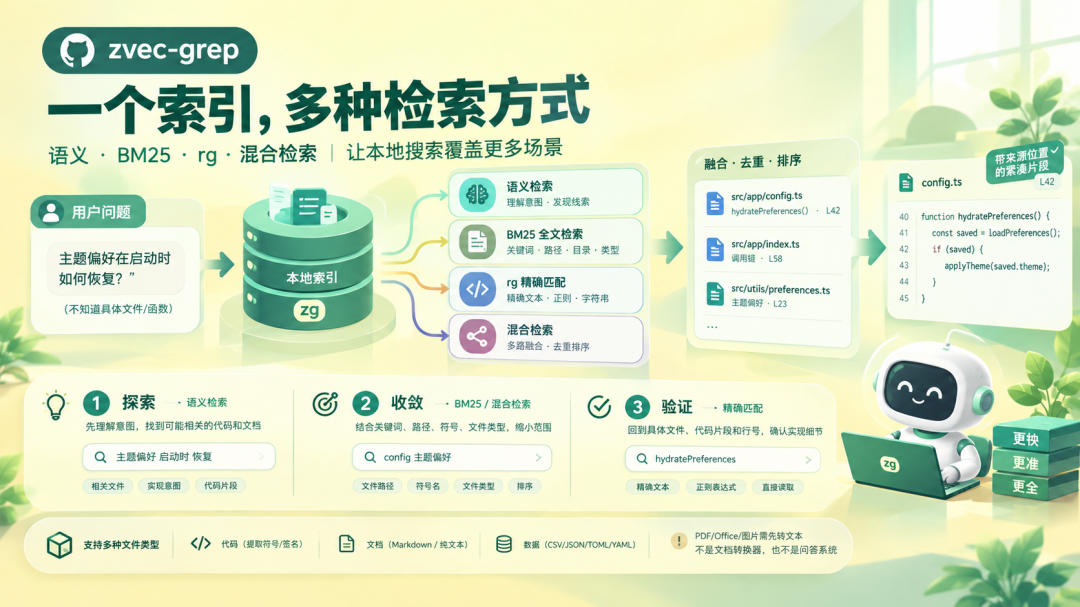
zg 的核心设计,可以理解为一份本地索引,连接了多条检索路径。
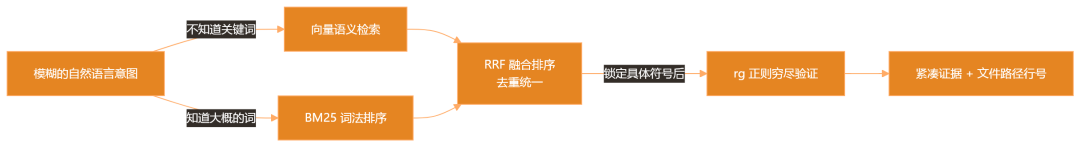
可以把一次典型的检索过程理解为三个阶段。
- 探索:只知道问题的大致含义,还不知道具体文件和符号在哪里,此时适合使用语义搜索。
- 收敛:结果返回后,结合关键词、路径、符号和文件类型缩小范围,BM25 或混合检索适合这一阶段。
- 验证:目标已比较明确时,用精确文本、正则表达式或直接读取文件内容,确认实现细节。
这三个阶段并非固定流程。已有明确关键词时,可以直接从精确搜索开始;如果问题涉及多个模块,也可以先用语义检索寻找入口,再沿着调用链逐步展开。
在结果处理上,zg 会对不同检索路径返回的结果进行融合、去重和排序,并优先提供带有来源位置的紧凑片段。Agent 可以先阅读这些证据,确认方向后再读取完整文件,从而减少无关内容进入上下文。
03 它到底能搜索哪些内容?
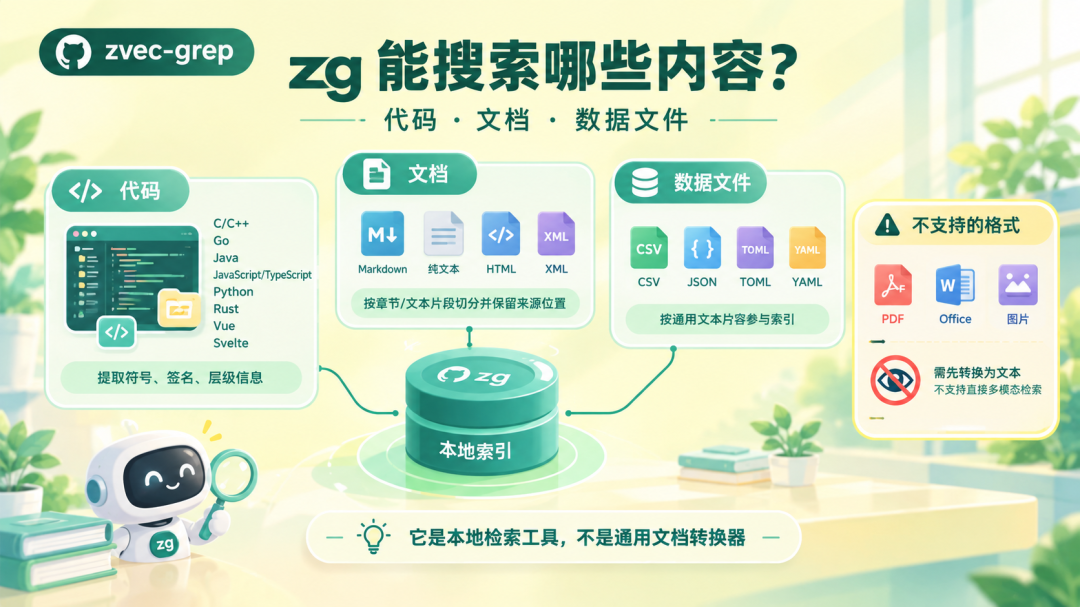
zg 的检索对象不局限于代码仓库。根据项目文档,目前主要覆盖以下内容:
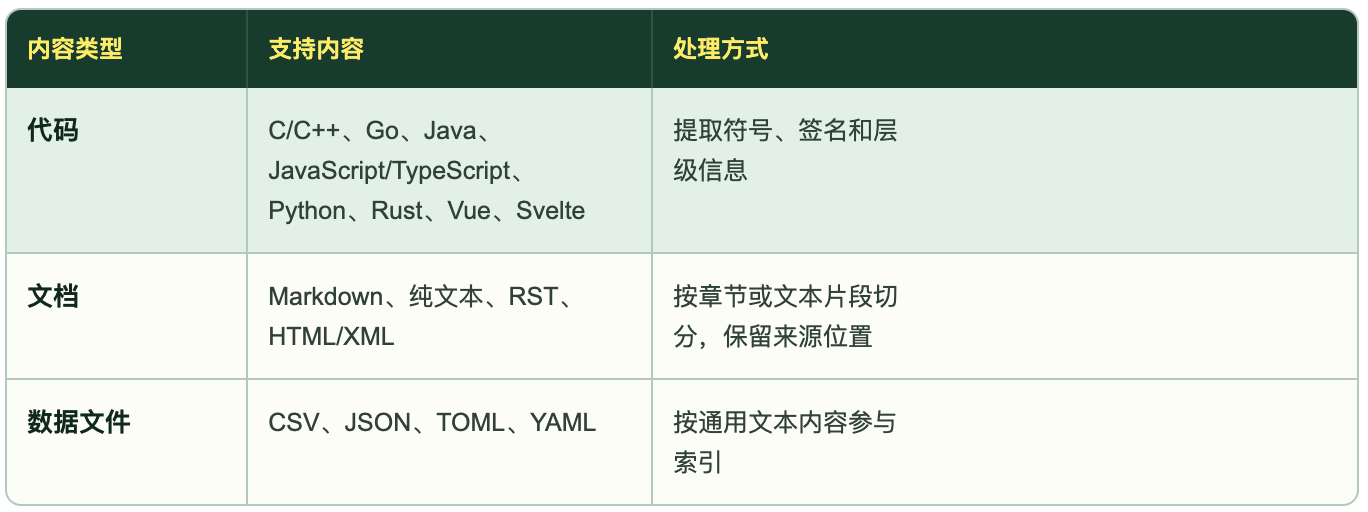
因此,代码仓库、项目文档、研究资料和本地知识库,都可以成为搜索对象。
边界:zg 本身是检索工具,不是通用文档转换器。对于 PDF、Office 文档或扫描图片,通常需要先将内容转换成可识别的文本格式,再交给它建立索引。官方项目目前也没有把原生 PDF、Office 文件和图片多模态检索列为已支持能力。
这个边界很重要。把它理解成「什么文件都能直接搜」,容易产生不切实际的预期。
04 如何部署:装一次,人和 Agent 共用
三步安装,CLI 和 Agent 共用一份索引。zg 需要 Node.js 22 或更高版本,安装命令如下:
# 1. 安装(需要 Node.js 22+)
npm install -g @zvec/zvec-grep
# 2. 自动发现本机已装的 Agent 并完成 MCP 配置
zg install
# 3. 进入工作区建索引,默认用轻量本地模型
zg index
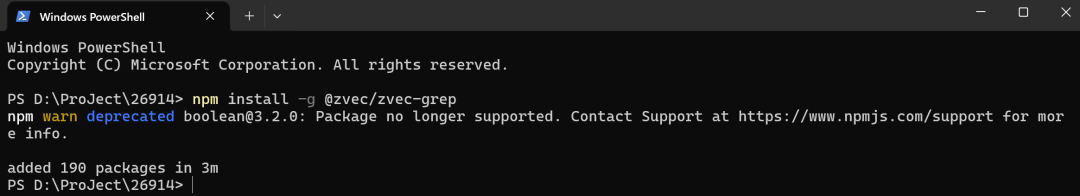
默认模型开箱即用
zg index 不带参数时用本地模型 potion-code-16m-v2,16M 参数、约 32MiB 缓存、不需要 GPU。
索引是持久资产
存在该目录下的 .zvec-grep/ 文件夹里,建一次反复用,之后文件有变化只增量处理变化部分,不用重建。如果目录是 git 仓库,建议把它加进 .gitignore。
纯文档场景换模型
搜代码用默认即可;如果是文档、书籍这类纯文本知识库,建议用 zg index –embedding local/potion-multilingual-128m,检索导向的模型对散文效果更好。
05 如何使用?
模式 1 先从命令行搜索一个本地资料库
先进入到你的工作区。比如,我在 D 盘放了一个关于美食的工作区(文件夹)。
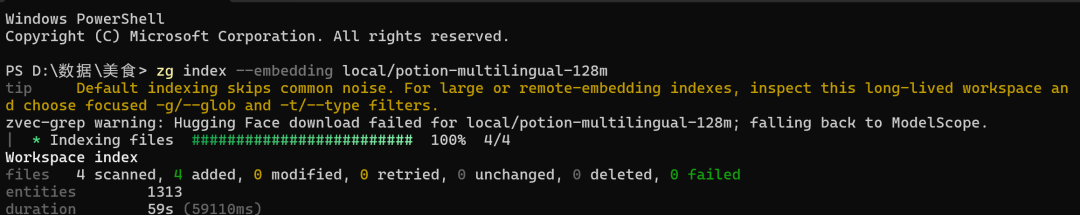
在终端进入到工作区后,执行建索引。由于咱们的场景是文档,就用自带的 potion-multilingual-128m 试一下:
zg index –embedding local/potion-multilingual-128m
它会先下载这个模型,然后建立索引。
然后试着用自然语言搜索,返回前 3 条:
zg query –human “梳理咖啡的分类” –limit 3
zg 会返回相关文档片段、文件位置和匹配内容。它本身不会直接生成一篇完整的总结文章,主要职责是找到相关证据。
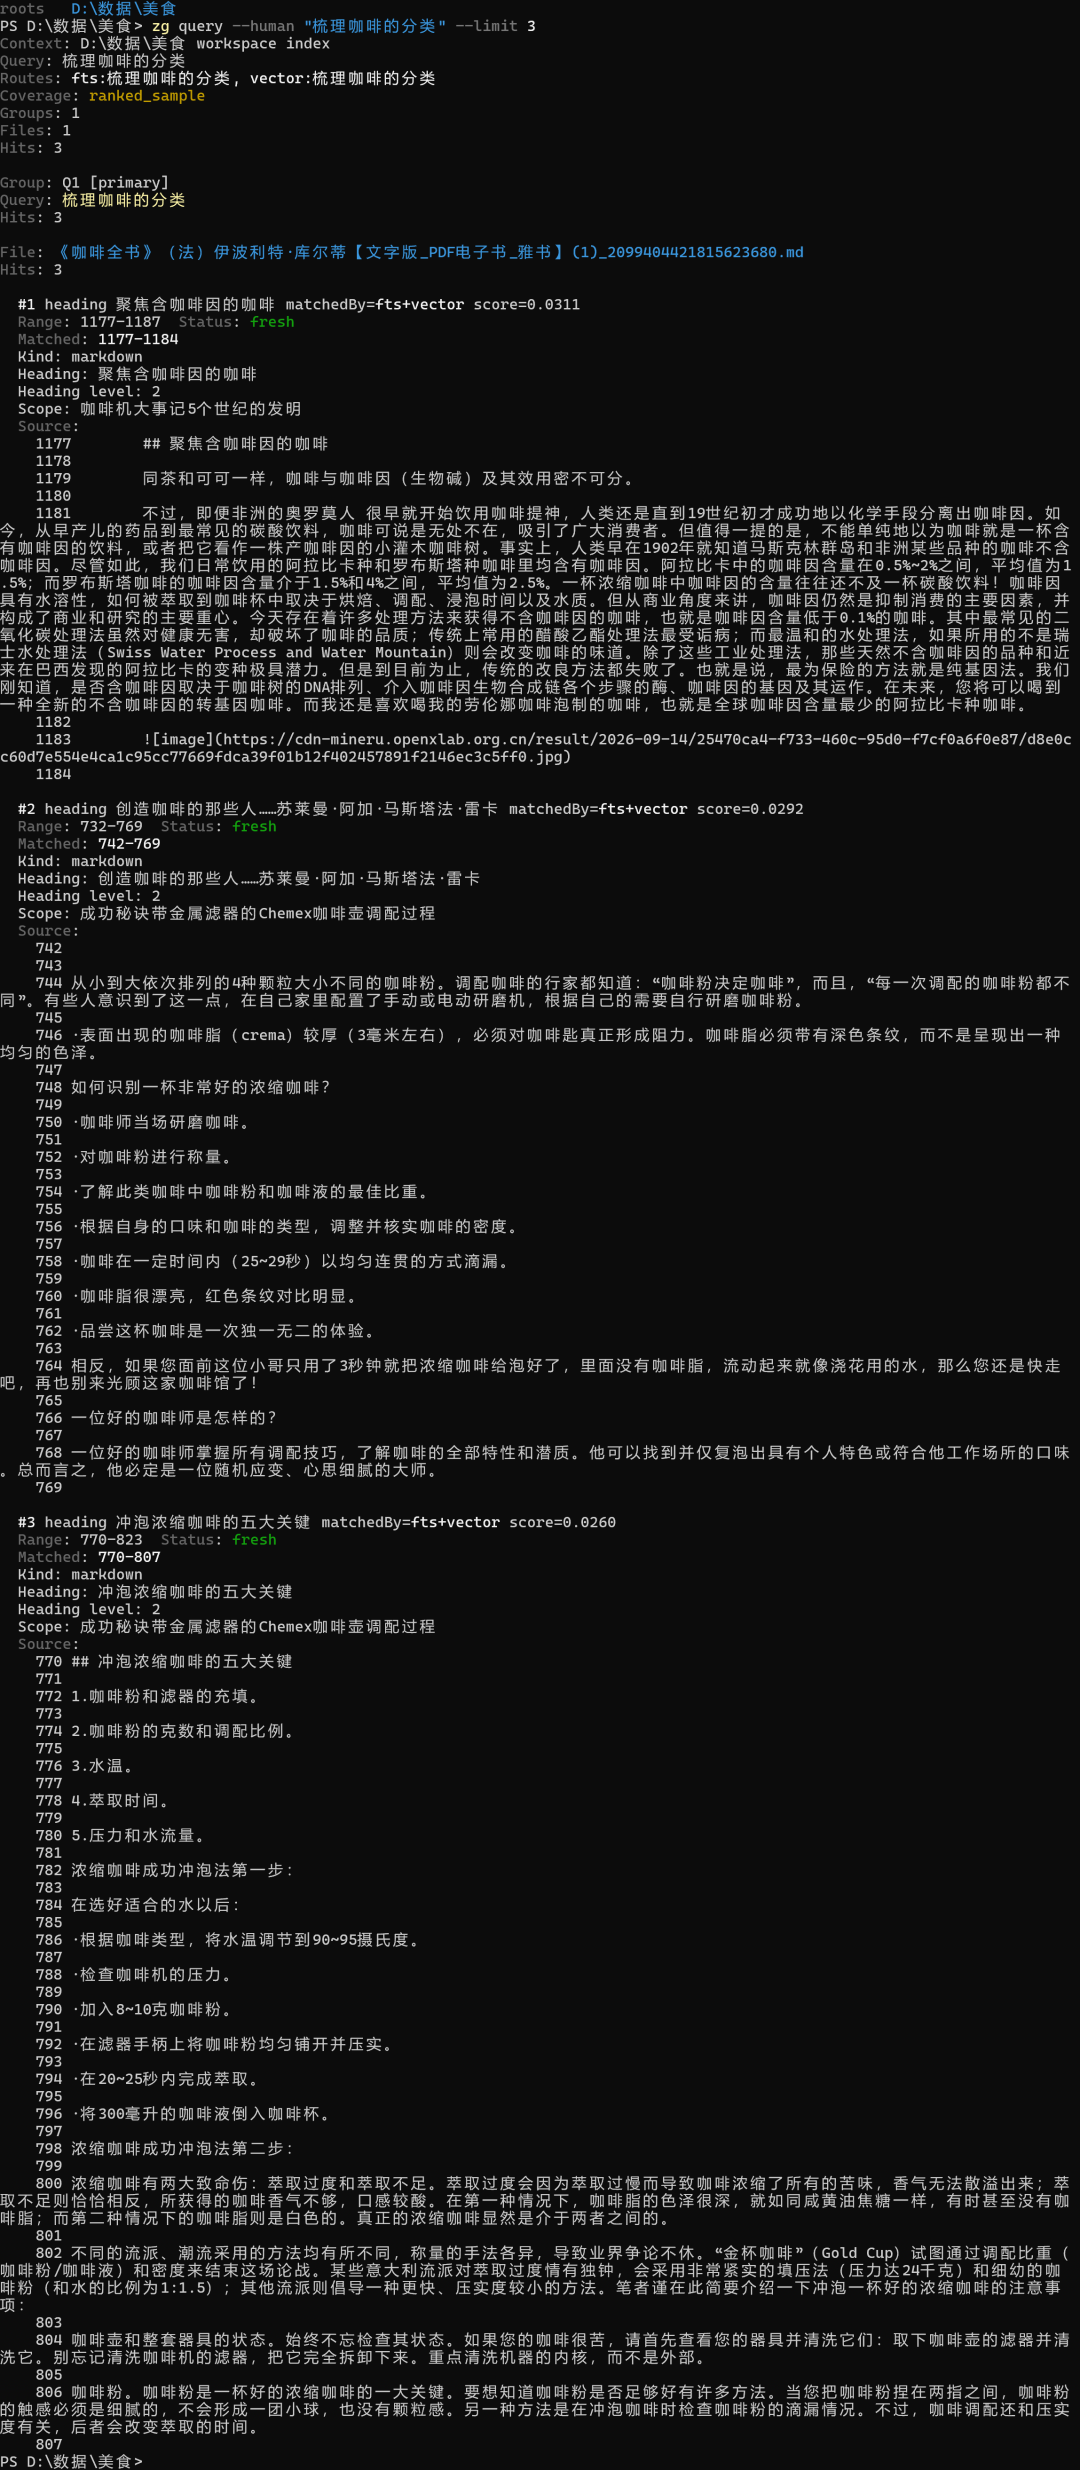
这种查询不要求用户记住资料中的具体标题,也不要求先知道关键词。只要资料内容已经被正确转换、切分并建立索引,就可以通过自然语言找到相关片段。
对于文档型资料库,提前整理格式仍然很重要。标题、章节和段落结构越清晰,检索结果通常越容易理解和定位。
模式 2 接入 MCP,让 Agent 自己搜索
一行命令:
zg install
这条命令会自动发现你本机装过的 Agent 工具(Codex、Claude Code、Cursor、OpenCode、Qoder)并配好 MCP。也可以指定目标:zg install –target claude code –yes。配好之后,CLI 和 Agent 共享同一份索引,Agent 不会重复建索引,你在对话里正常提需求即可。
咱们以 claude code 为例:
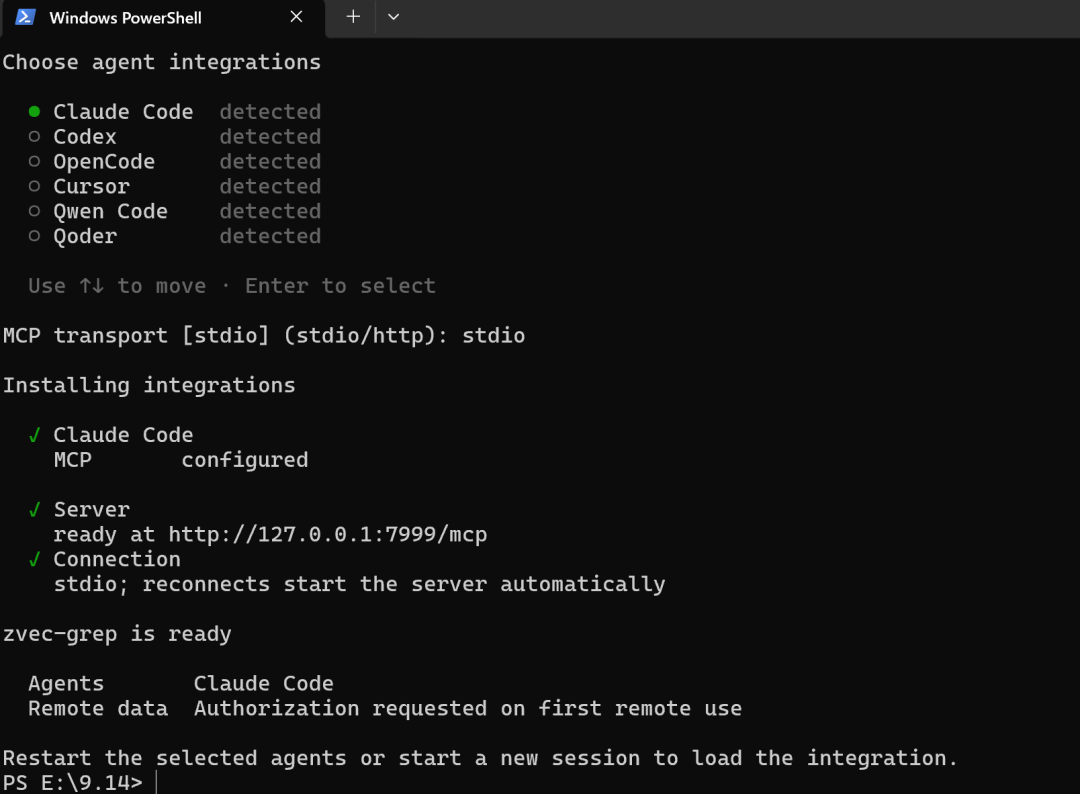
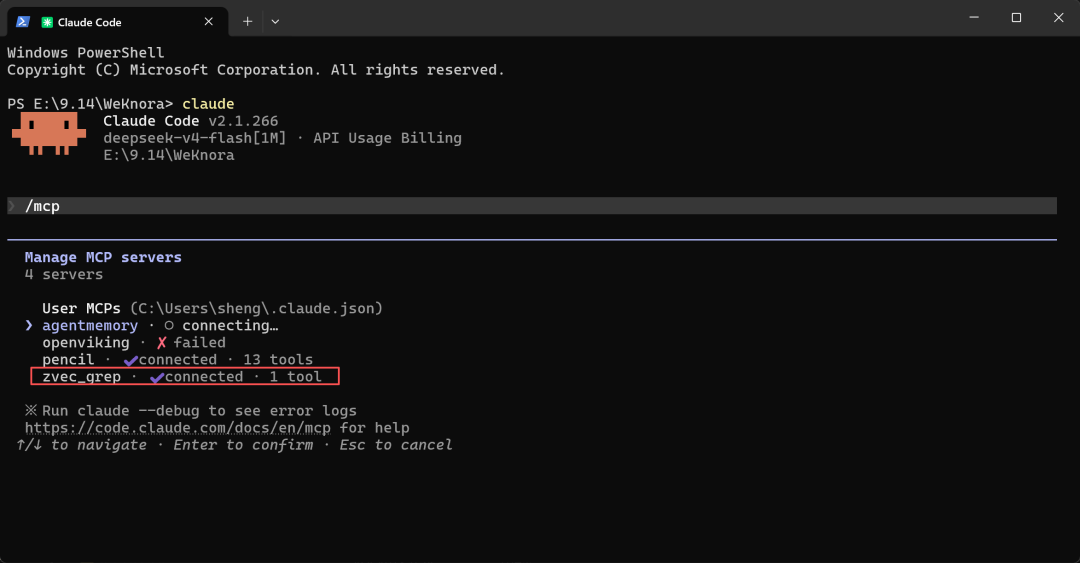
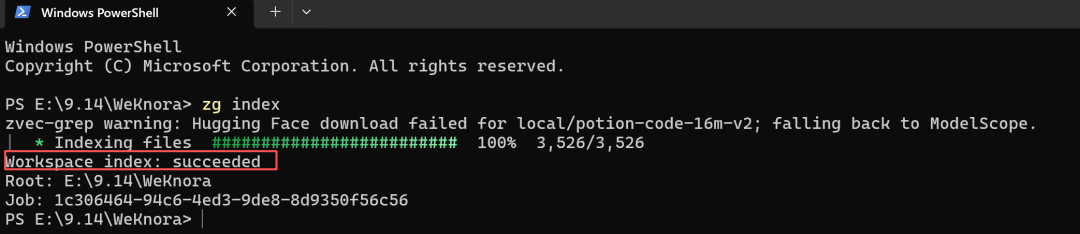
安装完成后,咱们试一个 case。之前 clone 过腾讯开源知识库的仓库,在项目文件夹下建立索引:
zg index
zg index 不带参数就用默认的 local/potion-code-16m-v2——16M 参数的静态模型,本地缓存约 32 MiB,CPU 直接跑,不需要 GPU。
CASE 01 定位配置项的确切位置
PROMPT用 zg 在当前项目里检索:知识库的 API Key 存在哪里、格式长什么样?给出具体文件路径和行号。找不到就明说,不要推测。
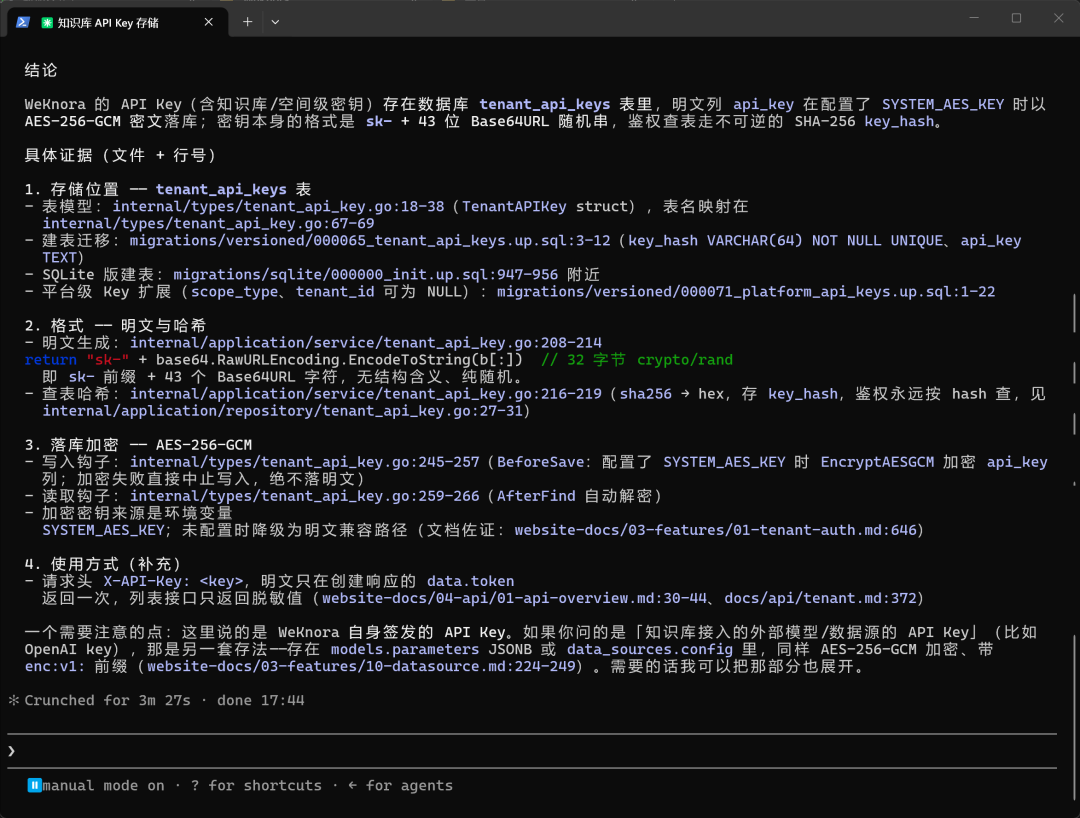
Agent 可以先通过语义或混合检索定位相关文件,再通过精确搜索和文件读取进行确认。
CASE 02 追踪完整处理链路
PROMPT用 zg 检索:用户在前端上传了一个 PDF 文档,从上传到能被搜索到,后台依次经过哪些处理步骤?把每一步对应的模块和文件路径按处理顺序列出来。
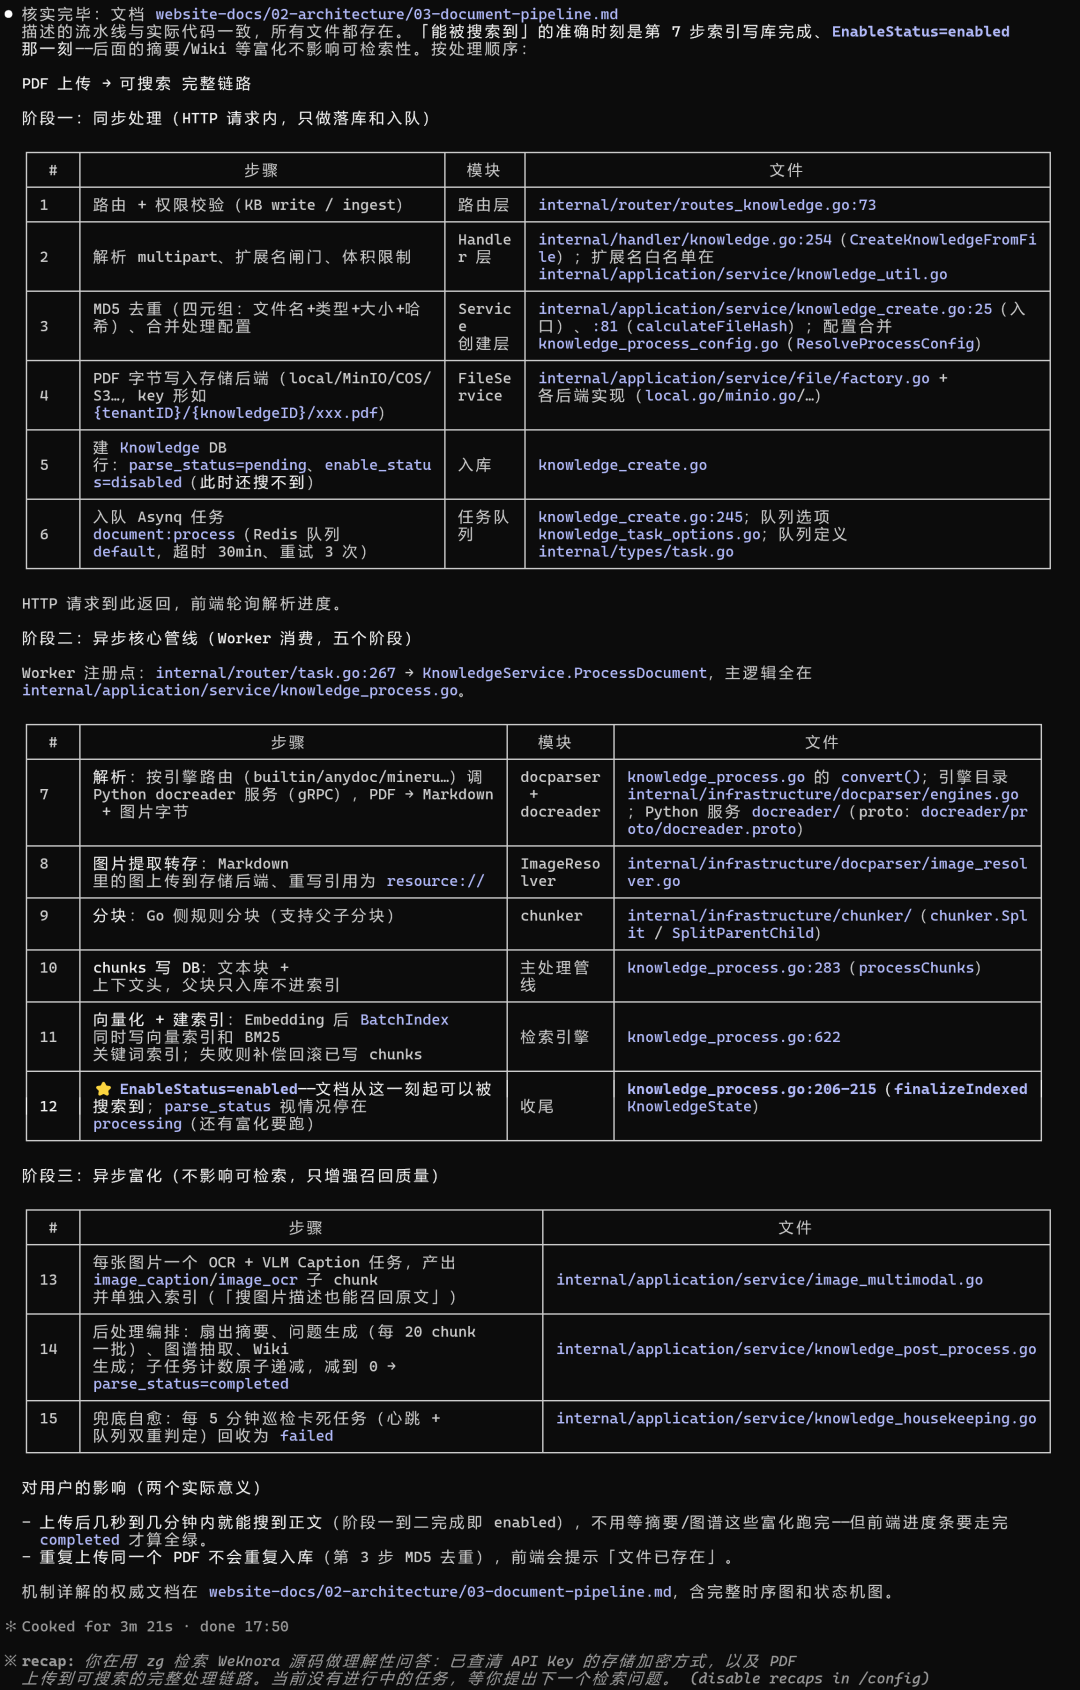
这类问题通常涉及多个模块,关键词可能分散在上传接口、异步任务、文件解析、切片、Embedding、索引写入和查询接口中。如果只搜索「PDF」,很容易得到大量配置、测试和前端代码。语义搜索可以先帮助 Agent 理解「从上传到可检索」的完整过程,再结合路径、函数名和代码引用关系逐步验证。
CASE 03 梳理检索方式的实现
PROMPT用 zg 检索:WeKnora 支持哪几种检索方式,比如关键词、语义、混合?每种在代码里是怎么定义的、什么时候触发?引用定义处的文件和行号。
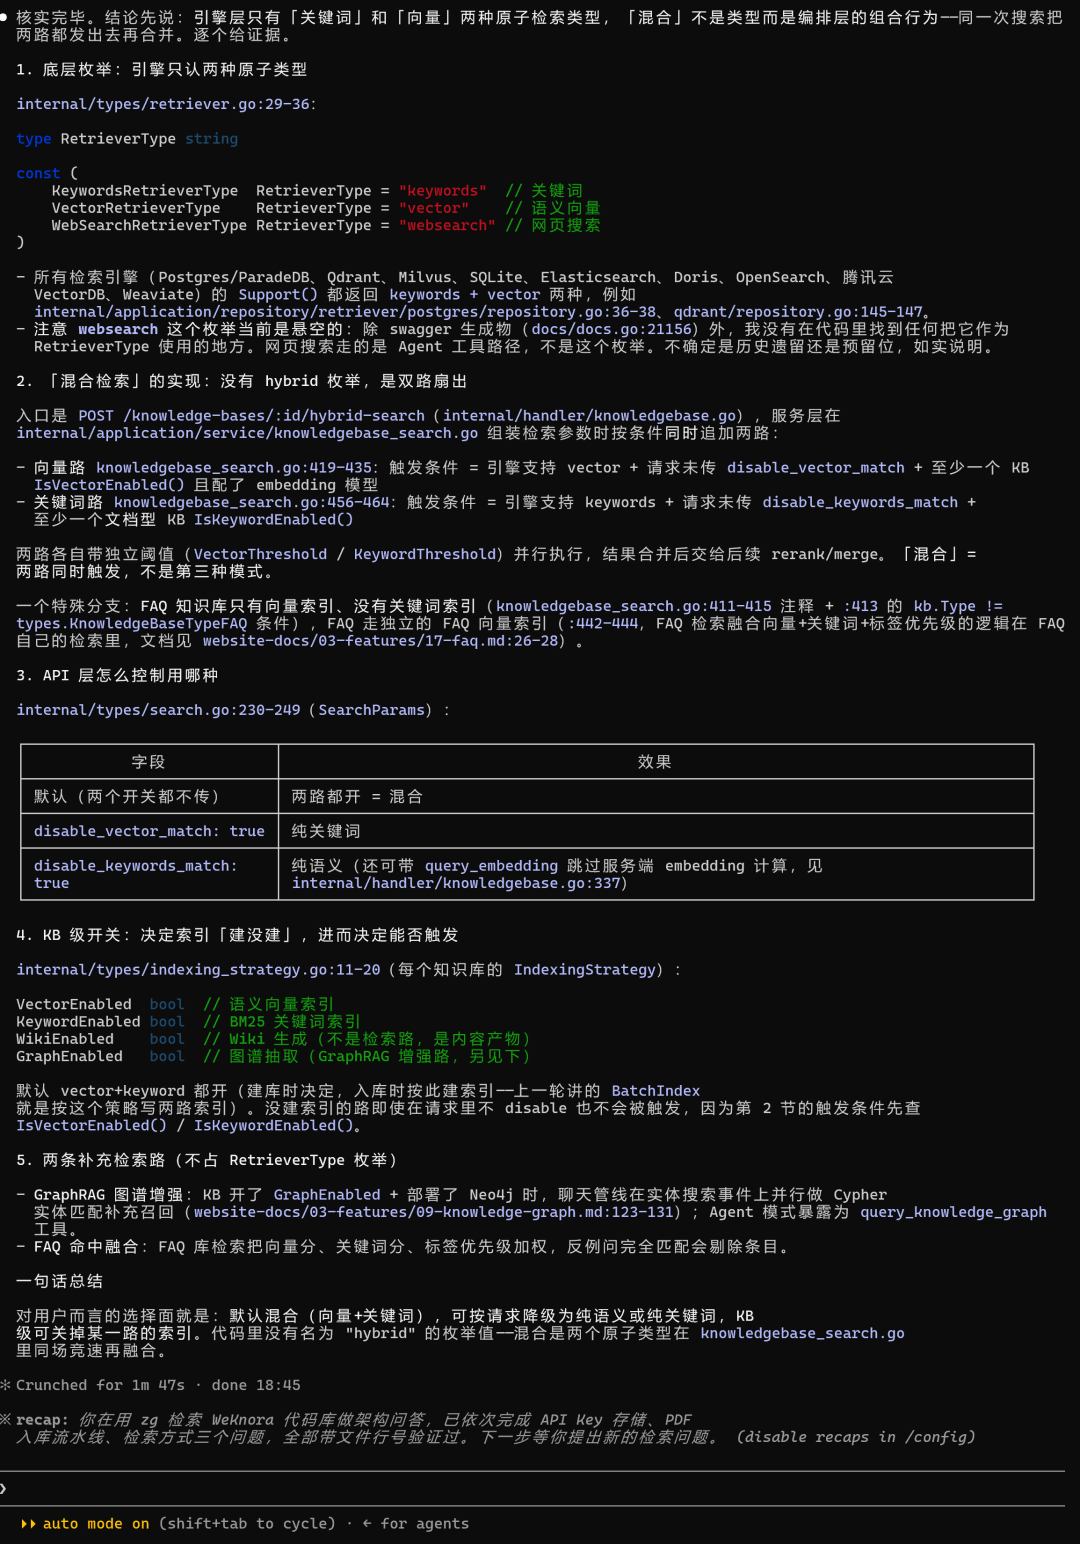
这些任务的共同点是:用户知道自己想了解什么,却未必知道答案位于哪个模块、哪个文件,甚至不知道项目内部使用了什么术语。
这正是语义检索比较有价值的地方:它接住的,正好是关键词搜索接不住的那部分问题。
06 zg 的底层是什么?
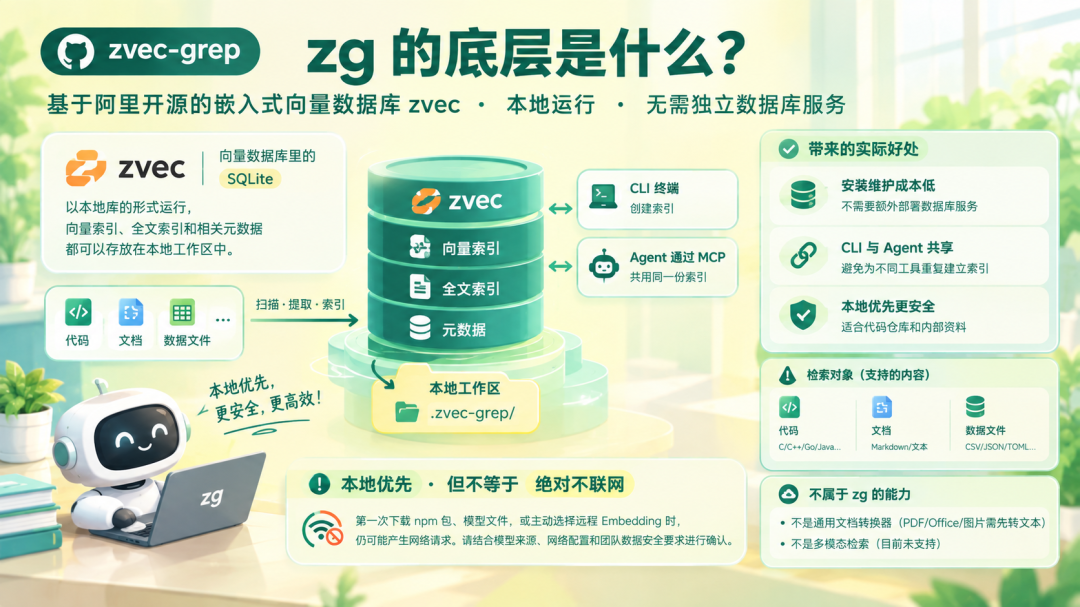
zg 基于阿里巴巴开源的嵌入式向量数据库 zvec。可以把它理解成「向量数据库里的 SQLite」:它以本地库的形式运行,不需要额外部署一个独立的数据库服务。向量索引、全文索引和相关元数据都可以存放在本地工作区中。
这带来几个实际好处。
- 安装和维护成本较低:个人开发者不需要额外启动数据库服务,也不需要配置远程检索系统。
- 索引可以被 CLI 和 Agent 共用:终端里建好索引后,Agent 通过 MCP 直接使用,避免为不同工具重复建同一份索引。
- 本地优先的设计更合适内部资料:文件扫描、内容提取、本地 Embedding、索引与检索都可以在设备内完成,远程 Embedding 属于可选路径。
注意
不过,「本地优先」不等于「任何情况下都绝对不会联网」。第一次下载 npm 包、模型文件,或者主动选择远程 Embedding 时,仍然可能产生网络请求。实际部署时,应该结合模型来源、网络配置和团队的数据安全要求进行确认。
07 适合什么场景?
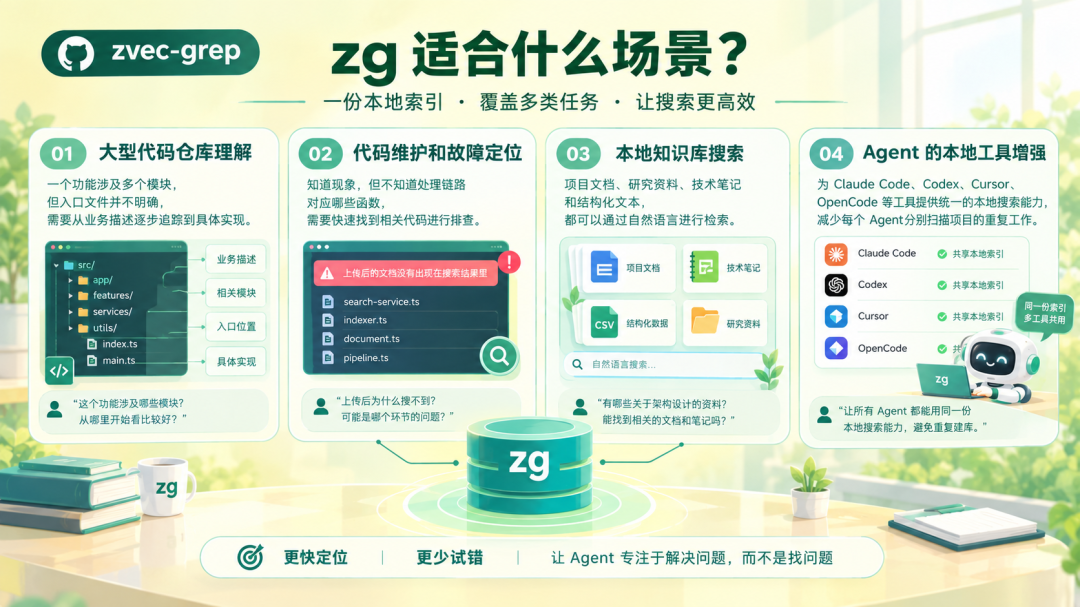
我认为,zg 最适合以下几类任务。
- 大型代码仓库理解:一个功能涉及多个模块、入口文件并不明确时,可以从业务描述逐步追踪到具体实现。
- 代码维护和故障定位:知道现象,比如「上传后的文档为什么没有出现在搜索结果里」,但不知道处理链路对应哪些函数。
- 本地知识库搜索:项目文档、研究资料、技术笔记和结构化文本,都可以通过自然语言进行检索。
- Agent 的本地工具增强:Claude Code、Codex、Cursor、OpenCode 等工具可以共用一套本地搜索能力,减少重复扫描项目。
08 目前的边界
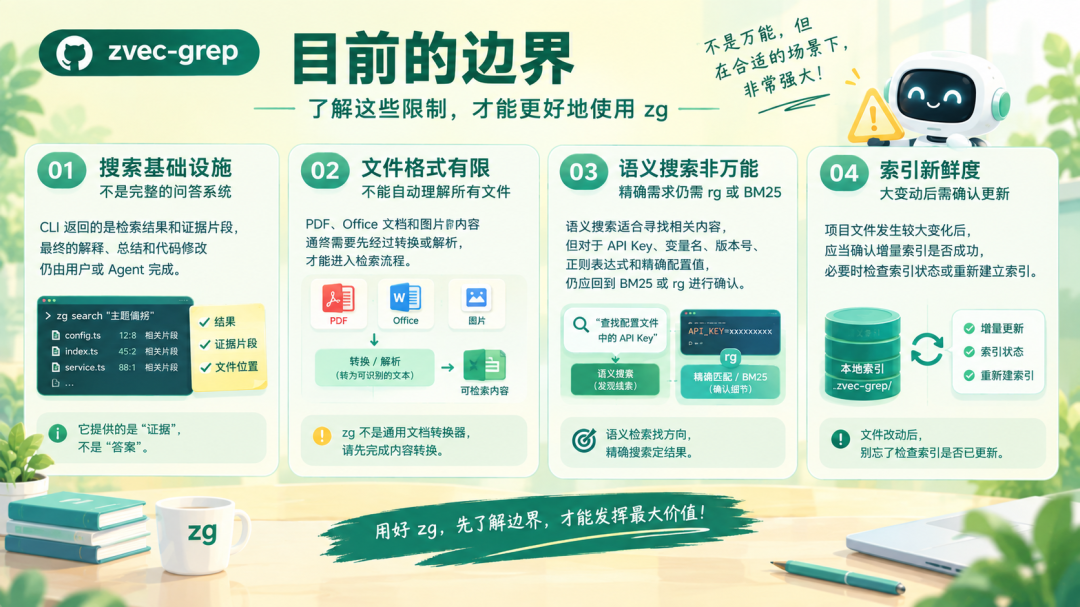
zg 仍然是一项正在发展中的项目,使用时需要注意几个边界。
- 它是搜索基础设施,不是完整的问答系统。 CLI 返回的是检索结果和证据片段,最终的解释、总结和代码修改仍由用户或 Agent 完成。
- 它不能自动理解所有文件格式。 PDF、Office 文档和图片内容通常需要先经过转换或解析,才能进入检索流程。
- 语义搜索也不是万能的。 它适合寻找相关内容,但对于 API Key、变量名、版本号、正则表达式和精确配置值,仍然应该回到 BM25 或 rg 进行确认。
- 索引的新鲜度会影响结果。 项目文件发生较大变化后,应当确认增量索引是否成功,必要时检查索引状态或重新建立索引。
写在最后
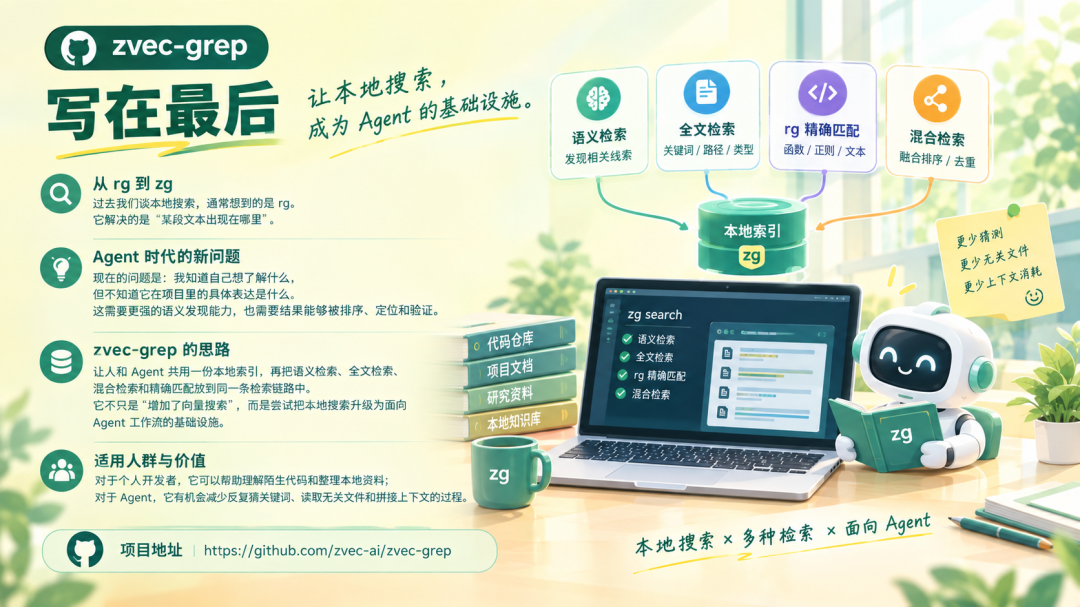
过去我们谈本地搜索,通常想到的是 rg。它解决的是「某段文本出现在哪里」。而 Agent 时代的问题逐渐变成了:
「我知道自己想了解什么,但不知道它在项目里的具体表达是什么。」
这要求搜索工具具备更强的语义发现能力,也要求结果能够被排序、定位和验证。
zvec-grep 提供了一种比较清晰的思路:让人和 Agent 共用一份本地索引,再把语义检索、全文检索、混合检索和精确匹配放到同一条检索链路中。
它最值得关注的地方,不只是「增加了向量搜索」,而是尝试把本地搜索从一个命令,发展成面向 Agent 工作流的基础设施。
对于个人开发者来说,它可以帮助理解陌生代码和整理本地资料;对于 Agent 来说,它有机会减少反复猜关键词、读取无关文件和拼接上下文的过程。
项目地址:https://github.com/zvec-ai/zvec-grep
搜索这件事的下半场,是让 Agent 先听懂人话,再回到代码里找证据。
本文由人人都是产品经理作者【AI李子】,微信公众号:【AI李子】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Pexels,基于 CC0 协议。

本地搜索的老习惯是 rg,关键词明确时确实快;但 Agent 常面对“主题偏好怎么在启动时恢复”这类意图清楚、术语不明的问题,只能猜关键词、翻文件、拼上下文,形成检索税。zvec-grep 把语义、BM25、rg 正则和混合检索放进同一接口,让探索、收敛、验证接在一条链路。关键判断不是语义替代精确搜索,而是先发现线索,再回到文件和行号验证。最后落到人和 Agent 共用一份本地索引,搜索从命令变成工作流基础设施。